


소개
경쟁 약물 프로파일 웹을 개발하면서, 초기 구조와 기능에서 실사용 관점의 한계를 느꼈습니다.
1) 네비게이션 UI는 전통적인 GNB 방식으로 되어 있음.
2) 주요 기능은 데모 데이터에 의존하고 있어 실제 데이터 기반의 인터랙션이 부족함.
3) PDF 요약 기능이 오작동하며 허위 정보를 정리하는 사례가 발생해, 신뢰성과 실시간성 확보 필요.
이런 문제들을 해결하고자 전반적인 구조 개편과 백엔드 고도화를 진행하게 되었습니다.
진행 방법
🔧 디자인 및 레이아웃 개선
사이드바 레이아웃 도입: 기존 GNB(Global Navigation Bar) 방식에서 벗어나, 현대적인 좌측 사이드바 구조로 전환해 메뉴 접근성과 사용자 흐름 개선
반응형 CSS Grid 설계: 메인 대시보드 및 상세 페이지를 다양한 화면 크기에서도 자연스럽게 렌더링되도록 구성
🧠 기능 고도화
인증 시스템 개선 (Supabase)
관리자용 고정 계정 + 일반 유저용 구글 소셜 로그인 방식의 하이브리드 인증 구조 구축
각 유저가 작업한 데이터를 저장하고 관리할 수 있는 Admin 페이지 구현
PDF 요약 기능의 신뢰성 개선 및 보안 강화
기존에는 Gemini API 호출 시 클라이언트에서 직접 요청하면서 API 키 노출 위험 존재
이를 방지하고 안정성을 높이기 위해 Node.js 기반 백엔드 프록시 서버 구축
스터디장님의 지도를 따라 보안 구조를 다음과 같이 개선:
🔐 보안 강화 작업 내용
.env파일 생성사용자 API Key는 소스 코드가 아닌
.env파일에 별도로 저장이 파일은 사용자 컴퓨터에만 존재하며 외부에 유출되지 않음
소스 코드 보호
server/scraper_service.js에서 하드코딩된 키 제거process.env.GEMINI_API_KEY를 통해 환경변수로 키를 불러오도록 수정
Git 유출 방지
.gitignore에.env포함 → 실수로 GitHub에 키가 업로드되는 상황 원천 차단
환경 변수 로딩 설정
dotenv라이브러리 설치 및 서버 코드 상단에 설정 추가로.env자동 인식
# 서버 실행 명령어
node server/scraper_service.js
요약 정확도 문제 확인 후, 요약 결과에 출처 데이터와 함께 병렬로 비교할 수 있는 UI 개선 검토 중
외부 데이터 실시간 연동
Asset Detail 페이지가 외부 API와 AI를 사용해 자동으로 채워지도록 코드를 업데이트해주고, 기밀 관련 우려되는 문제가 있는지 확인해줘 ClinicalTrials.gov V2 API 연동을 통해 실제 임상 시험 데이터를 실시간으로 조회하는 기능 구현
'LIVE DATA' 토글을 통해 사용자가 데모 데이터 vs 실제 데이터 중 선택할 수 있도록 구성
UX 최적화를 위해 실시간 필터링 대신, 검색어 입력 + Enter 또는 Search 버튼 클릭 방식 도입
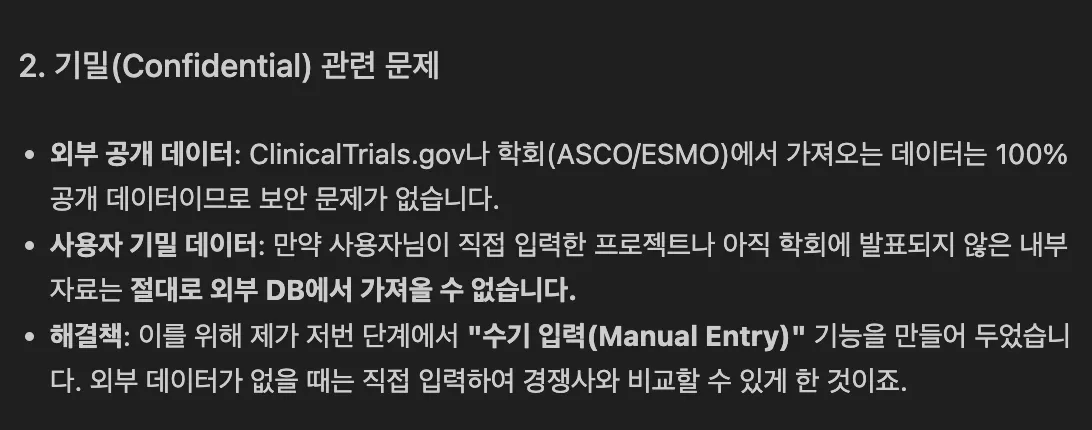
2 기밀
Asset Detail 자동 완성 기능 실험
사용자가 특정 약물을 선택하면 해당 약물의 실제 임상 데이터(스폰서명, 적응증, 임상시험 리스트 등)를 API를 통해 가져와 자동으로 상세 페이지를 구성
로딩 중에는 사용자에게 진행 상황을 안내하는 애니메이션도 함께 표시
Gemini 3 Flash를 활용하여 용법/용량(CP Profile) 정보를 실시간 추출하는 기능도 시도되었으나, 현재는 정확도와 안정성 측면에서 아직 실사용엔 무리가 있음을 확인
Git push
Git에 작업 파일 업로드.
🔍 실행 및 피드백 반영
Vercel로 배포 후 실사용 테스트 중, 일부 기능이 데모 데이터 기반으로만 동작하고 있음이 확인됨
스터디장님과 논의 후 해당 문제의 원인을 파악했고, 구조 수정에 대한 조언(안티그래비티 방식 설명)도 받음
실시간 API 연결 방식, 데이터 흐름 등을 재설계하며 수정 완료
결과와 배운 점
실제 데이터를 다루는 기능은 UI 이상으로 백엔드 설계와 구조가 핵심이라는 것을 체감함
PDF 요약 등 AI 기능은 참고 도구일 뿐, 정답을 생성하는 것이 아님을 깨닫고 검증 구조의 중요성을 느낌
Supabase 기반 관리자 페이지를 통해 사용자 활동 데이터도 정리할 수 있는 기반이 마련됨
Asset Detail 자동 완성 기능처럼 AI 연동 기능은 UX를 개선시킬 수 있지만, 모델 신뢰도에 대한 판단과 보완 로직이 필수임을 깨달음
다음 목표는 다음과 같습니다:
LLM 기능 정확도를 평가할 수 있는 신뢰도 테스트 체계 구축
사용자 피드백을 기반으로 한 기능 정교화 및 UX 개선 반복
Asset Detail 페이지에 AI 기능을 부분적으로 제한하거나, 사용자에게 AI 결과임을 명확히 표시하는 구조 도입
도움 받은 글
스터디장님의 피드백 및 안티그래비티 구조 설명 🙏
Google 로그인 연동 관련 요약:
Google Cloud Console에서 OAuth 클라이언트 ID와 Secret 발급
Supabase 대시보드에서 Google Provider 설정 → Client ID & Secret 입력
중요 사항 요약:
Client ID는 공개 가능하지만, Client Secret은 외부에 절대 노출 금지
리디렉션 URI는 정확히 설정 필요:
https://<프로젝트명>.supabase.co/auth/v1/callback설정 후 저장하면 실 도메인에서도 Google 로그인 정상 작동
