


소개
시도하고자 했던 것과 그 이유를 알려주세요.
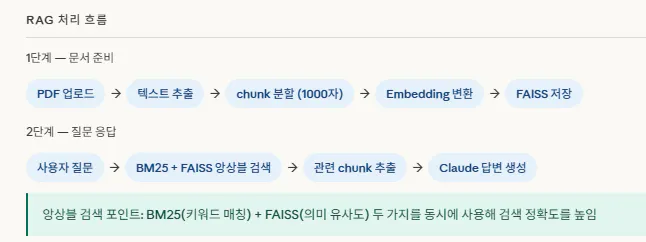
단순히 LLM에게 질문하는 챗봇을 넘어, 회사 내부 PDF 문서를 업로드하면 그 문서를 기반으로 정확하게 답변하는 RAG(Retrieval-Augmented Generation) 챗봇을 만들었습니다. "오픈북 시험"처럼 AI가 문서를 참조해서 답하게 하는 방식으로, 기업 내부 지식베이스 구축의 첫 단계를 실습했습니다.
진행 방법
Claude Code 자연어로 전체 코드 생성 및 오류 수정
LangChain PDF 로드 → chunk → embedding → 검색 파이프라인
FAISS Meta 오픈소스 벡터DB — 로컬 무료 사용
Streamlit 파이썬으로 웹 UI 구현
Anthropic API Claude Sonnet 4.5 답변 생성
Tip: 사용한 프롬프트 전문을 꼭 포함하고, 내용을 짧게 소개해 주세요.
PDF 여러 개 업로드하면 RAG로 답변해주는 Streamlit 챗봇 만들어줘.
조건:
- LLM은 Claude Sonnet 4.5
- VectorDB는 FAISS
- chunk_size 1000, overlap 200
- BM25 + FAISS 앙상블 검색
- 사이드바에서 PDF 업로드
- 이전 대화 기억
- .env에서 ANTHROPIC_API_KEY 로드
- 말투: 친절하고 충직한 보좌관 스타일
- 파일명: rag.py
Tip: 활용 이미지나 캡처 화면을 꼭 남겨주세요.
한국어 웹사이트 스크린샷
Tip: 코드 전문은 코드블록에 감싸서 작성해주세요. ( / 을 눌러 '코드 블록'을 선택)
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import FAISS
from langchain_community.retrievers import BM25Retriever
from langchain.retrievers import EnsembleRetriever
splitter = RecursiveCharacterTextSplitter(
chunk_size=1000,
chunk_overlap=200
)
chunks = splitter.split_documents(pages)
faiss_retriever = vectorstore.as_retriever(search_kwargs={"k": 4})
bm25_retriever = BM25Retriever.from_documents(docs, k=4)
ensemble_retriever = EnsembleRetriever(
retrievers=[faiss_retriever, bm25_retriever],
weights=[0.5, 0.5]
)
(내용 입력)
결과와 배운 점
배운 점과 나만의 꿀팁을 알려주세요.
RAG = PDF를 LLM에 올리는 것이 아니라 관련 청크만 골라서 전달하는 것
Embedding = 텍스트의 의미를 숫자(벡터)로 변환하는 과정
FAISS = Meta가 만든 무료 벡터DB — 내 컴퓨터 로컬에서 작동
Claude Code 자연어 방식이 Cursor txt 요구사항 방식보다 훨씬 빠름
API 키는 회사(Anthropic/Google/OpenAI)마다 완전히 다름 — 혼동 금지
과정 중에 어떤 시행착오를 겪었나요?
시행착오: ANTHROPIC_API_KEY와 GOOGLE_API_KEY를 혼동 — API키는 LLM 회사를 결정하는 핵심 설정임을 학습
도움이 필요한 부분이 있나요?
앞으로의 계획이 있다면 들려주세요.
유튜브 영상 요약 챗봇 제작 만들고자 합니다.
Ollama 로컬 LLM 연결 — 기밀문서용 완전 오프라인 버전
도움 받은 글 (옵션)
참고한 지피터스 글이나 외부 사례를 알려주세요.
감사합니다.
