[8기 랭체인] RAG 방식의 웹 기반 최신 맛집 찾기
2023.12.14
안녕하세요 미남홀란드입니다.
이번주도 역시 재밌는걸 조금 찾다보니깐 이런걸 하게 되었네요. GPT Plugin에서 Webpilot을 다들 많이 쓰실텐데요. 이게 그 기반인가 생각햅 볼 수 있는 예제 였습니다.
Google 검색엔진 기반으로 우선 좋은 GoogleSearchAPIWrapper
from langchain.utilities import GoogleSearchAPIWrapper요런 좋은 재료가 있더라구요. 그래서 처음엔 API key , 검색엔진 id 를 받아와서 이거재밌겠다 하고 연구를 해보기 시작했습니다.
호기로운 첫시도
링크를 뽑아서 그 링크를 다시 추출해서 LLM 한테 던진 후에 맛집을 추천해달라해보자!
meta data 를 활용해서 5개의 쿼리를 뽑아서 Link 만 받아내기
 search = GoogleSearchAPIWrapper()


def top5_results(query):
    return search.results(query, 5)


tool = Tool(
    name="Google Search Snippets",
    description="Search Google for recent results.",
    func=top5_results,
)
위 코드를 실행하면
Snippet: The description of the result.
Title: The title of the result.
Link: The link to the result.
위와 같은 형태로 Json 데이터가 추출이 됩니다. item 을 뽑은후 urls 란 변수에 넣어주고
from langchain.document_loaders import AsyncHtmlLoader
# HTML to Text
urls = ["https://www.espn.com", "https://lilianweng.github.io/posts/2023-06-23-agent/"]
loader = AsyncHtmlLoader(urls)
docs = loader.load()
html to text 를 알아서 잘 뽑아주는 재료가 있길래 요걸 활용해보자 했습니다.
여기까지 받은 후 사실 page_content 를 활용해서 LLM 에 던지는 작업을 해주면 되었습니다. 근데 항상헷갈리는게 이러면 토큰의 갯수가 너무많아서 항상 에러가 발생하는 경우가 생깁니다. 그래서 Vector DB에 담아야 하는구나 느꼈습니다.
아직 cookbook 만 따라해보는 정도라 자유자재로 랭체인을 다루지못해서 파라미터 속에 이걸 그대로 넣으면 얼마나 좋을까? 했지만 try 는 에러 범벅이었습니다.
위 방법으로 하면 코드가 조금 길어져서 ‘에잇 하고 때려치웠습니다’'
두번째시도
우연치 않게 RetrievalQAwithSourcesChain 이란게 있었고 Fetching page 하는 것까지 제 첫시도와 닮아있었습니다. 두번째시도는 단 코드 몇줄로 성공이었습니다.
#벡터 디비 선언 및 엠베딩
vectorstore = Chroma(embedding_function=OpenAIEmbeddings(api_key=api_key),
                     persist_directory="./chroma_db_oai")
# llm 선언
search_llm = ChatOpenAI(temperature=0,api_key=api_key, model_name="gpt-4-1106-preview")

search = GoogleSearchAPIWrapper()

web_research_retriever = WebResearchRetriever.from_llm(
    vectorstore=vectorstore,
    llm=search_llm,
    search=search
)

response_llm = ChatOpenAI(model_name="gpt-4-1106-preview",temperature=0,api_key=api_key,)
qa_chain = RetrievalQAWithSourcesChain.from_chain_type(response_llm,
                                                       retriever=web_research_retriever)
웹 리서치 리트리버를 만들어주고 체이닝 하면 끝이었습니다.. 현타가 살짝 오면서도 이래서 랭체인을 쓰는구나 싶더라구요
user_input = "수내동 한식 맛집 추천해줘"
result = qa_chain({"question": user_input})
result
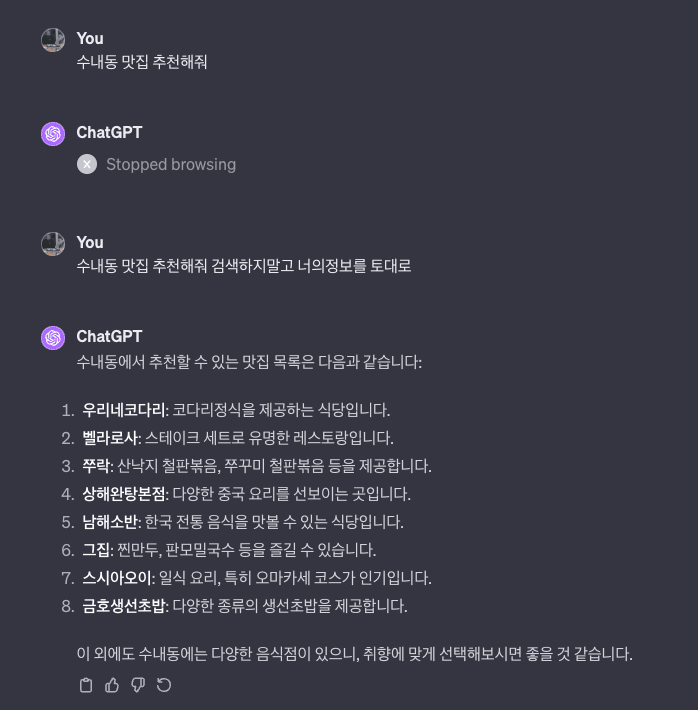
지금이야 GPT가 많이 업그레이드가 되어서 내말을 찰떡같이 알아들어서 bing 기반의 검색을 리트리버로 가져오지만 예전엔 자기가 알고있는 정보를 토대로 알려주었는데요. 확실히 웹 서치후 리트리버를 하니깐 최신이라던지 내가 설정한 값에 따라 리트리버를 해서 생성을 해주는 결과물을 보여주었습니다.
기존 지피티결과
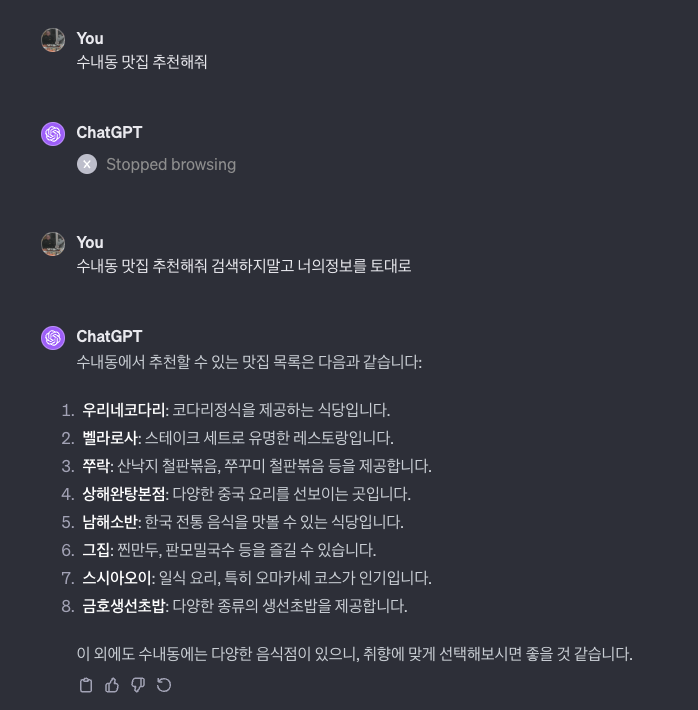
랭체인결과

실제로 블로그 기반이다보니 제가 가끔 가는 양지식당의 정보가 떠서 반가웠습니다. GPT-4 에는 양지식당이 학습이 안되어있는거 같더라구요. 하지만 블로그도 최신 기준으로 fetch 가 되게끔 해야된다고 생각한게 양지식당이 8천원으로 가격이 인상되었는데 이전 블로그 게시물이라 7천원으로 나오는거보면 정보 중심이기 때문에 확실히 또다른 전처리, 검증이 필요하다고 생각되었습니다.
Prompt 를 조금 더 추가해서 정제되게끔 값을 뽑아온다면 application 에서 충분히 활용가능성이 있지 않을까 싶었습니다.
로그인하고 댓글을 남겨 주세요
2. 하나는 리트리버용, 하나는 사용자질의에 대한 추론하기 위한 llm 둘이 체이닝 해서 쓰는거 같더라구요
질문이 있습니다.
1. 아래 코드 기능이 뭔가요??
tool = Tool(
    name="Google Search Snippets",
    description="Search Google for recent results.",
    func=top5_results,
)qa_chain = RetrievalQAWithSourcesChain.from_chain_type(response_llm, retriever=web_research_retriever)
GoogleSearchAPIWrapper도 유료인걸로 아는데 비용은 어느정도 발생하시던가요?

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요