HuggingFace 몇개 모델 체험
2024.04.09
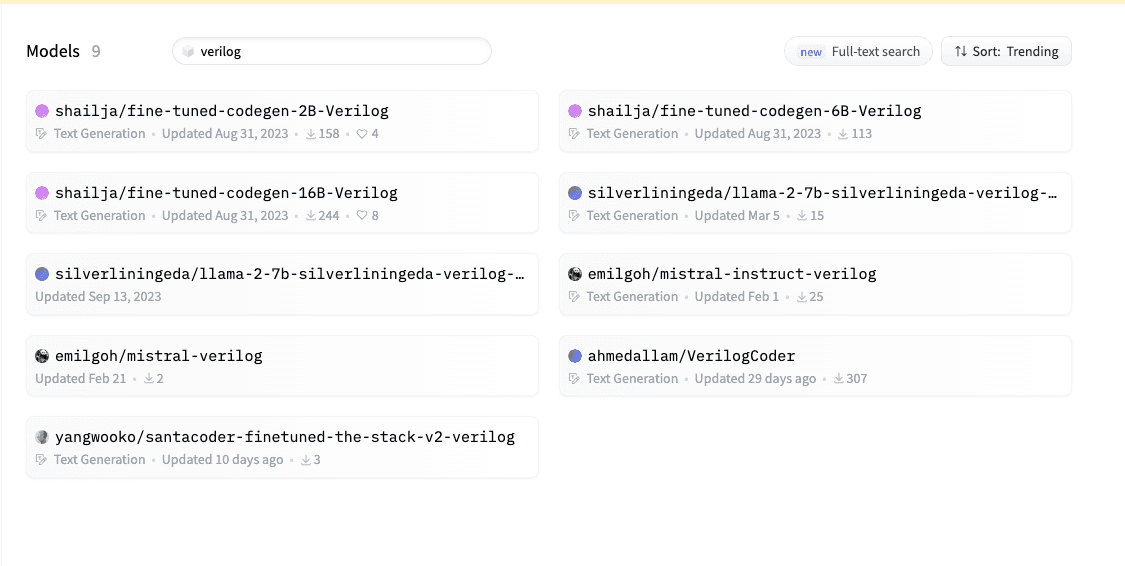
Language 중에 하나인 Verilog language (하드웨어 설계시 사용하는 언어) 가 학습되어 있는 LLM 모델을 사용해보았다.
Verilog language는 다른 programming language 에 비해, source가 부족하여, GPT 만으로 의존하기 아쉬어 huggingface 에 어떤 모델들이 있나 확인해보았다.
허깅페이스에 등록되어 있는 50만개 모델중 9개 나온다.
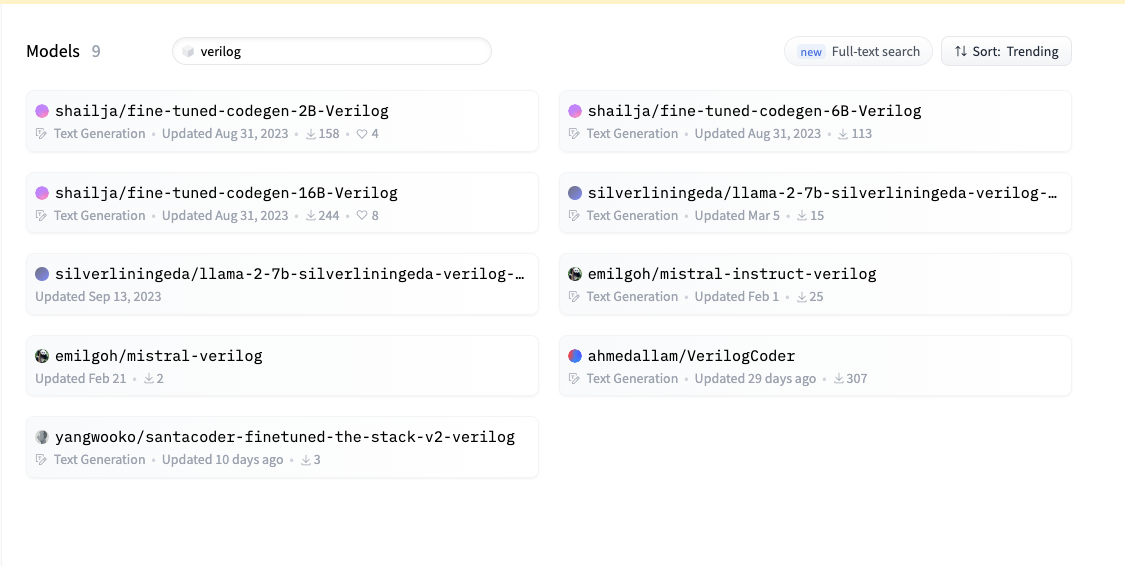
shailja/fine-tuned-codegen-*B-Verilog. Baseline LLM SalesForce/CodeGen
silverliiningeda llama2 7b 모델
ahmedallam 는 base가 starcoder2 15b
emilgoh 는 base가 Mistral 7b
yangwooko는 base가 santacoder 라고 제목에 있는데 모델 사이즈 명시되어 있지 않다.
각각 어떤 base model + finetune에 사용된 dataset에 따라 성능이 갈릴거 같은데,
위에 있는 모델 살펴보기 전에 코딩 관련 model 벤치마크부터 보자
https://evalplus.github.io/leaderboard.html
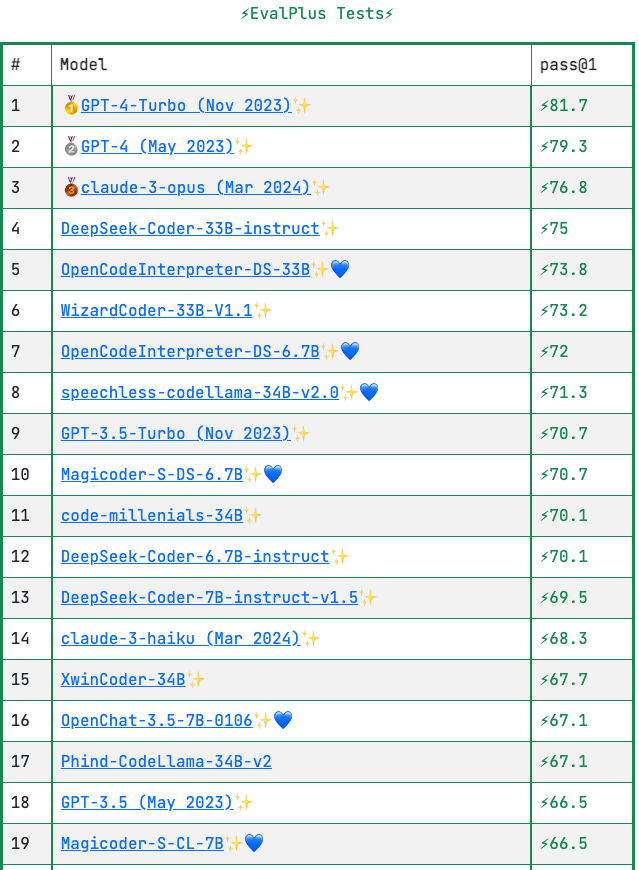
대형 모델 빼고, Deepseek, opencoderInterpreter, MagicCoder. 근데 opencoderI, magiccoder전부 deepseek 이 base. Deepseek은 기존 여러 코딩용 llm을 조합해서 2T tokens 학습한 친구.
33B 모델만 해도, 아주 높은 사양의 인프라를 요구하므로, 7B 이하급 한개 골랐다.
허깅페이스에 있는 모델로 돌아와 설명을 살펴보면 아래와 같다.
shailja/fine-tuned-codegen-16B-Verilog
The model was trained on Verilog from GitHub and textbooks.
The final Verilog corpus of textbook-extracted and GitHub code had a size of 400 MB.
Dataset 도 허깅페이스에 있는데 shailja/Verilog_GitHub. 109k rows.
10만줄 이상의 셋으로 A100 4개 15일 트레이닝 함.
논문에 base model & Pretrained or Finetuned 실험 결과가 나와 있다.
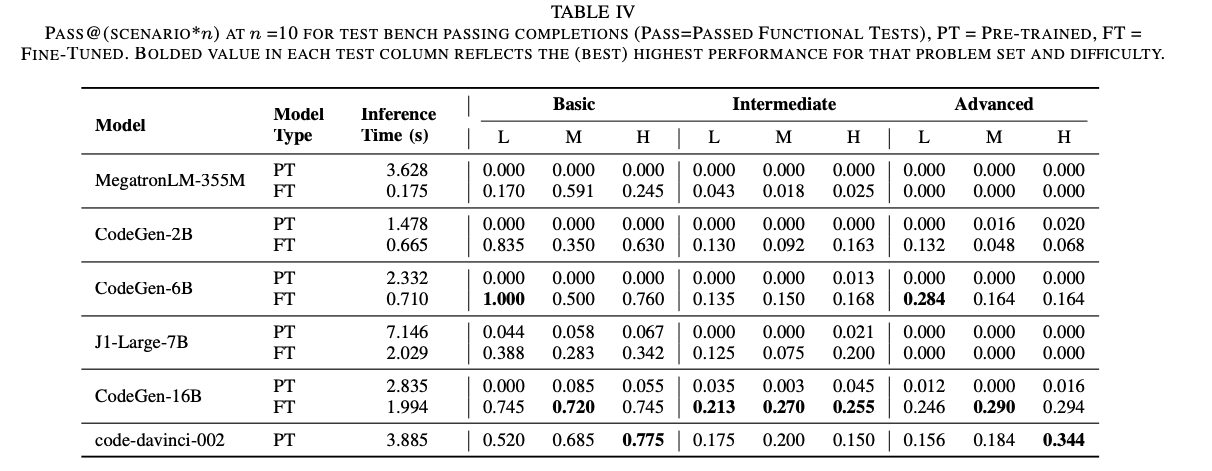
대략 CodeGen-16B 가 젤 좋아서, 저렇게 공유한것.
근데 16B 도 GPU 메모리 40GB 이상 필요해서, google colab 유료로도 실패.
6B 선택. shailja/fine-tuned-codegen-6B-Verilog
silverliningeda/llama-2-7b-silverliningeda-verilog-codegen
정보 기입이 없다. llama2 7b 모델에 무엇을 트레이닝 했는지 모르니 패스.
ahmedallam/VerilogCoder
구체적인 training dataset 이 안나와 있다.
emilgoh/mistral-verilog
This model is a fine-tuned version of mistralai/Mistral-7B-v0.1 on an unknown dataset.
올린 사람이 training한게 아닌가봄.
정석으로 하려면, benchmark 코드로 pass 테스트 해야겠지만, 시간여력 핑계로,
몇개 프롬프트만 적용 테스트
# prompt = "Verilog.  Write D flipflop"
# prompt = "You are a System Verilog expert. Write UVM testbench including AXI. DUT is simple feed through."
# prompt = "generate a Verilog module with the following description: Module with multiple wires and assignments"
# prompt = "Generate a Verilog module with the following description: Parameterized module"
# prompt = "Generate a system veriloog for a parameterized sequence class that adapts parameterized transactions"
# prompt = "Please fix the error.\
# ```\
# module top()\
# int a;\
# initial \
# begin\
# assign a = 1;\
# end\
# endmodule\
# ```\
# "
테스트 결과 표로 정리해보면 아래와 같다.
model1 : m-a-p/OpenCodeInterpreter-DS-6.7B
model2: shailja/fine-tuned-codegen-6B-Verilog
model3: silverliningeda/llama-2-7b-silverliningeda-verilog-codegen
//15B를 먼저 올려야하나 40GB RAM 으로 불가능. model4: ahmedallam/VerilogCoder
//동작 안함. model5: emilgoh/mistral-verilog
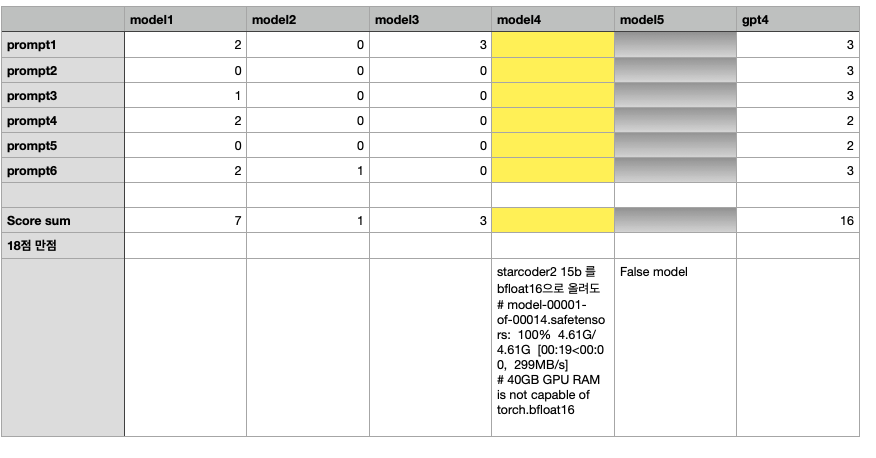
Model1 은 Base가 가지고 있는 학습양이라 그런지 성능이 많이 떨어진다.
Model2 는 training dataset 이 10만줄 이상이나 되었다고 하지만, 6b 모델로 자연어로 프롬프트 넣을시 처참할 정도로 성능이 떨어짐.
Model3 는 학습 데이터가 제대로 갖춰지지 않았을것이라고 생각한다. llama2 가 기본적으로 덜떨어진 base model은 아니니.
Model4 개인 리소스로 더이상 진행 않기로.
허깅페이스 사용시 내가 직접 모델을 학습/추론으로 사용하려면 돈이 좀 들어가는 현실이 아쉽다.
구글 colab 유료에서 주는 컴퓨팅을 모두 사용해서 컴퓨팅을 추가 구매후 해야한다.
#10기 HuggingFace 허깅페이스
로그인하고 댓글을 남겨 주세요
글을 재밌게 읽어내려 가던 중, 갑자기 뚝 끊김 현상이 ㅎㅎ 더더 공유해주세요! 어떤 하드웨어를 설계하고 계신 건지도 궁금하네요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
글을 재밌게 읽어내려 가던 중, 갑자기 뚝 끊김 현상이 ㅎㅎ 더더 공유해주세요! 어떤 하드웨어를 설계하고 계신 건지도 궁금하네요.