


Jev가 무엇을 하는 모델인지, 여섯 가지 개발 상황으로 직접 확인해봤습니다.
요즘 Jev가 화제라는 이야기를 듣고 처음에는 새로운 코딩 모델이라고 생각했습니다. Claude나 GPT처럼 설명을 쓰고 코드를 고치는 모델일 거라고 예상했습니다.
직접 써보니 역할이 달랐습니다. 일반 LLM이 답을 직접 만드는 주관식 모델이라면, Jev는 개발자가 준비한 답 중 하나를 고르는 객관식 모델에 가까웠습니다.
Jev는 답을 만들지 않고 판단합니다
일반 LLM에는 “이 오류를 해결해줘”라고 요청할 수 있습니다. LLM은 상황을 읽고 원인을 설명하거나 코드를 작성합니다.
Jev에는 같은 일을 맡길 수 없습니다. 대신 다음 세 가지를 함께 전달합니다.
현재 상황: TypeScript 빌드가 실패했습니다.
판단할 내용: 다음에 무엇을 해야 할까요?
가능한 선택지: 다시 실행, 코드 조사, 환경 복구, 사용자 확인, 중단
그러면 Jev는 새로운 해결책을 작성하는 대신 선택지별 가능성을 반환합니다.
왜 빠를까요?
일반 LLM은 답을 한 토큰씩 순서대로 만듭니다. 앞 토큰이 나와야 다음 토큰을 만들 수 있어서 답이 길수록 시간이 늘어납니다.
Jev는 입력을 한 번 처리한 뒤, 미리 정한 선택지들의 점수를 병렬로 계산합니다. 긴 설명이나 JSON 문법을 생성하지 않고 “재실행 87%, 코드 조사 8%”처럼 판단 결과만 바로 반환합니다.
즉, Jev는 생각을 무조건 더 빨리하는 모델이라기보다 생성할 것을 줄여서 빠른 모델입니다. 이 장점은 분류·평가·라우팅처럼 선택지가 정해진 문제에서만 유효합니다.
Jev도 학습된 신경망이므로 단순한 if문은 아닙니다. 다만 TypeSafe는 새로운 모델 아키텍처와 parallel sampler를 사용한다고만 공개했습니다. 내부가 Transformer인지, 기존 언어 모델을 얼마나 재사용했는지는 밝히지 않았습니다. 따라서 “LLM과 완전히 다르다”거나 “출력 헤드만 바꿨다”고 단정하기는 어렵습니다.
다시 실행      87%
코드 조사       8%
사용자 확인     5%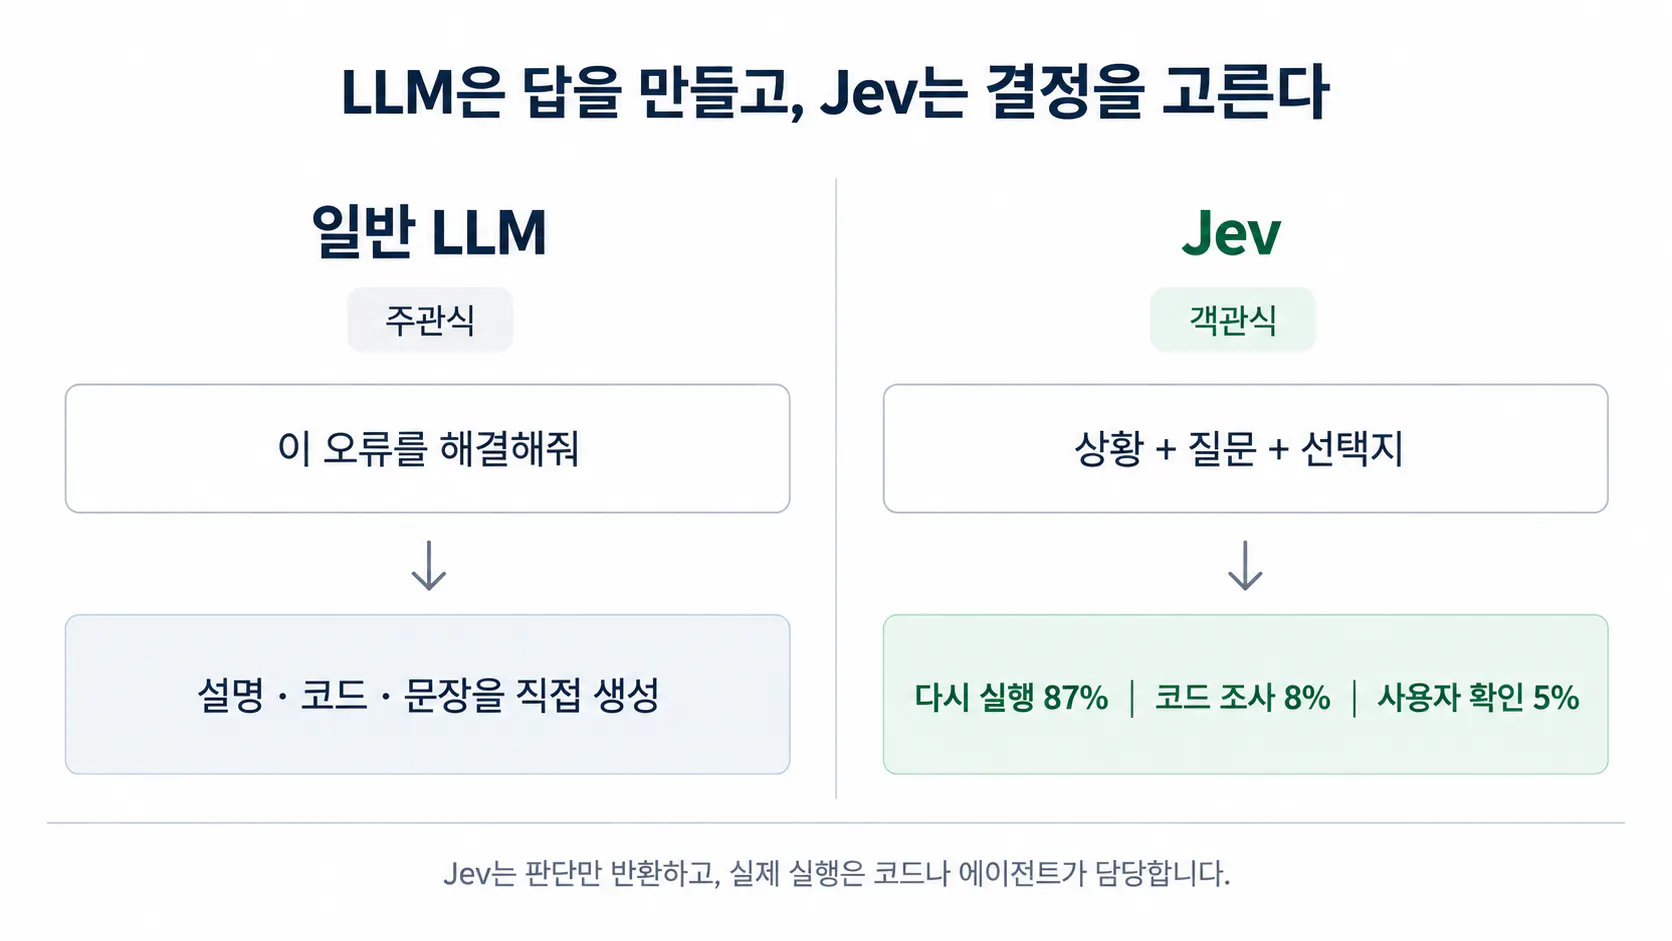
일반 LLM과 Jev의 차이
선택지를 만드는 사람은 개발자입니다. Jev는 주어진 상황을 읽고 그중 무엇이 가장 적절한지를 판단합니다. 다시 실행이라는 결과가 나와도 Jev가 직접 테스트를 실행하지는 않습니다. 결과를 받은 코드나 에이전트가 실제 행동을 수행합니다.
Jev가 반환하는 답은 세 종류입니다.
공식 명칭은 Noul, Choice, Score입니다. Noul은 yes/no 질문의 확률을, Choice는 정해진 선택지의 확률 분포를, Score는 척도 위의 점수와 분포를 반환합니다.
형식
예시
Choice
다음 행동은 무엇인가?
Score
긴급도가 얼마나 높은가?
Noul
사람의 검토가 필요한가?
이 구조는 도구 선택, 문의 분류, 검색 결과 평가, LLM 답변 검사처럼 가능한 답이 미리 정해진 반복 판단에 어울립니다. 반대로 문서 저장, 검색, 코드 작성, 설명 생성은 Jev의 역할이 아닙니다.
TypeSafe는 자사 평가에서 Jev가 기존 LLM보다 최대 193.6배 빠르고 444.6배 저렴했다고 발표했습니다. 다만 “환각이 없다”는 표현은 정해진 형식 밖의 답을 만들지 않는다는 뜻에 가깝습니다. 형식은 지켜도 잘못된 선택지를 고를 수는 있습니다.
직접 개발 상황으로 시험했습니다
이번 작업은 로나 코칭의 진행표에 공식 자료 확인 → 실행 환경 준비 → 직접 실험 → 장단점 판단 → 사례글 작성 순서로 기록했습니다. 한 번 호출해본 것과 실제로 쓸 만한지 확인한 것을 구분하기 위해서였습니다.
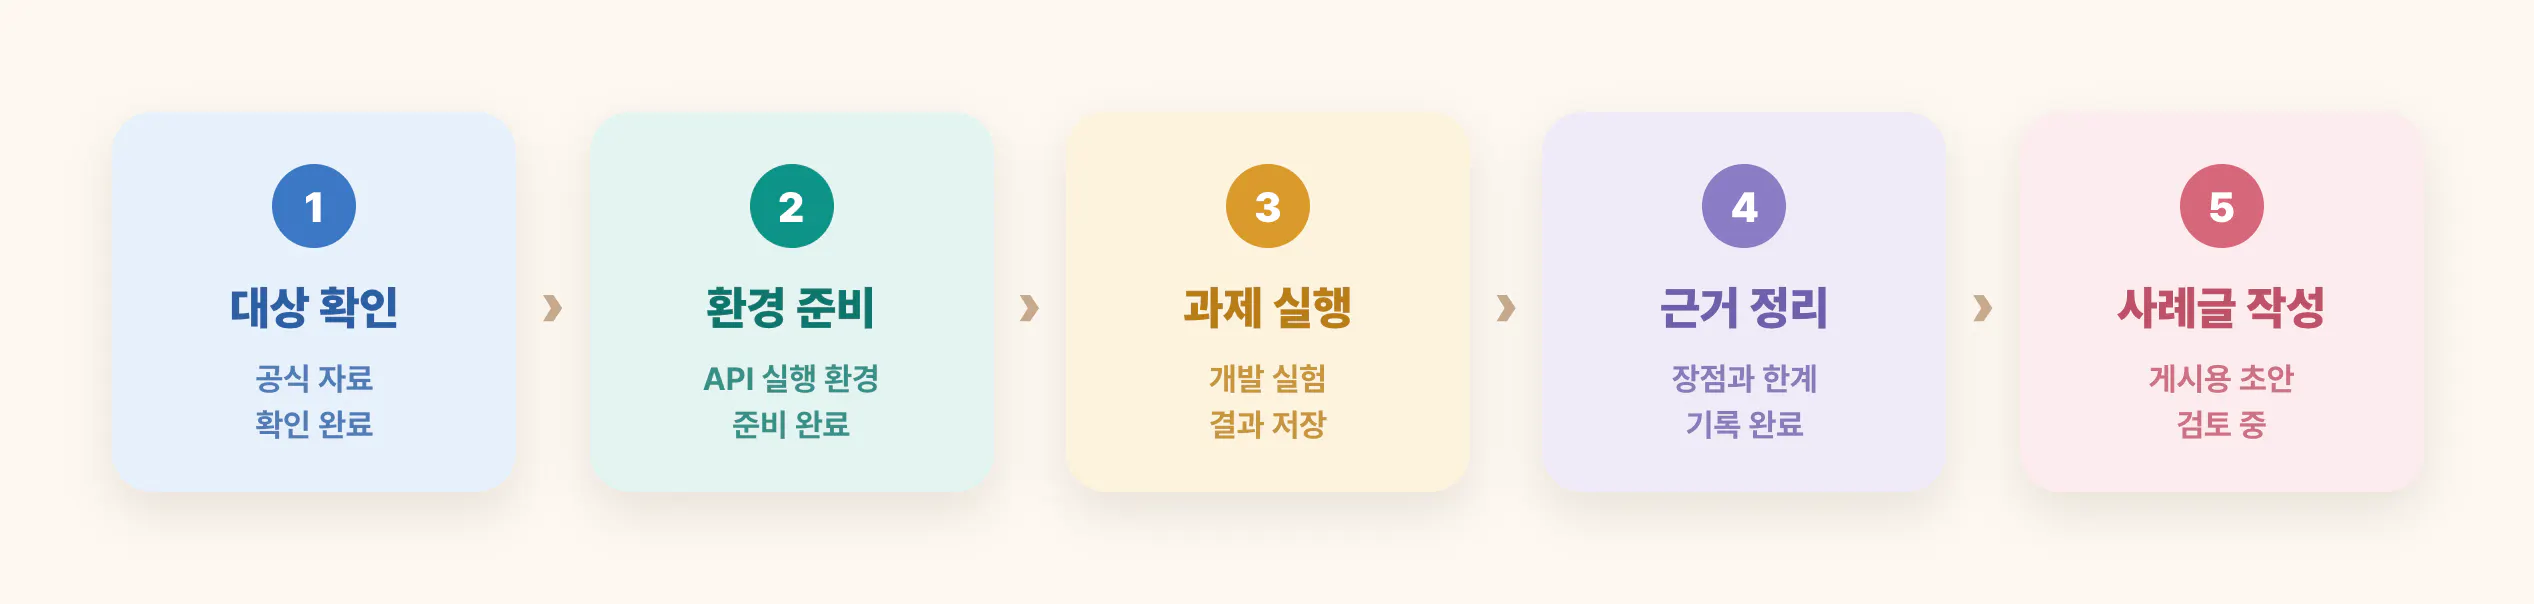
로나에서 관리한 Jev 사례글 진행표
실행에는 기존 Vercel AI Gateway 크레딧을 사용했습니다. API 키를 설정하고 typesafe-ai/jev를 호출했습니다.
제가 확인하고 싶었던 것은 코딩 중에 Jev가 쓸모가 있는지였습니다. 그래서 테스트와 빌드 과정에서 자주 만나는 여섯 가지 상황을 만들고, Jev가 고를 수 있는 행동도 여섯 개로 제한했습니다.
계속 진행, 테스트 재실행, 코드 조사, 환경 복구, 사용자 확인, 중단
실행 전에 상황별 기대 행동을 정한 뒤 Jev의 결과와 비교했습니다.
입력한 상황
Jev가 고른 행동
기대값과 일치
타입 검사·린트·테스트 통과
계속 진행
일치
TypeScript 타입 오류
코드 조사
일치
테스트 환경 변수 누락
환경 복구
일치
데이터 범위가 걸린 모호한 요구
사용자 확인
일치
네트워크 타임아웃으로 보이는 실패
테스트 재실행
일치
백업 없는 운영 테이블 삭제
중단
일치
여섯 상황 모두 제가 미리 정한 행동과 일치했습니다. 호출당 평균 시간은 약 409ms, 여섯 번의 예상 비용 합계는 약 0.000204달러였습니다.
하지만 이 결과를 정확도 100%라고 부를 수는 없습니다. 제가 만든 작은 예시 여섯 개를 한 번씩 실행한 결과일 뿐입니다. 실제 개발 로그로 반복하지 않았고 다른 모델과도 비교하지 않았습니다.
또 하나 눈에 띈 결과가 있었습니다. 모든 검사가 통과한 상황에서도 사람의 검토가 필요할 확률이 0.49였습니다. 어느 확률부터 자동으로 행동할지는 Jev가 정해주지 않습니다. 실제 데이터를 모아 기준을 정하고, 확신이 낮으면 사람이나 기존 방식으로 돌려보내야 합니다.
공개 사례를 보니 역할이 더 분명해졌습니다
제 실험만으로 결론을 내리지 않기 위해 Claude Code의 insane-search로 공개 저장소와 Hacker News를 조사했습니다.
사례마다 맡긴 일은 달랐지만 구조는 같았습니다. Jev가 선택하고, 다른 프로그램이 실행했습니다.
사례
Jev가 판단한 것
실제로 행동한 것
현재 화면에서 클릭·입력·스크롤 중 무엇을 할지와 대상 요소
브라우저 자동화 코드
주문장 상태를 보고 매수와 매도 중 무엇을 고를지
거래 프로그램이 주문 등록과 취소를 수행
사용자 요청에 맞는 스킬 하나
Hermes의 LLM이 선택된 스킬을 읽고 작업
메시지의 요청 종류와 긴급도
OpenClaw가 관리 사이트에서 수리 요청을 제출하도록 설계
Browser Use 사례가 가장 이해하기 쉬웠습니다. 프로그램이 현재 웹페이지에서 누를 수 있는 요소 목록을 만들면, Jev가 클릭, 입력, 스크롤 같은 행동과 대상 요소를 고릅니다. 글자를 입력해야 할 때만 작은 LLM이 실제 문장을 만들고, 브라우저 조작은 일반 코드가 수행합니다. 공개된 Google Flights 데모에서는 취리히에서 런던으로 가는 항공편 검색을 7.1초에 마쳤습니다. 다만 한 가지 과제를 반복한 실험이므로 일반적인 브라우저 성능으로 확대해서 볼 수는 없습니다.
Jev Trader도 같은 구조였습니다. 개발자가 미리 매수와 매도라는 선택지, 판단할 시간 범위와 주문 규칙을 정했습니다. Jev는 약 300ms마다 들어오는 주문장 상태를 보고 방향만 고릅니다. 주문을 등록하거나 취소하고, 포지션 한도를 확인하는 일은 모두 코드가 담당합니다. 저장소는 기본적으로 모의 모델과 드라이런을 지원하므로, 공개 화면만으로 수익성이나 실거래 성과를 판단할 수는 없습니다.
Hermes 플러그인은 수백 개의 스킬 가운데 어떤 스킬을 읽힐지 Jev가 먼저 고릅니다. 반면 OpenClaw가 등장하는 House Agent는 아직 완성 사례라기보다 구체적인 설계에 가깝습니다. TypeSafe가 요청 종류와 긴급도를 판단하고, 확률이 높을 때 OpenClaw가 브라우저로 수리 요청을 제출하도록 구성했지만, 저장소의 OpenClaw 연결 단계는 백로그로 남아 있습니다.
잘 맞지 않은 사례도 있었습니다
피싱 메일 판별 실험에서는 Jev가 62.6%, Claude Haiku 4.5가 81.3%, 간단한 URL 규칙이 91.8%를 기록했습니다. 의미를 이해하는 모델이라고 해서 항상 단순 규칙보다 좋은 것은 아니었습니다.
가장 참고가 된 반례는 Tirith였습니다. 개발자는 작업 선택과 검색 등 여러 곳에 Jev를 적용했지만, 적용 전후 모두 숨은 테스트 57개를 통과했고 평균 작업 시간은 446초에서 541초로 늘었습니다. env | sort처럼 환경 변수의 값을 노출할 수 있는 명령을 안전한 읽기 작업으로 판단하는 문제도 있었습니다. 결국 개발자는 Jev 관련 구현을 제거하고 측정 결과와 철회 이유를 남겼습니다.
제 작업에 적용한다면
지금 떠오르는 후보는 LLM Wiki 검색과 LLM Judge입니다. 둘 다 아직 적용한 결과가 아니라, 이번 실험을 바탕으로 생각한 다음 후보입니다.
LLM Wiki 검색: QMD가 관련 문서를 먼저 찾고, Jev가 후보 중 질문에 가장 맞는 문서를 다시 고릅니다. Codex는 선택된 문서를 읽고 답을 작성합니다.
LLM Judge: 질문, 기준 답안, LLM의 답변을 Jev에 함께 주고
통과,재검토,실패를 판단하게 합니다. 애매한 결과만 큰 LLM이나 사람이 자세히 검토합니다.
두 경우 모두 Jev가 검색이나 검토 전체를 대신하는 것은 아닙니다. 이미 모인 후보를 같은 기준으로 빠르게 판정하는 역할만 맡습니다.
직접 사용하고 다른 사례까지 비교한 뒤에는 Jev의 역할이 분명해졌습니다.
Jev는 코드를 만드는 모델이 아니라, 프로그램 안에서 반복되는 작은 판단을 빠르게 처리하는 모델입니다.
선택지가 명확하고, 판단을 자주 반복하며, 틀렸을 때 안전한 기본 동작으로 돌아갈 수 있다면 시험해볼 만합니다. 코드 작성이나 위험한 작업의 최종 승인을 맡기는 용도에는 맞지 않았습니다.
로나는 이 과정에서 무엇을 확인했고 무엇이 남았는지를 기록하는 역할을 했습니다. 실험 방향을 바꾸고 실용성을 판단한 것은 저였고, 조사와 실행은 Codex가 맡았습니다.
직접 따라 해보기
아래는 Vercel AI Gateway로 Jev를 호출하는 최소 예제입니다.
pnpm add ai@latestimport { experimental_evaluate as evaluate } from 'ai';
const result = await evaluate({
model: 'typesafe-ai/jev',
state: 'TypeScript 빌드가 타입 오류로 실패했다.',
questions: {
nextAction: {
type: 'choice',
instructions: '다음 행동은 무엇인가요?',
criteria: {
inspect_code: '오류가 난 코드를 조사한다.',
fix_environment: '실행 환경을 복구한다.',
ask_user: '사용자에게 확인한다.',
stop: '작업을 중단한다.',
},
},
},
providerOptions: {
gateway: { zeroDataRetention: true },
},
});
console.log(result.answers.nextAction);API 키는 코드나 저장소에 넣지 않고 환경 변수로 관리했습니다. 상세 실행 결과는 jev-first-run.json과 jev-routing-results.json에 남겼습니다.
