문과생도 크롤링 2주차 과제 100개 크롤링 실패기
2024.06.24
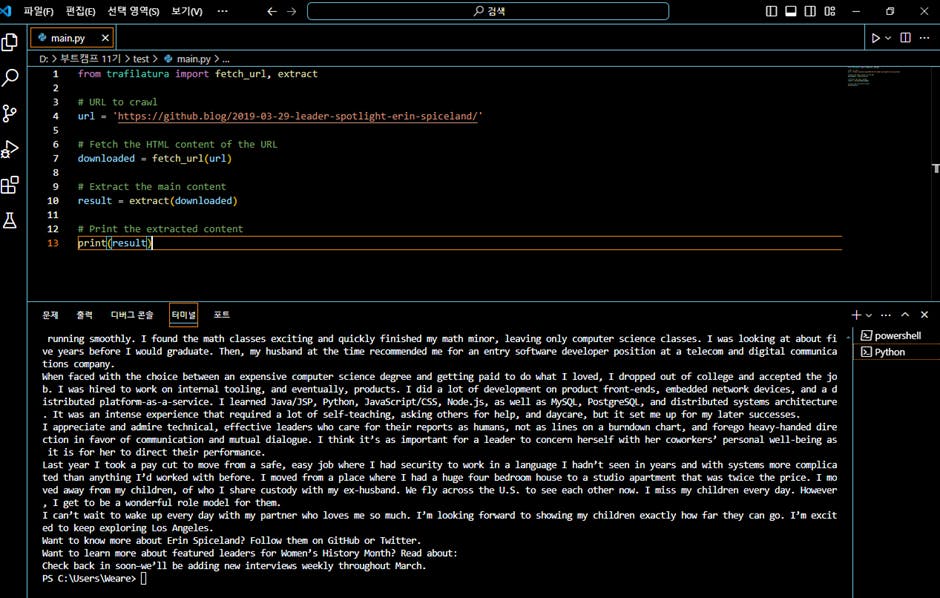
단순한 페이지 1개 크롤링은 성공했지만 100개 링크 크롤링은 실패했습니다.
어디서 잘 못된건지 아직도 혼란스럽네요 ㅠㅠ
vod영상을 돌려보아도 어디서 어떻게 잘 못된건지 조차 진단이 안되요.
우선 공유해주신 트라필라투라로 크롤링 기초 실습 노션을 보고 따라했습니다.
[페이지 크롤링]>성공
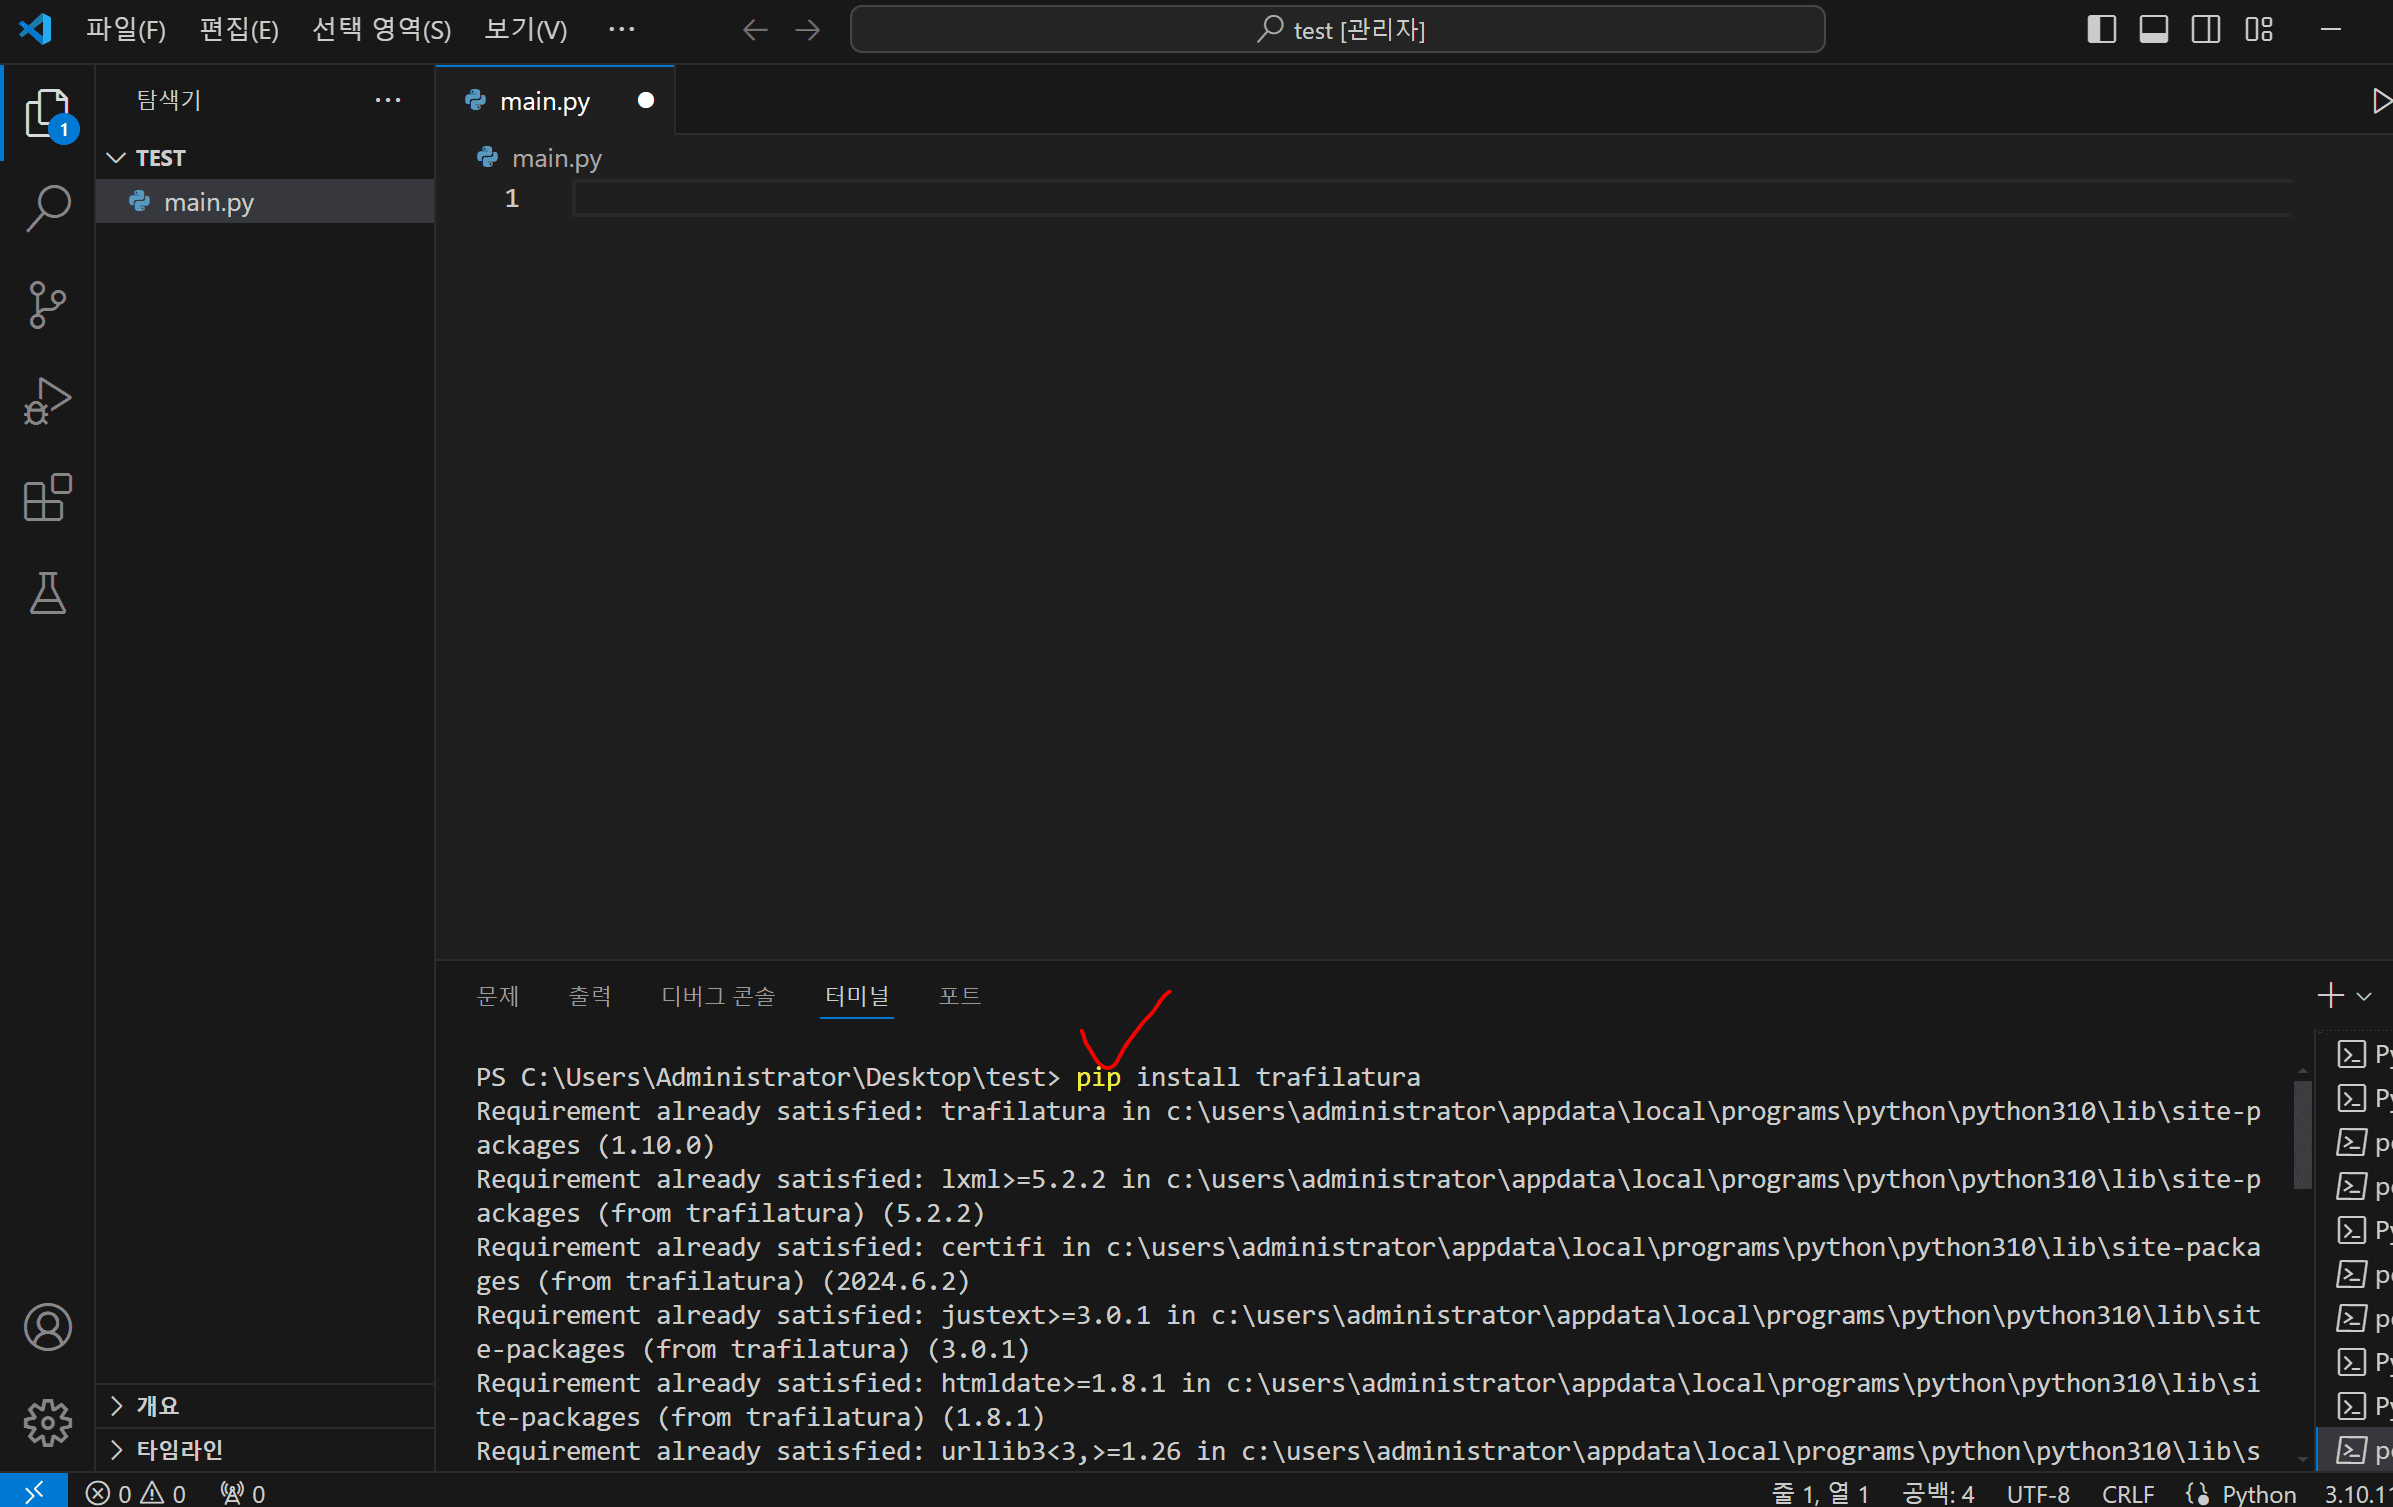
1. 터미널에 pip install trafilatura 입력
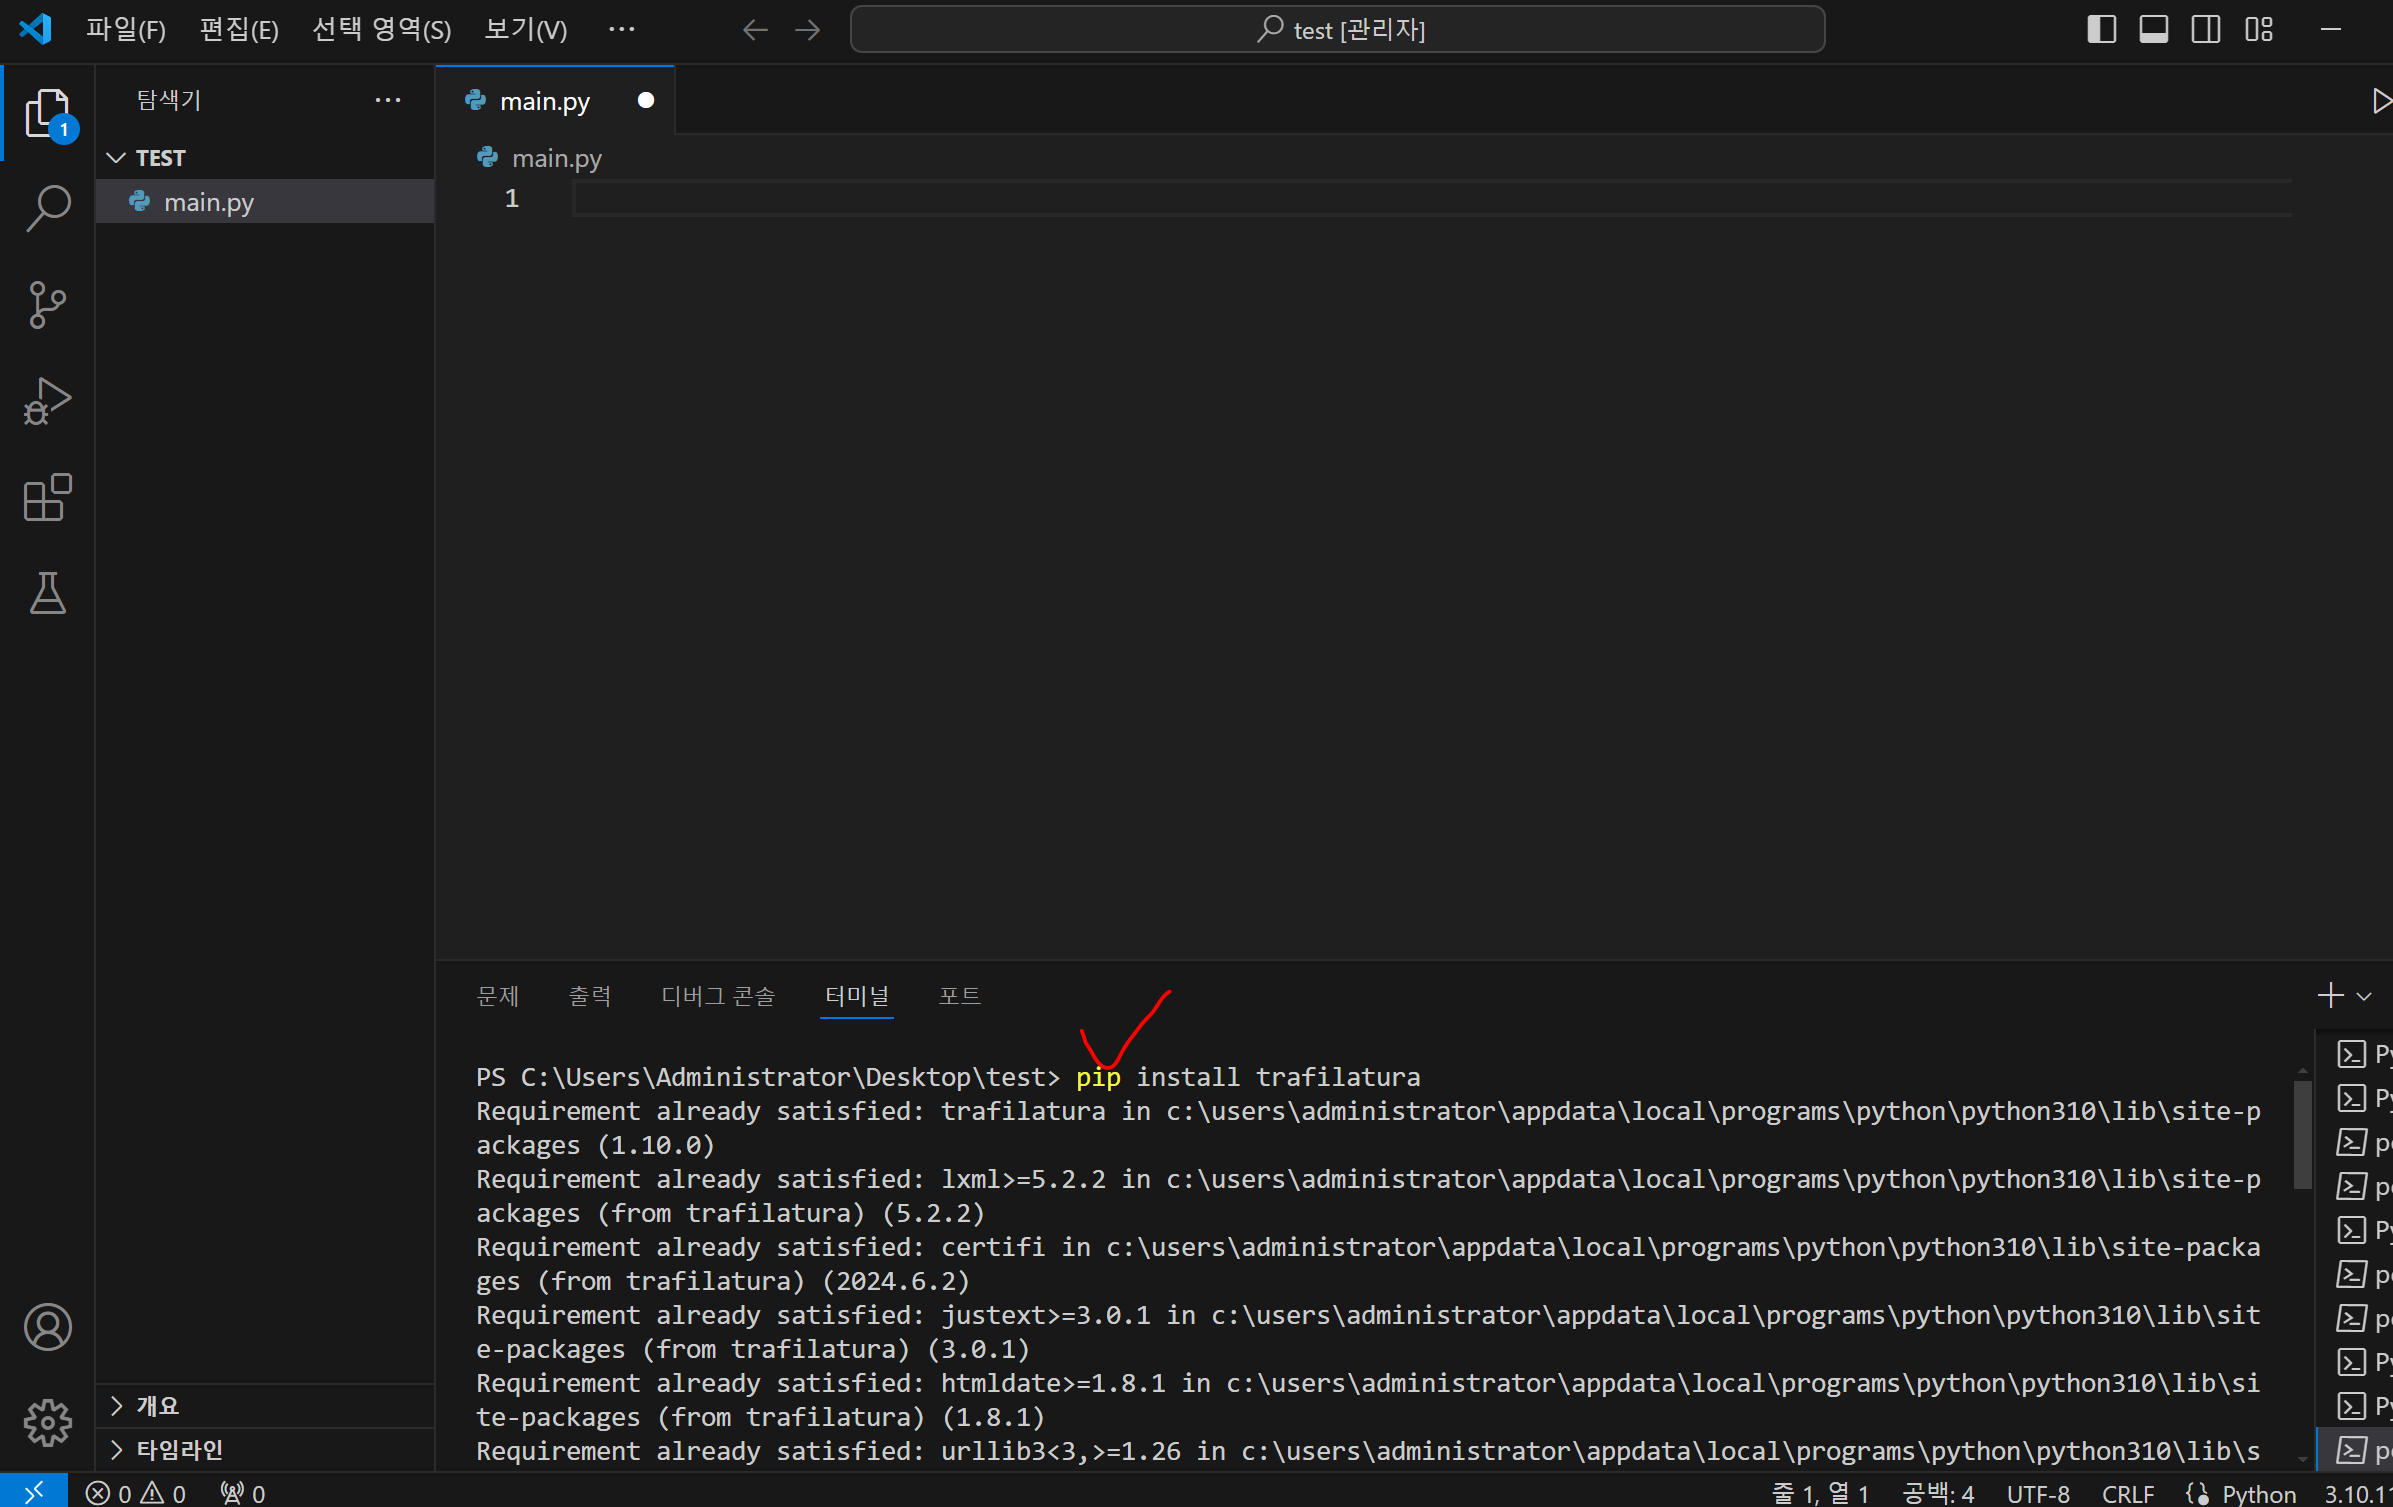
chat gpt가 짜준 코드 실행>성공
[네이버 스포츠 웹페이지 기사 100개 페이지 크롤링 도전]>실패
( https://sports.news.naver.com/wbaseball/index )
1.pip install requests beautifulsoup4 trafilatura 설치
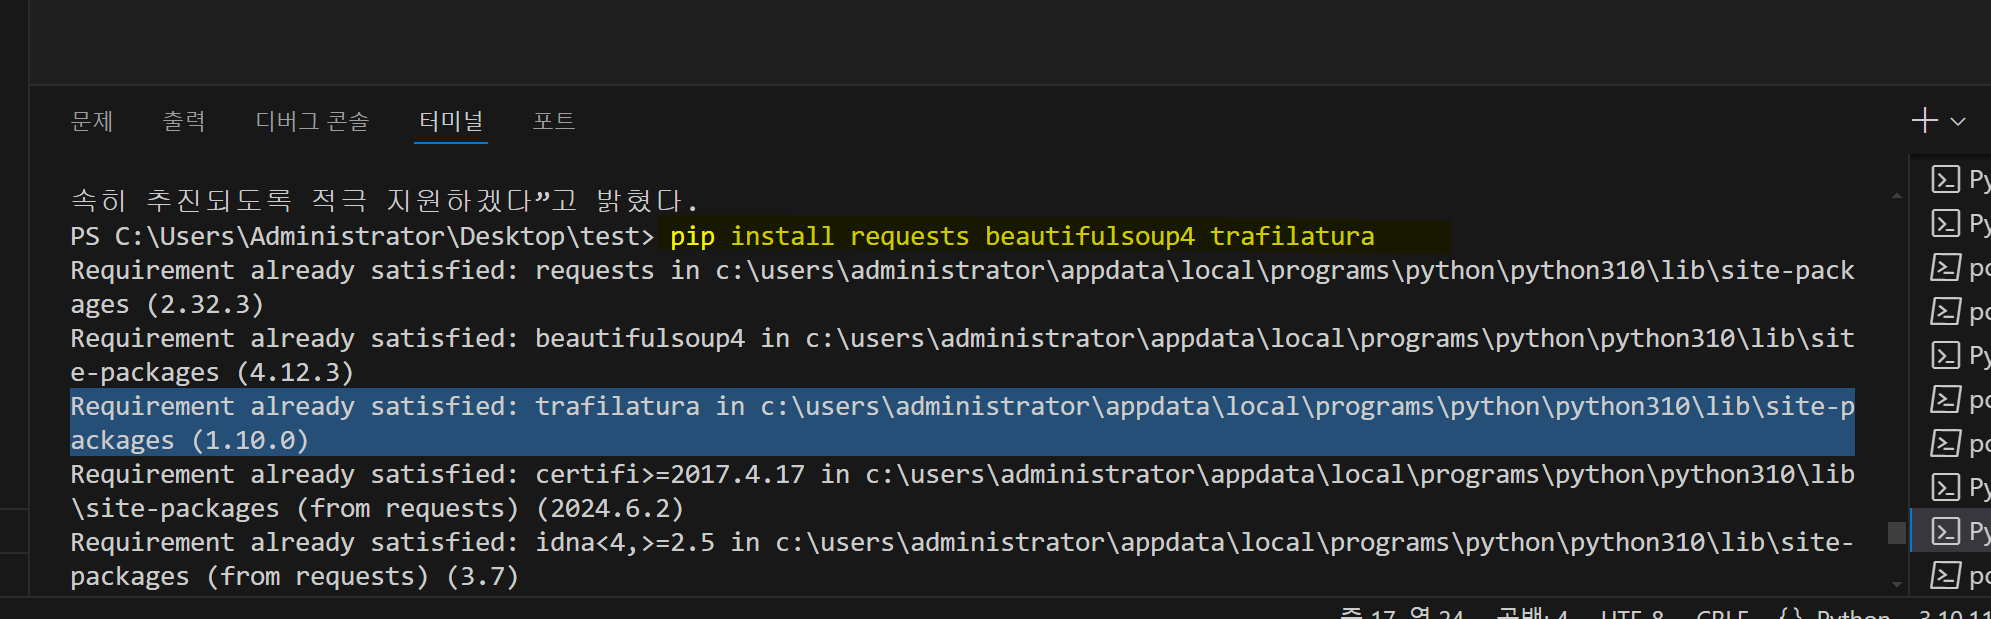
파이썬 코드 작성
import requests
from bs4 import BeautifulSoup
import trafilatura
# 헤드라인 뉴스 링크를 크롤링하는 함수
def get_headline_links(url):
response = requests.get(url)
if response.status_code == 200:
soup = BeautifulSoup(response.content, 'html.parser')
# 헤드라인 뉴스 링크 선택자
links = soup.select('.headline_list a')
headline_links = ['https://sports.news.naver.com' + link['href'] for link in links if link['href'].startswith('/news?oid')]
return headline_links
else:
print("페이지를 불러오는데 실패했습니다.")
return []
# URL에서 텍스트를 크롤링하는 함수
def extract_text_from_url(url):
downloaded = trafilatura.fetch_url(url)
if downloaded:
result = trafilatura.extract(downloaded)
return result
else:
print(f"{url}에서 콘텐츠를 다운로드하는데 실패했습니다.")
return None
# 메인 실행 부분
headline_url = 'https://sports.news.naver.com/wbaseball/index'
headline_links = get_headline_links(headline_url)
for link in headline_links:
print(f"크롤링 중: {link}")
text = extract_text_from_url(link)
if text:
print(text)
print("\n" + "="*80 + "\n")
첫번째 크롤링했던 결과값이 나옴.
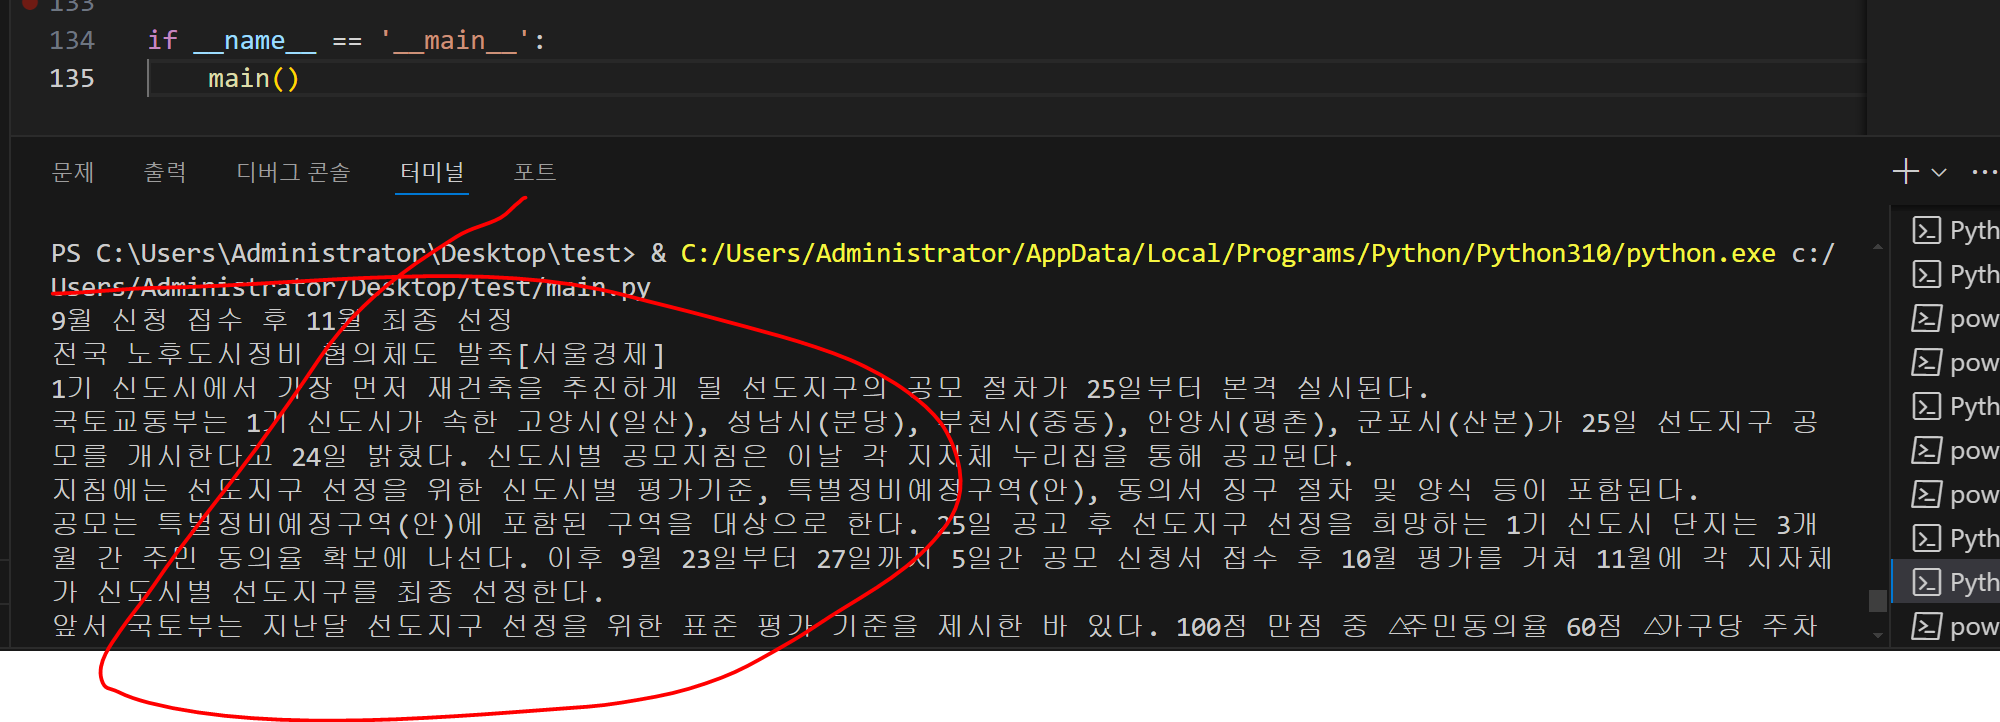
아래 메인 실행 부분이 잘 안됬나 싶어 CHAT GPT에게 도움요청.
헤드라인 뉴스 URL을 지정하고, get_headline_links 함수를 사용하여 링크를 크롤링합니다.
각 링크에 대해 extract_text_from_url 함수를 호출하여 텍스트를 추출하고 출력합니다.
새 코드를 짜줌
import requests
from bs4 import BeautifulSoup
import trafilatura
# 헤드라인 뉴스 링크를 크롤링하는 함수
def get_headline_links(url):
response = requests.get(url)
if response.status_code == 200:
soup = BeautifulSoup(response.content, 'html.parser')
# 헤드라인 뉴스 링크 선택자
links = soup.select('.headline_list a')
headline_links = ['https://sports.news.naver.com' + link['href'] for link in links if link['href'].startswith('/news?oid')]
return headline_links
else:
print("페이지를 불러오는데 실패했습니다.")
return []
# URL에서 텍스트를 크롤링하는 함수
def extract_text_from_url(url):
downloaded = trafilatura.fetch_url(url)
if downloaded:
result = trafilatura.extract(downloaded)
return result
else:
print(f"{url}에서 콘텐츠를 다운로드하는데 실패했습니다.")
return None
# 메인 실행 부분
def main():
headline_url = 'https://sports.news.naver.com/wbaseball/index'
headline_links = get_headline_links(headline_url)
for link in headline_links:
print(f"크롤링 중: {link}")
text = extract_text_from_url(link)
if text:
print(text)
print("\n" + "="*80 + "\n")
if name == '__main__':
main()
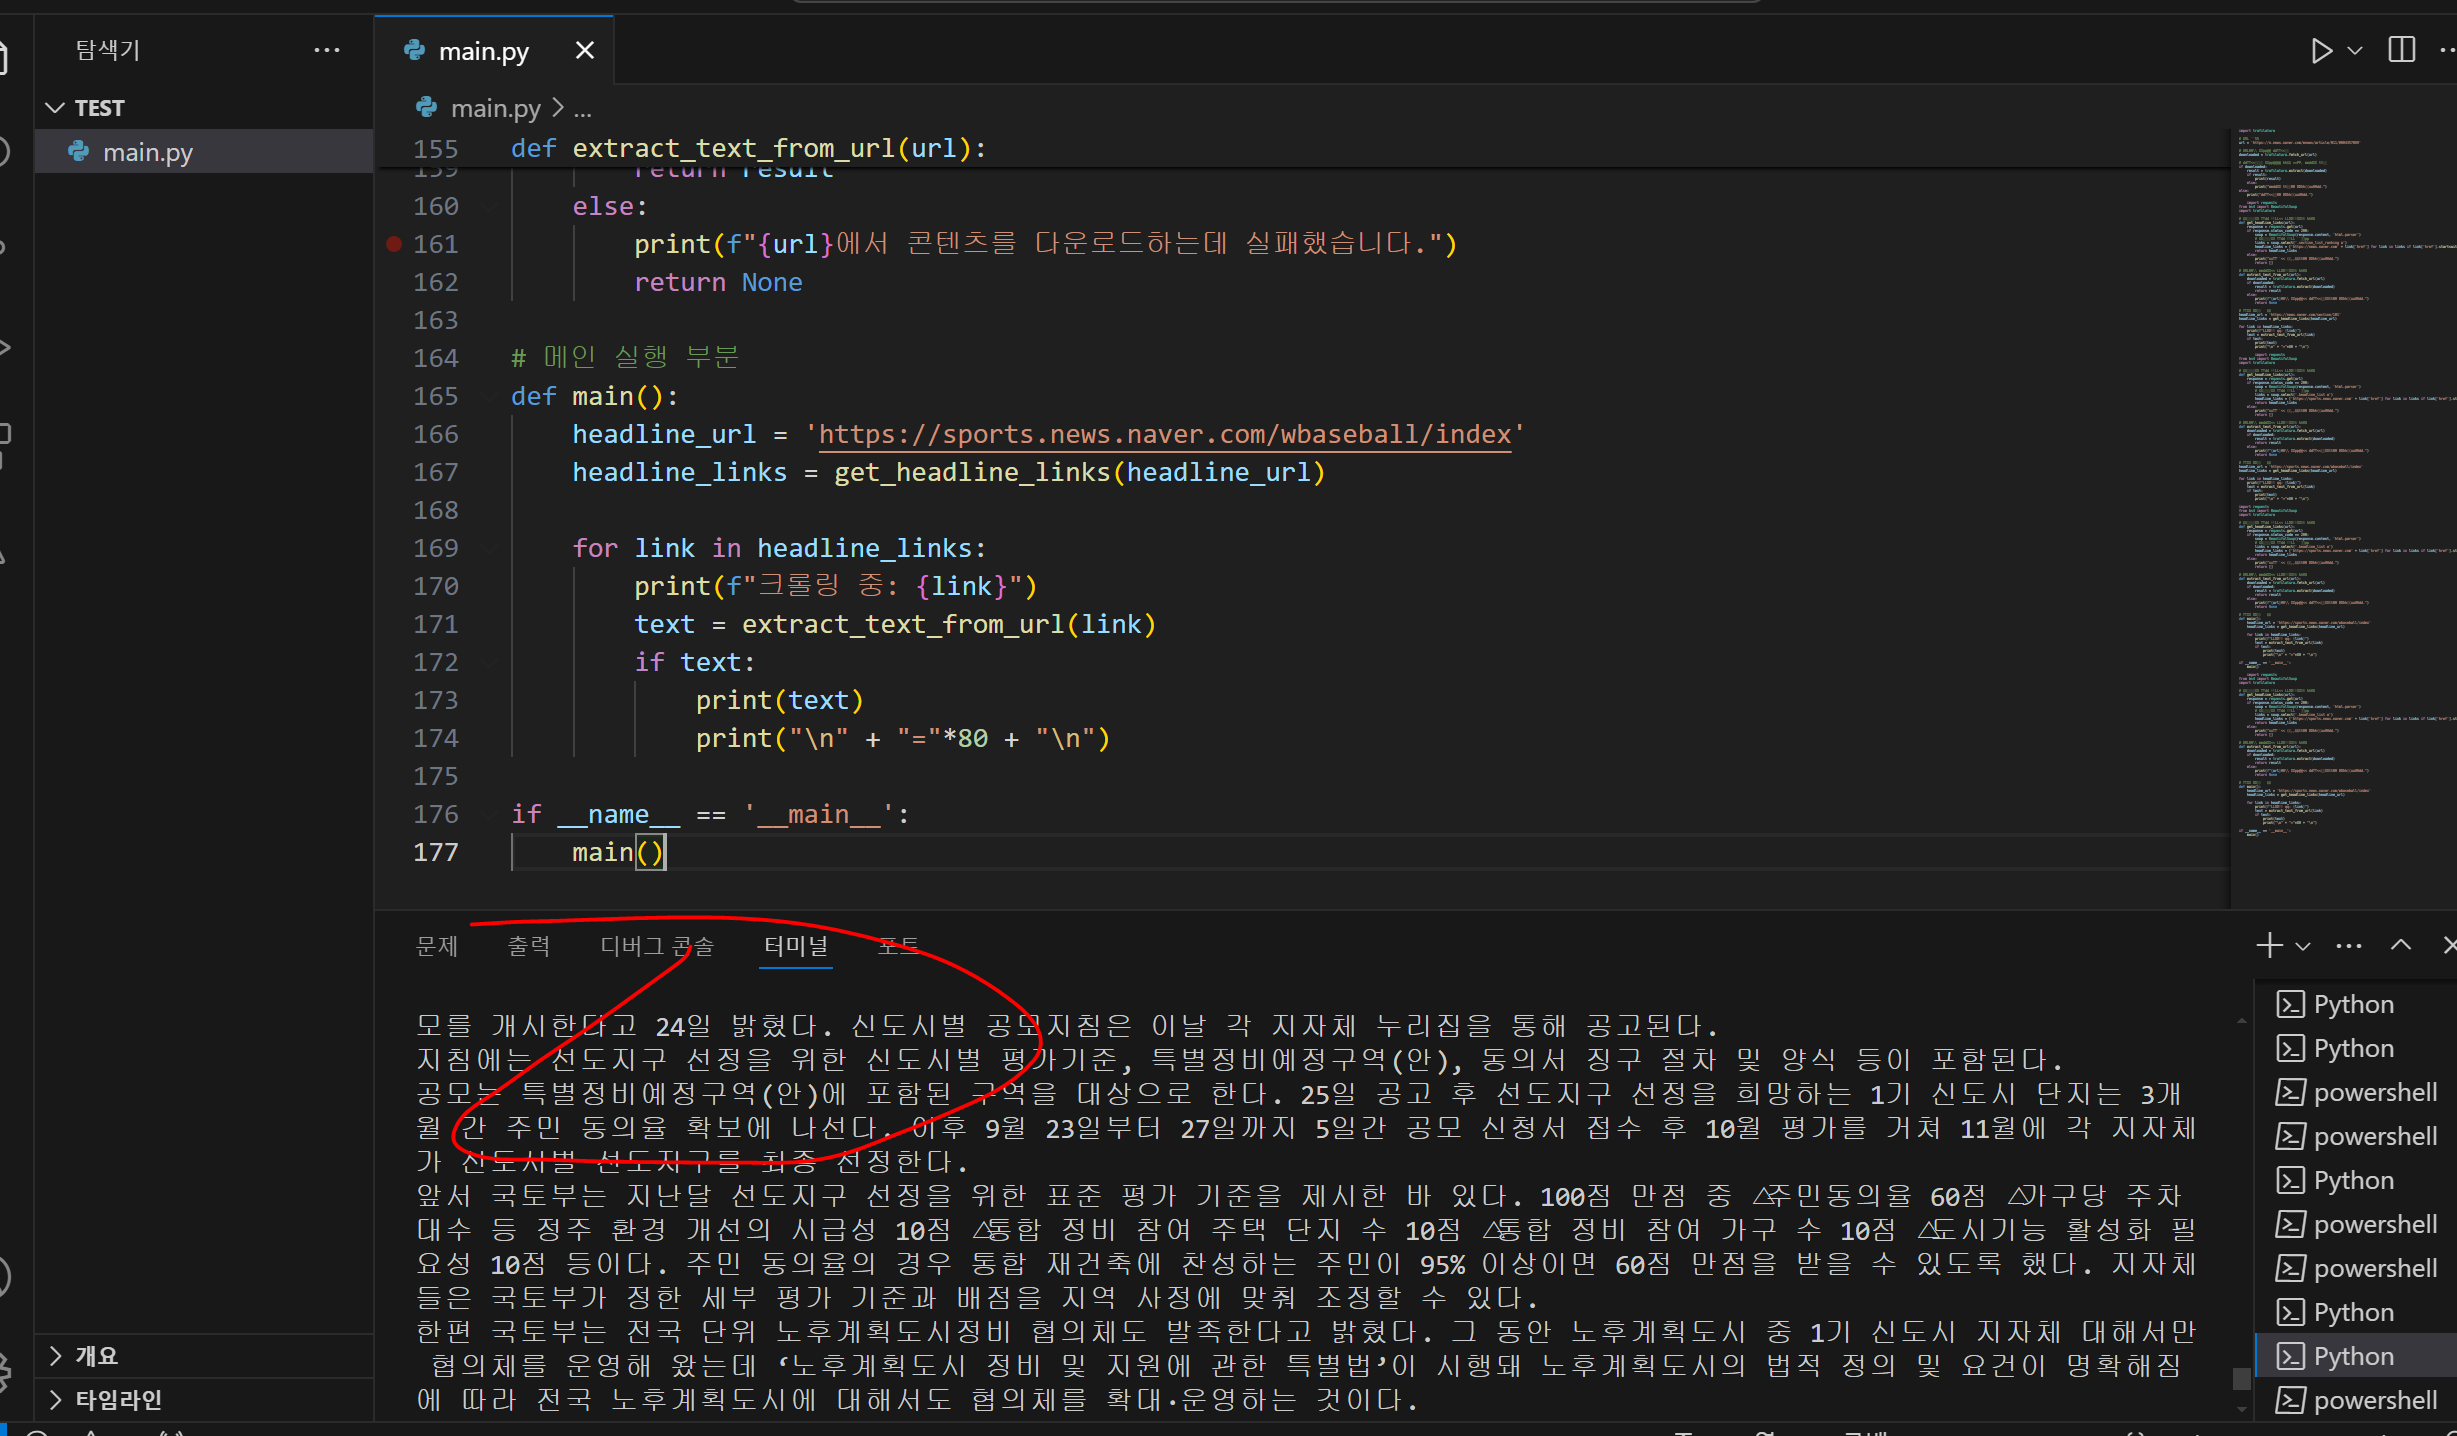
새 코드에도 여전히 첫번째 크롤링 결과값이나옴.
로그인하고 댓글을 남겨 주세요
import requests
from bs4 import BeautifulSoup
import trafilatura
# 헤드라인 뉴스 링크를 크롤링하는 함수
def get_headline_links(url):
response = requests.get(url)
if response.status_code == 200:
soup = BeautifulSoup(response.content, 'html.parser')
# 헤드라인 뉴스 링크 선택자
links = soup.select('.headline_list a')
headline_links = ['https://sports.news.naver.com' + link['href'] for link in links if link['href'].startswith('/news?oid')]
return headline_links
else:
print("페이지를 불러오는데 실패했습니다.")
return []
# URL에서 텍스트를 크롤링하는 함수
def extract_text_from_url(url):
downloaded = trafilatura.fetch_url(url)
if downloaded:
result = trafilatura.extract(downloaded)
return result
else:
print(f"{url}에서 콘텐츠를 다운로드하는데 실패했습니다.")
return None
# 메인 실행 부분rheadline_url = 'https://sports.news.naver.com/wbaseball/index'
headline_links = get_headline_links(headline_url)
for link in headline_links:
print(f"크롤링 중: {link}")
text = extract_text_from_url(link)
if text:
print(text)
print("\n" + "="*80 + "\n")
—-
제가 이코드를 돌려봤는데 아무런 출력이 안뜨더라고요..
지원님 혹시 원하시는 부분이
https://sports.news.naver.com/wbaseball/news/index?isphoto=N
이 사이트에 있는 뉴스를 크롤링 하는걸까요?

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
안녕하세요 한지원님!
제가 과제로 드린 링크에는 100개의 이상의 링크가 스크롤 다운하면 자동으로 생겨서 그렇게 내드린것인데
https://sports.news.naver.com/wbaseball/index
지원님께서 원하시는 사이트는 제가 과제로 드린 사이트와는 다르게 작동하는 웹이에요!
→ 따라서 웹마다 다르게 코딩을 하셔야 합니다!
그래도 100개는 실패하셨지만, 크롤링에 성공하신것을 축하드리고,
3주차때 제가 셀레니움 관련해서 설명드릴 때 들으시면 좋을 것 같습니다!!
너무 수고 많으셨어요! 😄
소중한 사례 감사드립니다!!