[8기 랭체인방] 이력서를 첨삭해주는 멀티모달 튜터
2023.11.30
안녕하세요. 이번에 지피터스에 입문하게되어 부트캠프까지 신청하고 한창 랭체인을 ‘뚝딱뚝딱’ 사용해보고 있습니다. 최근에 GPT-Vision 성능이 너무 좋길래 관심있게 보고 있었는데 RAG 멀티모달 관련해서 개인과제로 진행해봤습니다.
개인과제
멀티 모달 이력서 첨삭 튜터
배경 : 사람인 인공지능 이력서가 3만명이 넘게 쓴다고 하는데, GPT-4 기반이 더 좋지 않을까 생각이 들었다. 그리고 이건 비젼관련된걸 첨삭을 해주진 않겠지란 생각을 했다. API 비용이 호출되지만 나만의 이력서 선생님과 뚝딱 뚝딱 CV 경력서를 적을 수 있지 않을까 재밌어보여서 해보게되었다.
기능
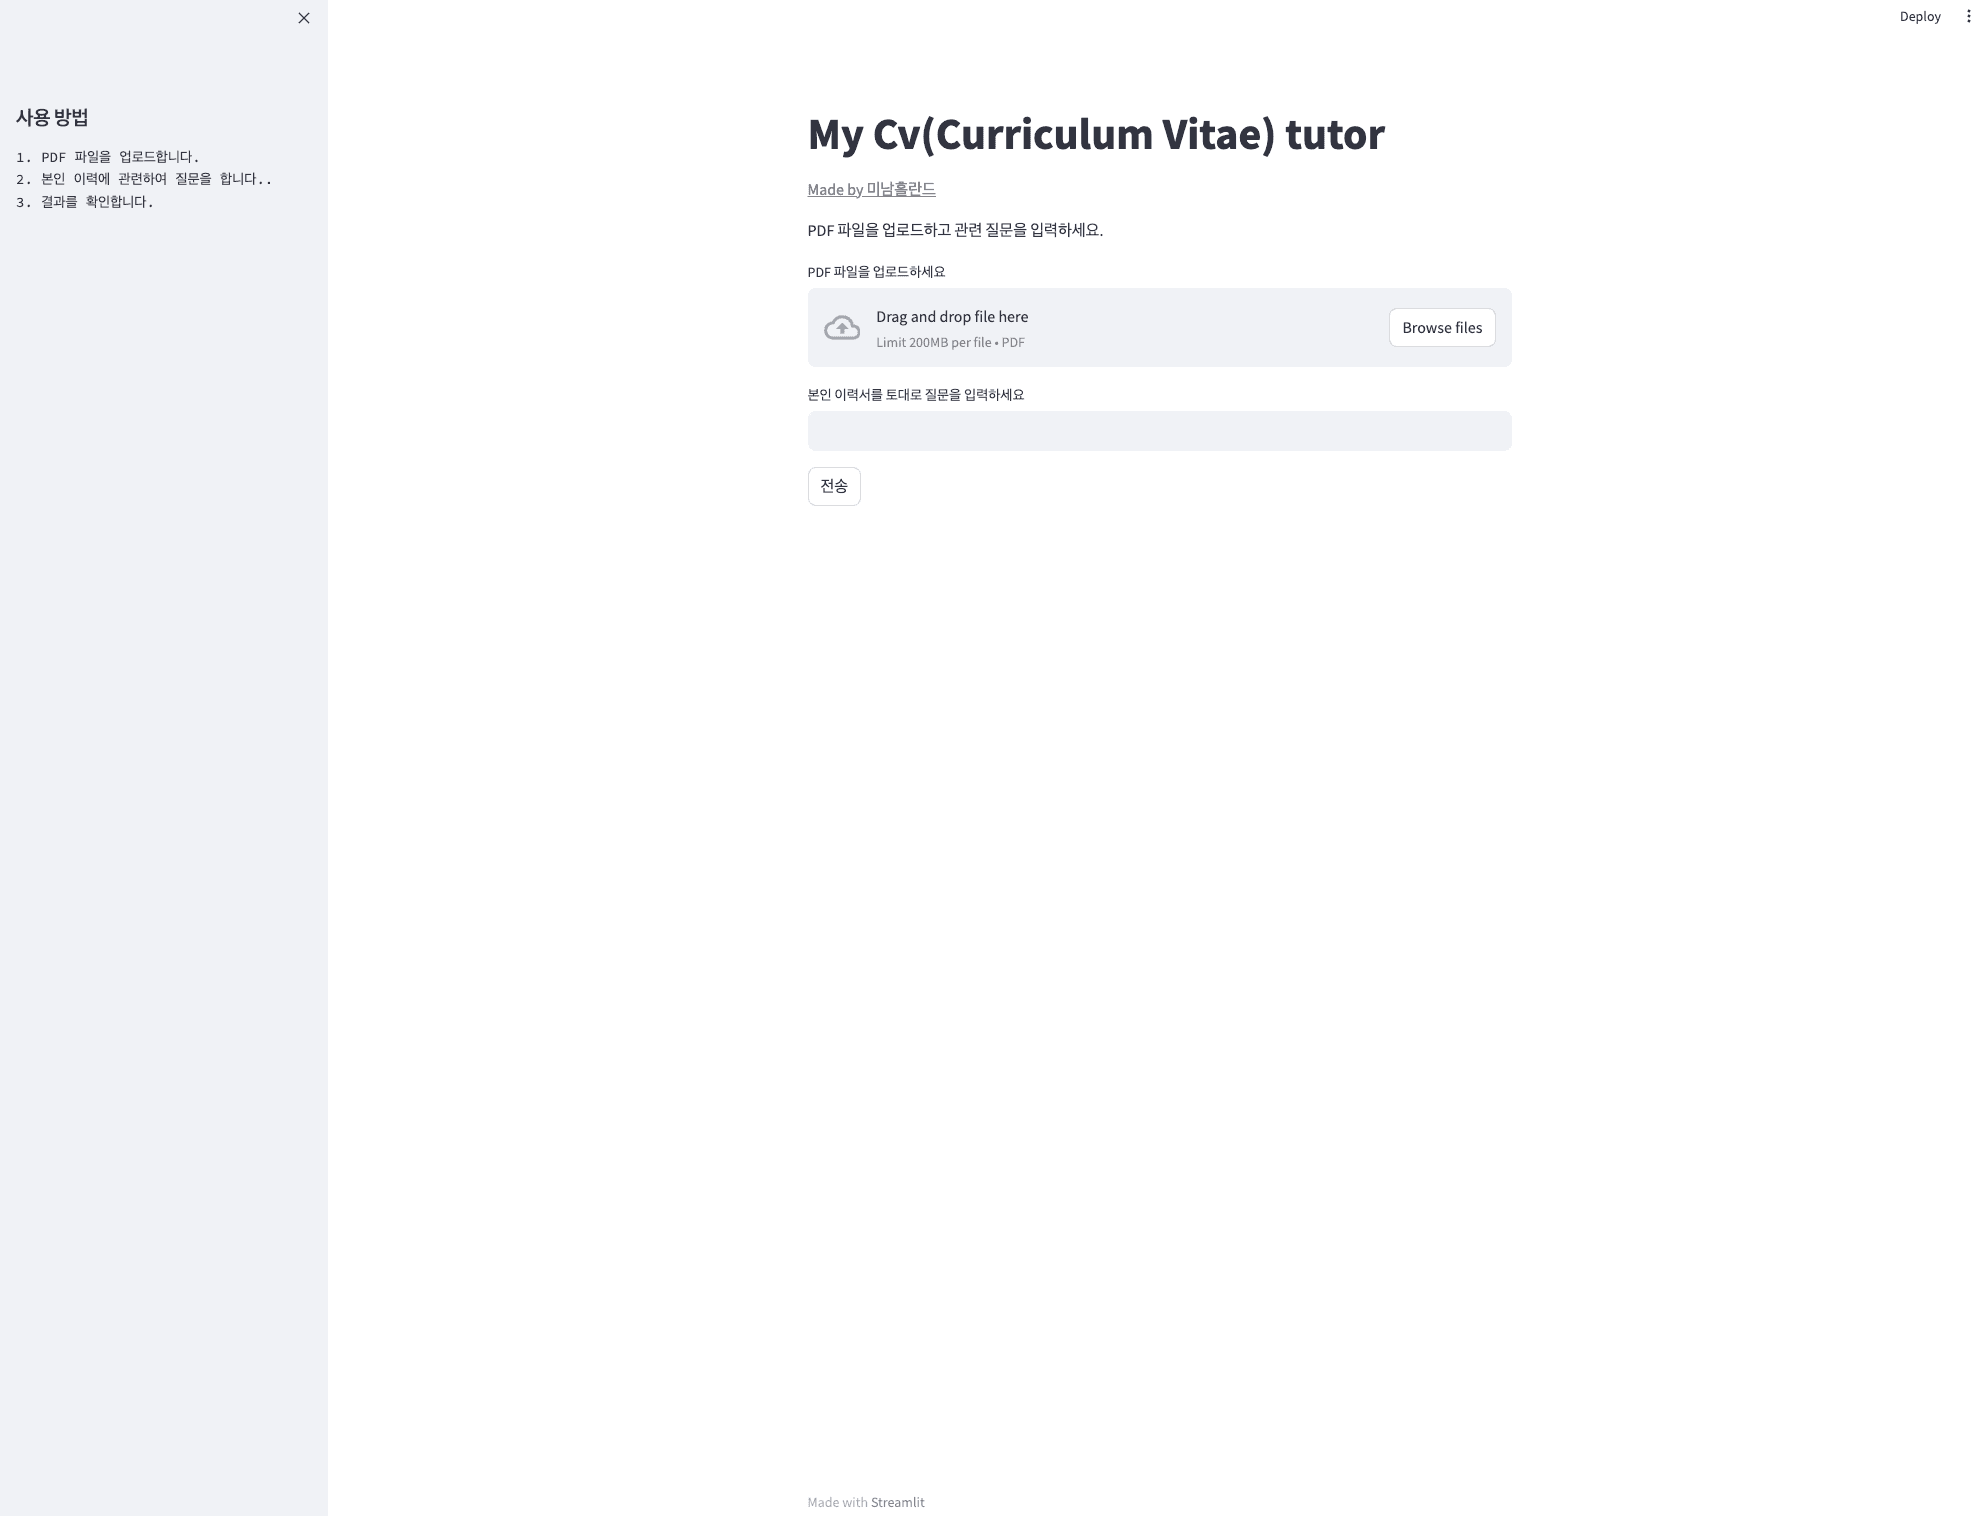
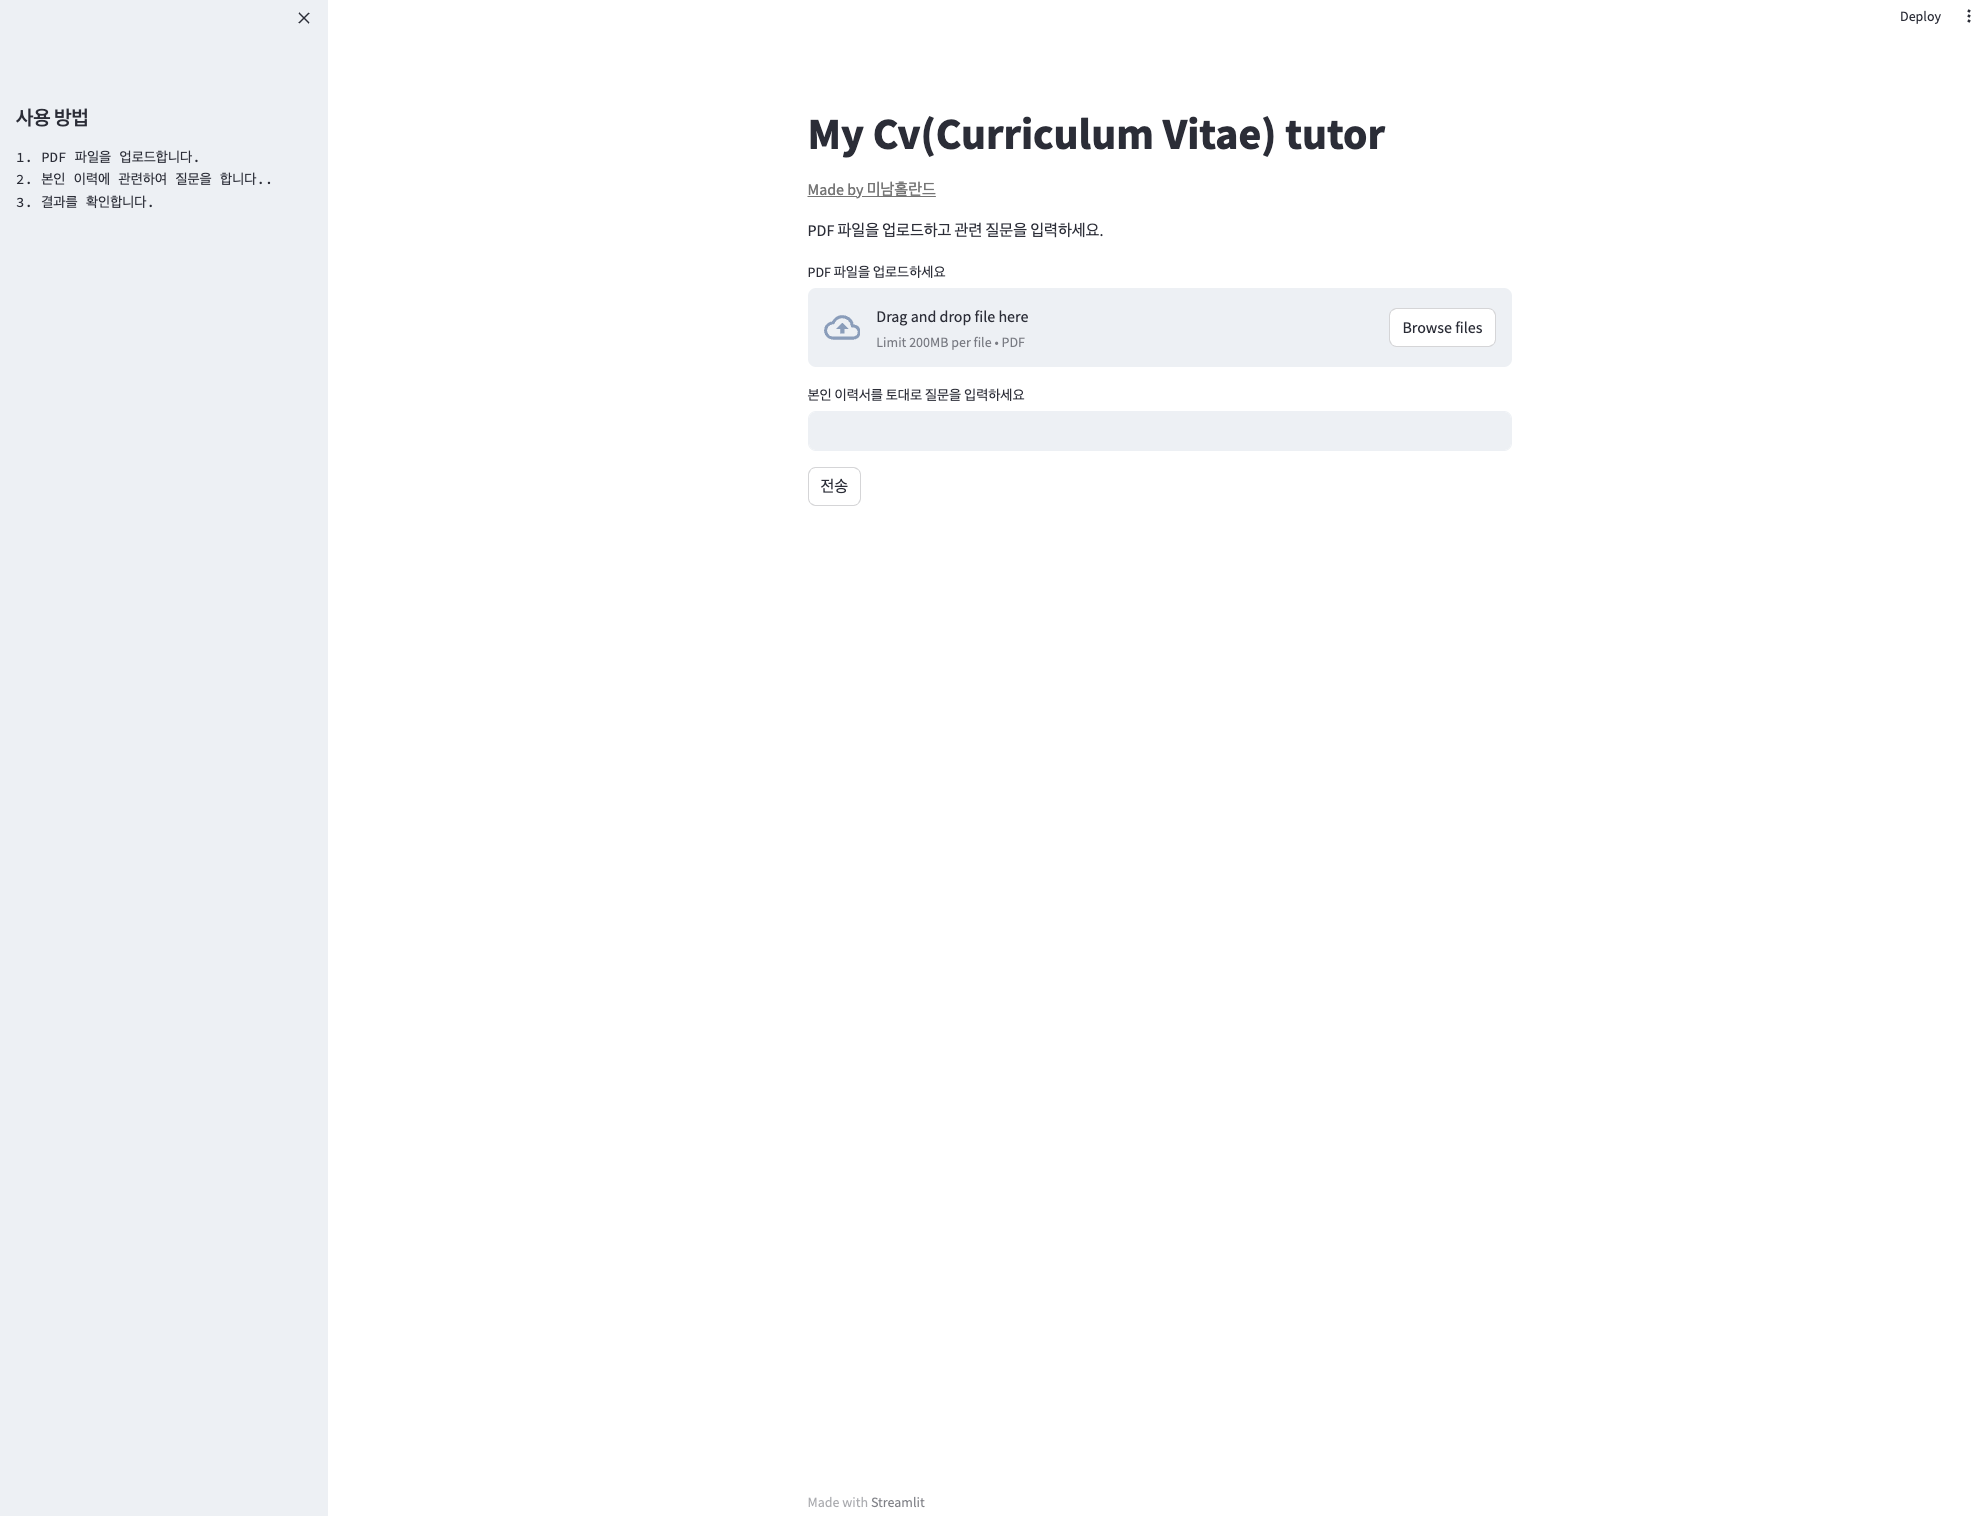
PDF 파일 업로드: 사용자는 자신의 이력서를 PDF 형식으로 업로드할 수 있습니다.
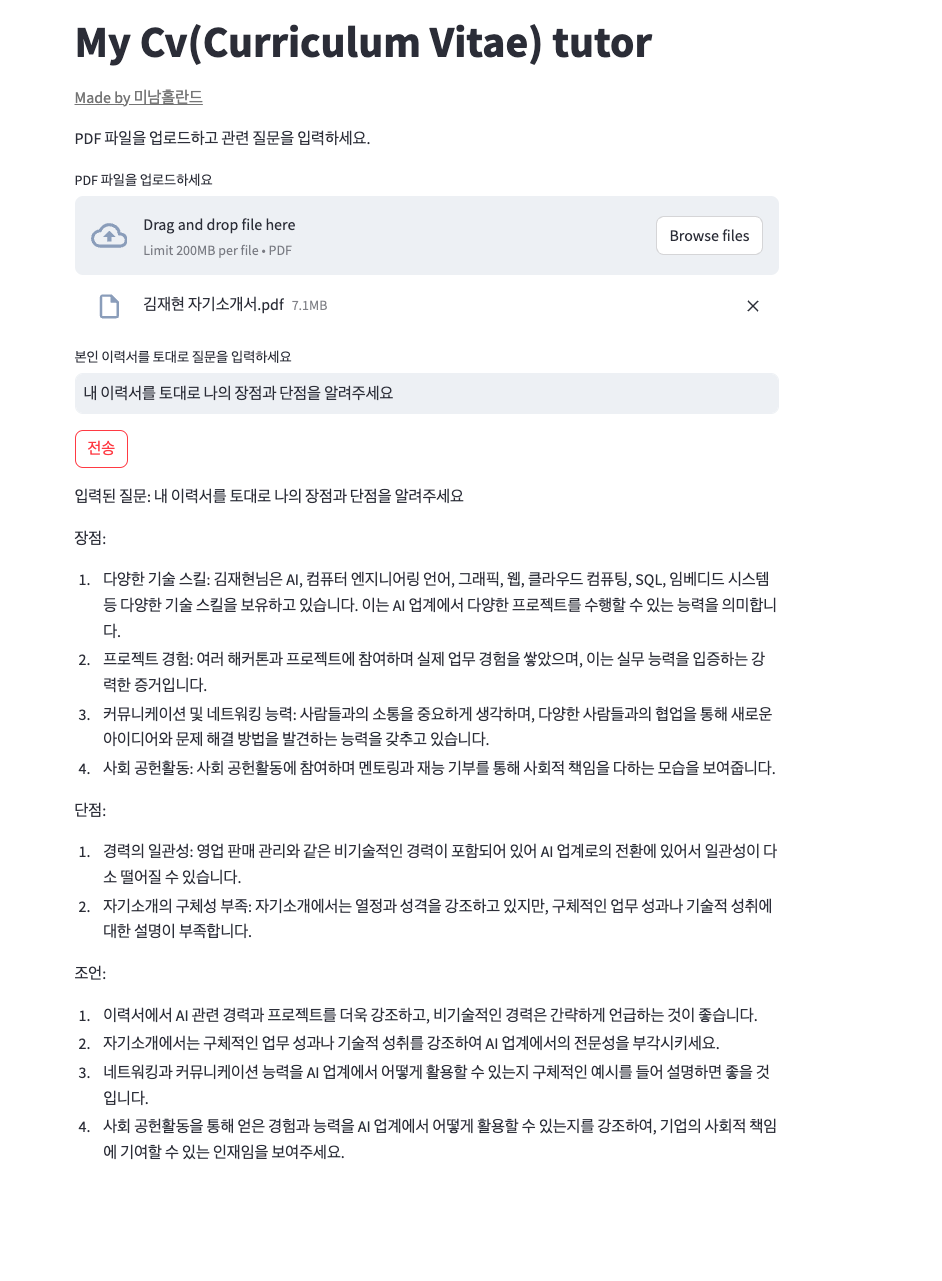
질문 입력 및 전송: 사용자는 자신의 이력서와 관련된 질문을 입력하고 전송.
AI 기반 분석 및 응답: 업로드된 이력서와 질문에 기반하여 AI가 분석을 수행하고 관련된 답변을 제공합니다.
사용방법
웹 애플리케이션에 접속합니다.
"PDF 파일을 업로드하세요" 버튼을 클릭하여 이력서 PDF 파일을 업로드합니다.
AI가 제공하는 답변을 확인합니다.
멀티모달 CV.py 함수 코드 로직
PDF 문서 처리:
extract_pdf_elements: PDF 파일에서 이미지, 테이블, 텍스트를 추출합니다.
categorize_elements: 추출된 요소를 테이블과 텍스트로 분류합니다.
텍스트 요약 및 처리:
generate_text_summaries: 텍스트 요소를 요약합니다. 요약은 GPT-4 모델을 사용하여 생성됩니다.
이미지 처리 및 요약:
encode_image, image_summarize, generate_img_summaries: 이미지를 base64 인코딩으로 변환하고 요약합니다. 여기에서도 GPT-4 모델이 사용됩니다.
멀티모달 검색 시스템 구축:
create_multi_vector_retriever: 텍스트, 테이블, 이미지의 요약을 인덱싱하여 검색할 수 있게 만듭니다. 이 과정에서 InMemoryStore, MultiVectorRetriever 등이 사용됩니다.
split_image_text_types, img_prompt_func, multi_modal_rag_chain: 검색 쿼리를 처리하기 위한 멀티모달 RAG 체인을 구성합니다. 이 체인은 검색 쿼리에 따라 텍스트와 이미지를 결합하여 GPT-4 모델에 전달합니다.
실행 및 결과 처리:
run_rag_chain: 구성된 RAG 체인을 실행하여 사용자 쿼리에 대한 결과를 반환합니다.
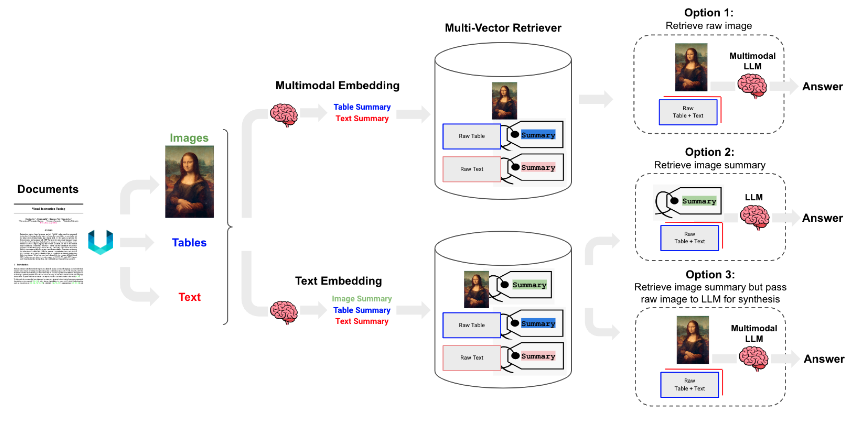
멀티모달 임베딩 : 다양한 유형의 데이터(이미지, 텍스트, 문서, 표 등)를 공통적인 벡터 공간에 매핑하여 이해할 수 있는 과정입니다. 이를 통해 모델은 이미지의 시각적 콘텐츠와 텍스트의 언어적 콘텐츠를 동일한 방식으로 처리할 수 있습니다. 각 유형의 데이터는 처리 및 요약되어 다음 단계로 전달됩니다.
벡터 리트리버는 멀티모달 임베딩을 통해 생성된 벡터를 사용하여 데이터를 검색하는 시스템입니다. 이 시스템은 복잡한 쿼리에 대응할 수 있도록 다양한 데이터 유형에서 관련 정보를 찾아내고, 이를 다음 단계의 처리(예: 대형 언어 모델)로 전달합니다.
옵션 1: 'Retrieve raw image' - 원본 이미지를 검색하여 'Multimodal LLM'(대형 언어 모델)에 전달하고, 그 결과를 'Answer'로 제공합니다.
옵션 2: 'Retrieve image summary' - 이미지 요약을 검색하여 LLM에 전달하고, 그 결과를 'Answer'로 제공합니다.
옵션 3: 'Retrieve image summary but pass raw image to LLM for synthesis' - 이미지 요약을 검색하지만 원본 이미지를 LLM에 전달하여 종합하고, 그 결과를 'Answer'로 제공합니다.
langchain
ChatOpenAI: OpenAI의 언어 모델을 활용하여 대화형 방식으로 응답을 생성하는 채팅 모델입니다.
ChatPromptTemplate: 채팅 모델의 입력을 구조화하는 데 사용되는 템플릿입니다. 특정 형식으로 문맥과 질문을 정의할 수 있습니다.
StrOutputParser: 채팅 모델의 출력을 읽기 쉽도록 문자열 형식으로 변환하는 출력 파서입니다.
CharacterTextSplitter: 긴 텍스트를 지정된 청크 크기와 겹침에 따라 작은 청크로 분할할 수 있는 텍스트 분할기입니다.
HumanMessage: 채팅 대화에서 사람이 보낸 메시지를 나타냅니다.
OpenAIEmbeddings: 텍스트를 숫자 표현으로 인코딩할 수 있는 임베딩 모델입니다.
MultiVectorRetriever: 여러 벡터 저장소를 사용하여 벡터 기반 문서 검색을 수행할 수 있는 리트리버입니다.
Document: 관련 메타데이터와 함께 텍스트를 나타냅니다.
InMemoryStore: 메모리에 문서를 저장하고 검색할 수 있는 저장 시스템입니다.
Chroma: 크로마 값을 기반으로 벡터를 저장하고 검색할 수 있는 벡터 저장소입니다.
RunnableLambda: 체인에서 실행할 사용자 정의 함수를 정의할 수 있는 런처블입니다.
RunnablePassthrough: 입력값을 체인에서 수정하지 않고 통과시키는 런너블입니다.
PyPDFLoader: PDF 파일에서 텍스트를 로드할 수 있는 문서 로더입니다.
위 과정들이 코드로는 되게 길지만 원리, 구조는 생각보다 어렵지 않았습니다. Clone 코딩을 하면서 Cookbook 따라치면서 내가 넣어야하는 형식의 데이터로만 변환을 해주었습니다. 그러니 생각보다 성능이 좋은 tutor 친구를 만나게 되었습니다. 이전의 Cookbook 을 따라하다가 PromptTemplate 단계에서 error 가 많이나서 짜증났는데 일단 클론코딩을 해보고 하나씩 이해하는게 맞구나 생각을 했습니다.
https://github.com/jh941213/my_AI_CV_tutor
깃허브에 업로드를 해두었습니다. 긴 글 읽어주셔서 감사합니다.
로그인하고 댓글을 남겨 주세요
멋지네요! 랭체인에서 제공하는 쿡북들에는 ‘Answer’가 모두 텍스트인 경우만 존재하던데, 혹시 멀티모달 RAG를 통해서 ‘Answer’가 이미지를 포함한 케이스도 보셨을까요?
예를들어 여러 상황들이 생각되는데요.
step 1) 이미지/텍스트 or only-텍스트 질문을 던져
step 2) 관련된 이미지를 탐색하여 원본을 답변으로 제공 or 원본을 기반으로 답변에 맞추어 생성한 이미지를 답변으로 제공.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
(이력서에 첨부된 프로필 사진조차 첨삭해주는 기능일까요 ㅎㅎ - 관상이 좋아보이지 않는 사진이니 이를 다물고 웃고 있는 사진으로 교체하시오 이런?)