클로드·코덱스로 받은 내 AI 사용 성적표: 모델 4개 비교
2026.10.15
일주일치 클로드 코드(Claude Code) 대화 58개로 내 AI 사용 성적표를 받고, 그중 10개를 클로드 하이쿠·소네트·오푸스와 코덱스(Codex)에게 다시 채점시켰어요.
내 성적표 한 줄: 한 대화에 너무 많은 일을 섞어요(45개 중 22개).
채점 모델을 바꿔도 성적은 대부분 같은 소네트를 다시 돌린 차이만큼만 달랐어요.
오푸스는 하이쿠보다 7.6배 비쌌는데 성적은 같았어요.
클로드 코드 일주일 58개 대화 성적표
지피터스에서 로나를 만드는 PM이자 24기 멀티에이전트 멤버 윤누리예요. 「내 AI 대화 기록을 에이전트로 분석하기」를 골랐어요.
로찌: 팀에서 만드는 사내 도구예요. 클로드 코드 대화 기록을 읽고 고칠 습관과 써 볼 도구를 카드로 골라 줘요.
10월 13일: 2026년 10월 6일부터 12일까지 일주일 대화 58개를 도구 5개로 분석했어요. ccusage, 박스던(Boxdawn), MS AI 엔지니어링 코치(AI Engineering Coach), 클로드 코드 직접 분석, 로찌예요.
숫자부터 봤어요(ccusage).
정가로 치면 326달러예요. 구독이라 실제로 낸 돈은 아니에요.
토큰의 97%가 캐시 읽기였어요. 긴 대화가 말할 때마다 앞 대화를 다시 읽은 거예요.
비용의 95%가 오푸스, 상위 5개 대화가 비용의 29%였어요.
여러 도구가 같이 잡은 고칠 습관이에요.
한 대화에 여러 일을 섞어요. 로찌는 45개 중 22개, MS 코치는 메시지 50개가 넘는 대화 2개를 짚었어요. 할 일: 요청이 10개를 넘거나 주제가 바뀌면 인계문을 만들고 새 대화로 옮겨요.
문안을 낱개로 여러 번 고쳐요. 클로드가 칸 제목을 너무 줄여 써서 제가 「이건 뭔소리?」 하고 고친 게 한 대화에서 4번이었어요. 할 일: 칸 제목은 줄이지 말고, 고칠 땐 같은 종류 칸을 한 번에 고쳐요.
큰 일을 한 번에 시켜요. 한 요청에 도구를 15개 넘게 쓴 게 49건이었어요(MS 코치). 할 일: 단계로 쪼개 한 번에 하나씩 시켜요.
다른 PC에서 할 시험을 이 맥에서 25분, 정가 11달러어치 헛돌렸어요(직접 분석). 할 일: 시험 전에 실행 위치부터 한 줄 확인해요.
잘 될 때 저장을 안 해요. 스킬 파일을 26번 고치고 마지막에 한 번 커밋했어요(로찌). 할 일: 잘 될 때마다 「여기까지 저장해줘」.
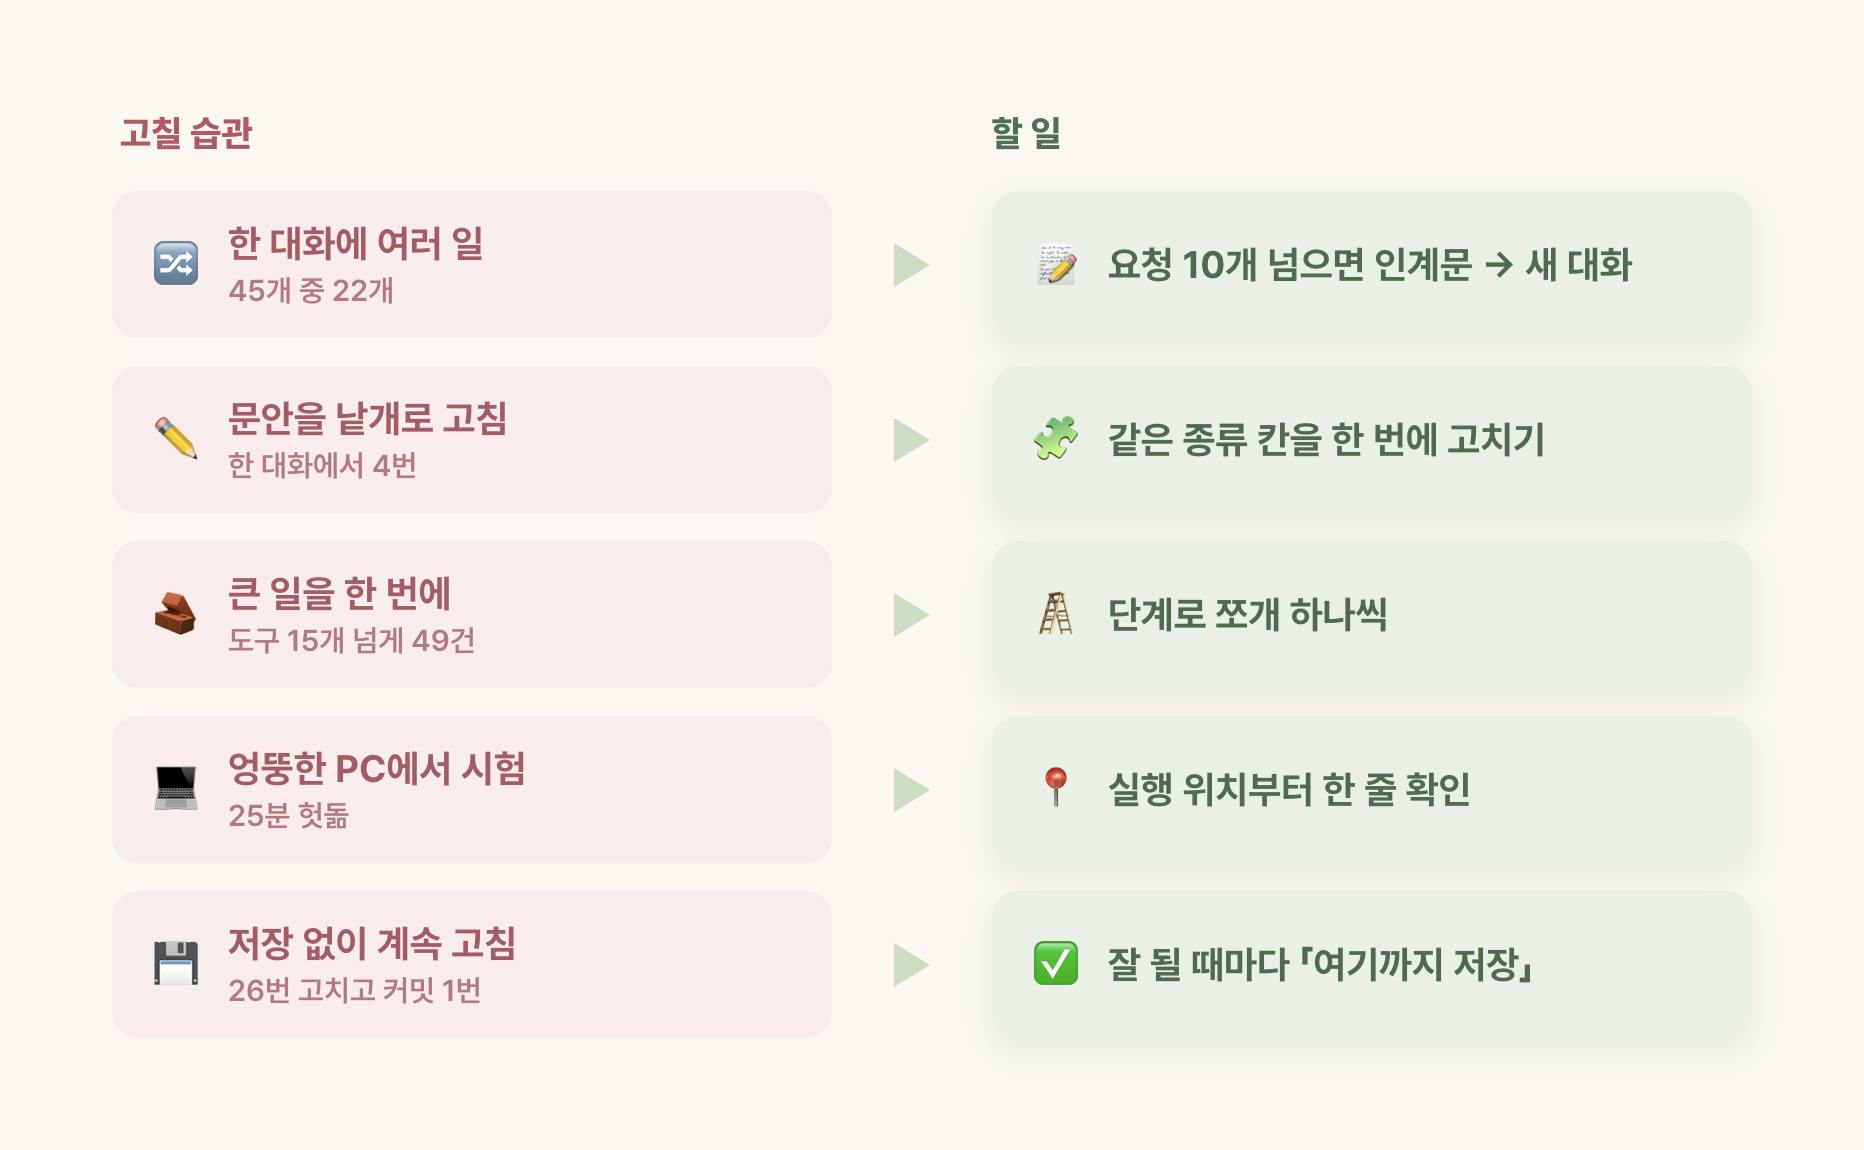
▲ 일주일 58개 대화에서 여러 도구가 같이 잡은 고칠 습관 5개와 각각의 할 일
잘한 점도 있었어요(로찌).
메일을 대량으로 지우기 전에 보낸 사람 목록부터 봤어요.
결과 숫자만 받지 않고 「어떤 상황에서 이게 벌어진건디?」처럼 근거 장면을 되물었어요.
써 볼 도구로는 스킬 재시험을 자동으로 판정하는 claude plugin eval 이 나왔어요.
이 성적표, 채점 모델을 바꾸면?
도구별로는 장면 6개 중 직접 분석이 5개, 로찌가 3개, ccusage가 0개를 잡았어요. 근데 하나가 걸렸어요. 직접 분석도 로찌도 둘 다 소네트로 읽었다는 점이에요. 방법 차이인지 모델 차이인지 알 수 없었어요.
그날 오후 클로드 코드에 이렇게 물었어요.
이것을 할 때 클로드 대화 세션을 클로드로 돌릴지, codex로 돌릴지, 섞어서 돌릴지에 따라서 또 결과가 달라지지 않을까 싶군이틀 뒤 스터디 글을 쓰기 전에는 모델별 결과까지 갖춰 달라고 이렇게 부탁했어요.
이거를 멀티 에이전트 스터디의 글로 쓸거라 각 모델 별로 분석 결과까지 있는 상태로 쓰는게 좋을거같긴함.계획은 클로드 코드와 같이 세웠고, 이틀 뒤 이렇게 돌렸어요.
검토: 비평 에이전트(critic)가 계획을 읽고 짚은 결함 8곳을 고쳤어요.
입력: 58개 중 장면 6개가 나오는 대화 10개(약 3MB). 모델 5조건을 다 돌리고, 정답 장면으로 채점하려고 줄였어요.
모델: 클로드 하이쿠 5.5(Claude Haiku 5.5), 클로드 소네트 5.5(Claude Sonnet 5.5), 클로드 오푸스 5.5(Claude Opus 5.5), 코덱스 gpt-6.1-sol
방법 1, 로찌: 대화를 하나씩 읽고 항목과 원문 인용을 뽑아요.
방법 2, 직접 분석: 압축한 대화 11개(약 28만 자)를 한 번에 주고 고정 질문 3개에 답하게 해요.
흔들림 재기: 소네트를 로찌로 3번, 직접 분석으로 2번 돌렸어요.
채점: 모델 이름을 가린 결과 11개를 클로드 오푸스 서브에이전트와 코덱스가 따로 매겼어요. 60칸 중 54칸이 같았고, 다른 6칸은 낮은 쪽을 골랐어요.
시간: 새 실행 10번에 12분쯤, 채점에 15분쯤 걸렸어요.
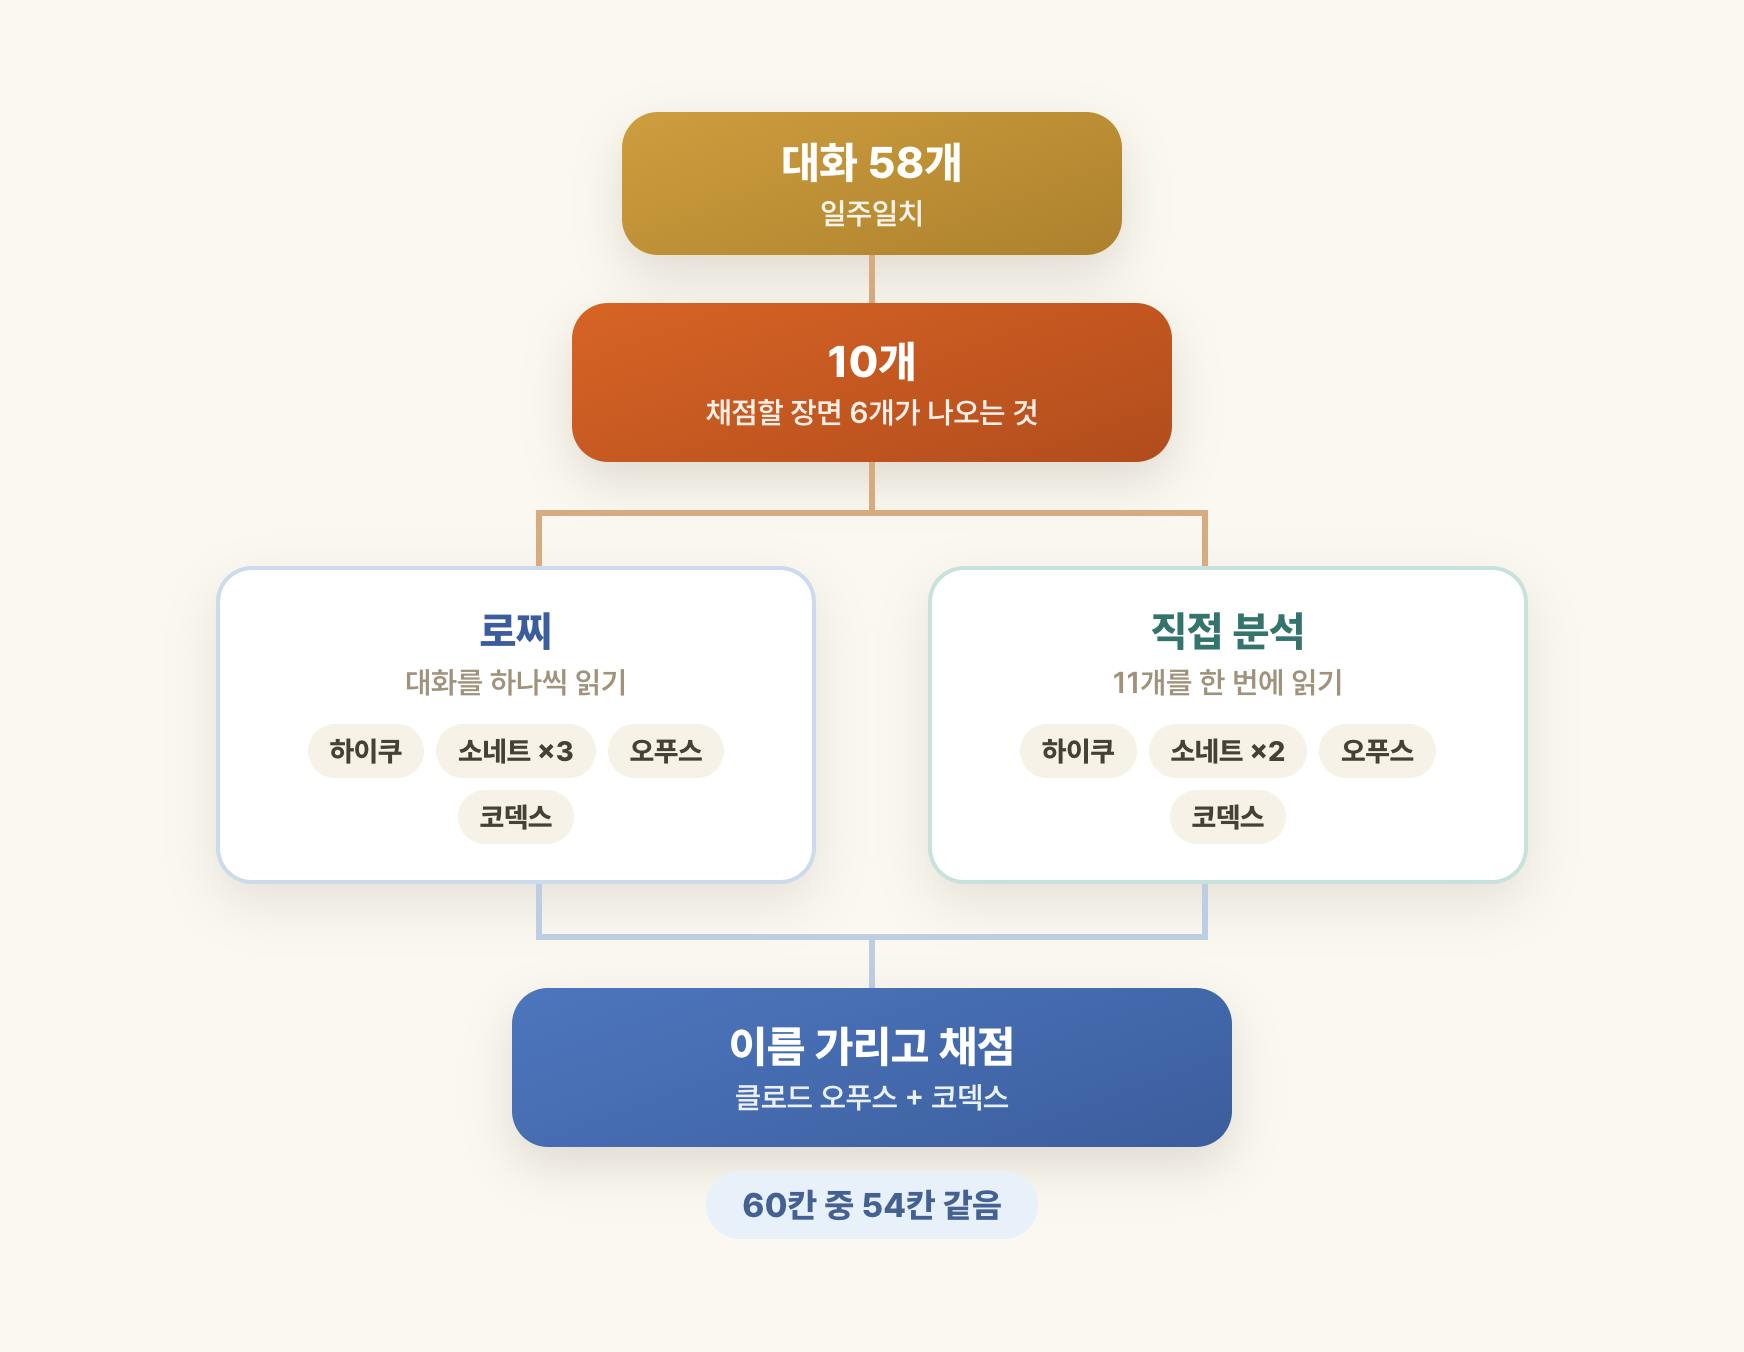
▲ 대화 58개 중 10개를 로찌와 직접 분석으로 나눠 모델 4개에 읽히고, 이름을 가린 채 채점 2명이 매긴 흐름
채점한 장면 6개예요. ○는 할 일까지 냄, △는 신호만, ✗는 못 봄이에요.
원격 PC에서 돌릴 시험을 이 맥에서 돌리며 25분 헛돎
읽기 크기 제한에 걸린 파일을 매번 나눠 읽음(로찌는 이 대화를 설계상 안 읽어서 직접 분석만)
한 대화에 여러 일을 섞고, 쉬었다가 이어 쓴 긴 대화
제 질문을 클로드가 실행 승인으로 읽음
문안을 여러 번 나눠 고침
폴더를 다시 만들다 앞서 낸 결과를 지움
클로드·코덱스 모델별 채점 결과
비용은 구독이라 실제로 낸 돈이 아니고 API 정가로 환산한 값이에요. 코덱스는 달러 값을 주지 않아요.
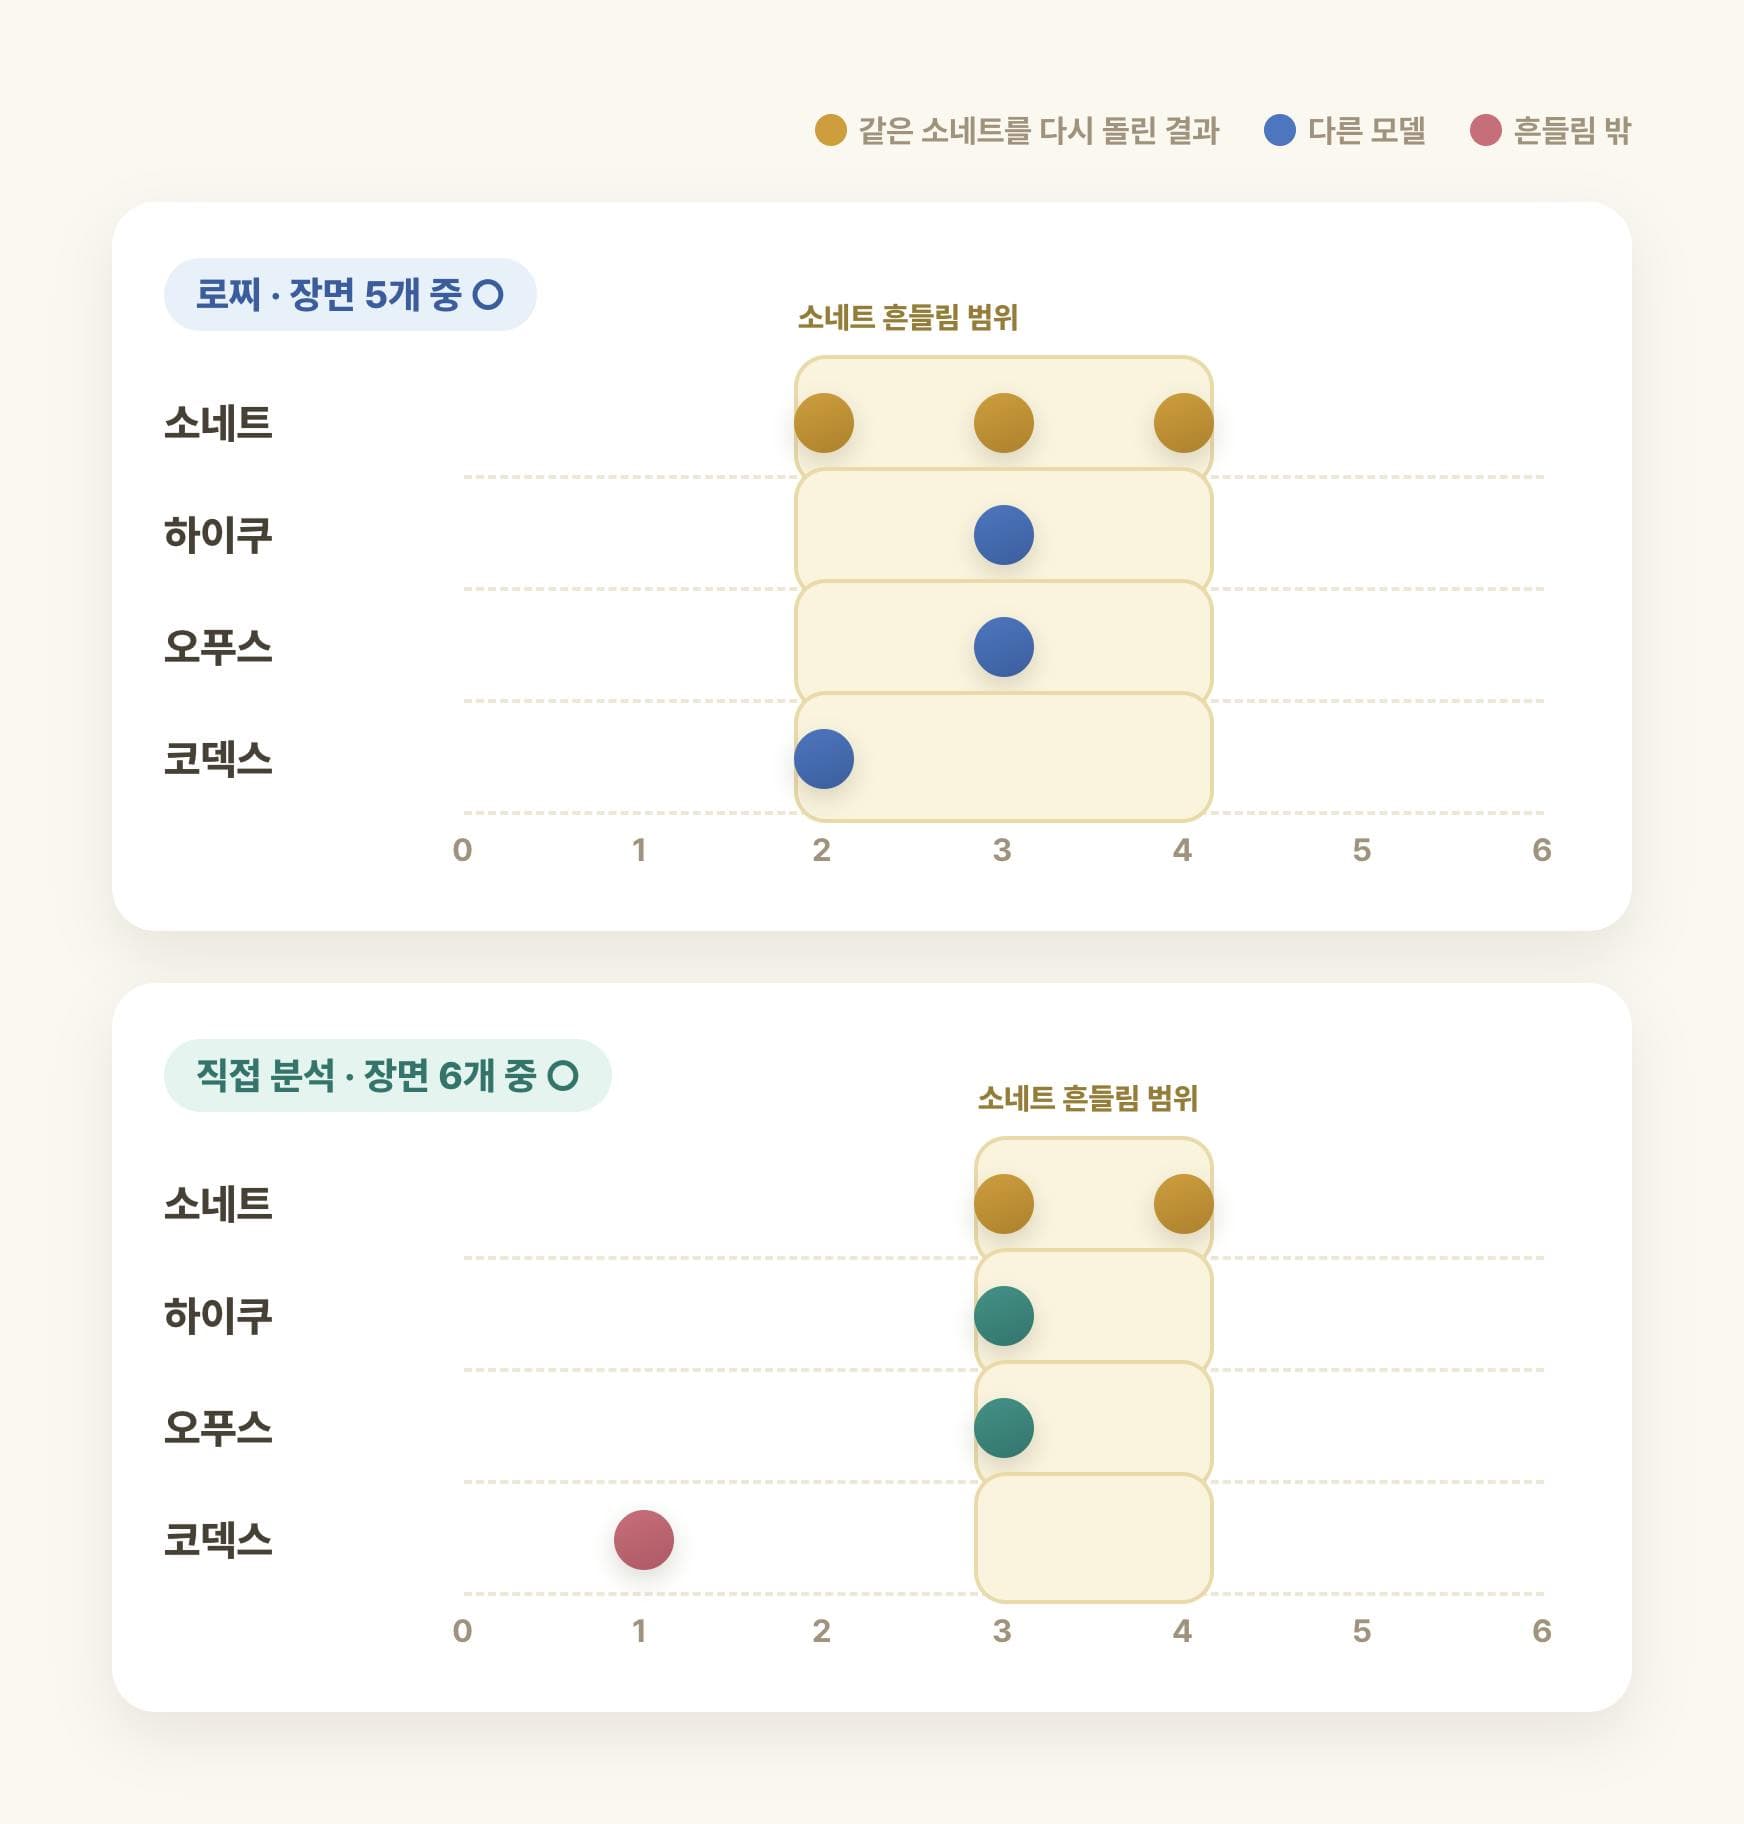
로찌로 읽혔을 때(장면 5개 중 ○)
하이쿠: 3개, 221초, 1.90달러
소네트: 세 번 돌려 4개, 3개, 2개. 82초와 126초, 7달러 안팎
오푸스: 3개, 174초, 14.41달러
코덱스: 2개, 93초
직접 분석으로 읽혔을 때(장면 6개 중 ○)
하이쿠: 3개, 85초, 0.25달러
소네트: 두 번 돌려 3개, 4개. 150초 안팎, 1.02달러와 1.03달러
오푸스: 3개, 194초, 2.08달러
코덱스: 1개, 39초
▲ 로찌와 직접 분석에서 모델별로 할 일까지 낸 장면 수(○)와 소네트가 흔들린 범위
장면 판정이 몇 칸 바뀌었는지도 셌어요.
소네트끼리: 로찌 1칸에서 3칸, 직접 분석 2칸
로찌: 하이쿠, 오푸스, 코덱스 모두 이 범위 안이었어요.
직접 분석: 소네트 두 번과 비교해 오푸스 1칸·3칸, 하이쿠 2칸·4칸, 코덱스 5칸·5칸
코덱스만 확실히 멀었어요. 다만 추론 강도 기본값에 한 번만 돌려서, 못한다고 단정할 근거는 없어요.
돈을 보면 차이가 커요.
로찌에서 오푸스는 하이쿠보다 7.6배 비쌌고, ○는 3개로 같았어요.
긴 대화를 나누라는 로찌 카드는 모델과 회차를 가리지 않고 6번 모두 나왔어요.
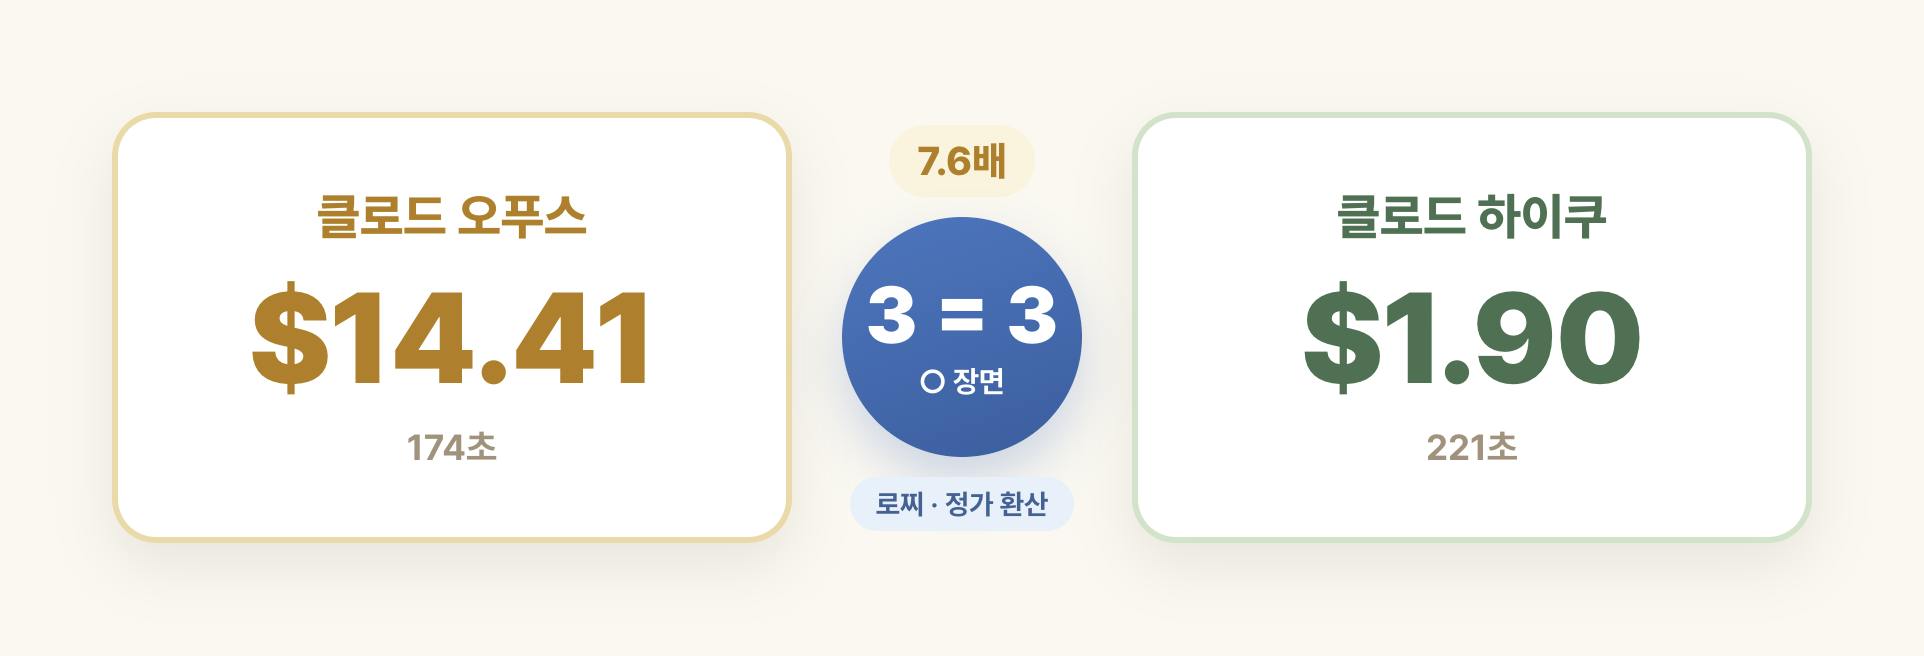
▲ 로찌로 읽혔을 때 클로드 오푸스 정가 14.41달러와 클로드 하이쿠 정가 1.90달러, 할 일까지 낸 장면은 둘 다 3개
모델보다 읽는 방법이 갈랐어요
긴 대화: 로찌는 6번 모두 ○, 직접 분석은 5번 중 0번
결과 삭제: 직접 분석은 5번 중 4번 ○, 로찌는 6번 중 1번
문안 반복 수정: 두 방법 합쳐 11번 중 10번 ○. 가장 단단한 발견이에요.
질문을 승인으로 읽음: 로찌는 6번 중 2번(같은 소네트도 회차마다 달랐어요), 직접 분석은 소네트 두 번만 잡았어요.
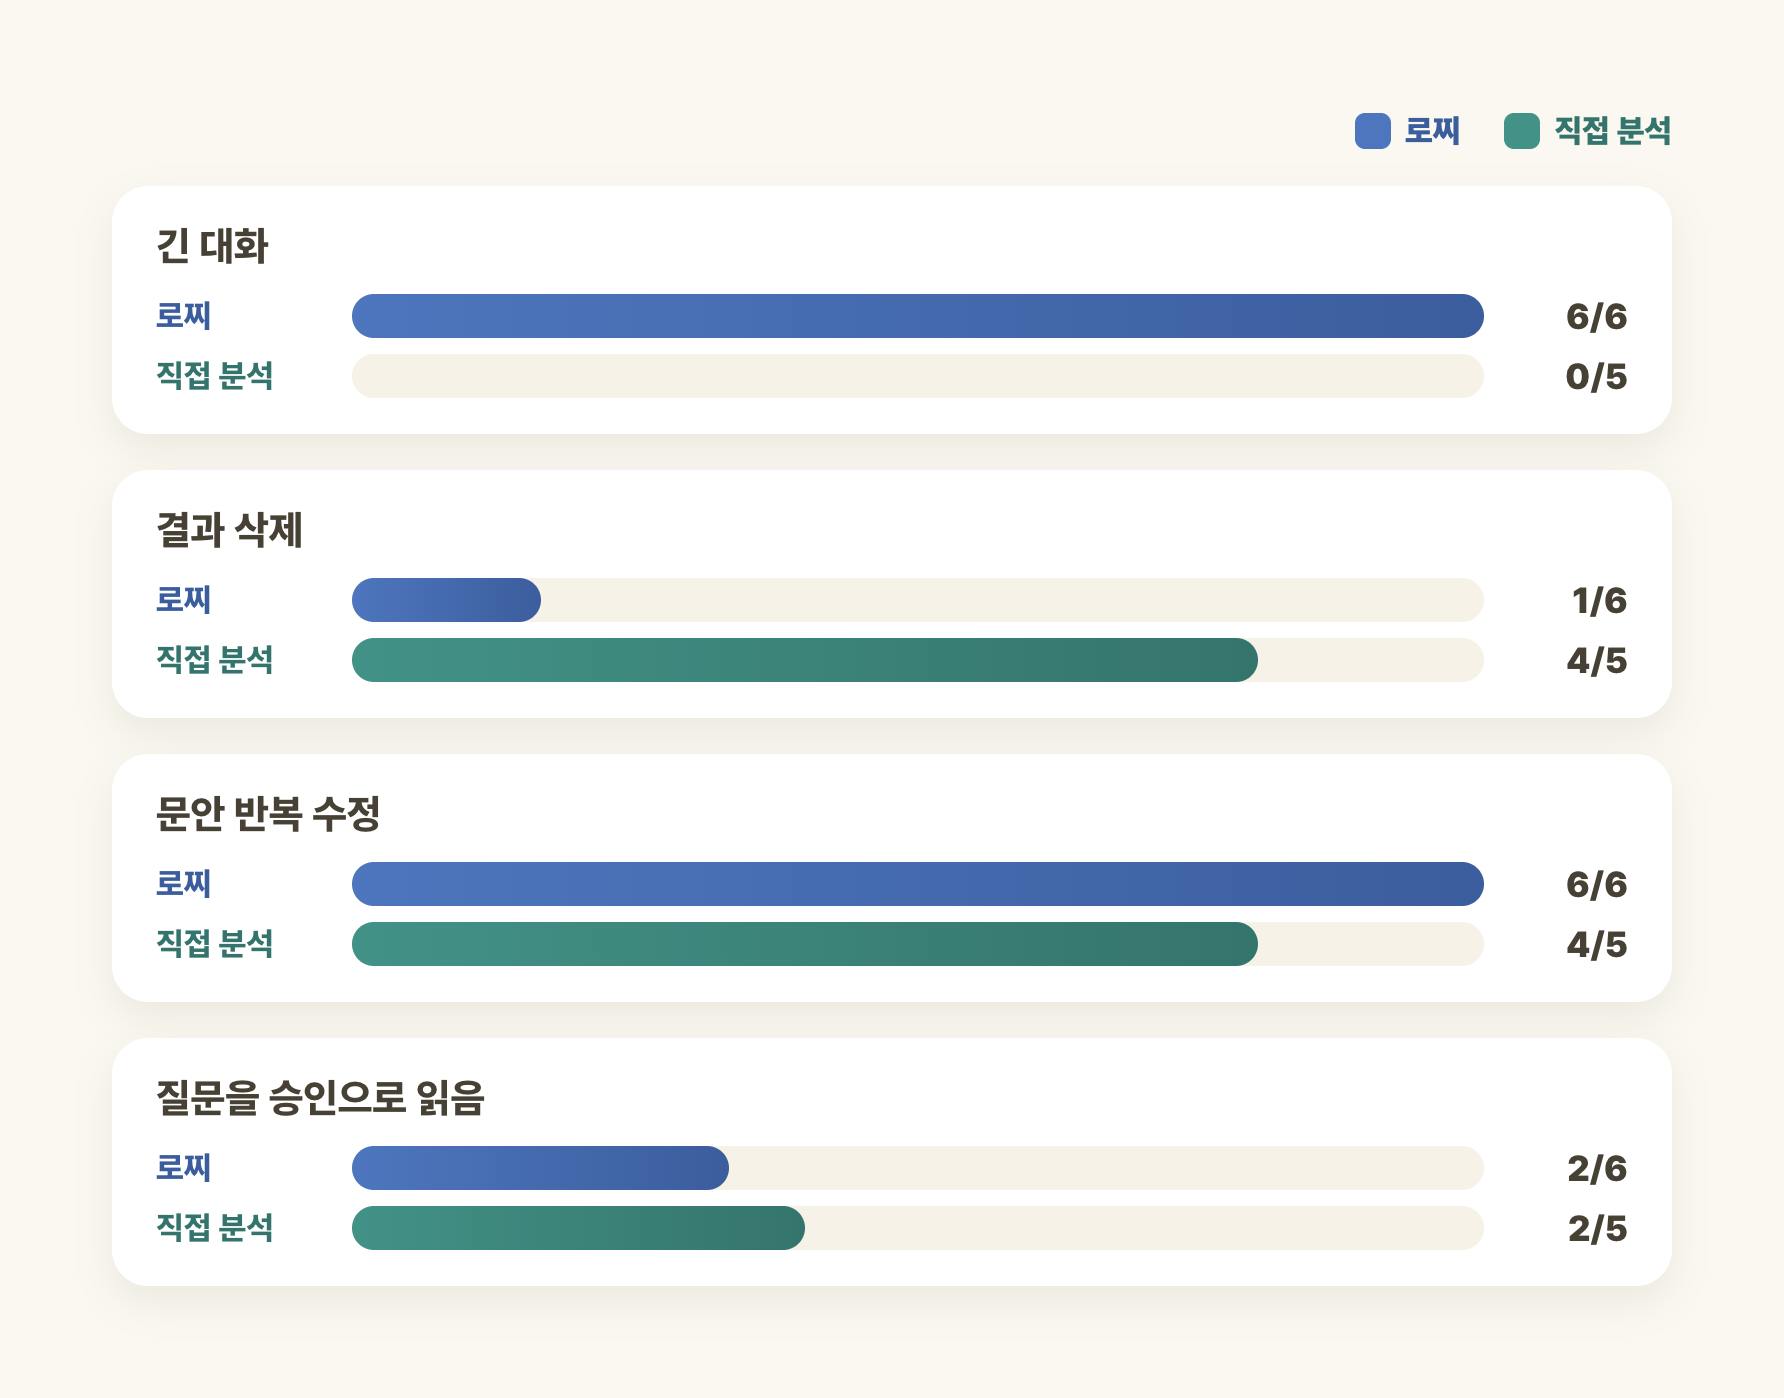
▲ 장면별로 할 일까지 잡은 횟수, 긴 대화는 로찌 6/6·직접 분석 0/5, 결과 삭제는 1/6·4/5
승인 장면은 메일 정리 중 「ㅇㅇ 수신거부하면 스팸에 쌓이나?」라는 제 질문에서 생겼어요. 이걸 잡은 오푸스의 로찌 결과예요.
클로드가 질문 섞인 답을 승인으로 해석하고 실행해서, 도구 호출을 거절해야 했어요
장면 6개 밖에서 새로 잡힌 것도 있었어요.
로찌 6번 모두: 다른 대화창이 같은 브랜치에 커밋해서 작업이 섞인 장면
직접 분석 5번 중 4번: 메일 정리 중 두 작업이 같은 브라우저 탭을 같이 써서 부딪친 장면
아직 모르는 것
모델 비교는 58개 중 10개로, 조건마다 한 번씩만 돌렸어요(소네트만 두세 번). 어느 모델이 낫다고는 못 해요.
추론 강도를 맞추지 않았어요. 코덱스는 기본값으로 돌았어요.
장면 6개가 10월 13일 소네트 분석에서 나와서 소네트에 유리할 수 있어요. 장면 밖 새 발견은 모델마다 4개에서 8개로 비슷했어요.
코덱스가 왜 중국어로 답했는지는 모르겠어요.
대화 10개를 이번에 처음 오픈AI에도 보냈어요. 제 기록이고 제가 동의해서 보냈어요.
내 대화 기록 성적표 받는 프롬프트
10월 13일 직접 분석에 쓴 질문을 줄였어요. 클로드 코드에 이렇게 시키면 돼요.
~/.claude/projects 에서 [최근 7일] 동안 [프로젝트 폴더] 대화 기록을 읽어 줘.
내 메시지, 도구 이름과 입력 앞 120자, 에러, 답변 앞 200자만 남겨 압축해.
그다음 아래 세 가지를 3개씩 찾아 줘.
1. 내가 같은 지시를 반복하거나 결과를 고친 곳 + 막을 CLAUDE.md 규칙 한 줄
2. 에이전트가 헛돈 곳(같은 파일 반복 읽기, 같은 명령 반복 실패, 되돌리기)
3. 나에게 맞는 도구 제안. 이미 설치한 스킬·플러그인은 빼고.
발견마다 대화 id 앞 8자, 날짜, 원문 인용 80자 이내, 바로 할 행동 한 줄.
모델을 비교하려면 같은 프롬프트를 모델마다 두 번씩 돌려 보세요.
한 번만 돌리면 모델 차이인지 운인지 가릴 수 없어요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요