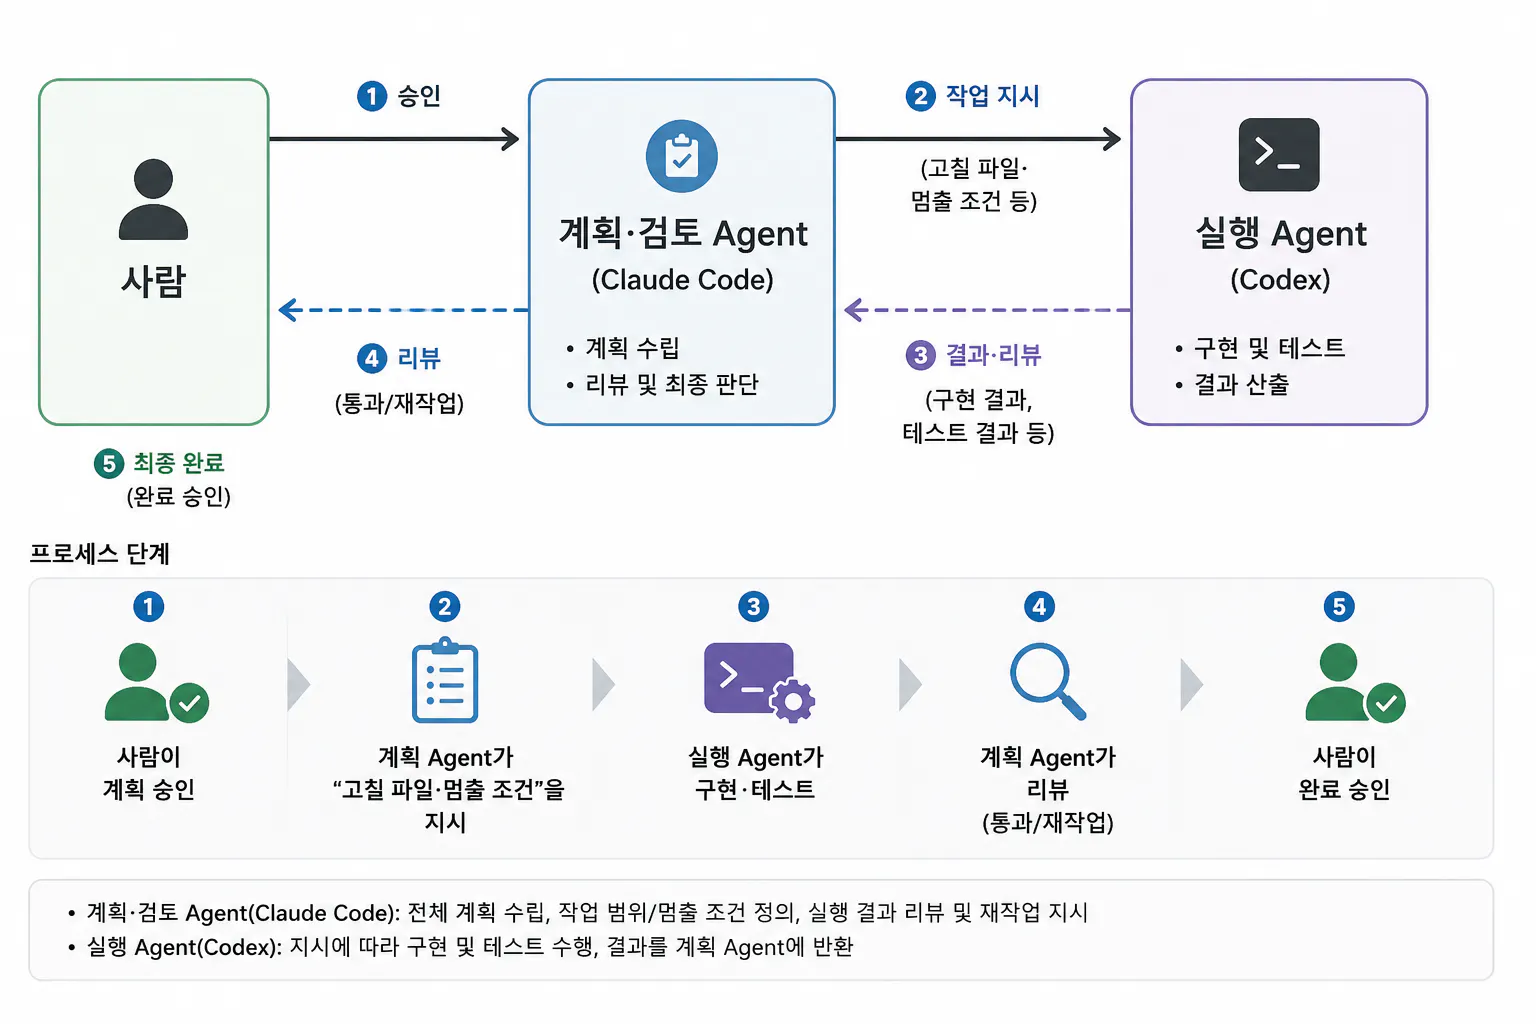
여러 AI 실행 주체에게 시킬 작업을 한 창구에서 접수·조회하는 로컬 API 서버 v0.1을 만들었습니다. AI 모델을 직접 부르지 않고, 작업을 받아 상태만 추적하는 창구입니다. 만들 때는 Agent 하나에 다 맡기지 않고, 계획·검토 Agent(Claude Code)와 구현 Agent(Codex), 사람 승인으로 역할을 나눴습니다.
바쁘시면 이것만:
무엇을: 내 장비에서 도는 AI 작업 접수·조회 API 서버 v0.1 (FastAPI + SQLite, 로컬 전용). 서버 자체보다, 여기서 익힌 "통제된 운영 방식"을 앞으로 24시간 개인 AI 서버에 이어 쓰는 게 목적.
어떻게: 한 Agent는 계획·리뷰, 다른 Agent는 구현, 사람은 승인. 역할 분리.
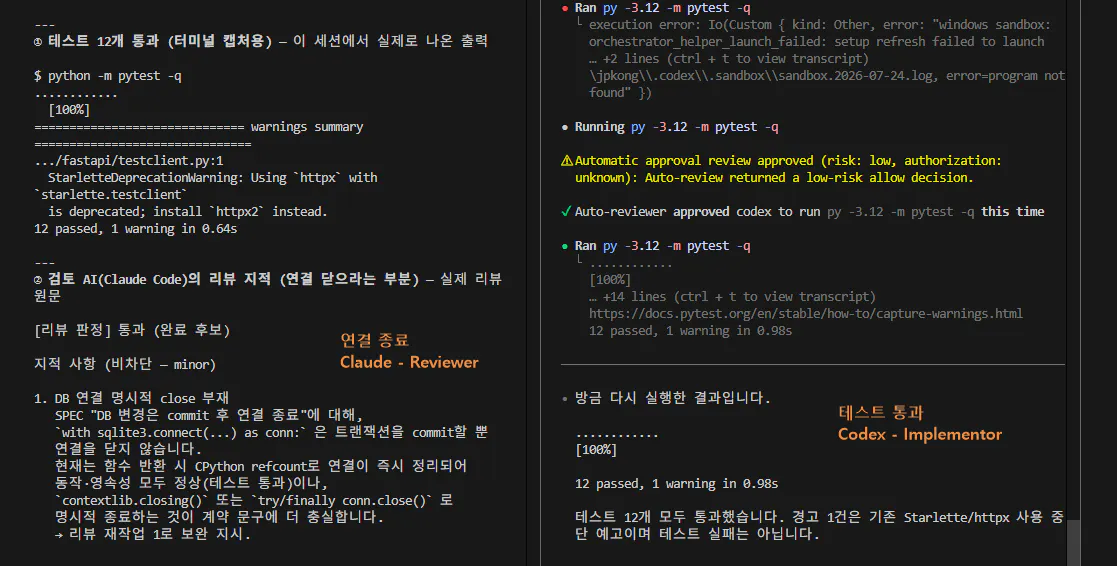
핵심 순간: 실행 Agent가 "테스트 12개 다 통과"라는데, 검토 Agent가 사람이 놓치기 쉬운 문제(작업 끝나도 DB 연결을 안 닫음)를 리뷰에서 잡음.
통제 결과: Agent에게 고칠 파일과 멈출 조건을 미리 정해줘서, 최종 커밋까지 내가 승인 안 한 변경이 하나도 없었음.
왜 개발자·팀리드에게: 새 AI 도구 소개가 아니라, 비용·데이터·운영이 통제되는 셀프호스팅 구조 이야기.
🎯 이런 분들께 도움돼요
AI 도구를 써보는 데서 그치지 않고, 파일·API·도구 실행·상태 확인을 연결한 "운영 가능한 인터페이스"까지 직접 만들고 싶은 실무 개발자·기술 실무자
내 장비 위에서 AI 에이전트를 실행·관찰·제어하는 구조를 손에 쥐고 싶은 분
"새 AI 도구"보다 비용·데이터·운영 통제가 되는 구조인지를 먼저 보는 팀리드·도입 담당·대표
😫 문제 상황 (Before)
발단은 GPTers 스터디 과제였지만, 방향은 정해져 있었습니다. 여러 AI에게 일을 시키다 보면 어떤 작업을 누구에게 맡겼고 지금 어떤 상태인지가 흩어집니다. 뭔가를 제대로 운영하려면, 모델을 직접 부르기 전에 작업을 접수하고 상태를 조회하는 창구가 먼저 필요합니다.
그래서 첫 조각을 정했습니다. AI를 직접 부르지 않는 작업 접수·조회 전용 로컬 API 서버, 그 v0.1입니다. 일부러 작게 잡았습니다. 크게 벌이기 전에 작은 조각 하나를 끝까지 통제하며 완성해보고 싶었고, AI 코딩 도구가 자주 앞서가는 만큼 통제권을 잃지 않는 방법이 필요했기 때문입니다.
🛠️ 사용한 도구
Claude Code — 지휘 역할. 계획·작업 지시서·리뷰·완료 확정. 모델은 Claude Opus 4.8.
Codex (CLI) — 구현 역할. 실제 파일 작성과 테스트 실행.
원칙: Claude Code는 구현 파일을 직접 손대지 않고, Codex는 승인된 범위 밖으로 나가지 않으며, 사람은 승인만 한다.
에이전트 생성 프로세스를 보여주는 다이어그램
🔧 작업 과정
1. 혼자 만들되 통제하기
가장 먼저 한 일은 코드가 아니라 구조 설계였습니다. 하나의 Agent에 처음부터 끝까지 통째로 맡기는 대신 위 그림처럼 역할을 나눴고, 이 구조는 곧바로 시험대에 올랐습니다. 초반에 Claude Code가 계획을 승인받지도 않고 설정 문서를 먼저 바꾸려 했고, 그래서 멈춰 세웠습니다.
프로젝트 초기 설정 절차를 다시 점검해줘.
확정과 변경 계획 보고 전에 설정 문서가 먼저 바뀌었다.
지금은 추가 파일 수정이나 구현을 진행하지 마.
여기서 규칙을 하나 못 박았습니다. "사람의 승인은 규칙 위반을 덮는 면죄부가 아니다." Agent가 "해달라고 하셨잖아요"라며 앞서가도 승인 단계를 건너뛰지 못하게 한 겁니다.
2. 설계를 문서로 못 박기
구현 전에 규격을 문서로 확정했습니다. 상태 코드, 입력 검증 규칙, 저장 방식, 재시작 후 데이터 유지까지.
API 응답 규격을 확정해.
상태 확인 성공 200 / DB 점검 실패 503,
작업 접수 성공 201 / 검증 실패 422,
작업 조회 존재 200 / 미존재 404 / 잘못된 형식 422 ...
그리고 "작업 지시서"에 어떤 파일만 몇 개까지 고칠 수 있는지, 어떤 상황이면 멈춰야 하는지를 적었습니다. 최초 구현은 파일 여섯 개가 필요했는데 기본 규칙은 세 개까지였습니다. 그래서 파일 수를 늘리는 것을 따로 승인받아, 정확히 그 여섯 개만 건드리게 묶었습니다. "하는 김에 이것도"를 막기 위해서였습니다.
3. 실행 Agent가 스스로 버그를 찾다
승인된 지시서를 Codex에 넘겼습니다.
작업 지시 왔어. 진행해.
Codex는 여섯 파일을 구현하고 테스트를 돌렸는데, 시키지 않은 일을 하나 했습니다. 마지막 규격 대조에서 스스로 버그를 찾은 겁니다. 입력 규칙은 "앞뒤 공백을 지운 뒤 4,000자 이내"인데 구현은 공백을 지우기 전에 길이를 재고 있었습니다. 딱 최대 길이 근처에서 결과가 갈리는, 놓치기 쉬운 부분입니다. Codex는 순서를 바로잡고 공백이 붙은 4,000자 테스트까지 추가했습니다. 테스트는 열한 개에서 열두 개로 늘고 전부 통과했습니다.
4. "테스트 다 통과"인데, 검토 Agent가 숨은 문제를 잡다
Codex가 완료를 보고했습니다.
완료했단다. 검토해.
겉으로는 완벽했습니다. 테스트 열두 개 전부 통과, 서버도 정상. 이 정도면 대개 합격으로 넘어갑니다. 그런데 검토 Agent가 하나를 집어냈습니다. 작업이 끝난 뒤에도 DB 연결을 명시적으로 닫지 않고 있었습니다. 파이썬이 뒤처리를 알아서 해줘서 지금은 닫히고 테스트도 통과하지만, 코드에 "연결을 닫아라"가 없으면 서버를 오래 켜뒀을 때 연결이 쌓여 자원이 샐 수 있습니다.
당장 터지는 버그는 아니라 넘어가기 쉽습니다. 하지만 이런 걸 처음에 잡느냐가 오래 도는 서버에서는 안정성 차이로 돌아옵니다. 만든 쪽은 통과라는데 검토하는 쪽이 이면을 봤고, 이게 역할을 나눈 이유였습니다.
한국어 스크린샷
보완 과정에서 작은 사건이 하나 더 있었습니다. Codex가 "이번엔 문서 수정 금지"를 문자 그대로 받아들여, 남겨야 할 작업 기록을 빠뜨린 겁니다. "문서 수정 금지"와 "결과는 항상 기록"이 충돌한 경우였고, 지적하자 더 상위 규칙인 기록 의무가 우선임을 인정하고 바로잡았습니다. 수정 후 다시 확인하니 바뀐 파일은 하나, 테스트는 여전히 통과. 통과로 판정했습니다.
5. 승인 안 한 변경 없이 커밋
완료를 확정하고 하나의 커밋으로 묶었습니다. 커밋 직전 확인도 거쳤습니다.
커밋 직전에 다시 확인해.
- 테스트 → 12 passed
- 커밋 파일이 보고한 12개와 일치
- 승인하지 않은 변경 없음
커밋에 들어간 건 승인된 구현 파일 여섯 개, 완료 기록, 따로 승인한 규칙 변경뿐. 처음부터 끝까지 통제권이 사람 손에 있었다는 걸 기록으로 확인했습니다.
✅ 결과 (After)
항목
Before
After
작업 접수 창구
없음 (흩어짐)
동작하는 로컬 API 서버 v0.1
결과물 검증
—
테스트 12개 통과, 재시작 후 데이터 유지
협업 방식
Agent 하나에 전부 위임
계획·실행·검토·승인 역할 분리
통제 수준
불명확
승인 안 한 변경 없음
재사용성
—
다음 단계에도 쓸 운영 방식 확보
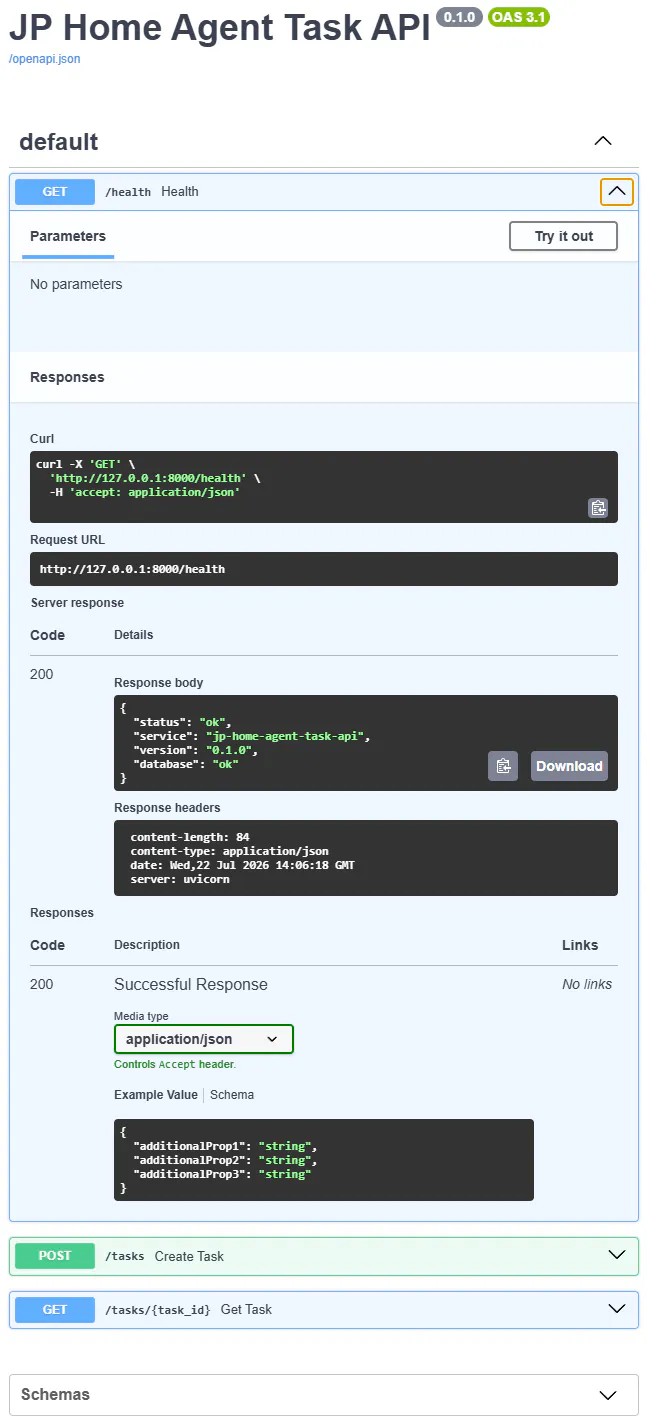
이번 v0.1은 커밋 4개, 테스트 12개, 재작업 1회로 마무리했습니다. API 세 개짜리 작은 서버지만, 안을 들여다보면 이렇게 돌아갑니다.
[작업 접수]  요청 ─▶ POST /tasks ─▶ 입력 검증 ─▶ SQLite 저장 ─▶ 접수 완료
                                              (고유번호 발급, 상태=대기중)
[작업 조회]  요청 ─▶ GET /tasks/{번호} ─▶ 상태 반환 (없음/형식오류/정상 구분)
[상태 확인]  요청 ─▶ GET /health ─▶ 서버·DB 정상 여부
저장은 내 장비의 SQLite 파일 하나에 하고, 외부 공개나 로그인은 없으며, 서버를 껐다 켜도 데이터가 남습니다. 작지만 "여러 AI 작업을 한곳에서 접수하고 추적한다"는 창구의 핵심은 실제로 돌아갑니다.
JS 홈 에이전트 작업 API
💬 배운 AI 활용 팁
효과적이었던 것
실행 Agent의 "통과"를 그대로 믿지 말고 검토 Agent로 다시 보기. 만든 Agent와 검토 Agent를 나누면 다 통과한 코드에서도 숨은 문제를 잡습니다. 코딩이 아니어도 초안 Agent와 검수 Agent를 따로 두는 것만으로 품질이 오릅니다.
고칠 범위와 멈출 조건을 미리 정해주기. 어떤 파일만, 몇 개까지, 어떤 상황이면 멈춰 물어볼지 정해두면 Agent가 범위를 안 벗어납니다.
작업 상태를 기록 파일 하나 + 완료 보관함으로 관리하기. 대화가 끊기거나 다른 Agent로 넘겨도 이어서 통제할 수 있습니다.
이렇게 하면 안 돼요
승인 게이트 없이 넓은 재량을 주면 위험합니다. AI는 자주 앞서가니, 승인 전에 실제 변경을 시작하지 못하게 막고, 승인이 규칙 위반의 핑계가 되지 않게 하세요.
규칙을 문자 그대로만 해석하게 두면 충돌합니다("문서 수정 금지" vs "결과는 항상 기록"). 무엇이 우선인지 알려주세요.
🌍 다른 업무에 적용한다면?
이 "역할 분리 + 승인 단계"는 코딩 밖에서도 그대로 씁니다.
문서·기획: 초안 Agent와 검수 Agent를 나누고, 사람은 방향만 승인.
리서치·분석: 수집 Agent와 검증 Agent를 나눠 한쪽 결론을 다른 쪽이 반박·확인.
팀 도입: "새 도구를 쓴다"보다 "AI 작업을 접수·승인·기록하는 통제 구조를 둔다"로 접근. 비용·데이터·책임 추적이 되는지를 먼저 봅니다.
🚀 앞으로의 계획
솔직히 이번에 만든 v0.1 API 서버 자체를 계속 쓰지는 않습니다. 진짜 소득은 서버가 아니라 그걸 만들며 익힌 운영 방식이었습니다.
스터디의 기본 목표는 Agent SDK로 에이전트를 만들고 그 앞에 API 서버를 둬서 AI 협의체를 시연하는 것이었습니다. 저는 방향을 조금 바꿔, 새 서버를 더 만들기보다 이미 있는 도구(Hermes)로 이 운영 흐름을 실제 업무에 정착시키는 데 집중합니다. 개발·투자·비즈니스에 반복해서 쓸 24시간 개인 AI 작업대(Hermes Personal AI Workbench)를 만드는 게 목표입니다.
어디서 돌리나 — 구형 노트북을 Linux로 24시간 서버로 돌려 Hermes를 운영하고, Telegram으로 작업을 맡기고 받습니다. Docker로 데이터·설정을 보존해 재부팅 후 자동 복구, Tailscale로 안전한 원격 관리.
실제로 쓸 기능 세 가지
프로젝트 문맥 확인: 작업 시작 때 그 프로젝트의 현재 기록(진행·남은 일·제약)을 먼저 읽어 복구하고, 결정과 다음 할 일을 다시 기록에 반영. 이번 v0.1의 "기록 파일 + 완료 보관함" 방식을 그대로 잇습니다.
결정 협의체: 웬만한 일은 Hermes가 직접 하고, 중요한 선택만 두 Agent가 따로 검토(한쪽은 실행성·기대효과, 다른 쪽은 위험·대안)해 사람에게 결정을 넘깁니다. 모든 일에 붙이진 않습니다.
날씨 도우미: API 서버 과제를 준비하다가 한 스터디원이 든 실감 나는 날씨 API 서버 예시가 모티브가 됐고, "내 생활에 딱 맞는 날씨 도우미"를 만들면 개인·업무로 다양하게 응용하겠다 싶었습니다. 날씨 데이터를 가져와 정리하고, 내 일정·생활 패턴·취향을 반영해 아침 브리핑이나 우산·외출·빨래 질문에 답합니다.
4주 방향 — ① 24시간 Hermes 환경 구축 → ② 프로젝트 문맥 확인·결정 협의체를 실제 업무에 적용 → ③ 날씨 도우미로 도구·정기 실행·피드백 점검 → ④ 써보고 계속 쓸 기능만 남김.
원칙은 하나입니다. 새 플랫폼이나 복잡한 자동화를 만들지 않는다. API 서버·별도 도구 서버·벡터 DB는 실제 문제가 생긴 뒤 검토하고, 게시글용으로 기능을 늘리지 않고 실제 쓴 결과만 사례로 남깁니다.
최종 목표는 시연이 아니라 이 흐름이 매일 돌아가게 만드는 것입니다.
   ┌─▶ 프로젝트 문맥 확인 ─▶ 문제 검토 ─▶ 사람 결정 ───┐
   │                                                  ▼
   └── 끊겨도 빠른 재개 ◀─ 다음 작업 실행 ◀── 기록 갱신 ┘
📋 재사용 가능한 프롬프트
프롬프트 1: 역할 분리와 승인 단계 세팅
앞으로 이 작업은 역할을 나눠 진행해.
너는 계획과 검토만 한다. 실제 [구현/문서 수정]은 직접 하지 말고, 무엇을 어떤 범위로 할지 정리해 내 승인을 먼저 받아라.
내가 승인하기 전에는 실제 변경을 시작하지 마라. 내 승인은 규칙 위반을 덮는 핑계가 아니다.
[실제 작업]은 따로 넘길 테니, 너는 그 결과를 규격과 대조해 리뷰해라. [대괄호]는 본인 상황(코드·문서·리서치 등)에 맞게 바꾸세요.
프롬프트 2: 작업 지시서로 범위를 정해 지시하기
이번 작업을 아래 형식으로 지시한다.
목표 / 고쳐도 되는 대상(정확한 목록, 이 외 금지) / 금지(범위 밖 변경·새 설치 등)