랭체인을 첫 시작하며.. Part 2
2024.06.23
지난 포스팅에 이어 업데이트 된 정보를 간략하게 공유해 드립니다.
(지난포스팅 보기 : https://www.gpters.org/dev/post/starting-langchain-first-time-vEunFwsnNLxKSzy)
특정사이트에서 원하는 영역의 부분을 정해진 시간마다 크롤링해서
(5분마다) csv 파일로 업데이트 하는 부분을 성공했습니다. 코드는
제가 앞으로 직접 사용을 해야되는 부분이라 일부만 공유하겠습니다.
import time
import datetime
import pandas as pd
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.action_chains import ActionChains
from webdriver_manager.chrome import ChromeDriverManager
import schedule

# 작업 실행 상태를 나타내는 플래그
is_running = False

def scrape_qoo10():
    global is_running

** 중략 / 실제 활용을 해야되는 코드라 일부만 공개합니다 **

# 처음 실행 시 크롤링
scrape_qoo10()

# 5분마다 함수 실행
schedule.every(5).minutes.do(scrape_qoo10)

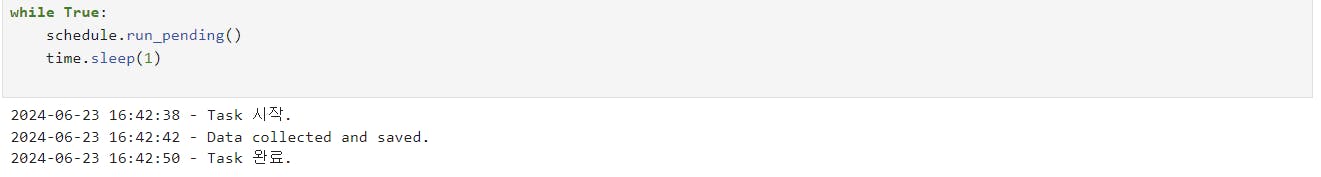
while True:
    schedule.run_pending()
    time.sleep(1)
해당 소스코드를 실행을 하면 결과가 이렇게 나옵니다.
크롤링 된 정보가 저장된 .csv 파일입니다.

그리고 아래는 해당 파일이 제대로 저장이 되었는지 체크 이미지 입니다.

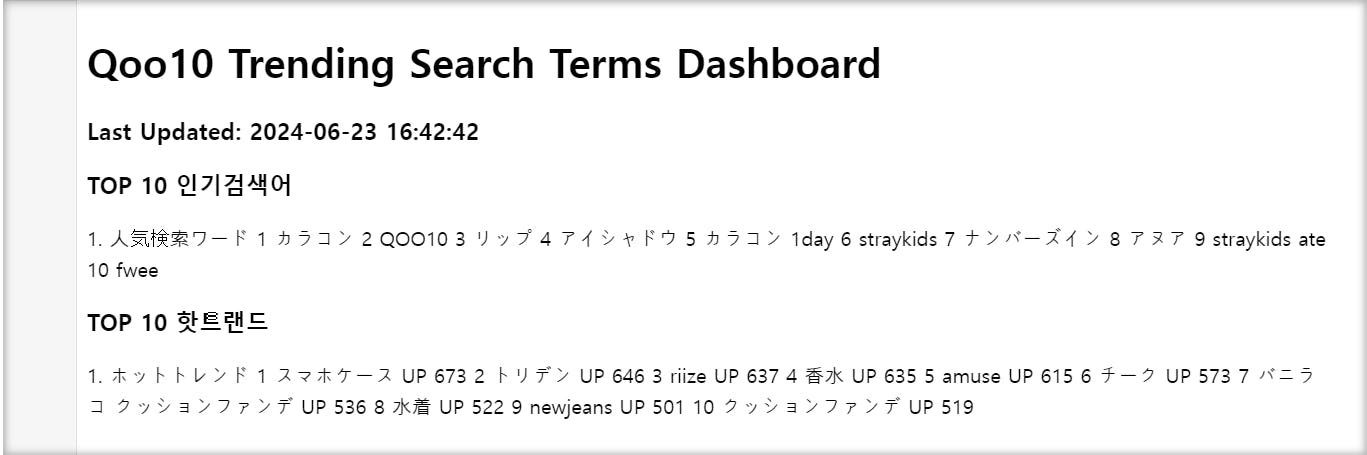
대시보드에서 해당 csv에 저장된 파일을 추출을 해서 불러온 결과물 입니다.
import os
import dash
from dash import dcc, html
from dash.dependencies import Output, Input
import pandas as pd

# 파일 경로 설정 (현재 작업 디렉토리 사용)
file_path = os.path.join(os.getcwd(), 'qoo10_trends.csv')

def load_data():
    print(f"Attempting to load data from {file_path}")

    if not os.path.exists(file_path):
        print(f"Error: File not found at {file_path}")
        return pd.DataFrame()

** 중략 / 실제 활용을 해야되는 코드라 일부만 공개합니다 **

    grp_hotrnk_product_list = [html.H3("TOP 10 핫트랜드")]
    grp_hotrnk_product_list += [html.P(f"{i+1}. {term}") for i, term in enumerate(grp_hotrnk_product_terms)]

    return html.H3(f"Last Updated: {last_updated}"), grp_pplrnk_list, grp_hotrnk_product_list

if __name__ == '__main__':
    app.run_server(debug=True, port=8060)
크롤링 된 csv 파일을 LLM 모델에 학습을 시키거나, 아니면 챗봇 형태로 파일을 업로드 해서 해당 파일들에 대해서 사용자들의 구매패턴 이나 선호도, 트랜드 예측 그리고 추후 소싱을 해야될 아이템들까지 추천을 받을 수 있도록 구현을 해보고 싶은 생각입니다.
여기에서 더 나아가 5분 간격으로 업데이트 된 정보를 LLM 모델에서 감지를 하고, 해당 아이템을 국내 사이트에서 검색을 해서 최저가의 제품까지 추천을 해주는 서비스를 만드는게 지금 현재의 목표입니다.
감사합니다.
로그인하고 댓글을 남겨 주세요
랭체인 등 AI 프로덕트에서는 사실 LLM도 중요하지만, 그보다 앞단에 있는 이런 데이터 수집 과정이 굉장히 중요할 때가 많은 것 같습니다ㅎㅎ
그래서 저도 본격적으로 AI 커리어를 다지기에 앞서 RPA, 크롤링, MLOps 레벨부터 업그레이드하는 중이라 IAMDATA님의 글이 더 반갑기도 하네요ㅋㅋ
이제 개인적인 용도면 이걸 랭체인 등의 기술과 연결해 유용한 AI 프로덕트로 만드실 수 있으실 것 같고
만약 상용 프로덕트를 생각하고 계신다면, 로컬 크롤링 경험을 바탕으로 실시간 크롤링 서버와 데이터 파이프라인 구축으로 한 단계 레벨업하셔야 될 거예요ㅎㅎ 요쪽으로 관심 있으시면 저한테 가볍게 톡 남겨주세요
아는 건 많이 없지만, 조금이라도 도움될 수 있는 정보가 있다면 최대한 박박 긁어서 드릴게요ㅋㅋ

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
@양경호감사합니다. 개인적으로 연락 꼭 드리겠습니다. ^^