[문과생도 AI] 간단한 웹사이트 크롤링
2024.06.13
안녕하세요, 문과생도 AI방 1주차 과제로 간단한 크롤링을 시도해보았습니다.
목표
솔로프리너들 사이에 유명한 Justin Welsh의 뉴스레터와 아티클 크롤링 후 리스트 CSV파일로 받기
Articles for Solopreneurs | Justin Welsh과정
1. Justin Welsh의 웹사이트에서 아티클과 뉴스레터 페이지 URL을 GPT에게 제공
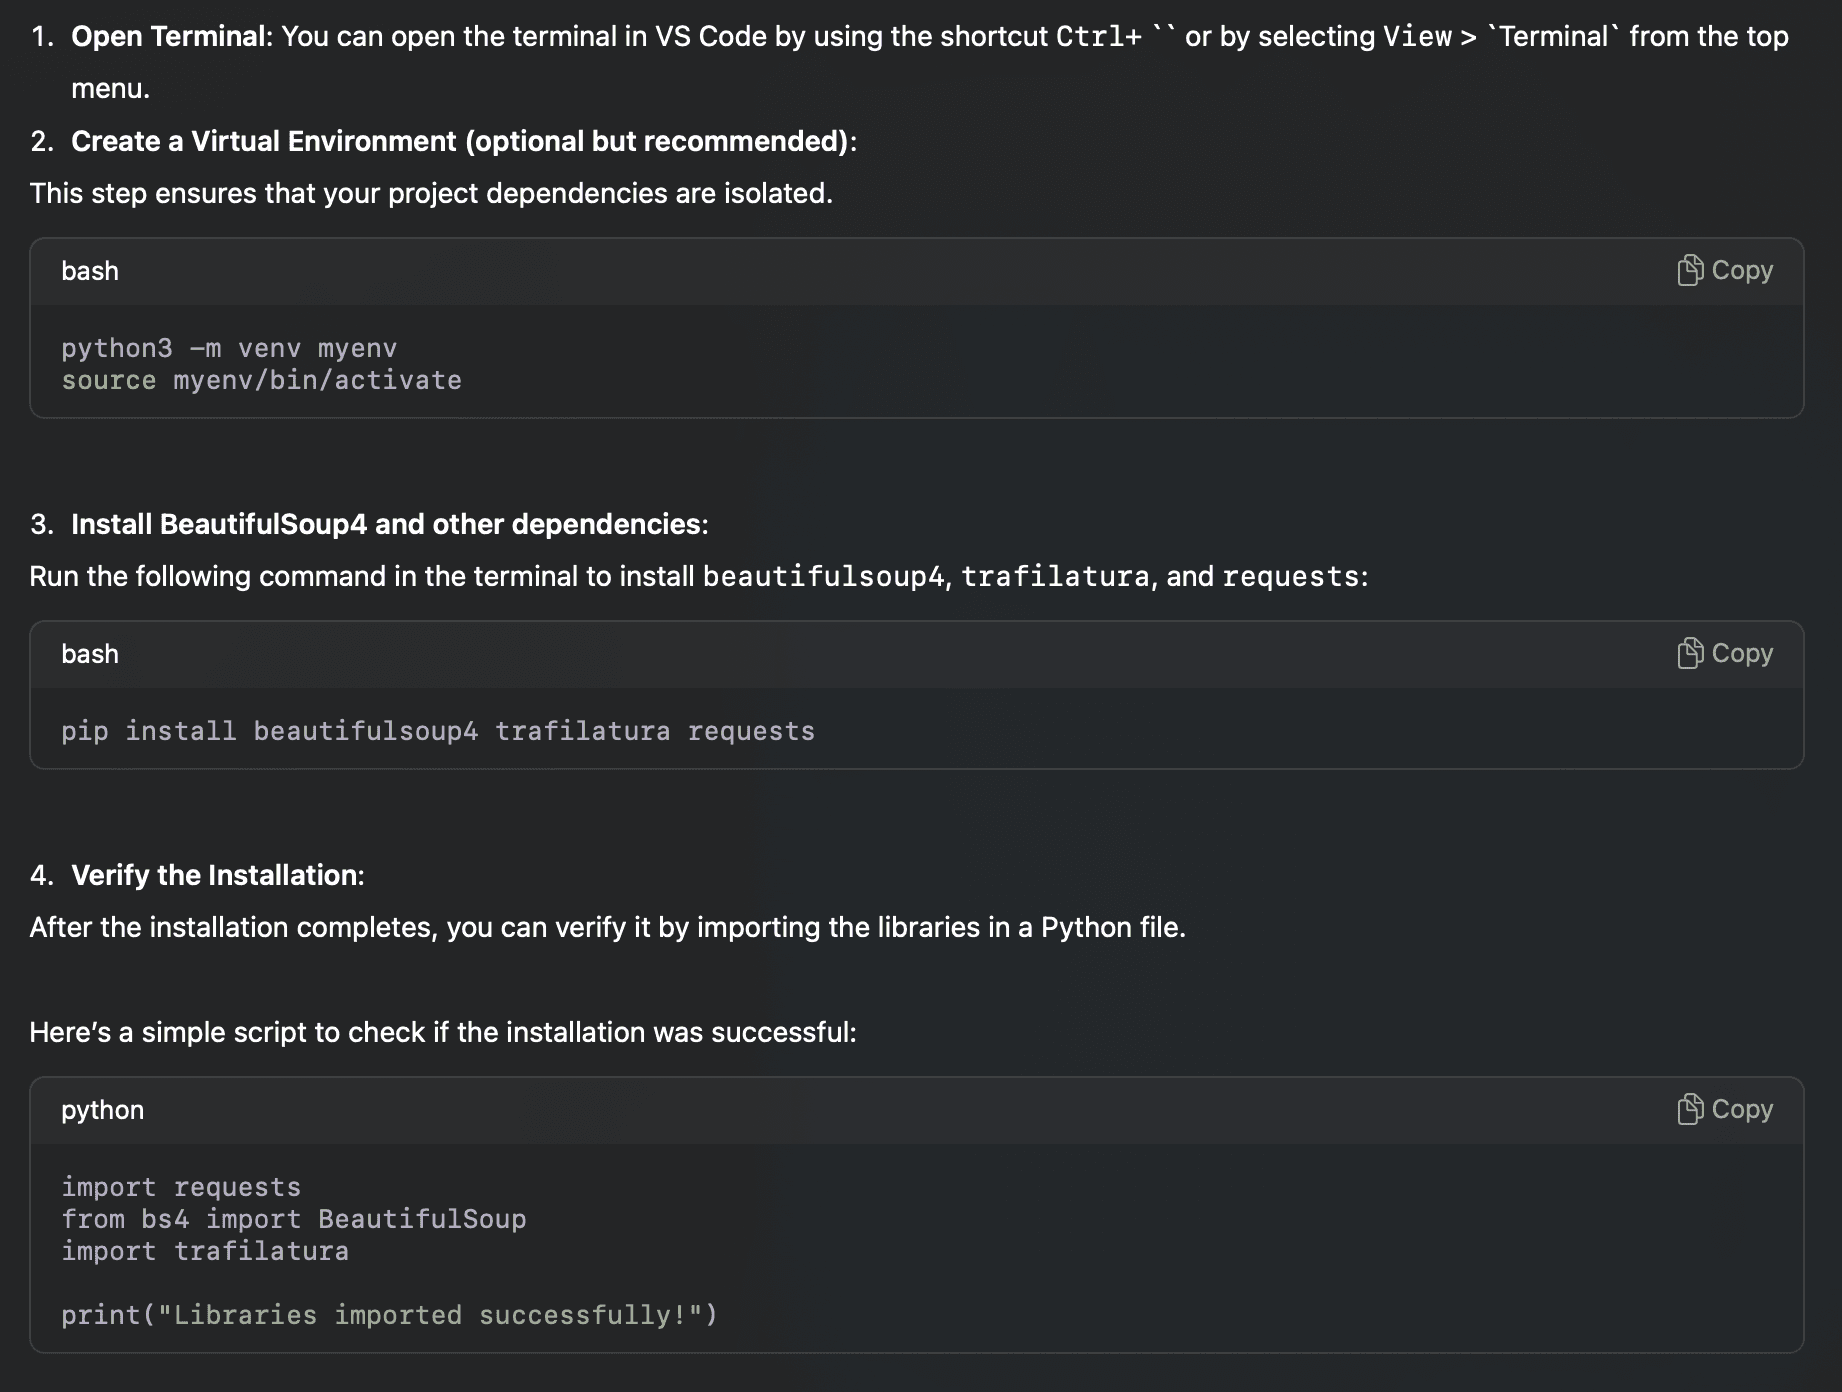
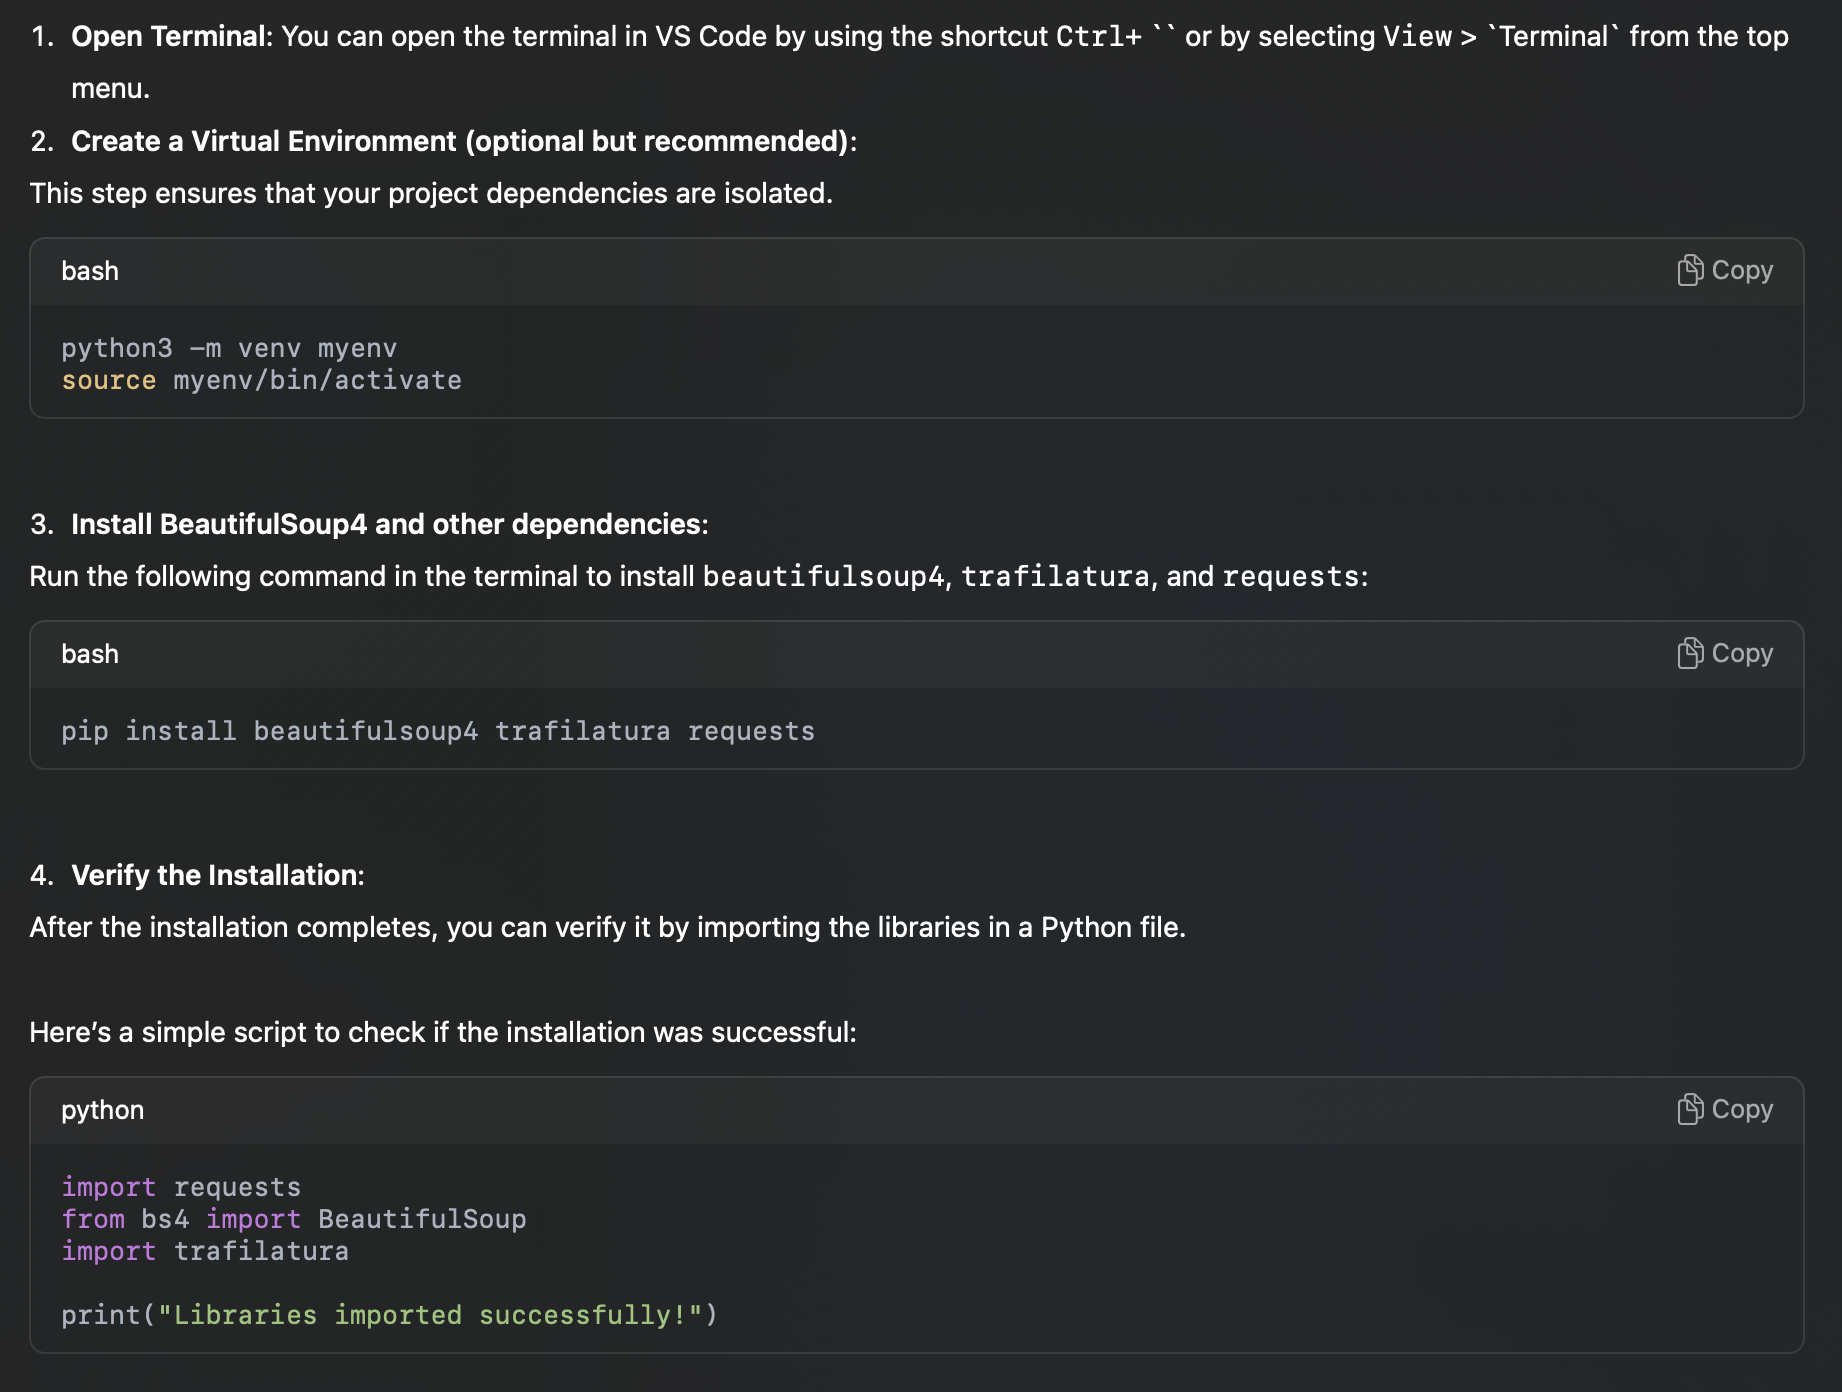
오티때 실습한 Trafilatura가 아닌 BeautifulSoup를 사용해서 VS Studio에 설치 후 진행했습니다.
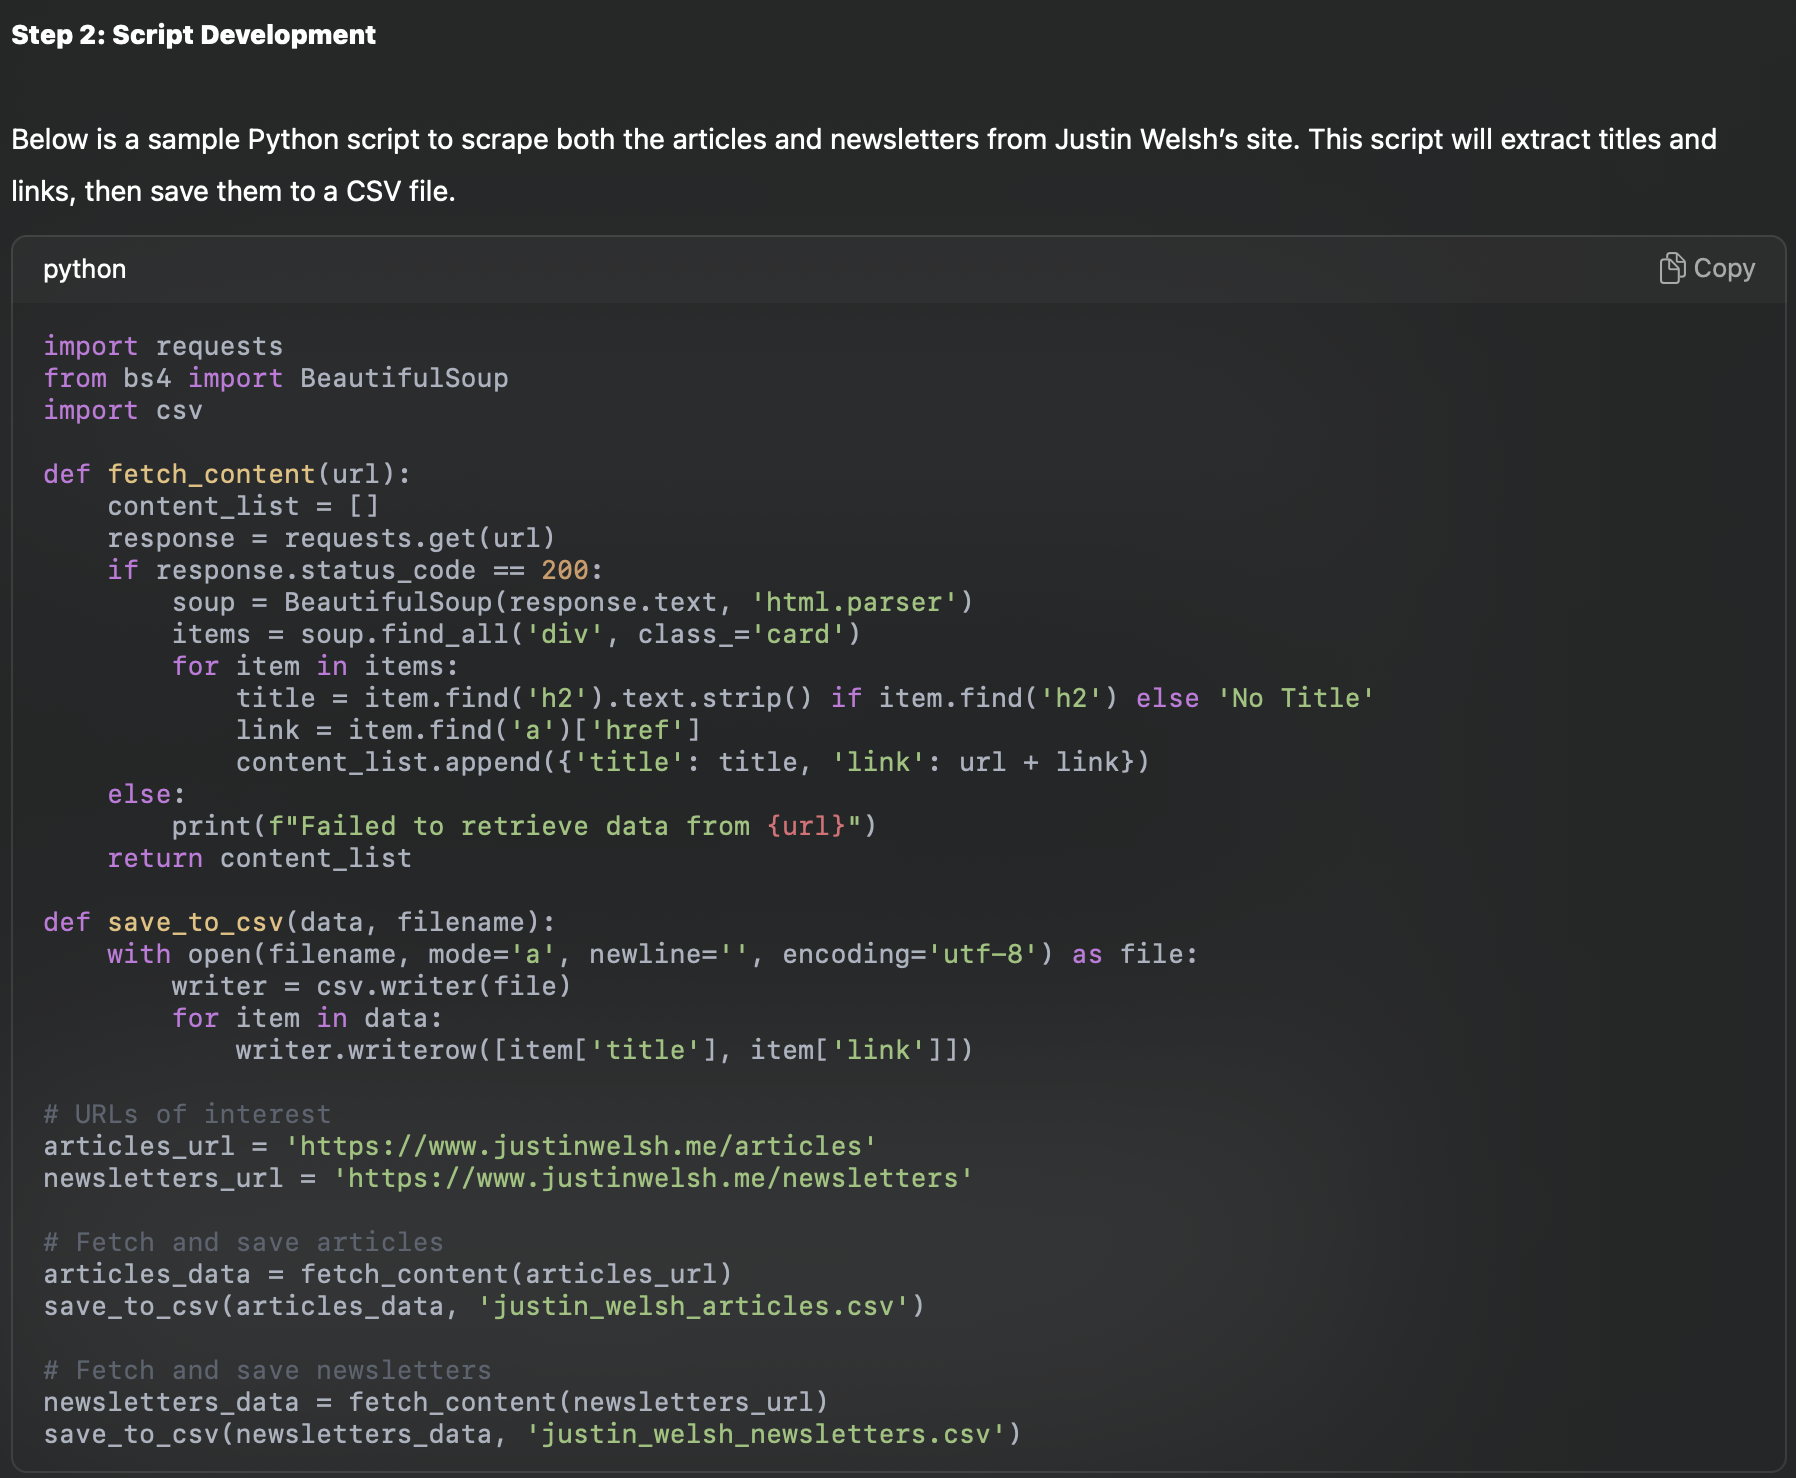
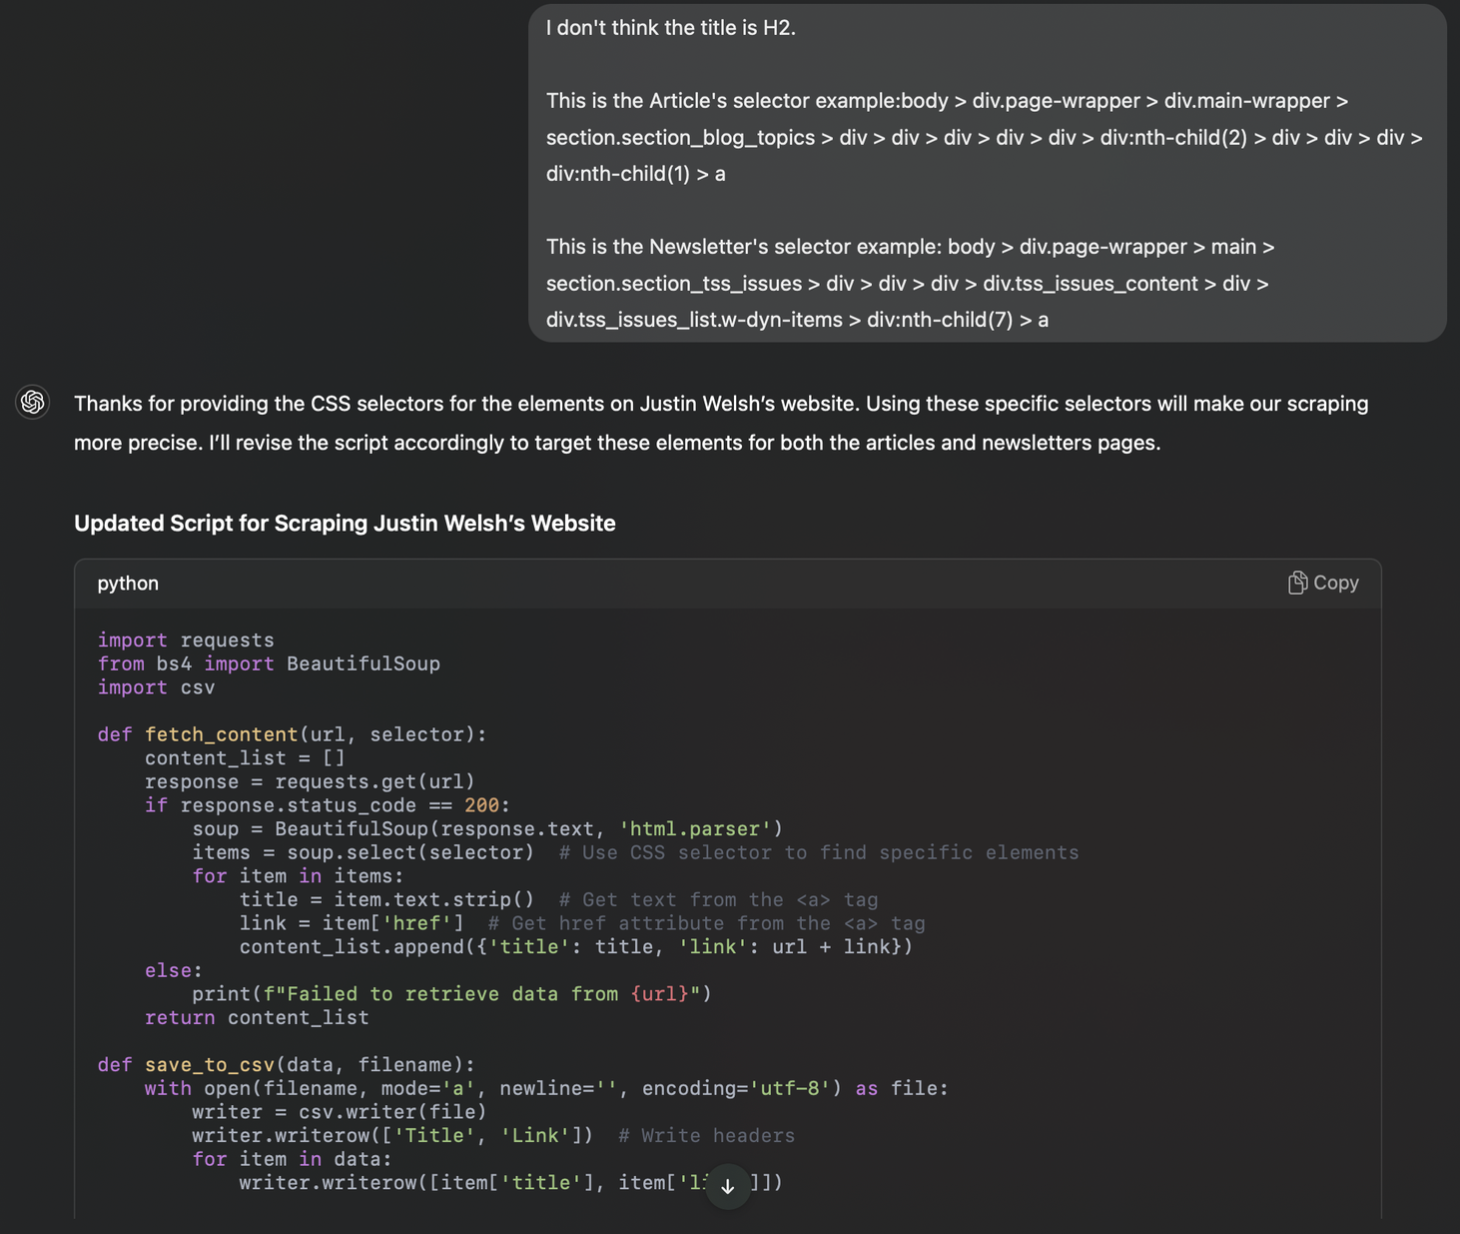
지피티가 작성한 코드
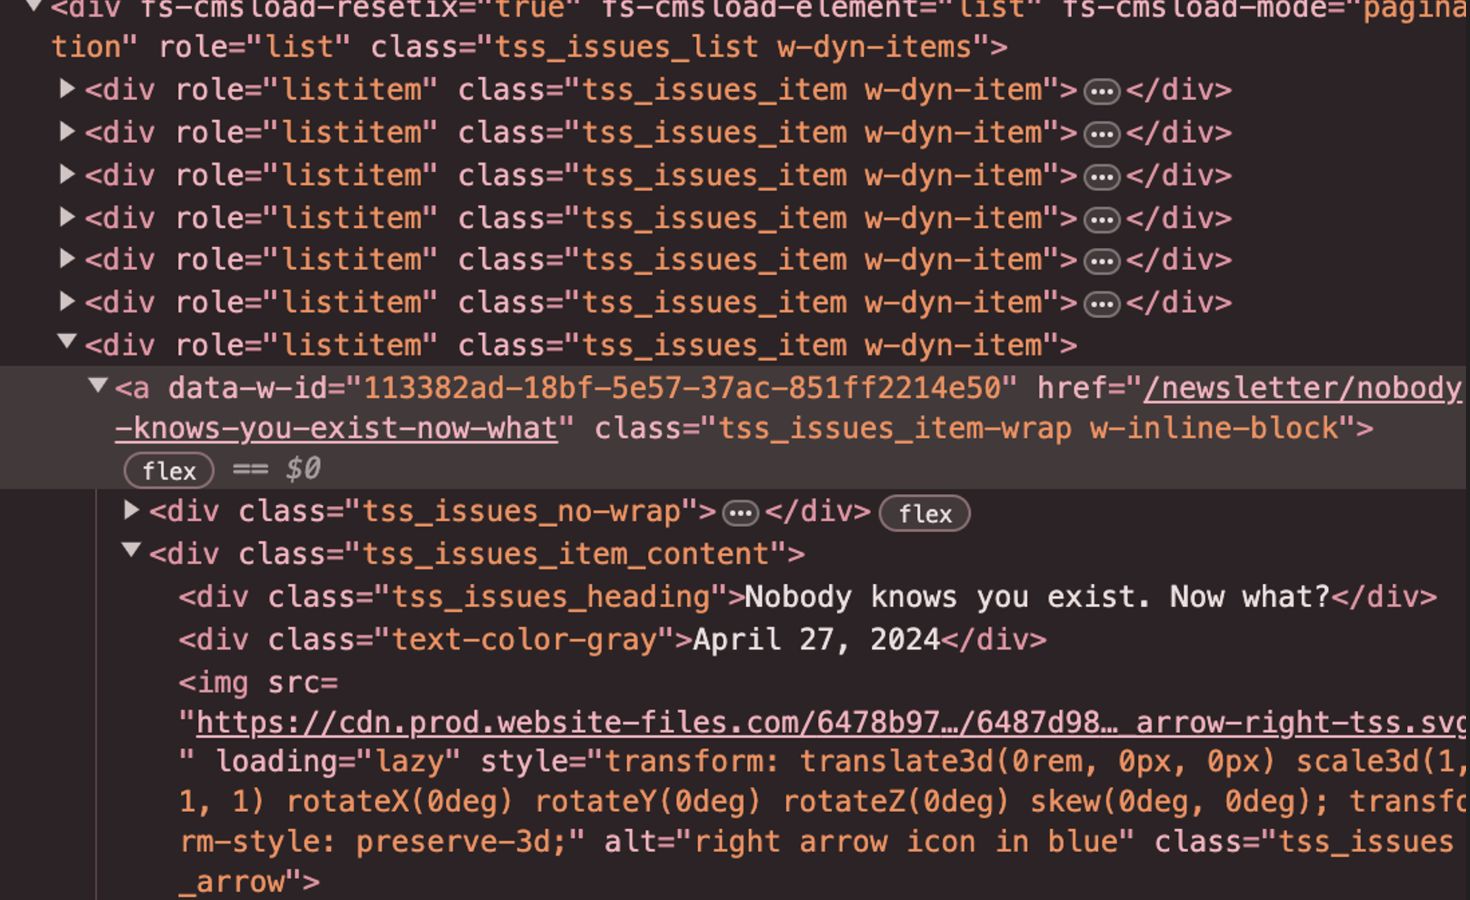
Inspect 모드로 사이트에서 title을 확인했을 때 <H2>가 아니었어서 Selector 값을 복사 후 제공
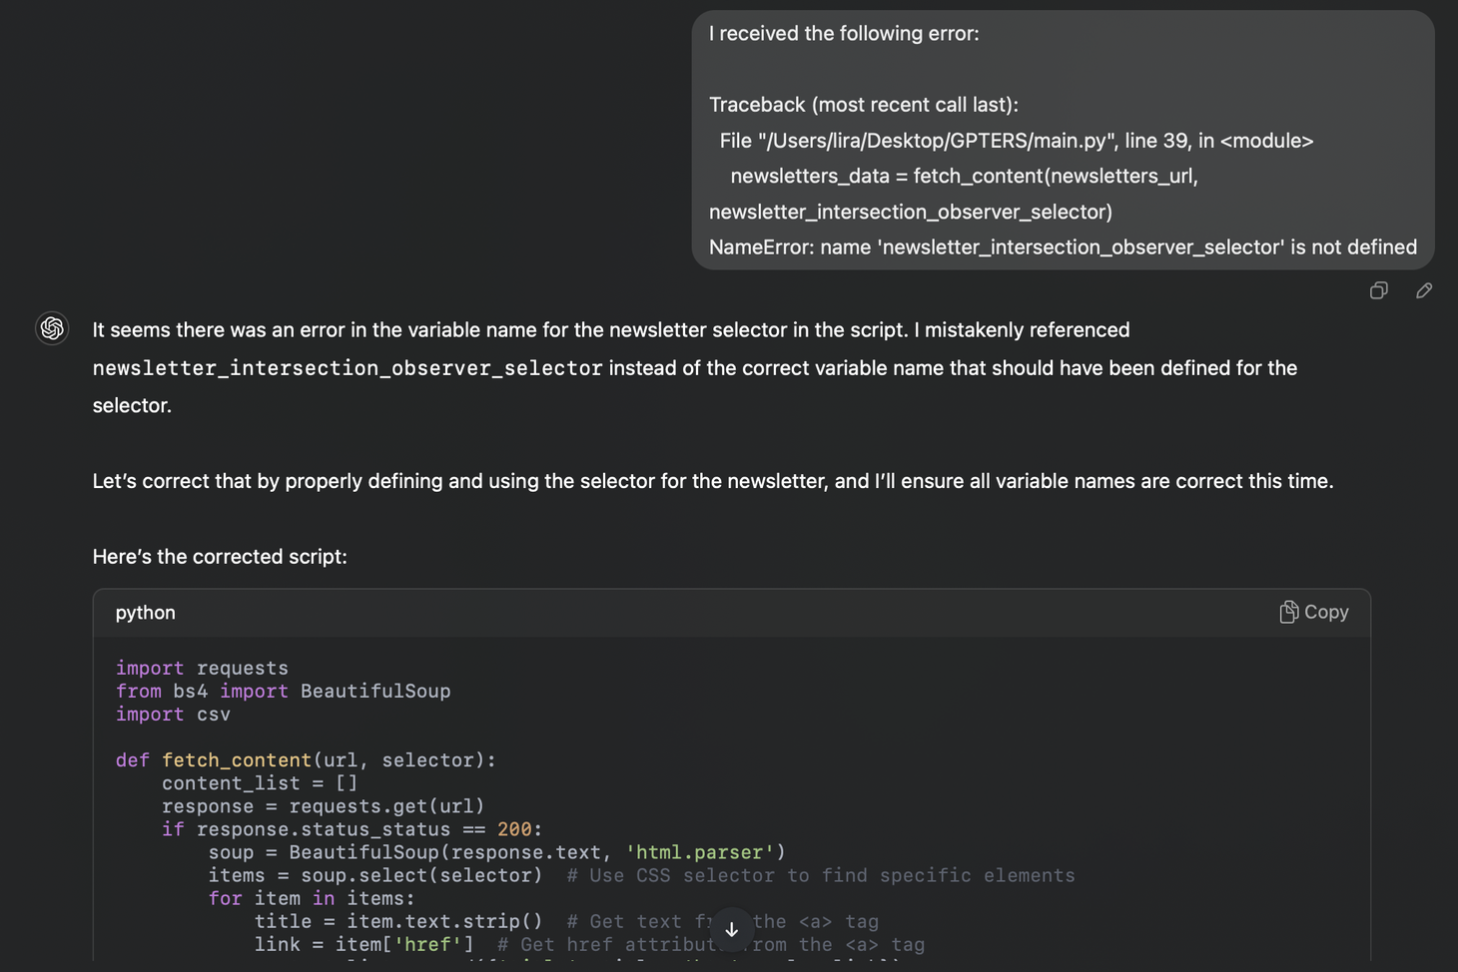
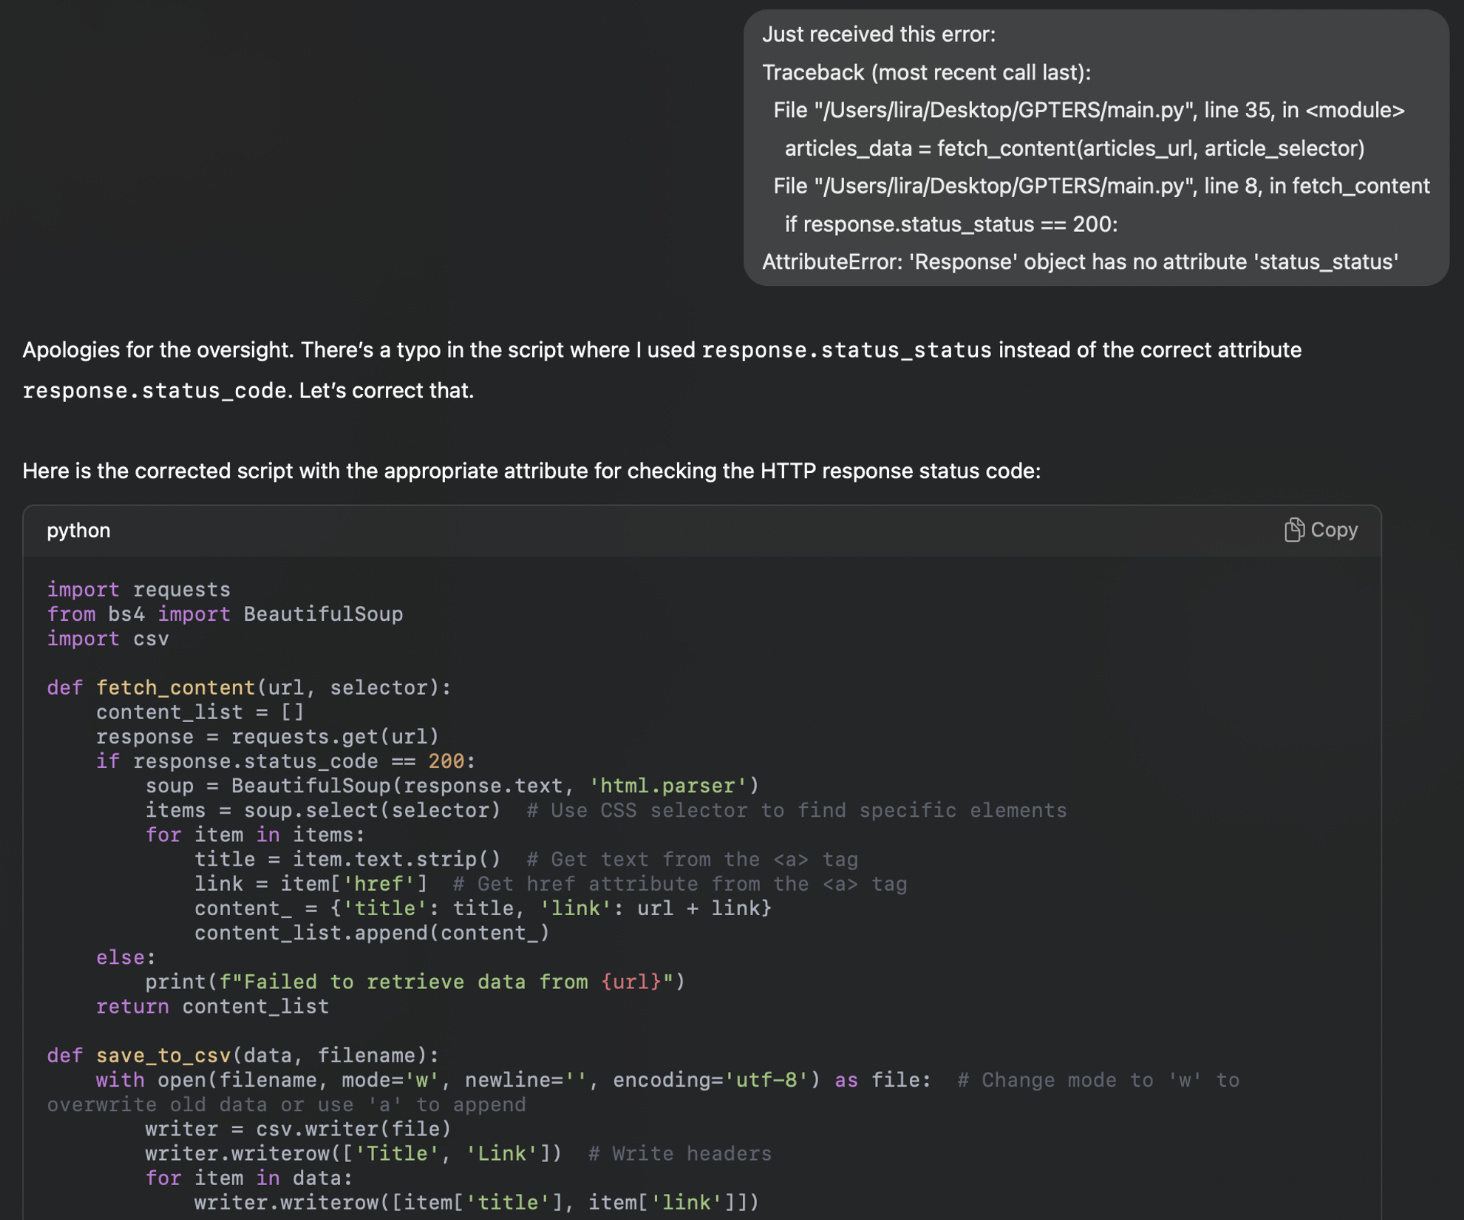
코드 실행 후 에러가 나는 부분을 복사해 계속 질문하며 코드를 수정
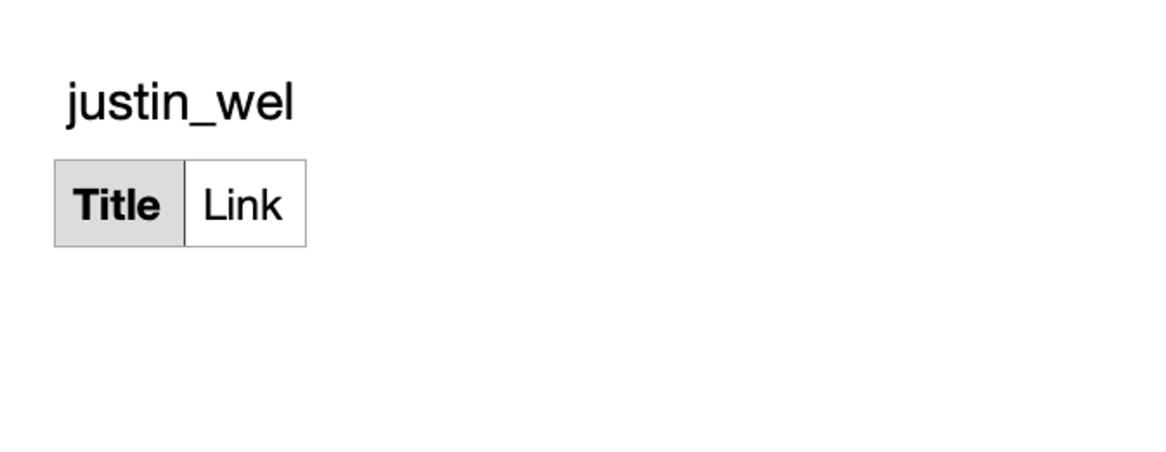
뉴스레터는 페이지에서 보이는 부분만큼 CSV 파일에 리스트업되어 저장되었음. 그러나 아티클은 빈화면으로 나옴.
→ 문제는 아티클 타이틀 관련 Selector 값을 잘못 복사해온 것
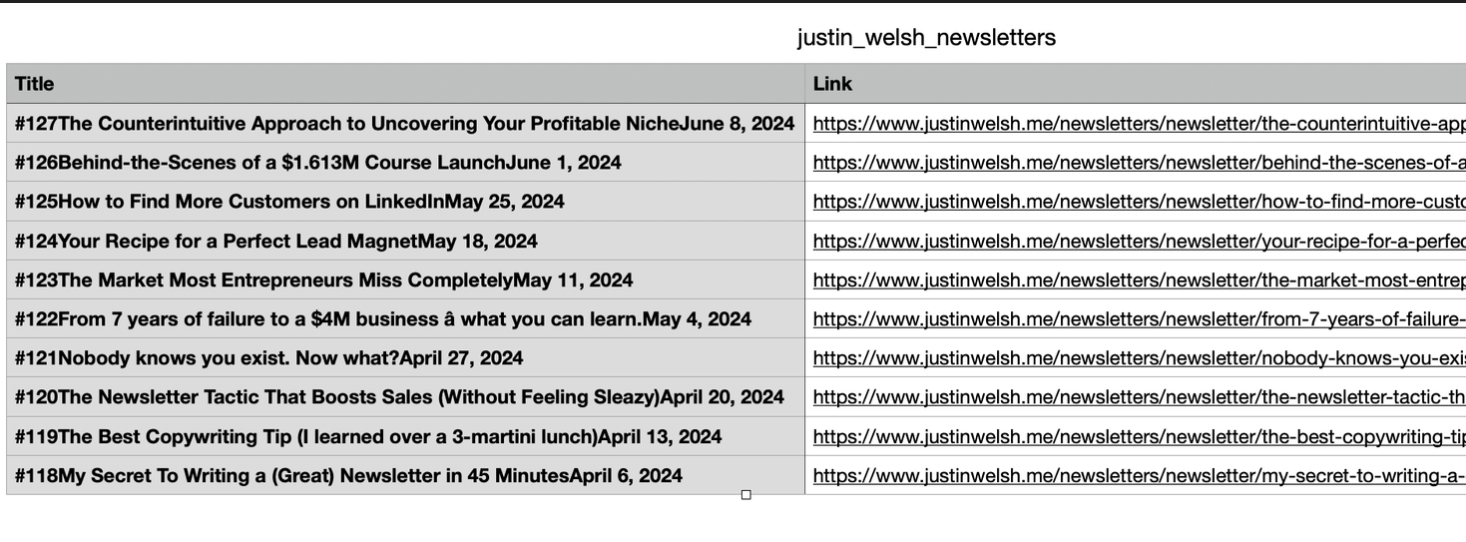
아티클 selector를 다시 찾아 코드 업데이트
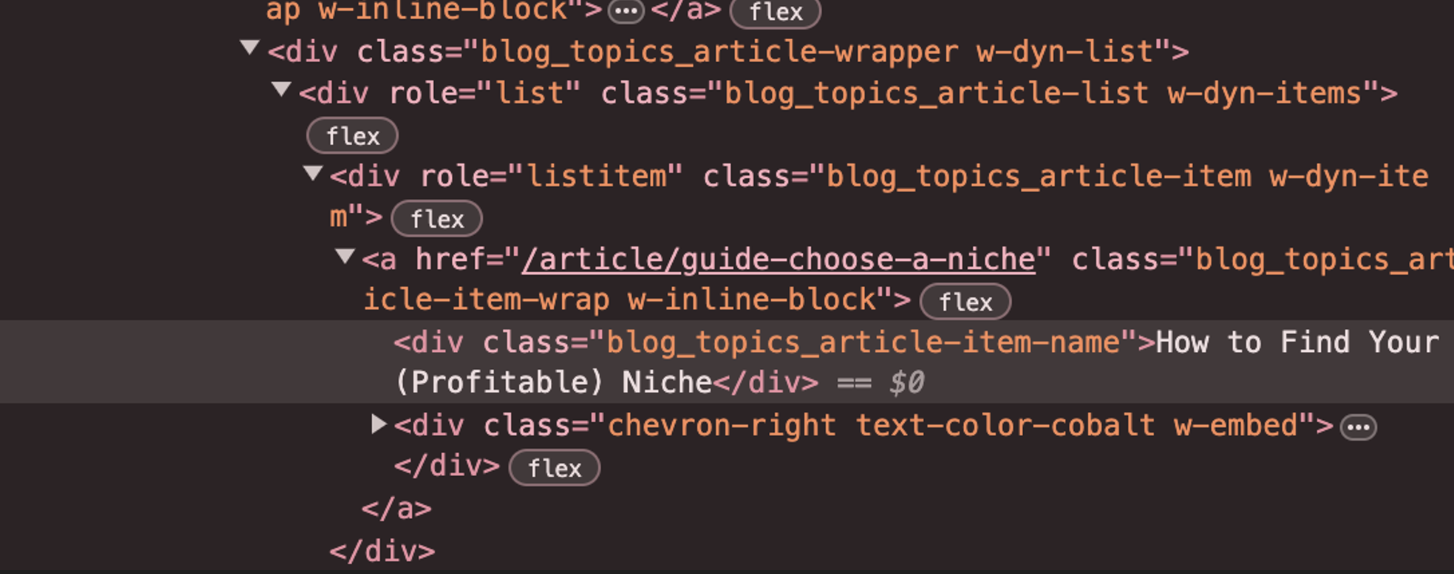
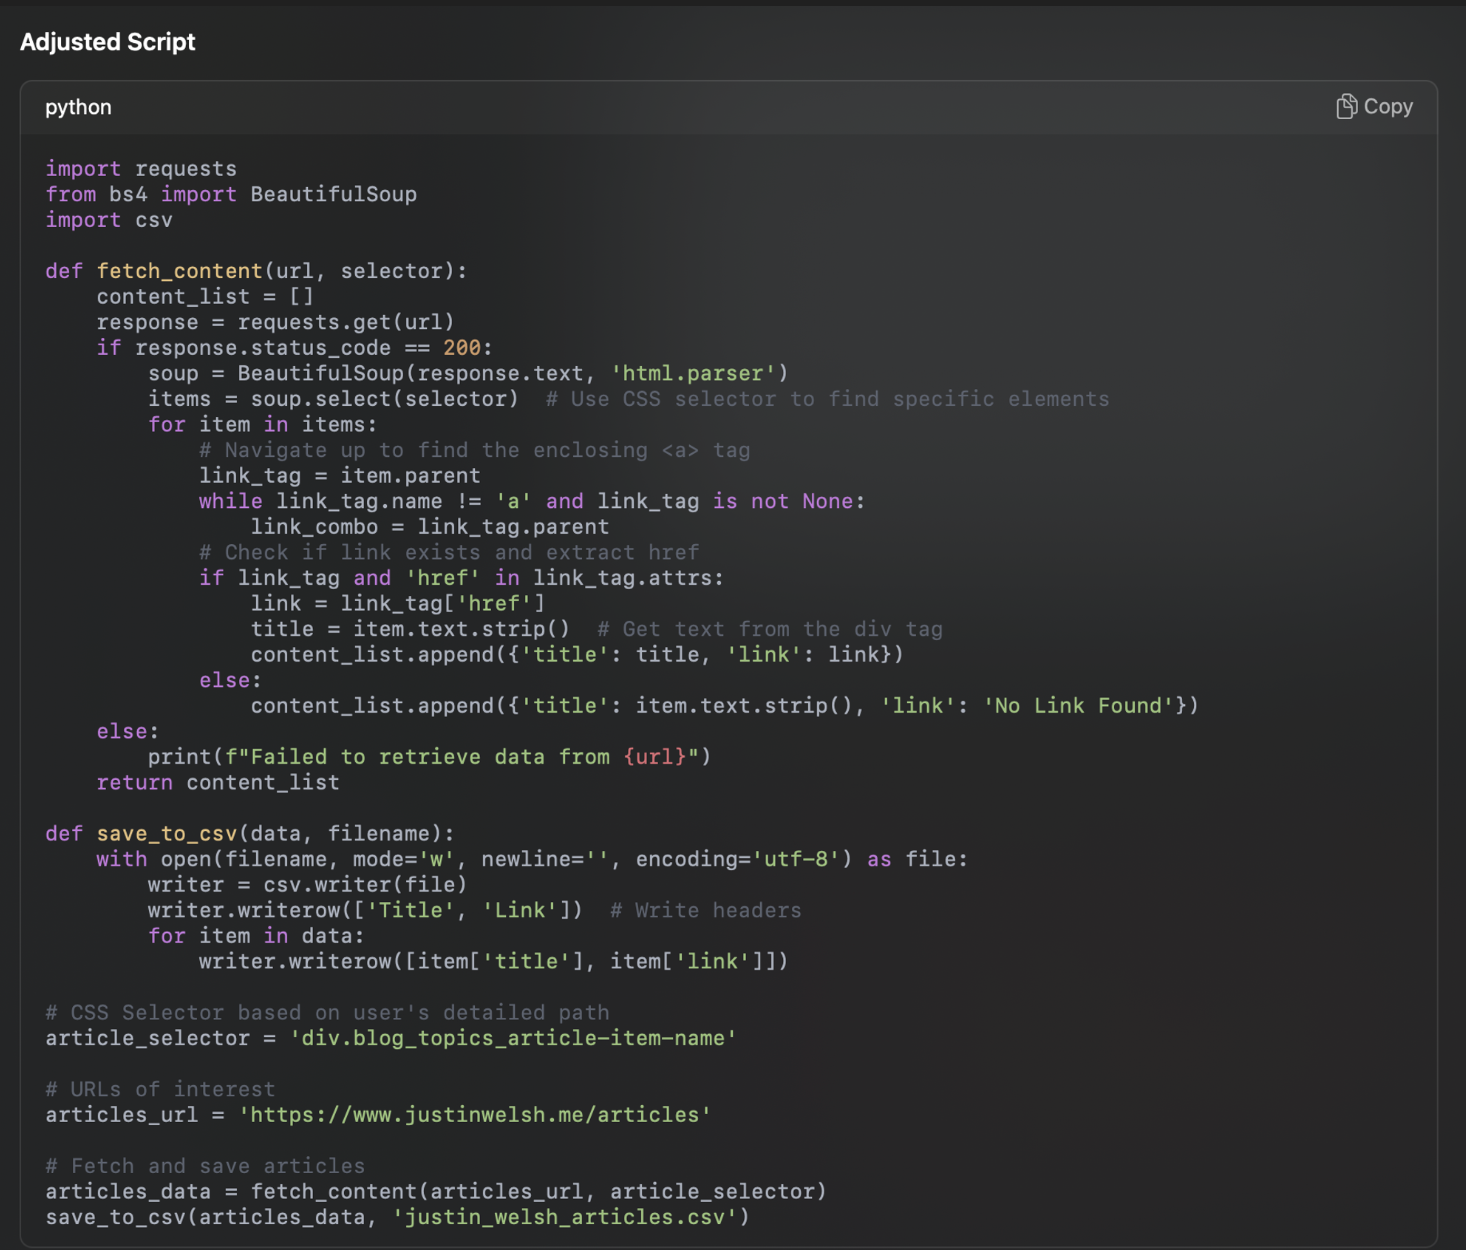
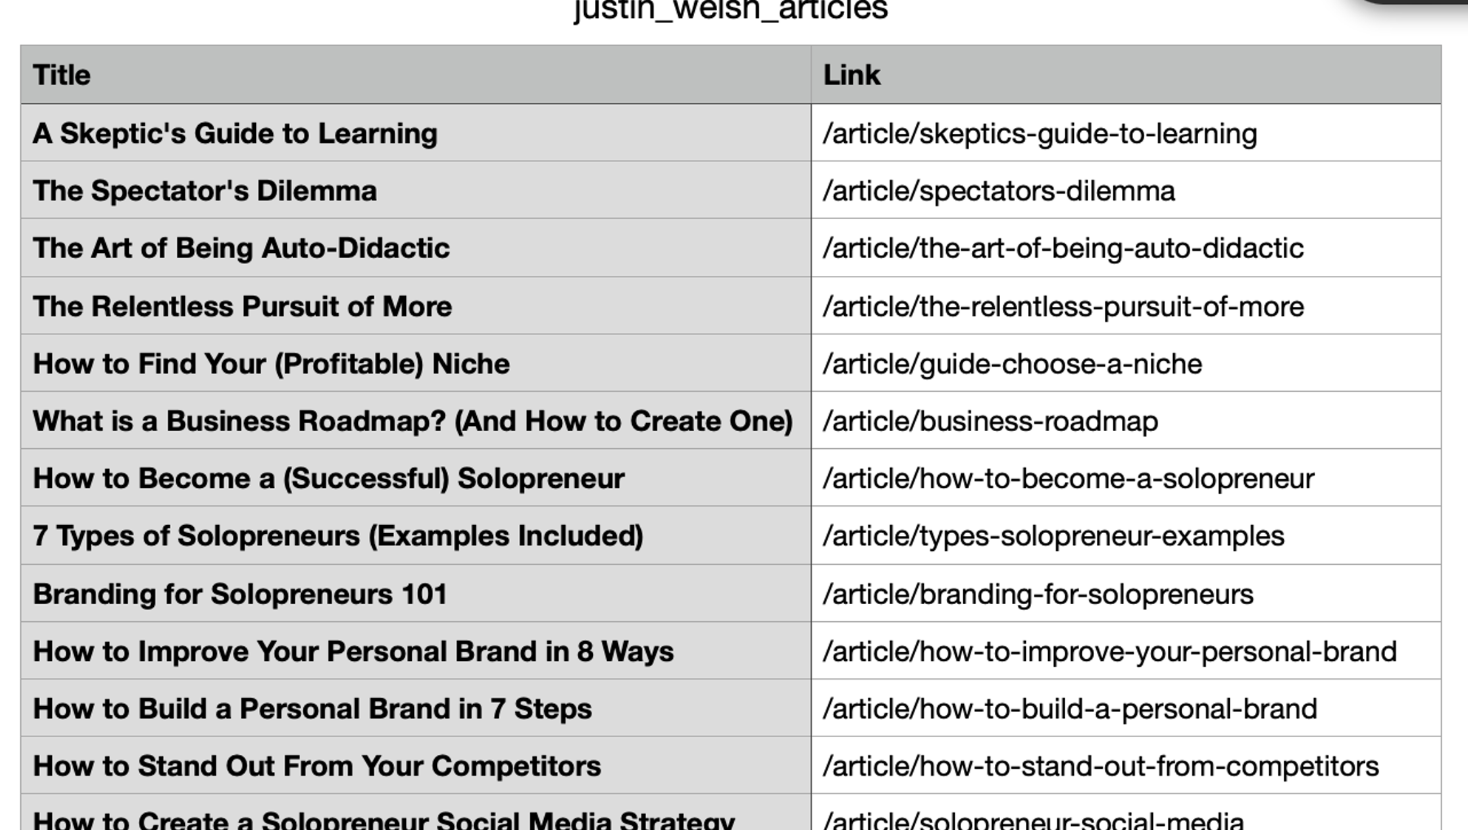
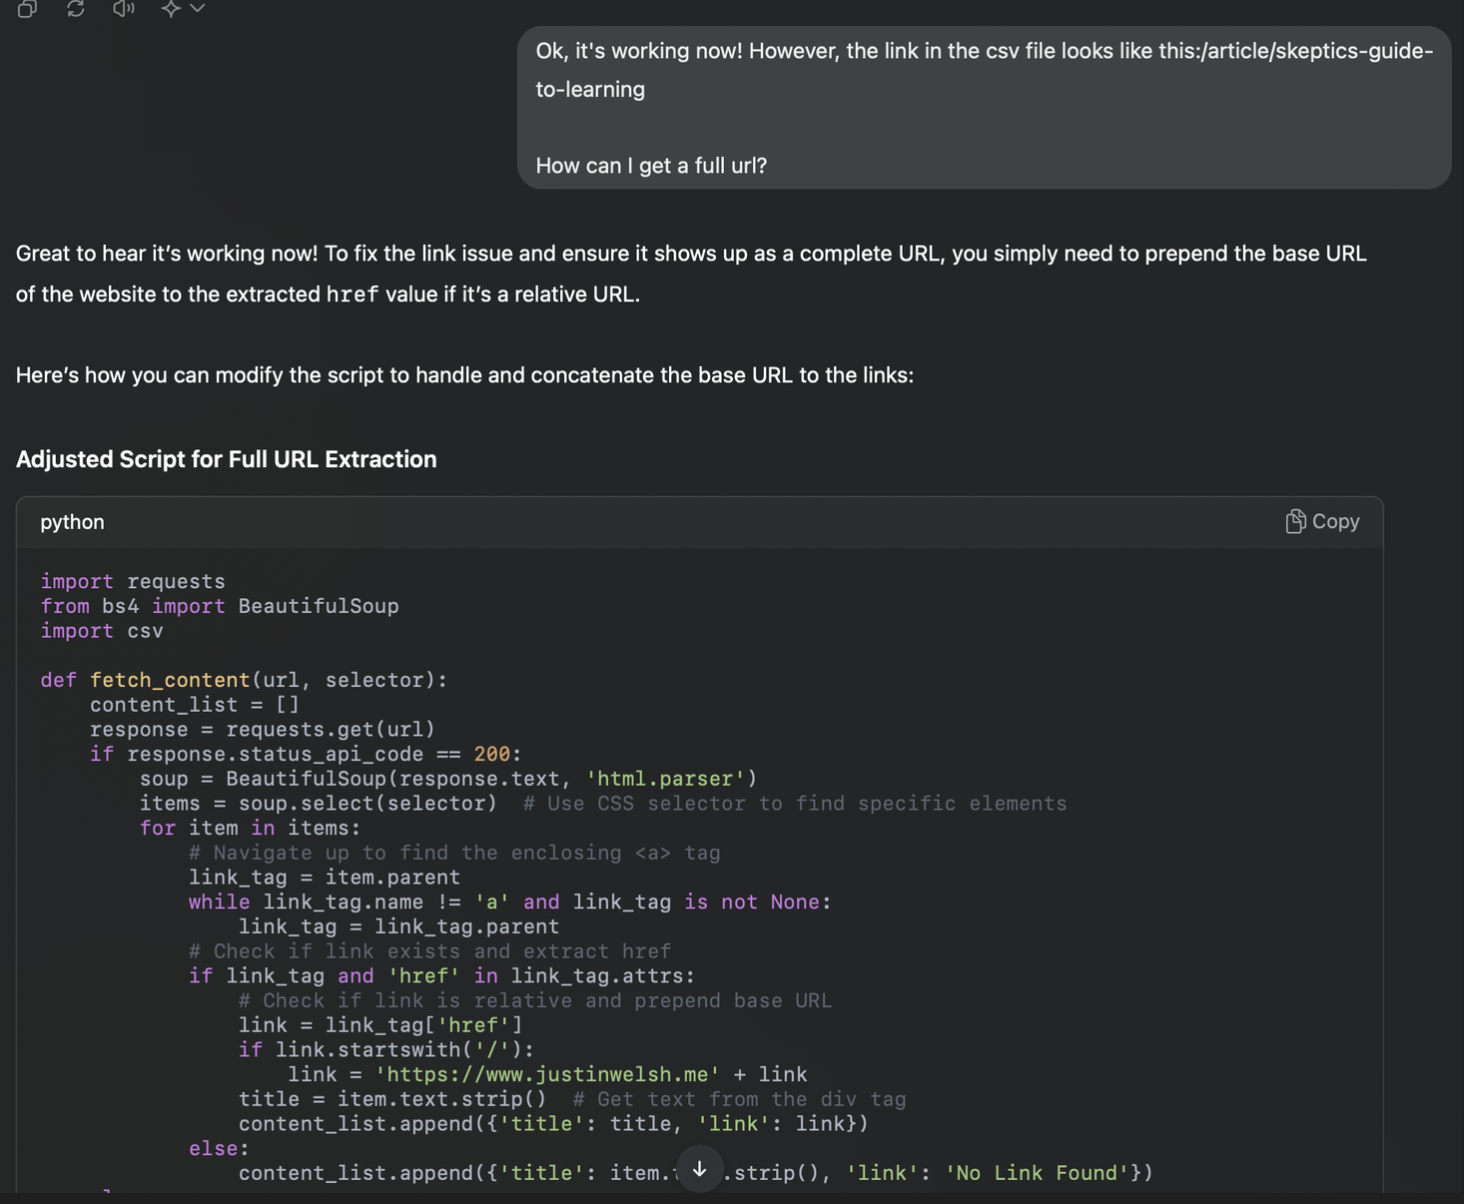
6. 아티클 리스트는 제대로 나오지만 URL이 제대로 나오지 않아서 다시 코드 수정
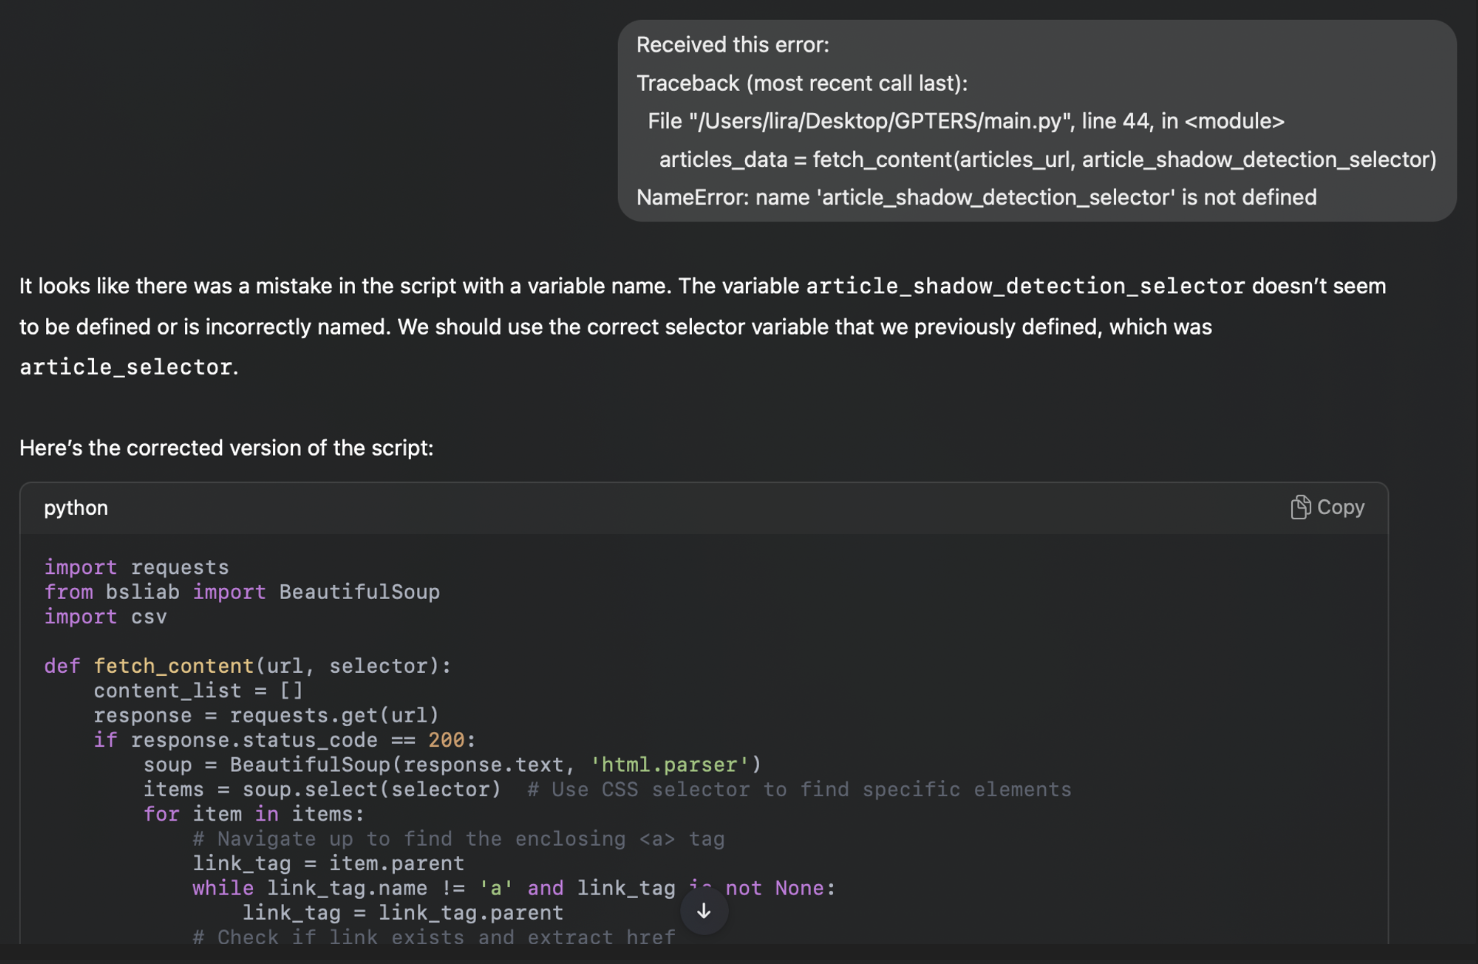
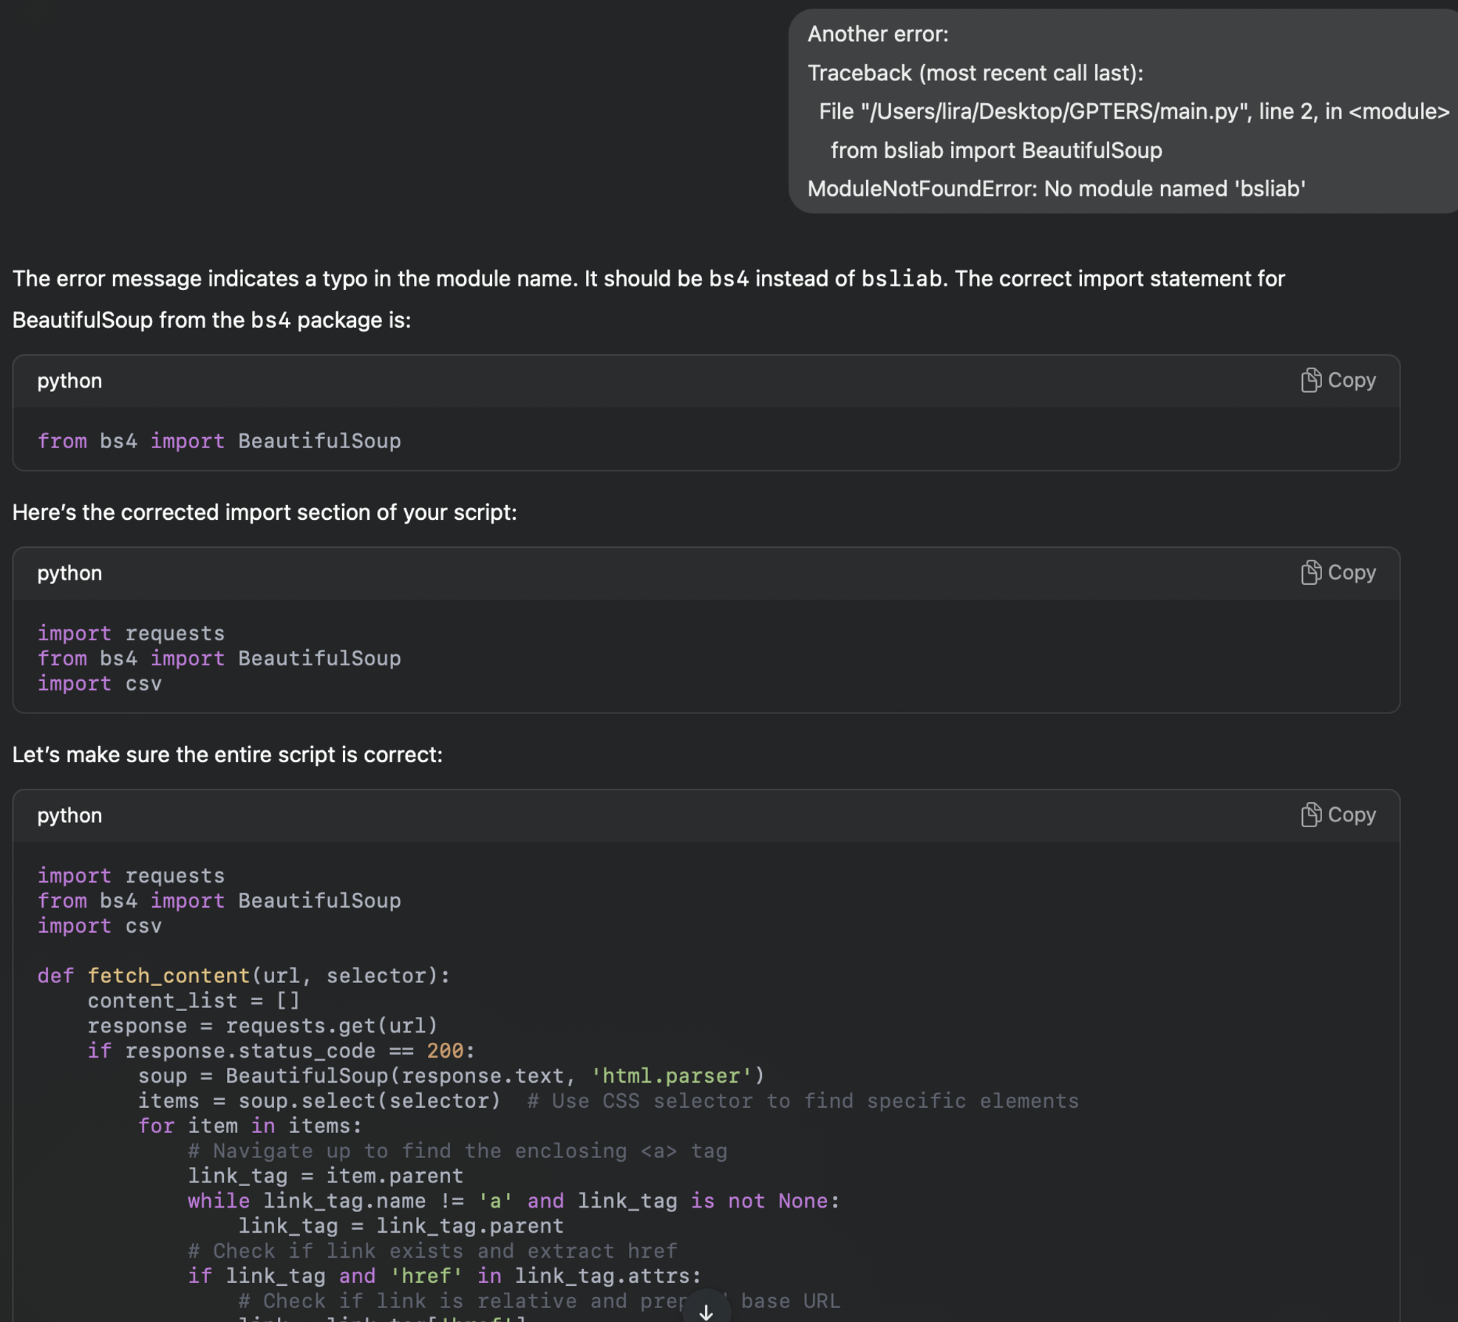
7. 에러가 나기 시작해서 다시 수정 (variable 이름이 잘못되었고 , beautifulsoup 불러오는 부분에 타이포)
→ 생각보다 GPT가 타이포를 자주 내는 것 같음
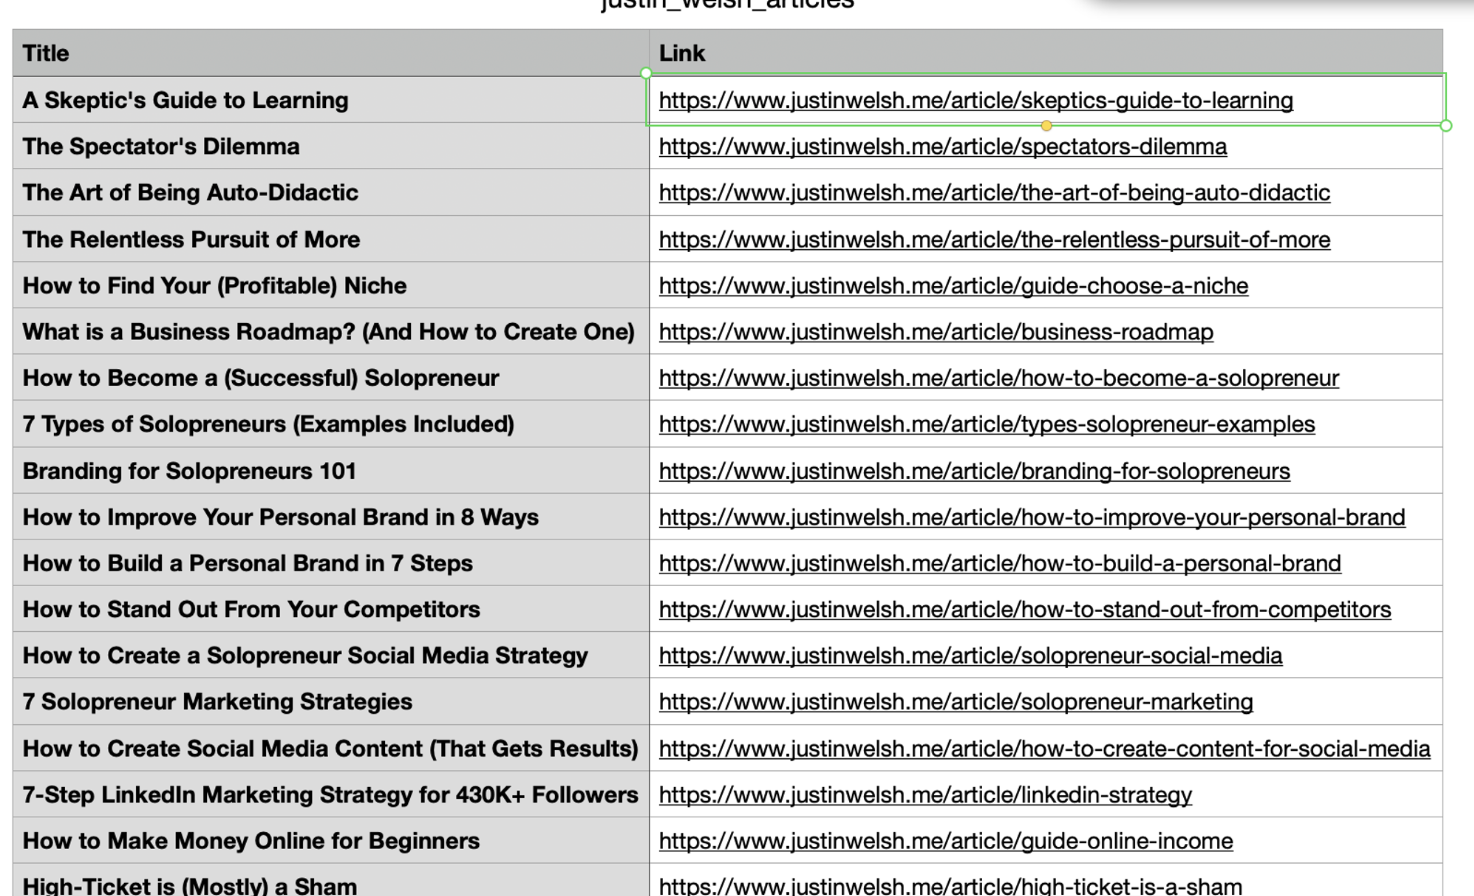
8. 완성!
import requests
from bs4 import BeautifulSoup
import csv

def fetch_content(url, selector):
    content_list = []
    response = requests.get(url)
    if response.status_code == 200:
        soup = BeautifulSoup(response.text, 'html.parser')
        items = soup.select(selector)  # Use CSS selector to find specific elements
        for item in items:
            # Navigate up to find the enclosing <a> tag
            link_tag = item.parent
            while link_tag.name != 'a' and link_tag is not None:
                link_tag = link_tag.parent
            # Check if link exists and extract href
            if link_tag and 'href' in link_tag.attrs:
                # Check if link is relative and prepend base URL
                link = link_tag['href']
                if link.startswith('/'):
                    link = 'https://www.justinwelsh.me' + link
                title = item.text.strip()  # Get text from the div tag
                content_list.append({'title': title, 'link': link})
            else:
                content_list.append({'title': item.text.strip(), 'link': 'No Link Found'})
    else:
        print(f"Failed to retrieve data from {url}")
    return content_list

def save_to_csv(data, filename):
    with open(filename, mode='w', newline='', encoding='utf-8') as file:
        writer = csv.writer(file)
        writer.writerow(['Title', 'Link'])  # Write headers
        for item in data:
            writer.writerow([item['title'], item['link']])

# Correct selector for articles
article_selector = 'div.blog_topics_article-item-name'

# URLs of interest
articles_url = 'https://www.justinwelsh.me/articles'

# Fetch and save articles
articles_data = fetch_content(articles_url, article_selector)
save_to_csv(articles_data, 'justin_welsh_articles.csv')
해결하지 못한 부분
보이는 페이지에 나온 아티클/뉴스레터만 크롤링 했음
처음부터 혼자 코드를 짜는게 아니고 GPT가 짠 코드를 바탕으로 같이 에러를 해결하다보니 진행도 빨랐고, 간단한 크롤링이었지만 해낼 수 있었다는게 정말 뿌듯했던 과제였습니다!! 😆

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
GPT를 이용해서, 못했던걸 해보게 되는 경험 — 이게 너무 좋네요 !