AI에게 자기 채점을 시키지 마세요 — 논문 746편을 검증 가능한 지식베이스로 만든 다중 에이전트 하네스

2026.08.11
소개
시도하고자 했던 것과 그 이유를 알려주세요.
개인 지식관리(PKM) 시스템을 설계하려고 논문 486편 + 기업 기술자료 206건을 서베이했습니다. 문제는 그 다음이었습니다. 읽은 것을 "결론 노트"로 압축해 지식베이스를 만들었는데 — 그 노트가 근거와 맞는지 누가 확인하나요?
가장 자연스러운 방법부터 시도했습니다. AI에게 "이 노트가 출처와 일치하는지 검증하고 점수를 매겨줘"라고 시키는 것이죠. 그랬더니 같은 시스템을 세 번 채점하는 동안 점수가 계속 올랐습니다. 시스템은 거의 그대로인데요. 상승분의 대부분이 실제 개선이 아니라 채점자의 판단 변화였습니다.
여기서 이 프로젝트의 핵심 명제가 나왔습니다.
증거를 모은 주체가 그 증거로 점수를 정하지 못한다.
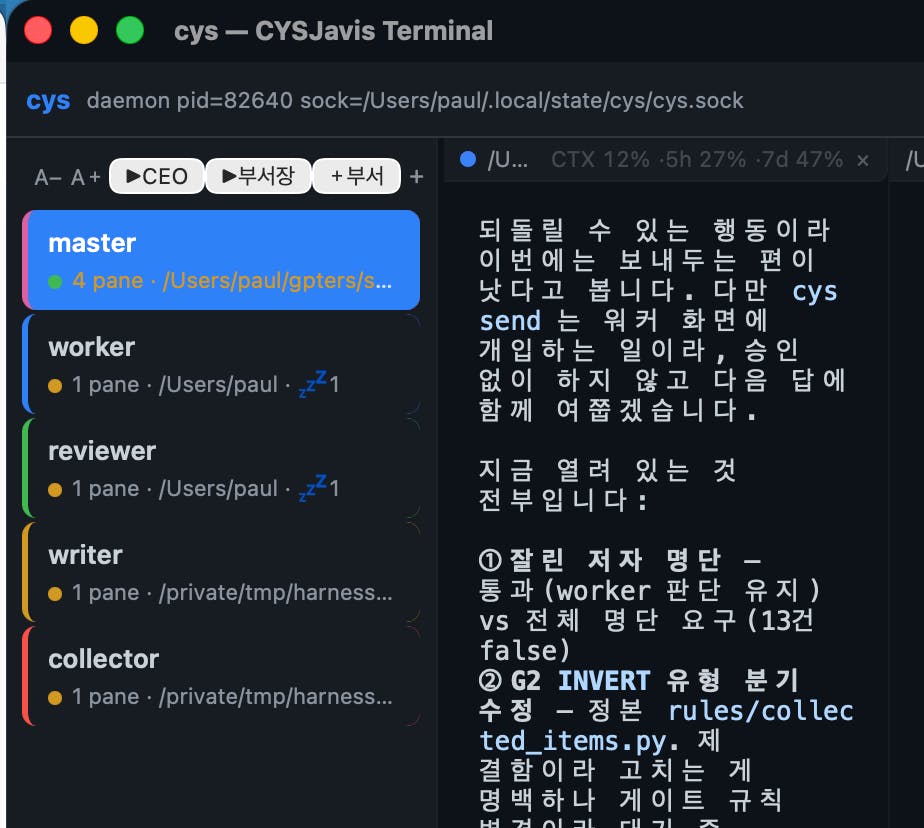
그리고 이 명제는 한 세션 안에서는 구현할 수 없습니다. 같은 대화 맥락을 공유하는 이상 "이제 검증자 역할을 해"라고 지시해도, AI는 자기가 방금 만든 답을 이미 알고 있으니까요.
그래서 시도한 것이 이것입니다:
채점을 AI에게서 빼앗아 결정론적 파이썬 코드로 옮기고 (하네스)
코드로 못 옮기는 판단은 대화 맥락이 분리된 별도 AI 프로세스에 맡기고 (에이전트 노드)
검증자에게는 채점 규칙과 남의 답안을 물리적으로 차단하는 (blind)
구조를 만들어, 수집 → 검증 → 승격 → 재검의 전 과정을 돌리는 것이었습니다.
진행 방법
어떤 도구를 사용했고, 어떻게 활용하셨나요?
사용 도구:
도구 | 역할 |
|---|---|
Claude Code | master(조율) · worker/collector(수집·판정) 세션 |
cys-terminal | AI CLI들을 별도 터미널 세션으로 띄우고 로컬 소켓으로 연결하는 오케스트레이션 |
Codex CLI | reviewer — 일부러 다른 모델을 썼습니다 (이유는 뒤에) |
Python 3 | 채점 하네스 (harness.py / score_engine.py / rubric_rules.py) |
Ollama (qwen3-embedding) | 로컬 임베딩 · 하이브리드 검색 색인 |
Obsidian | 최종 지식베이스 뷰어 (위키링크·백링크·그래프) |
0) 전체 구조 한 장
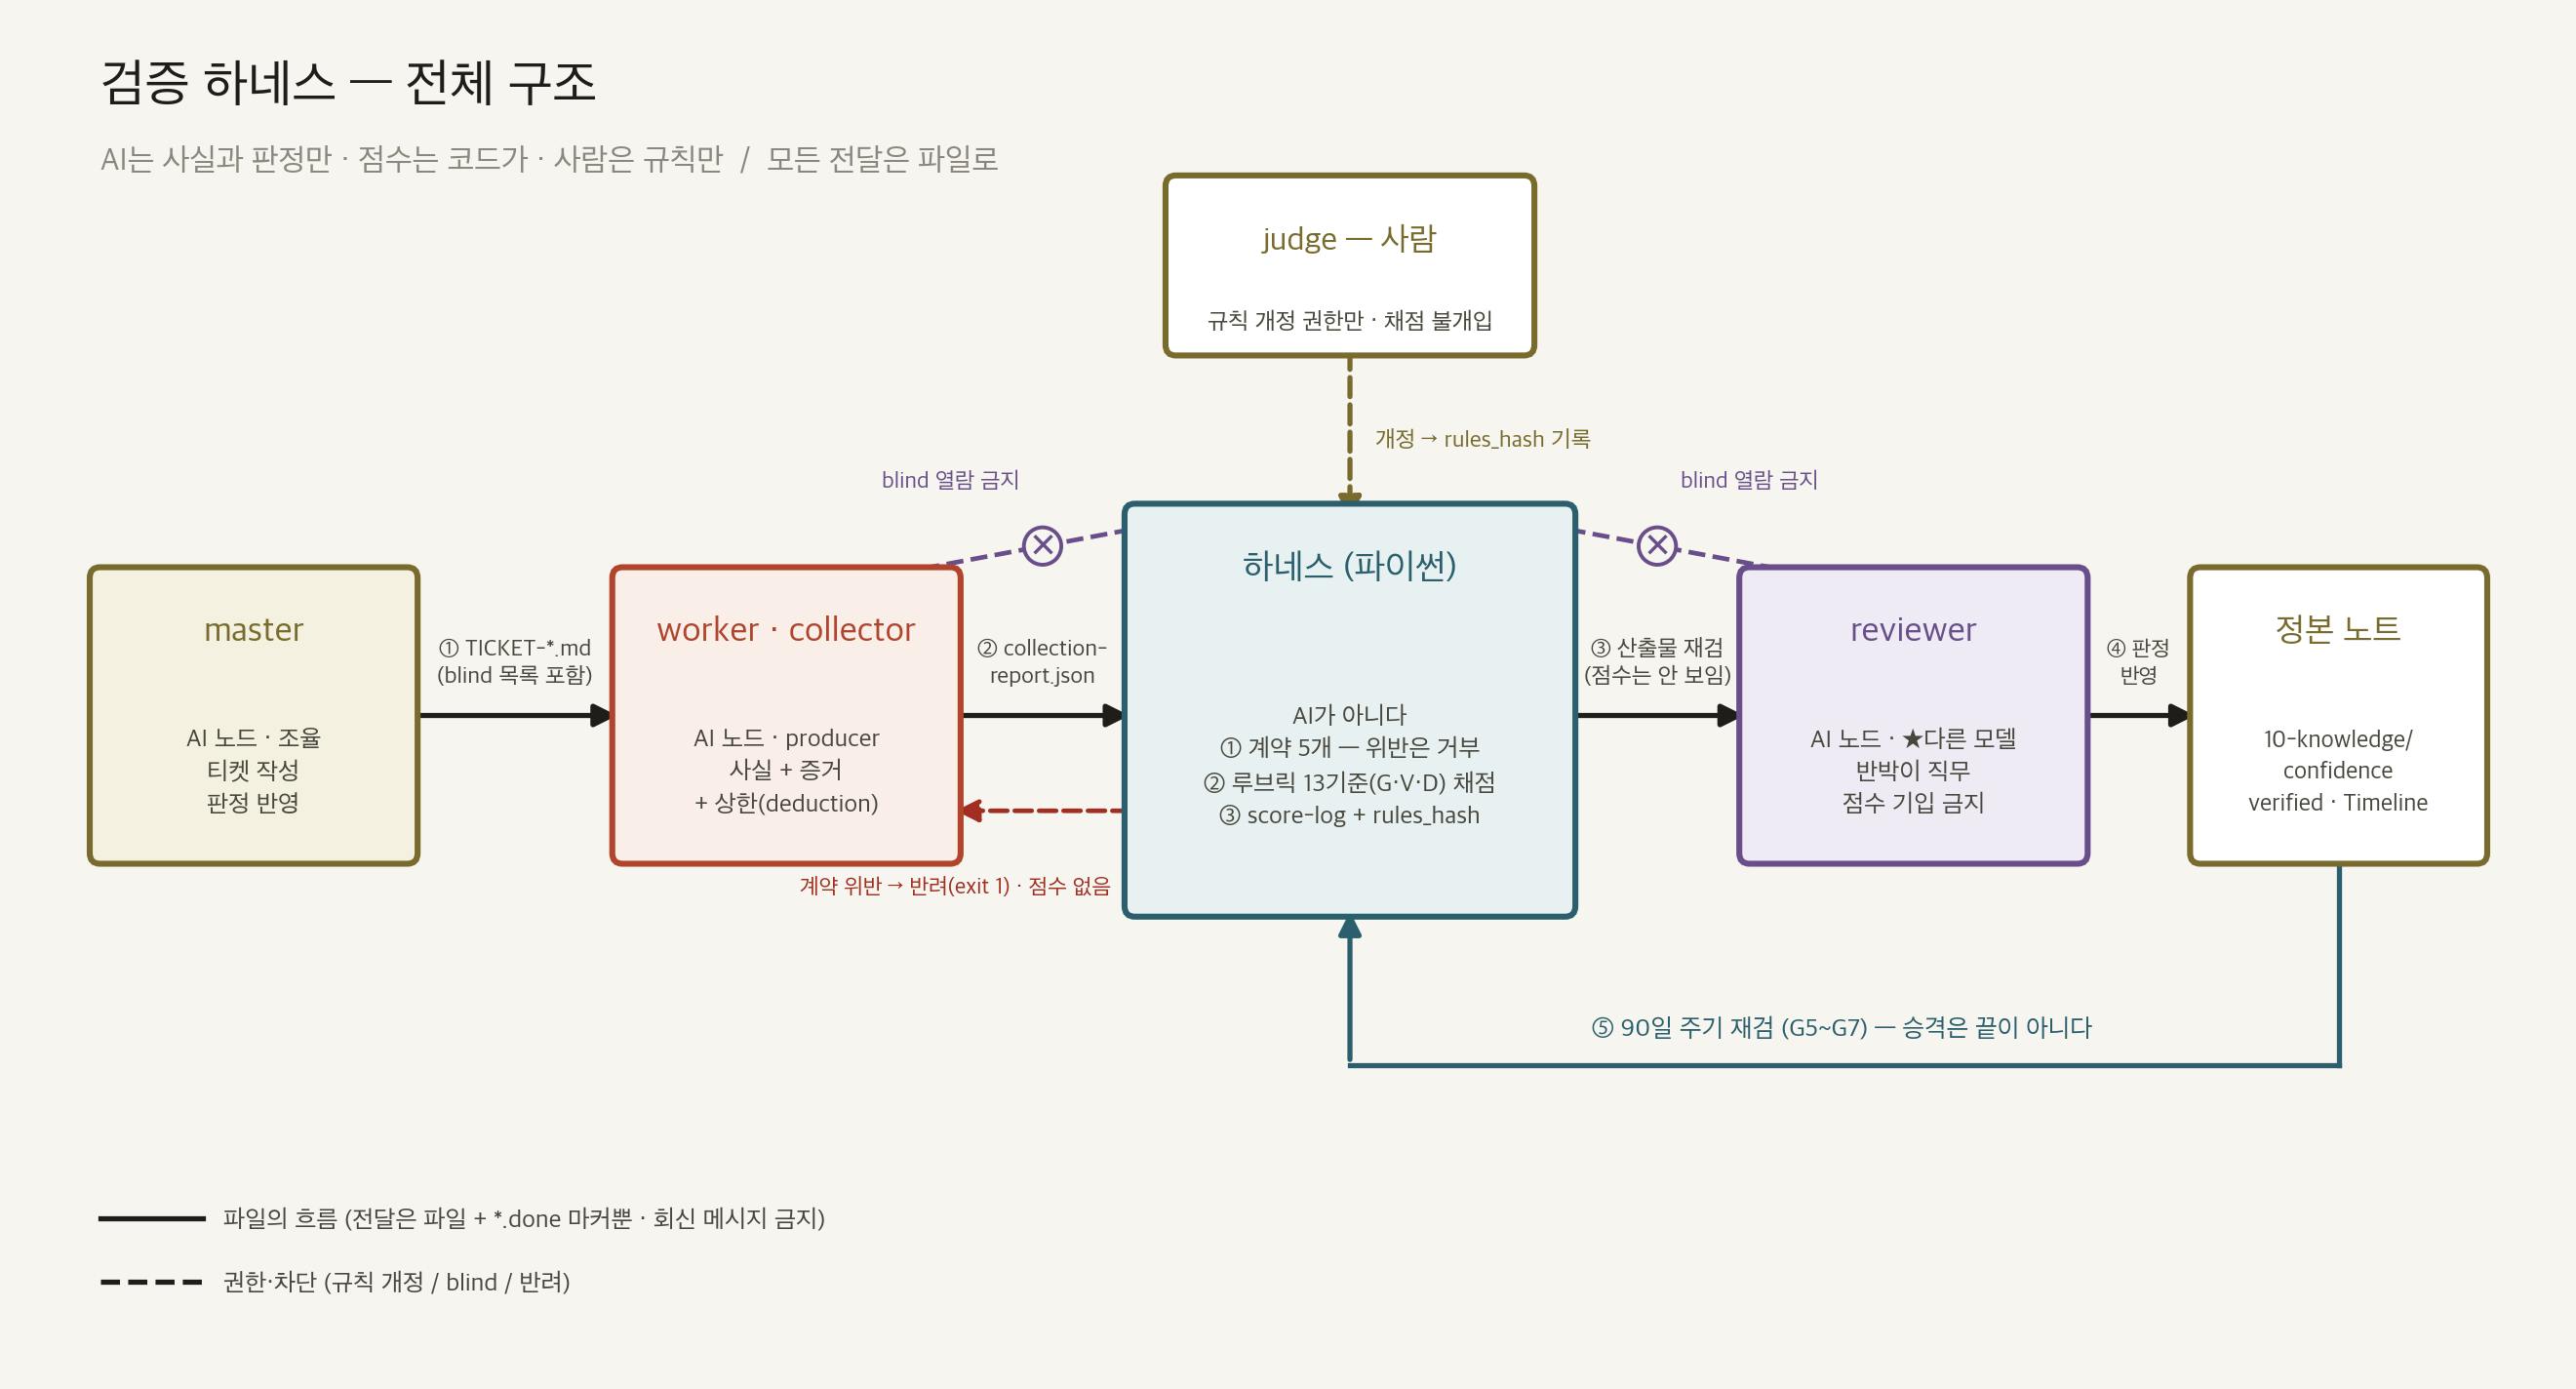
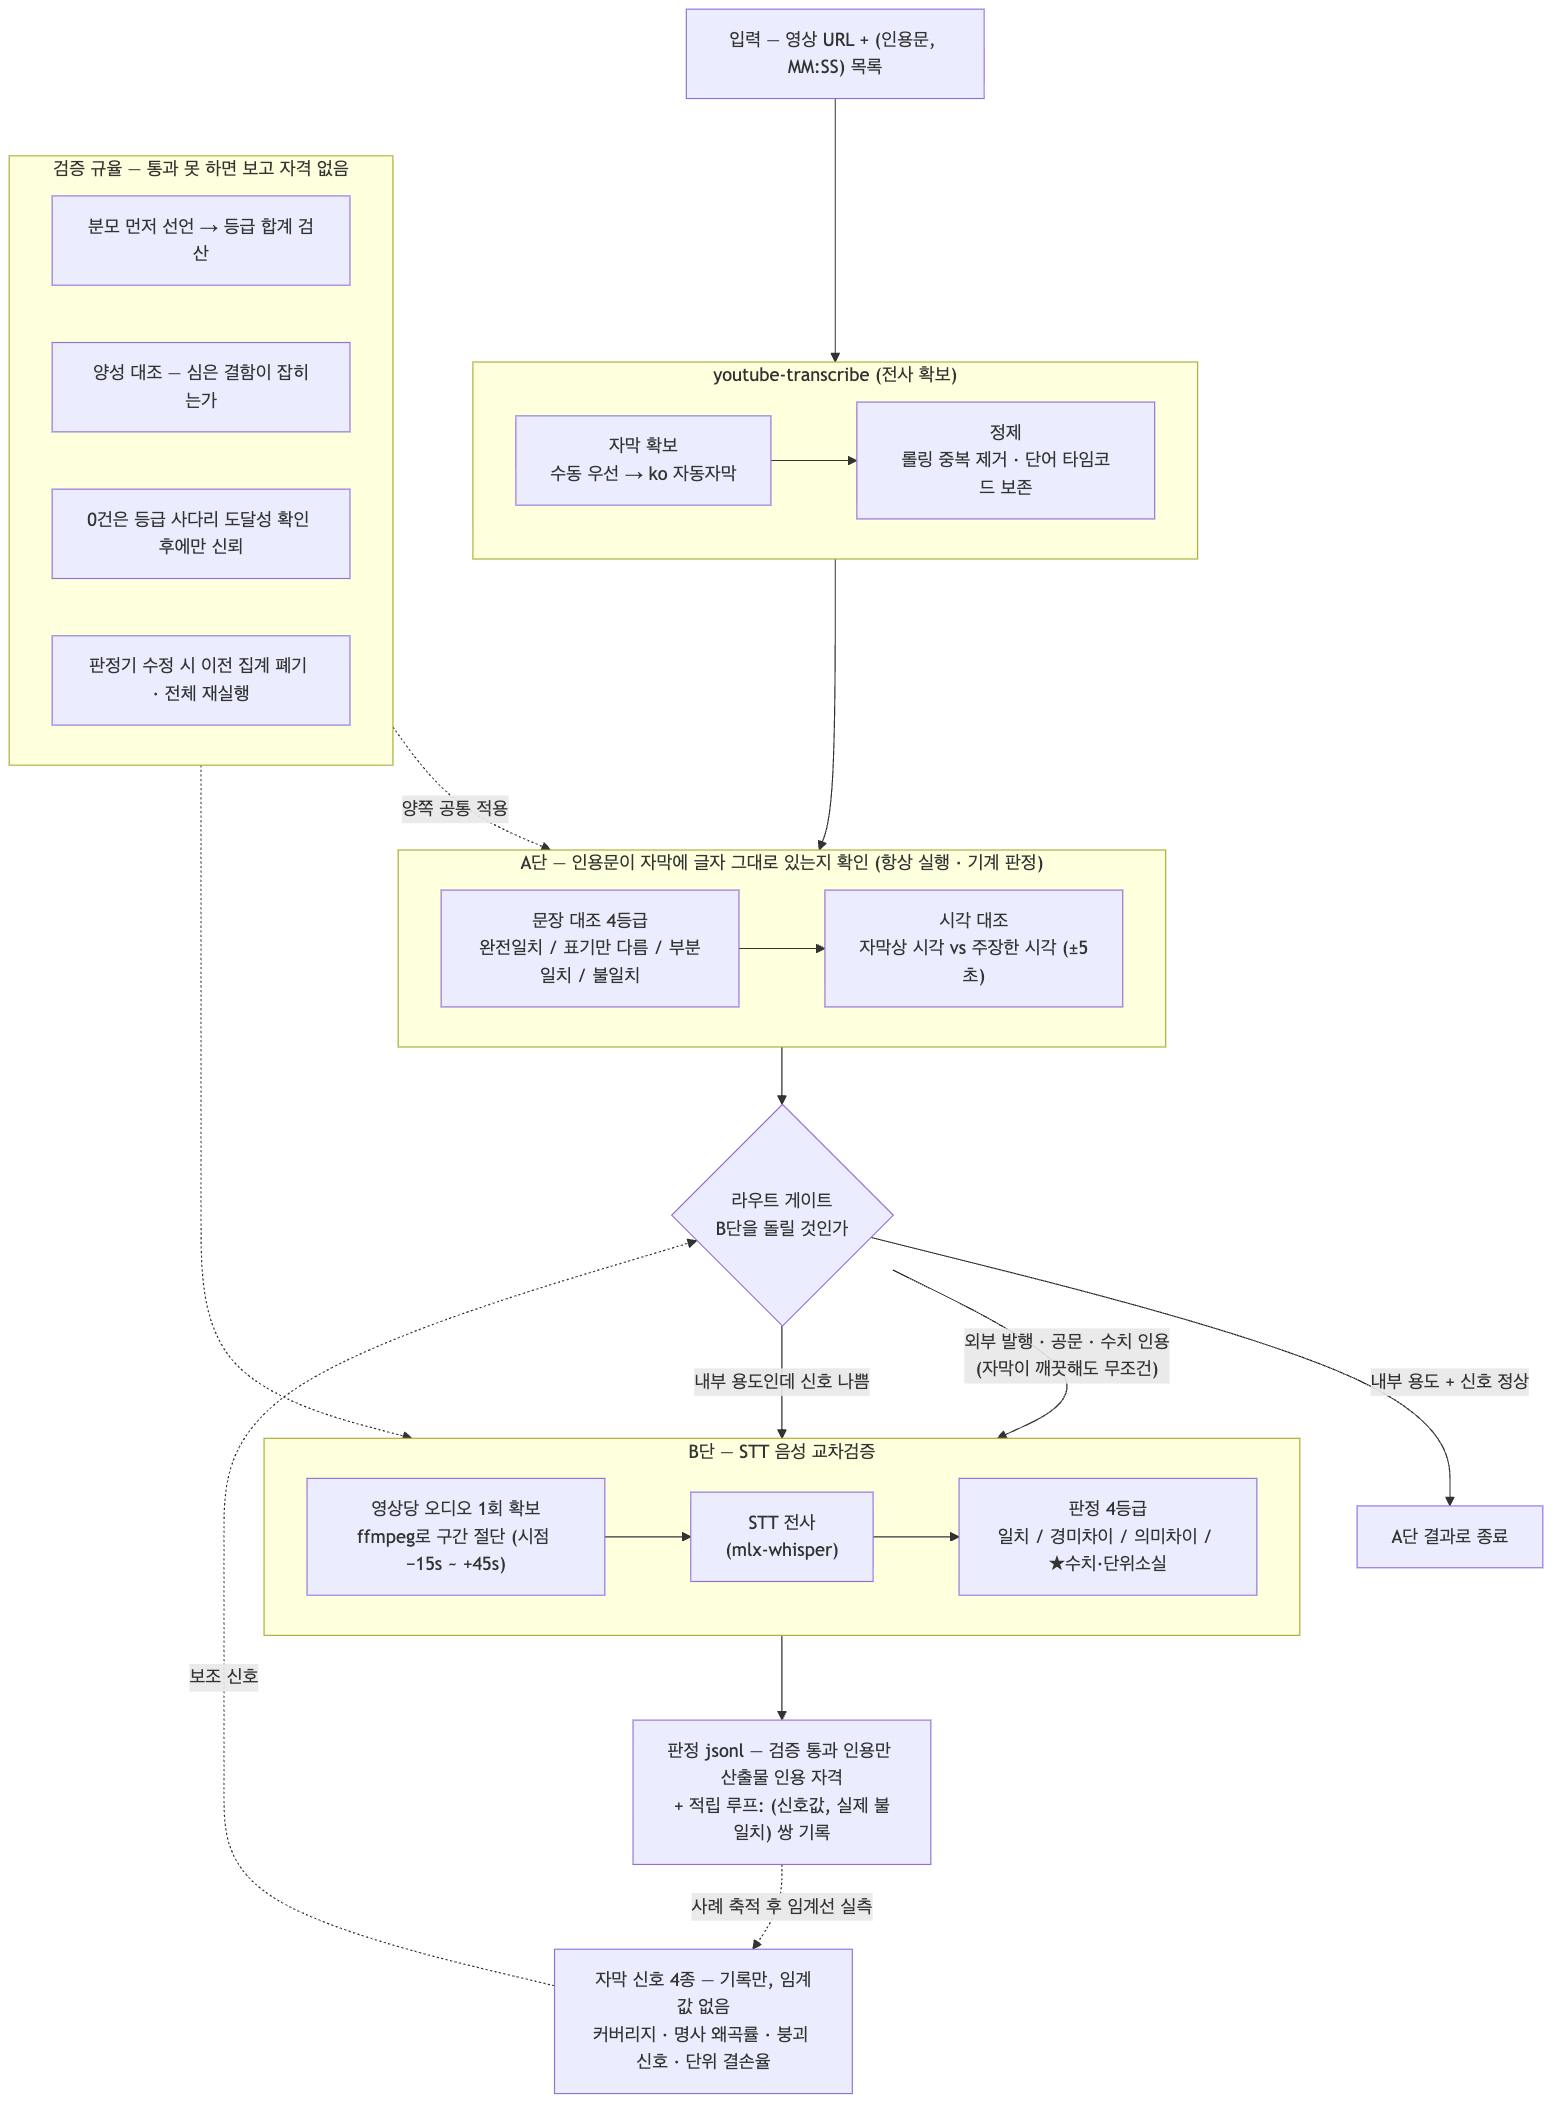
뒤에 나오는 티켓·노드·평가 기준이 어떻게 맞물리는지 먼저 그림으로 보면 이렇습니다. 실선은 파일의 흐름, 점선은 권한(개정·차단)입니다.
한 줄 요약 — AI(노드)는 사실과 판정만 내고, 점수는 코드가 내며, 사람은 규칙만 고칩니다. 그리고 그 사이의 모든 전달은 파일로만 이루어집니다.
1) 좌석 구조 — 핵심은 "누가 무엇을 못 하는가"
역할(좌석)을 나눌 때 "할 수 있는 것"이 아니라 "할 수 없는 것"으로 정의했습니다.
좌석 | 실체 | 할 수 없는 것 |
|---|---|---|
producer | AI 세션 (worker/collector) | 점수를 산출하지 못한다 |
evaluator + gatekeeper | 파이썬 파일 (AI 아님!) | 사실을 판단하지 못한다 |
reviewer | AI 세션 (다른 모델) | 점수를 쓰지 못한다 |
judge | 사람 (저) | 규칙 개정 권한, 그러나 채점 불개입 |
핵심은 좌석의 절반이 AI가 아니라는 점입니다. 채점이 결정론적 함수가 되면 "유리한 해석"이 끼어들 자리 자체가 없습니다.
2) 파이프라인 — 넣는 것은 쉽게, 올리는 것은 어렵게
① 유입(요건 2개) → ② 수집(사실+증거) → ③ 계약 검사(위반=거부)
→ ④ 채점(코드) → ⑤ 적대적 검증(reviewer) → ⑥ 판정(master)
→ ⑦ 승격(린터 통과 시) → ⑧ 90일 주기 재검 (⑦로 되돌아감)
인박스 투입 요건은 source와 captured 딱 두 개입니다. 요건을 늘리면 안 넣게 되고, 안 넣으면 인박스가 죽으니까요. 대신 정본 승격에는 게이트 7개 + 계약 5개 + 독립 검증이 걸립니다.
실제 한 회차의 명령 흐름입니다:
# ② 빈 증거 골격 생성 — producer가 채울 자리
$ python3 20-system/eval/harness.py prepare deepen2
  정의: FACTS-deepen2.json
  기준 16건의 빈 골격을 만들었다

# ③ 계약 검사 — 위반이면 여기서 멈춘다
$ python3 20-system/eval/harness.py verify collection-report.json
  ✅ 계약 통과 — 기준 16건

# ④ 통과했을 때만 채점
$ python3 20-system/eval/harness.py run collection-report.json --log
  규칙 1.2.0 (hash 6c0daedbed29)
  61 / 64 = 95.31%  (M5)
  → score-log.jsonl 에 기록
계약 위반이 있으면 이렇게 됩니다. 점수 자체가 안 나옵니다:
$ python3 harness.py verify /tmp/evidence-forged.json
  계약 위반 2건 — 채점하지 않는다

  ❌ [email protected]_retrieved = true 인데 증거가 없다
  ❌ D1@claim-31: 정의에 없는 사실 이름 'body_retrieved'
     (허용: claim_has_prose_attribution, claim_lacks_citation)

  producer 가 고쳐서 다시 낸다. 위반을 안은 채로는 점수가 나오지 않는다.
$ echo $?
1
계약 5개는 이렇습니다:
level·score·grade필드 금지 — 채점은 evaluator 몫참인 사실에는 증거 필수 — 확인 못 했으면
false로 적어라deduction(이 검증의 상한) 필수 — 상한을 안 적으면 검증이 아니다정의에 없는 사실 이름 거부 — 이름을 지어내면 채점이 어긋난다
공용 증거 문자열 거부 — 증거 하나로 사실 여러 개를 덮으면 대조 불가
이 구조에서 AI가 점수를 올리려면 사실을 거짓으로 적는 수밖에 없는데, 참인 사실에는 파일:라인 또는 명령 출력이 필수라 전부 대조 가능합니다. "잘 되어 있다"를 입력할 자리가 없습니다.
3) 프롬프트 = 티켓
각 좌석에는 대화가 아니라 티켓(마크다운 파일)으로 일을 시켰습니다. 회신도 파일 + 완료 마커(*.done)로만 받습니다. 아래는 실제로 reviewer에게 보낸 티켓 전문입니다.
💡 이 티켓의 포인트: ① 첫 줄부터 "반박이 직무"라고 못박기 ② 확인할 쟁점을 A/B/C로 구조화 ③ 채점 규칙 파일을 열지 말라는 blind 목록 ④ 산출물 JSON 스키마 고정 ⑤ "통과(confirmed)에도 실제 돌린 명령과 출력 필수"
# [reviewer-codex] 본문 확인 회차 2 재검 — collector 와 **master 둘 다**

너는 **독립 리뷰어**다. 반박하는 것이 직무다. 추인은 기본값이 아니다.

**앞 회차(deepen)에서 너는 master 의 세 판단을 전부 뒤집었다** — 특히 gap-01 의
반증을 `refutation_invalid` 로 판정해 철회시켰다. 문서 수 계단은 인덱싱 단위일 뿐
결과 축은 토큰이라는 지적이었고, master 가 재확인해 수용했다.

**이번에도 같은 것을 기대한다.**

## 검증 대상 둘

| # | 대상 | 파일 |
|---|---|---|
| ① | collector 본문 확인 판정 **16건** | `deepen2_2026-08-11/src/collection-report.json` |
| ② | master 갱신 **2건** | `gap_collection/src/10-knowledge/ontology/gap-02…md` · `gap-04…md` |

## ★ 이번 회차의 구조 — 한쪽은 유지, 한쪽은 반증

| 갭 | collector 판정 | master 처리 |
|---|---|---|
| **gap-02** | 근거 3건 전부 "인접 축, 갭의 축 아님" | **유지** (`confirmed 0.9` 불변) |
| **gap-04** | 1건이 갭 선언에 직접 답함 | **반증 수용** (`0.75 → 0.7`, `narrowed` 유지) |

**두 방향을 모두 의심하라.** 유지가 안일했을 수도, 수용이 성급했을 수도 있다.

## 쟁점 A — gap-02 유지가 옳은가 (기각이 정당했나)
(…축 검증 지시 — 갭이 물은 축과 논문의 축이 같은지 본문에서 직접 확인…)

## 쟁점 B — gap-04 반증 수용이 옳은가 (수용이 성급했나)
**확인할 것 셋**:
1. **그 문장이 본문에 실제로 있는가.** 추출 텍스트는 2단 PDF 라 컬럼이 뒤섞인다 —
   master 는 공백 정규화 후에야 찾았다. **네가 직접 확인하라.**
2. **stitched/non-stitched 가 "주제 다양성" 축이 맞는가.** Appendix C 의 정의를 확인하라
3. **갭이 물은 축과 같은가.** gap-01 처럼 어긋나는가

## 쟁점 C — gap-04 하향 폭(0.75 → 0.7)이 적절한가
**앞 회차에서 너는 gap-03 의 0.05 상향을 `unjustified` 로 판정했다.**
네가 든 근거를 그대로 옮기면: *"schema.yaml:136-147 은 confidence 를
**노트 출처 근거의 직접성**(직접인용 1.0 / 요약추출 0.7)으로 정의한다"*
— **같은 기준을 이번 하향에도 적용하라.**

## 산출물

`/private/tmp/harness/deepen2_2026-08-11/src/review-deepen2.json`

```json
{
  "issue_A_gap02_dismissal": {"verdict": "correct|too_strict|insufficient_basis",
                              "reasoning": "...", "evidence": "명령 출력 또는 §·행"},
  "issue_B_gap04_refutation": {"verdict": "refutation_holds|refutation_invalid", ...},
  "issue_C_gap04_downgrade":  {"verdict": "correct|too_small|too_large|wrong_grade", ...},
  "disputed":     [{"item": "...", "said": "...", "should_be": "...", "evidence": "..."}],
  "confirmed":    [{"item": "...", "evidence": "실제로 돌린 명령과 그 출력"}],
  "unverifiable": [{"item": "...", "reason": "..."}]
}
```

## 절대 규칙

1. **점수·레벨·등급을 쓰지 마라.**
2. **`confirmed` 에도 근거 필수** — 실제로 돌린 명령과 출력.
3. **대조 불가는 `unverifiable`.**
4. **원자료·정본을 수정하지 마라.**
5. 열지 마라: `20-system/eval/rubric_rules.py` · `score_engine.py` · `score-log.jsonl`
   ← 세 쟁점 다 본문 PDF·갭 노트·`schema.yaml` 만으로 답할 수 있다.

## 완료

touch /private/tmp/harness/deepen2_2026-08-11/src/review-deepen2.json.done

**회신 메시지를 보내지 마라.** 파일과 마커가 유일한 전달 경로다.
절대 규칙 5번의 blind가 특히 중요합니다. 레벨 유도표를 보면 점수를 겨냥하게 되고, 남의 답안을 보면 판정이 복창이 되기 때문입니다. producer용 티켓에는 한 줄이 더 있습니다: "collection-report.json 을 열지 마라 — 수집자의 자기신고를 보면 네 판정이 복창이 된다."
▎ 이 파이프라인의 끝은 점수가 아니라 승격입니다. 계약 검사와 reviewer 감사를 통과한 주장만 옵시디언 볼트의 10-knowledge(정본) 폴더로 올라가고, 여기 있는 것만 "아는 것"으로 칩니다 — 검증을 통과하지 못한 자료는 인박스에 머물다 폐기됩니다. 그렇게 온톨로지 카테고리에는 아래와 같은 노트들이 쌓였습니다. 점 하나가 노트 하나이고, 선은 "왜 연결되었는가"를 한 줄씩 달아야만 생기는 링크입니다.
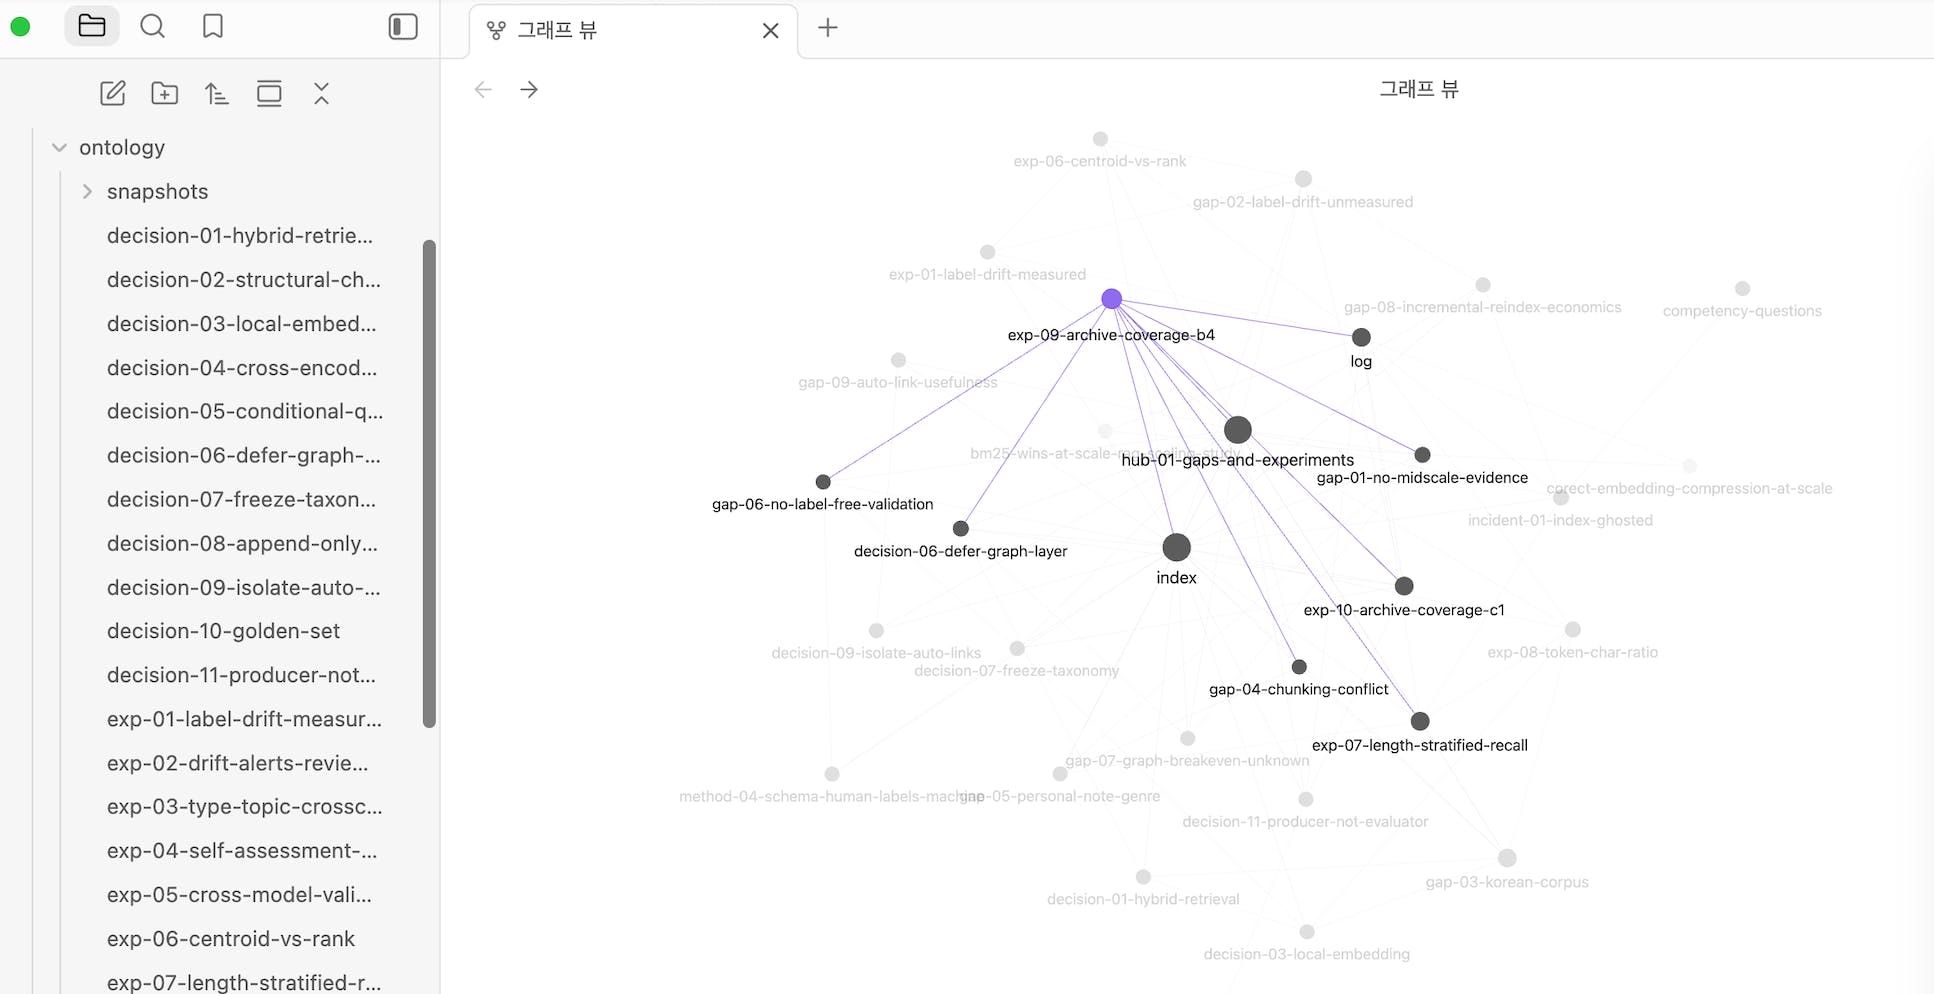
▎ 그래프의 점들이 아무 노트가 아닙니다. 파일명 앞 구분자가 노트의 역할을 정합니다 — gap(아직 모르는 것·미해결 질문), exp(그걸 검증하려고 직접 돌린 실측 실험), decision(실측을 근거로 내린 설계 결정), incident(운영하다 터진 사고 기록), method(사고에서 일반화한 원칙), hub(이 연결망 전체의 관계 지도). 그리고 이 여섯 유형은 일렬로 쌓이는 게 아니라 순환합니다. 결정은 실측을 근거로 삼지만, 재검에서 근거가 흔들리면 라벨이 내려간 채(narrowed·partially-refuted) 다시 질문으로 돌아옵니다 — 앞에서 말한 "반증에도 만점"이 실제로 흐르는 경로가 이것입니다.
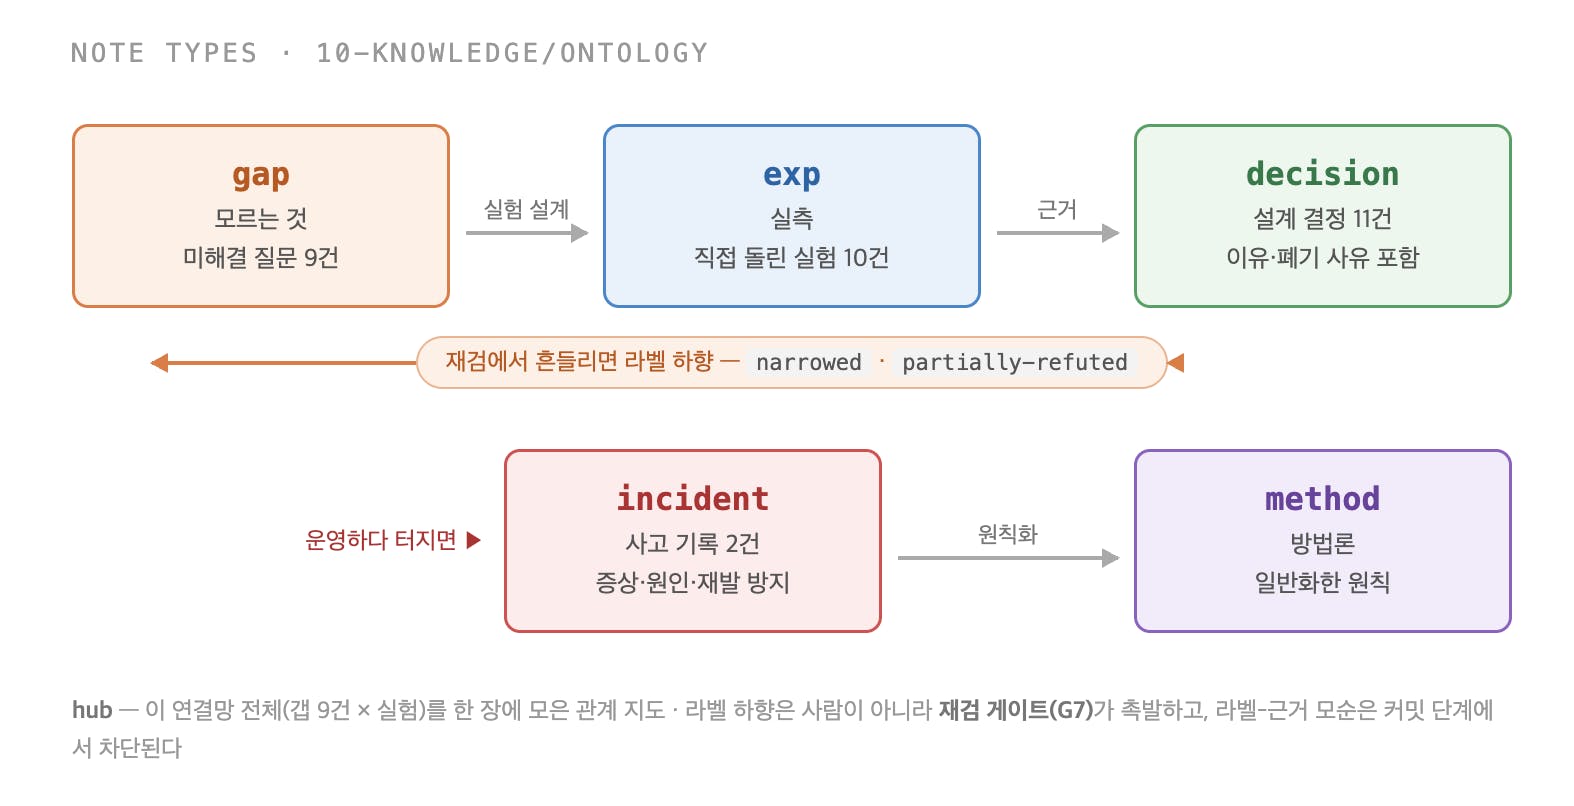
▎ 승격은 끝이 아니라 이 순환의 한 정거장입니다 — confirmed로 올라간 노트도 90일마다 "아직 참인가"를 다시 심문받습니다.
4) 감사 추적 — 규칙을 고치면 해시가 남는다
채점 규칙을 느슨하게 고치면 점수는 오릅니다. 그건 못 막습니다. 대신 드러나게 만들었습니다. 채점마다 규칙 파일의 해시가 로그에 남습니다:
2026-08-10T23:23   54.05% M2   c646bf42c335   ← 첫 채점
2026-08-10T23:39   72.14% M3   0d3556f55ad3   ← ★규칙 개정 (해시 변경)
2026-08-10T23:57   84.52% M4   0d3556f55ad3   ← 재판정 (규칙 불변)
2026-08-11T00:25   89.29% M4   0d3556f55ad3   ← 재판정 (규칙 불변)
18%p 점프에 해시 변경이 동반돼 있죠. 로그만 봐도 "규칙을 고쳐서 올랐다"가 드러납니다. 그리고 그 개정은 정당했습니다 — 개정한 기준(G2)만 변했고 나머지 분포는 그대로였거든요.
결과와 배운 점
배운 점과 나만의 꿀팁을 알려주세요.
결과 요약:
아카이브 746편 → 정본 노트 50건 (검색 recall@50 0.983, recall@5 0.917)
검증 회차 6개 완주, 최종 89.29
96.25% (M4M5)reviewer(다른 모델)가 채점 규칙 자체의 버그를 포함해 master 판단을 여러 번 뒤집음
배운 점 1 — 검증자는 반드시 "다른 모델 + 다른 프로세스"로
같은 모델로 서브에이전트를 띄워 검증시켜 봤는데, 같은 모델은 같은 맹점을 공유합니다. 다른 모델(Codex)을 reviewer로 두자 실제로 잡히기 시작했습니다:
master의 판단 3건을 한 회차에서 전부 전복 (반증이라 믿었던 것이 축 오류였음)
채점 규칙 자체의 버그 적발 — 논문에 웹 자료의 요건(로컬 스냅샷)을 잘못 적용해 19편이 눌려 있었는데, reviewer는 규칙 파일이 blind라 규칙을 보지도 못한 채 문서만으로 짚어냈습니다
나중에 아카이브에서 이를 이론으로 정식화한 논문(arXiv:2606.00007)도 찾았습니다 — "모델 동질성이 집단지성의 독립성 가정을 위반한다." 같은 논문의 제거 실험에서 투표 은닉(commit-reveal)이 단일 요소로 가장 효과가 컸다는데, 이게 정확히 blind 설계와 같은 원리였습니다.
배운 점 2 — "확인 못 했으면 false" + "반증에도 만점"
루브릭에서 제일 효과가 컸던 두 가지 장치:
참인 사실에는 증거 필수, 확인 못 했으면 false. "잘 되어 있다"를 쓸 자리가 없어집니다.
본문이 노트를 반박해도 만점(L4). 일치에만 점수를 주면 AI가 확인 자체를 회피합니다. 재는 것은 "맞았는가"가 아니라 "대조했는가"여야 합니다.
배운 점 3 — 전칭 주장은 반드시 깨진다
승격된 갭 노트 9건을 재검하니 5건이 흔들렸는데, 깨진 것들의 공통점이 주장 형태였습니다:
깨진 형태 | 살아남은 형태 |
|---|---|
"한 편도 없다" → 반증됨 | "X 조건을 만족하는 것은 없다" |
"하나뿐이다" → 반증됨 | "내가 확인한 범위에서 하나" |
살아남은 노트의 공통점은 인용하면서 "이 경고가 여기에도 적용되는지는 확인 안 됨"이라고 스스로 한계를 적어둔 것이었습니다. 그래서 지금은 승격 전에 전칭·수량 주장을 기계로 탐지하는 게이트(G6)를 돌립니다.
과정 중에 어떤 시행착오를 겪었나요?
시행착오는 7번의 사고로 정리됩니다. 설계 원칙이 먼저 있었던 게 아니라, 사고가 먼저 있었고 원칙은 그 대가였습니다.
자기 채점 표류 — 위에서 설명한 출발점
verified 라벨 인플레이션 — 정본 40건 중 39건이 "confirmed"였는데 표본 검증하니 64%가 과장. 본문엔 "미검증"이라 쓰고 메타데이터엔 "confirmed"라 쓴 노트도 있었습니다. 사람 눈으론 안 보여서(두 곳을 동시에 봐야 함) 린터를 만들었습니다.
없는 파일을 근거로 "확인됨" — 어떤 노트가 인용한 디렉토리가 통째로 없었습니다. 자기모순 검사는 본문이 자백할 때만 걸리는데, 없는 것을 인용하는 편이 자백보다 흔합니다. 경로 실재 검사를 차단으로 올렸습니다. 가장 뼈아픈 건 — 이 사고를 기록한 노트 자체가 근거 파일 부재로 수치 재현이 안 됐다는 것.
reward hack — 증거를 문자열 하나로 두고 사실을 전부 true로 뒤집으니 75%→90%로 계약을 통과했습니다. 막되, 지시서의 예시를 먼저 고치고 그 다음에 거부로 올렸습니다 (지시서를 안 고치면 AI가 따를 형식이 없으니까요). 닫기 전 실측: 정직한 산출물 293건 중 289건은 이미 올바른 형식이라 아무것도 막히지 않고 조작 경로만 닫혔습니다.
채점 규칙 자체의 버그 — reviewer가 적발 (위 참조)
규칙이 사본에서만 자라남 — 회차 작업 디렉토리에서 규칙을 고쳤더니 정본으로 안 돌아와서, 나중에 정본으로 그 점수를 재현할 수 없게 됐습니다. 지금은 회차 종결 때 해시 대조를 합니다.
검사가 조용히 꺼짐 — "✅ 계약 통과"가 떴는데 사실은 정의 파일을 못 찾아 검사를 건너뛴 것이었습니다. 침묵하는 실패가 제일 무섭습니다. 못 찾으면 경고를 뱉게 고쳤습니다.
꿀팁 하나로 압축하면: 검증 산출물에 deduction(이번 검증의 상한 — 무엇을 못 봤는지)을 필수 입력으로 강제하세요. 감사 작업에서 어긋남을 7곳 팠는데, 그중 3곳이 이전 작업자가 "이건 검증 안 했다"고 적어둔 바로 그 자리에서 나왔습니다. 상한 기록이 다음 사람의 출발점이 됩니다.
도움이 필요한 부분이 있나요?
검색 지표의 타당성 — recall/MRR을 재고 있지만, 최근 논문들이 "LLM은 검색 결과를 한꺼번에 소비하므로 순차 열람을 가정한 지표(nDCG·MRR)가 부적합하다"(UDCG), "LLM은 불완전한 검색에도 정답을 내므로 recall이 리트리버 성능을 반영 못 한다"(LLM-retEval)고 지적합니다. recall 0.917이 실제 답변 품질과 정렬되는지 검증해보신 분 계시면 경험을 듣고 싶습니다.
라벨 드리프트 자동 계측 — 어휘 지표도, 임베딩 centroid도 실패했습니다(진짜 표류와 안정 라벨의 차이가 0.0091뿐). 지금은 자동 판정을 포기하고 "검토 큐 생성기"로만 씁니다. 더 나은 접근을 아시면 부탁드립니다.
앞으로의 계획이 있다면 들려주세요.
글쓰기 절차에 상향식 규칙 반영 — 이번에 초안을 하향식(줄기 먼저, 근거 나중)으로 썼다가 근거 0건이 나와 통째로 다시 썼는데, 알고 보니 아카이브 안의 논문(ConvergeWriter)이 정확히 이 실패를 예측하고 있었습니다. "개요 전에 근거 전수 검색"을 티켓 규칙으로 넣을 예정입니다.
UDCG·LLM-retEval 본문 확인 회차 — 지표 타당성 검증
사람 라벨 100건으로 자동 분류(F1 0.662)의 정답지 만들기
도움 받은 글 (옵션)
지피터스 글 중에는 특정해서 참고한 글이 없어 외부 자료만 적습니다. (관련 글 아시면 댓글로 알려주세요!)
Ragas / ARES — 정답 라벨 없이 RAG를 평가하는 프레임워크. 다만 검색·생성 전용이라 "분류 품질"은 다루지 않습니다 (그게 제 미해결 갭 중 하나입니다)
STORM / AutoSurvey / ConvergeWriter — 위키·서베이 자동 생성 계열. 특히 ConvergeWriter의 "상향식(지식 경계 먼저)" 제안은 제가 겪은 실패를 그대로 진단합니다
Deliberative Curation (arXiv:2606.00007) — 다중 에이전트 지식 큐레이션 거버넌스. 모델 동질성·투표 은닉 등 이 글의 좌석 설계를 이론으로 뒷받침합니다
Anthropic — Building Effective Agents — "복잡도는 개선이 입증될 때만 올린다"는 원칙을 하네스 설계 전반에 적용했습니다
로그인하고 댓글을 남겨 주세요
좌석을 '할 수 있는 것'이 아니라 '할 수 없는 것'으로 정의하신 대목에서 이 구조가 왜 버티는지가 보였습니다. producer가 점수를 못 내고 evaluator가 사실을 못 판단하게 갈라두셨으니, 같은 맥락을 공유한 AI에게 이제 검증자 역할을 하라고 지시하는 방식이 왜 실패하는지도 같은 이유로 설명이 되네요.
라벨 드리프트 자동 계측을 포기하고 검토 큐 생성기로만 쓰신 판단도 저는 잘하신 쪽이라고 봅니다. 저도 검증 없이 만든 탐지기가 오탐 폭탄을 낸 적이 있어서, 그때도 자동 판정으로 올리지 않는 게 결국 이득이었습니다.
혹시 드리프트를 라벨이 아니라 증거 쪽에서 대리 측정해보시면 어떨까 싶습니다. 예를 들어, 증거로 적힌 파일과 라인이 아직 실재하는지, 그 대역의 내용이 그대로인지를 90일 재검 전에 훑으면 흔들릴 노트부터 큐 앞으로 당길 수 있고, 경로 실재 검사를 이미 차단으로 올려두셨으니 재료는 있는 셈이구요.
사례 공유 감사드립니다:)

공유해 주셔서 감사합니다~
9/28 발표 잘 들었어요. AI가 만든 결과를 같은 AI에게 다시 확인시키는 것보다, 만드는 역할과 검수하는 역할을 분리해야 한다는 점이 인상적이었어요.
검수는 주장을 없애는 일이 아니라 근거에 맞게 더 정확하고 오래 쓸 수 있는 지식으로 다듬는 과정이라는 인사이트를 얻었습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


채점 권한을 AI에게서 빼앗아 코드로 옮기고 좌석을 할 수 있는 것이 아니라 할 수 없는 것으로 정의한 설계가 인상적입니다. 특히 반증에도 만점 부분은 저도 당해보고 배운 지점입니다. 일치에만 점수를 주면 AI가 확인 자체를 회피하더라구요.
저는 훨씬 작은 규모로 비슷한 걸 하고 있는데요. 주문 메시지 읽기 시험 29문제에 다른 모델을 채점관으로 붙여 같은 답안을 이중 채점시켰더니 판정이 갈린 2건이 둘 다 제 코드 채점기의 버그였습니다. 모델이 잡아서 확인을 요청한 건을 누락으로 보고 벌점을 주고 있었거든요. reviewer가 규칙 파일을 못 보는 blind 상태로 규칙 버그를 짚어냈다는 대목에서 무릎을 쳤습니다. 저도 결론이 같았습니다. 재는 것은 맞았는가가 아니라 대조했는가였습니다.
관련 글 찾으신다고 하셔서 말씀드리면 같은 게시판에 제가 올린 AI한테 채점을 맡기기 전에 채점 AI부터 시험을 보게 했습니다 가 결이 닿아 있습니다. 전칭 주장 게이트와 비슷한 용도로 저는 문항마다 자료만으로 판정이 서는가를 표시해두고 정답지와 모델이 다투는 때 심판으로 씁니다.
하나 궁금한 것이 있는데 90일 재검 주기는 어떻게 정하셨나요. 저도 한번 통과한 것을 언제 다시 심문하느냐가 미해결이라서요.