


소개
1주차엔 "AI 요약을 검수하는 도구"를 만든다고 생각했습니다. 2~4주차에 실제로 한 일은 그 도구를 검수하는 일이었습니다.
먼저 지도를 펴겠습니다. 위쪽 수집 → 선별 → 생성 → 검수가 1주차까지 있던 것이고, ★ 세 구간이 2~4주차에 얹은 것입니다.
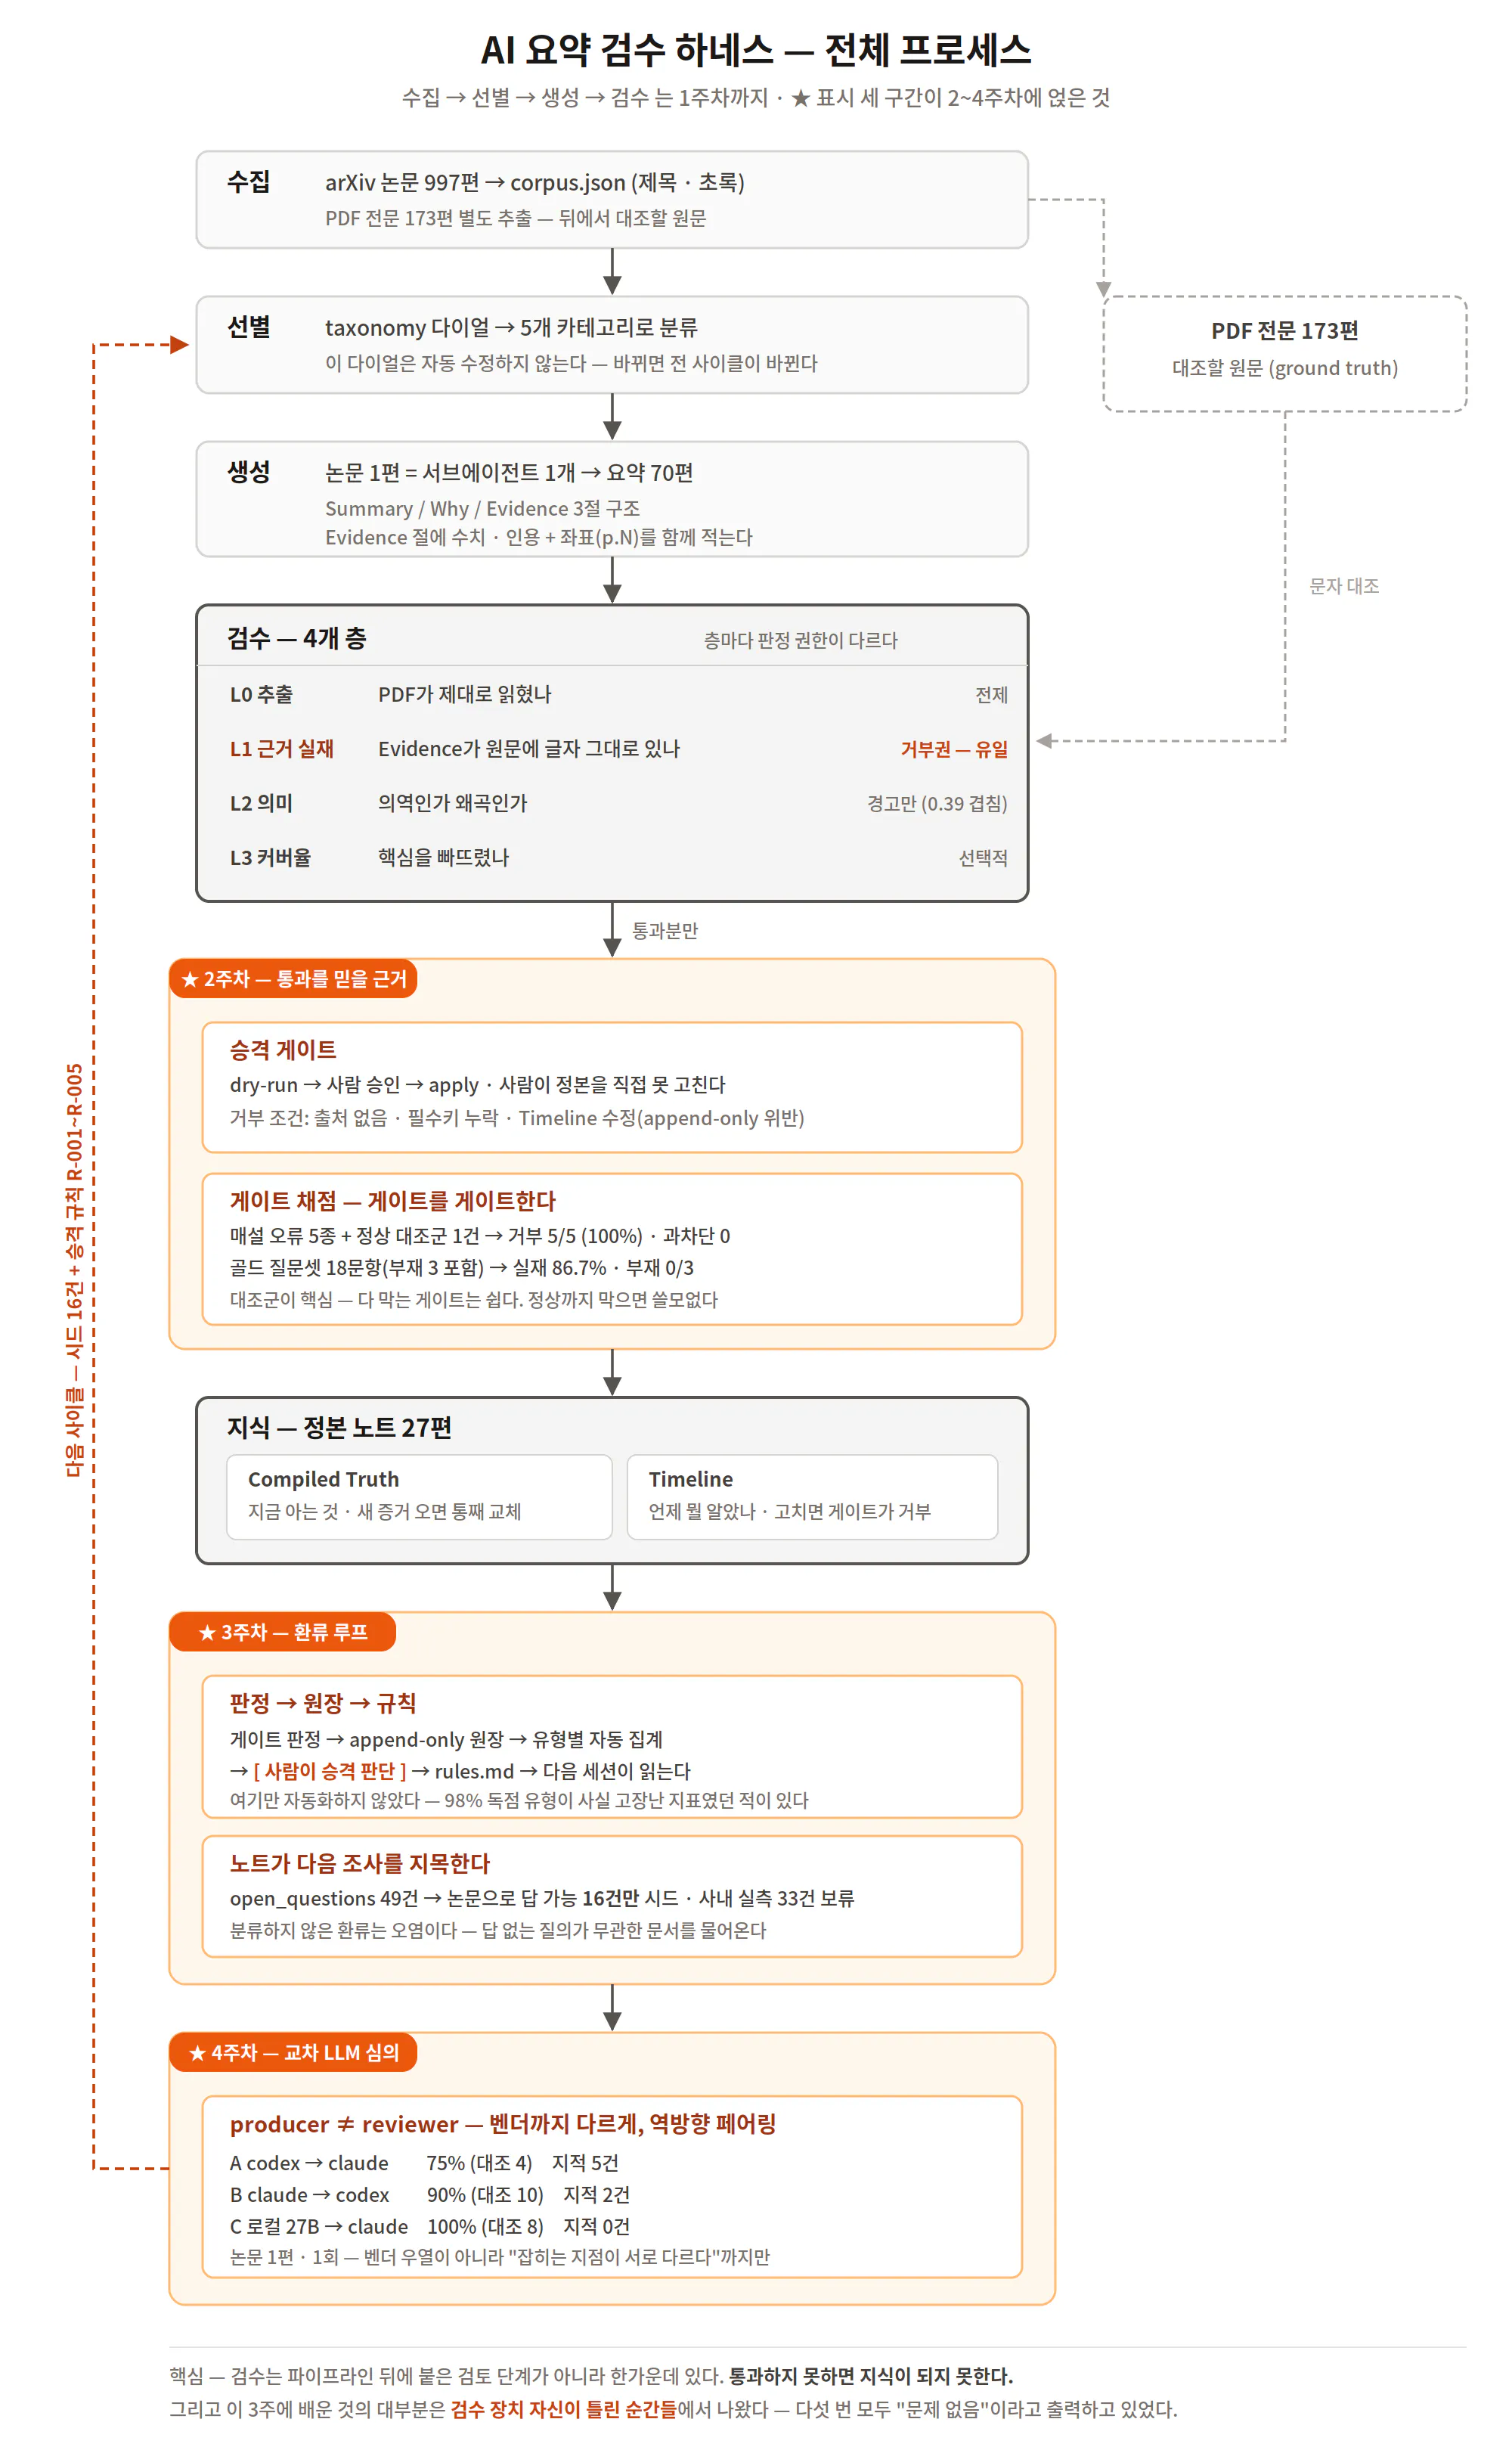
한국에서 구직하는 과정을 보여주는 다이어그램
1주차까지는 요약이 나오고 통과·실패가 찍히는 데까지였습니다. 문제는 그 다음이었습니다. 통과한 요약이 자동으로 지식이 되지는 않습니다. 세 칸이 비어 있었습니다.
구멍
메운 것
2주차
통과를 믿을 근거가 없다
승격 게이트 + 게이트 자체 채점
3주차
쌓이기만 하고 순환이 없다
원장 → 규칙 → 환류 루프
4주차
판정자가 한 종류다
교차 LLM 심의
그리고 이 3주에 배운 것의 대부분은 그 검수 장치 자신이 틀린 순간들에서 나왔습니다.
진행 방법
2주차 — "통과"를 믿을 근거를 만든다
① 지식이 되려면 별도 관문을 통과해야 한다. 사람이 정본을 직접 못 고칩니다. dry-run → 사람 승인 → apply만 경로입니다.
승격 거부 조건
  · 출처(source) 없음         → 거부
  · 필수 키 누락              → 거부
  · 과거 이력(Timeline) 수정   → 거부 (append-only)
정본 노트는 두 칸으로 쪼갰습니다. Compiled Truth는 지금 아는 것이라 새 증거가 오면 통째로 교체하고, Timeline은 언제 뭘 알았나라서 고치면 게이트가 거부합니다. 지식은 바뀌어도 이력은 바뀌면 안 됩니다. 나중에 "왜 이렇게 판단했지?"를 되짚을 수 있는 건 Timeline이 불변이기 때문입니다.
② 게이트를 만들었으면 게이트를 채점해야 한다. 여기가 2주차의 핵심이자 이 프로젝트 전체의 방법론입니다. "잘 돌겠지" 하면 안 되니, 일부러 틀린 노트를 만들어 집어넣습니다(매설).
매설 5종:  발명 수치 · 문구 오인용 · 출처 없음 · 이력 변조 · 필수키 누락
정상 대조군 1건
──────────────────────────────────────────
결과:  거부 5/5 (100%) · 대조군 통과 1/1 · 과차단 0
대조군이 핵심입니다. 다 막는 게이트를 만드는 건 쉽습니다 — 정상 노트까지 막으면 쓸모가 없습니다. 거부율과 과차단율을 같이 봐야 게이트가 평가됩니다.
첫 번째 반전. 처음 재봤을 때 거부율이 60% 였습니다. 게이트가 약한 줄 알고 로직을 파고들었는데, 원인은 검사 플래그를 안 넘겨서 검사가 아예 안 돌고 있었다는 것이었습니다. 도구는 조용히 통과시켰습니다. 그래서 "입력이 없으면 경고하고 멈춘다" 를 규칙 R-005로 박았습니다. 검수 도구가 배선 누락을 조용히 통과시키면, 그 도구의 출력은 전부 무의미합니다.
③ 검색도 같은 방식으로 잰다 — "모른다"를 물어보기. 지식이 쌓여도 꺼내 쓰지 못하면 소용없습니다. 골드 질문셋 18문항을 층화 표본으로 만들면서 한 층을 더 넣었습니다 — 답이 없는 질문 3개.
실재 15문항  →  86.7% 적중
부재  3문항  →  0/3 전건 실패     ← 없는 걸 없다고 못 한다
있는 것만 물었으면 "86.7% 적중"으로 기분 좋게 끝났을 일입니다. 원인은 구조적입니다. 랭킹 점수를 질의 내부 최대값으로 정규화하니 1등은 언제나 1.0이고, 점수 안에 "답이 있는가"라는 정보가 애초에 없습니다. RAG를 쓰는 분에겐 이게 할루시네이션의 입구입니다 — 관련 없는 문서를 만점으로 물어와서 근거랍시고 LLM에 먹입니다.
3주차 — 잡은 것을 다음 작업에 싣는다
검수해서 결함을 잡아도 다음 세션이 그걸 안 읽으면 무의미합니다. 매번 같은 실수를 새로 발견하게 되죠.
게이트 판정
    ↓ (기록: append-only 원장)
유형별 자동 집계
    ↓
[ 사람이 승격 판단 ]        ← 여기만 자동화하지 않았다
    ↓
rules.md 에 규칙으로 주입 → 다음 세션이 읽는다
현재 R-001~R-005 다섯 개가 이 경로로 승격됐습니다.
왜 승격만 사람이 하나 — 두 번째 반전. 원장을 열었더니 한 유형이 50건, 전체의 98% 를 독점하고 있었습니다. 자동 승격이었다면 압도적 1순위로 규칙이 됐을 겁니다. 그런데 파보니 그 지표 자체가 고장나 있었습니다 — 영어 원문 ↔ 한국어 요약이라 단어가 원리적으로 안 겹치는데 커버율을 재고 있었습니다. 지표를 폐기하고 언어 중립 지표(STR)로 갈아끼웠습니다(R-001). 가장 빈발하는 패턴이 가장 중요한 문제라는 보장은 없습니다. 측정기가 고장나면 빈도는 고장의 크기를 잽니다.
한 번 더 있었습니다. 원장에 승격 후보 5건이 심각한 반복 결함으로 떠올랐는데, 열어보니 매설 노트가 거부된 기록이었습니다. 게이트가 정상 동작한 사건이 원장의 60%를 차지하며 결함처럼 집계되고 있었습니다. 매설 기록을 집계에서 분리하니 후보 5건 → 0건.
노트가 스스로 다음 조사를 지목하게 했습니다. 정본 frontmatter의 open_questions를 감사가 모아 다음 사이클 검색 시드로 돌립니다.
미해소 질문 49건
    ↓ 분류
논문으로 답 가능  16건  → 다음 사이클 검색 질의로
사내 실측 필요    33건  → 보류 (예: "사내 SME 오류율은?")
33건을 그냥 안 던집니다. 논문에 답이 없는 질문을 검색에 넣으면 무관한 문서가 올라오고, 그게 다음 요약의 근거로 들어갑니다. 분류하지 않은 환류는 오염입니다.
같이 손본 것 — 긴 사이클이 끊겨도 처음부터 안 돌게 단계 상태를 기록하고(상태 파일이 변조·누락되면 fail-closed), FAIL 한 등급을 넷으로 쪼갰습니다.
판정
뜻
해야 할 일
CONTRADICTED
원문에 값이 있는데 형태가 다르다
내용 수정
INSUFFICIENT
근거 자체가 없다
주장을 낮춘다
STRUCTURAL
형식 미비
산출물 완성
UNVERIFIABLE
원문을 못 구했다
산출물 결함이 아니다
마지막이 특히 중요합니다. "검증 못 함"과 "검증해서 틀림"을 한 칸에 넣으면 멀쩡한 요약이 불량으로 기록되고, 그 기록이 원장에 쌓이고, 그게 규칙 후보가 됩니다.
4주차 — 판정자를 여러 종류로
여기까지의 검수는 전부 제가 만든 스크립트, 혹은 저와 같은 벤더의 모델이 했습니다. 같은 계통은 같은 지점에서 같이 눈이 멉니다.
그래서 만드는 AI와 검수하는 AI를 다른 벤더로 짝짓고, 역방향 페어링까지 넣어 같은 논문을 세 팀에 돌렸습니다.
팀
만든 쪽 → 검수한 쪽
근거 실재율
리뷰어 지적
A
codex → claude
75% (대조 4개)
5건
B
claude → codex
90% (대조 10개)
2건
C
로컬 27B → claude
100% (대조 8개)
0건
서로 다른 벤더가 같은 자리에서 같이 틀렸습니다.
원문:  "documents across the Data, Finance, and Logistics sectors"
       └ 나열만 할 뿐 개수를 말하지 않는다 — '3'도 'three'도 원문에 없다
A·B 요약:  둘 다 "3개 분야"라고 썼다   ← 세어서 만든 수치
사람이면 자연스럽다고 넘길 것을, "원문에 그 문자열이 있는가"만 보는 층은 그냥 잡습니다. 교차검증이 만능이 아니라는 증거이면서, 동시에 결정론 층이 왜 따로 필요한지의 증거입니다.
이 표로 벤더 우열을 말하지 않습니다. 논문 1편·1회이고, C(로컬 모델)는 애초에 다른 질문("로컬 모델로 되는가")입니다. 근거 대조 개수도 4~10개로 제각각이라 퍼센트끼리 비교되지 않습니다. 말할 수 있는 건 "세 팀 모두 결함을 냈고, 잡히는 지점이 서로 달랐다" 까지입니다. 이 경계를 리포트 안에 못 박아 뒀습니다 — 나중에 이 표만 떼어 인용하는 사람이 있을 테니까요.
검수 요청서 — 스펙 전문
리뷰어에게 주는 검수 축입니다. ①~③이 원래 있던 것이고, ④⑤가 4주차에 추가한 두 줄입니다.
[검수 축 — 아래 유형에 해당하는 것만 flag 한다]

① 발명 수치      원문에 없는 수치를 제시했는가
② 오인용         따옴표 안 문구가 원문에 글자 그대로 존재하는가
③ 과장           주장 강도가 근거 강도를 넘는가
                 (원문 한정어 much of / tend to / may 를 임의로 제거했는가)
④ 관계·순서 왜곡  원문의 선후·인과·대비 관계를 뒤집거나 바꿨는가        ← 신설
                 예) "A before B" → "B하여 A를 형성"
⑤ 결정적 누락    성과와 대비되는 한계·조건이 통째로 빠졌는가            ← 신설
                 예) 수치만 제시하고 한계 서술 절을 누락
                 예) 수치가 특정 도메인 한정이라는 조건을 누락

[출력]
flagged: [{axis, 요약 구절, 대응 원문 구절, 확신도}]
해당 없으면 flagged: []
출력 스키마는 건드리지 않았습니다. 파서가 엄격해서 형식이 바뀌면 전건 unchecked로 떨어지는데, 그건 위장 무결과 구분이 안 되는 최악의 실패입니다.
📸 캡처 첨부 위치 — 게이트 채점 출력 / 원장 before-after / 골드셋 부재층 결과 / 3팀 비교표 / 검수 축 확장 대조 실험
결과와 배운 점
검수 장치가 틀린 다섯 번
이번 3주의 진짜 내용은 여기입니다. "통과"라는 출력이 통과를 뜻하지 않았던 사례들.
겉으로 보인 것
실제 원인
게이트가 약하다 (거부율 60%)
플래그를 안 줘서 검사가 아예 안 돌았다
심각한 반복 결함 (승격 후보 5건)
게이트의 정상 동작이 원장의 60%를 차지
승격 1순위 패턴 (98% 독점)
그 지표 자체가 고장나 있었다
A 벤더 요약이 부실하다 (78%)
채점기가 마침표 하나로 오판정
요약이 깨끗하다 (지적 0건)
스펙에 없는 오류 유형은 안 잡힌다
앞의 셋은 위에서 봤고, 나머지 둘이 4주차에서 나왔습니다.
넷째 — 마침표 하나가 벤더 비교를 뒤집을 뻔했습니다.
요약:  "achieving a fuzzy-match F1-score of 0.724 in the Data domain."
원문:  "… in the Data domain while revealing limitations …"
원문 문장은 이어지는데 요약이 인용을 문장으로 끊었습니다. 닫는 따옴표가 마침표 뒤에 왔을 뿐이고 내용은 완전히 정확합니다. 그런데 채점기는 "원문에 없음" = 발명으로 판정했습니다. 이걸 못 잡았으면 "A 벤더가 B 벤더보다 근거가 부실하다" 는 틀린 결론이 리포트에 남았을 겁니다. 벤더 차이가 아니라 채점기 결함이었고, 실재율 78% → 100%.
다섯째 — 100%가 "제대로 읽었다"를 뜻하지 않습니다.
결정론 채점 만점을 받은 요약이 있었습니다. 수치·인용 8개가 전부 원문에 실재하고 발명 0건. 그런데 다른 벤더 리뷰어가 원문과 대조해보니:
원문:  "구조화한 다음(before) 직렬화한다"
요약:  "직렬화하여 구조를 형성한다"          ← 인과가 반대

원문:  "limitations in scope definition …"    ← 한계 서술
요약:  (통째 누락) · 0.724 성능만 제시
둘 다 결정론 층이 원리적으로 못 잡습니다. 발명 수치도 아니고 오인용도 아니니까요.
100%는 "지어내지 않았다"이지 "제대로 읽었다"가 아닙니다.
더 흥미로운 건 리뷰어도 그 결함을 놓쳤다는 점입니다. 정확히는 — 알아보고도 "스펙 밖"이라 흘려보냈습니다. 당시 검수 요청서가 물은 건 발명 수치·오인용·과장 셋뿐이었고, 순서 왜곡과 결정적 누락은 어디에도 안 들어갔습니다.
검수 축 두 줄을 추가하고, 같은 요약·같은 리뷰어·같은 모델로 다시 돌렸습니다.
지적 0건 → 4건 (알던 2건 + 몰랐던 2건)모델을 안 바꿨습니다. 질문을 바꿨습니다.
검수기가 무엇을 잡느냐는, 모델 성능보다 무엇을 물었느냐에 먼저 달려 있습니다.
그리고 제가 만든 사고 한 건
유실 방지 장치(실행별 원본 보존)를 만들고 운영 워크스페이스 위에서 스텁으로 검증했습니다. 그 검증이 진짜 초안과 리포트를 덮어썼습니다. 리포트는 문서에 남은 값으로 복원했지만 초안 일부는 복구 못 했습니다 — 보존 장치가 붙기 전 시점이라서요.
유실 방지 장치를 운영 데이터 위에서 검증하면, 그 검증이 유실을 만듭니다.
아직 안 된 것 — 정직한 목록
구조적으로 못 잡는 것
검색기가 "모른다"고 답하지 못한다 (0/3) — 차단 임계를 걸어봤더니 부재 3건을 다 막으려면 실재 15문항 중 10개를 잃습니다. 측정만 하고 차단은 안 합니다. 지금 구조로는 원리적 해결이 불가능하고 임베딩 같은 별도 채널이 필요합니다.
질적 오류는 결정론 층 밖 — 순서 왜곡·누락은 문자 대조로 못 잡습니다. 다른 벤더 리뷰어가 보완하지만 판정 권한은 안 줬습니다. 문자 유사도로는 충실한 의역(0.39)과 왜곡(0.39)이 겹쳐서, 거부권을 주면 정상 요약을 대량으로 막습니다.
따옴표 검사에 269건 사각지대 — 현재
## Evidence절만 검사해서,## Summary에서 의역을 따옴표로 감싸면 통과합니다. 전수 조사하니 60편에 269건. 검사를 넓히면 269건이 한꺼번에 FAIL이라 분포부터 보고 임계·전환 기간을 정해야 합니다. 미착수.
설계상 일부러 안 한 것
규칙 자동 승격 — "98% 독점 유형이 사실 고장난 지표였던" 사례 때문에 사람 승인을 경유합니다.
시드 자동 투입 — 분류 다이얼은 추출과 지속 매칭을 동시에 지배해서, 조용히 바뀌면 전 사이클이 오염됩니다. 제안까지가 도구의 경계입니다.
표본이 부족한 것 — 교차 벤더 1회(논문 1편), 워크스페이스 1개(온톨로지 방법론 도메인). 어느 것도 일반화 불가입니다.
다음 우선순위
순위
항목
왜
높음
R-002 분포 조사 (269건 중 진짜 위반 몇 건)
임계를 정해야 게이트를 켠다
높음
교차 벤더 표본 확대 (논문 5~10편)
1회로는 아무것도 말 못 한다
중간
부재 판별 임베딩 채널
지금 구조로는 원리적 불가
중간
리뷰어 판정 권한 승급 검토
단 과차단 임계 실측이 선행
낮음
다른 도메인 워크스페이스 1개
일반화 검증
도움이 필요한 부분
RAG의 abstention — "답이 없다"를 어떻게 판정하시는지. 점수 정규화 구조 때문에 임계로는 못 막고 있습니다.
교차 벤더 비교의 최소 표본 — 몇 편·몇 회부터 말해도 되는지 근거 있는 기준을 못 세웠습니다.
"켜면 269건 일괄 FAIL"인 규칙의 전환 전략 — WARN 유예가 정석 같은데 실무 사례가 궁금합니다.
숫자 (전건 실측)
코퍼스
논문 997편 · 전문 173편 · 요약 70편 · 정본 27편
승격 게이트
매설 거부 5/5 (100%) · 대조군 통과 1/1 · 과차단 0
골드셋
18문항(층화 4종) · 실재 15문항 86.7% · 부재 0/3
게이트 임계
--min-top1 0.85 (0.85 통과 · 0.90 실패)
승격 규칙
R-001 ~ R-005 (전건 사람 승인 경유)
환류
미해소 질문 49건 → 논문 답변 가능 16건만 시드
요약 검수
56/56 PASS
교차 LLM
3팀(역방향 페어링 포함) · 논문 1편
검수 축 확장
지적 0건 → 4건 (같은 요약·같은 리뷰어)
채점기 결함 수정
실재율 78% → 100% (마침표 오판정)
원장 정화
승격 후보 5건 → 0건 (매설 기록 분리)
검수 시간
1편 손 ~1시간(추정·미완주) vs 하네스 0.05초
자체 검사
9종 PASS · CI 게이트 통과
추정과 실측을 구분합니다 — 손 검수 1시간만 추정이고, 나머지는 전부 스크립트 출력입니다.
마무리
이번에 고친 다섯 건 중 네 건이 검수 장치 자신의 결함입니다. 게이트가 안 돌고 있었고, 집계가 정상 동작으로 뒤덮였고, 채점기가 정상 인용을 발명으로 몰았고, 검수 요청서가 너무 좁았습니다. 다섯 번째는 유실 방지 장치가 유실을 낸 것이고요.
공통점이 하나 있습니다 — 전부 "문제 없음"이라고 출력하고 있었습니다.
"통과"라는 출력이 통과를 뜻하는지는, 따로 확인해야 알 수 있습니다.
그래서 발표를 이 질문으로 끝냈습니다 — "AI 검수 체계를 보실 때, 그 기준점은 누가 검수해야 하지?" 저는 이번에 "적어도 나 자신은 아니다" 까지만 확인했습니다.
도움 받은 글 (옵션)
지피터스 23기 AI 결과물 검수 스터디 커리큘럼 (1~4주차)
1주차 사례글 — 기준을 못 박고, 그 기준을 검수받다
산출물 워크스페이스:
ontology-methodology/ 검수 엔진:verifier-kit
