


한줄 요약 데이터 라벨링 태깅 가이드를 클로드에게 학습시켜 앉아있는 소 사진의 가려진 다리 키포인트를 해부학적으로 추론해보게 했고, 같은 요청을 챗지피티·제미니에도 그대로 던져서 결과를 비교한 다음, 클로드에게 그 결과물들의 다리뼈 구조가 실제로 맞는지 검증까지 시켜본 후기입니다.
누구에게 도움이 될까 데이터 라벨링 키포인트(관절점) 태깅 작업을 하는 사람, 여러 AI에게 같은 작업을 시켜 결과를 비교·검증해야 하는 사람.
문제 상황 키포인트(관절점) 태깅 가이드를 다루다 보면, 실제 현장 이미지에는 동물이 앉아있거나 몸을 웅크려서 다리 관절이 절반쯤, 혹은 완전히 가려진 경우가 흔합니다. 라벨러 입장에서는 "안 보이는 부위는 어떻게 찍어야 하나"가 늘 헷갈리는 지점이라, 이걸 AI가 얼마나 그럴듯하게 대신해줄 수 있는지 궁금해서 실험해봤습니다.
소(COW) 가공 가이드 PDF(키포인트 21개, 코·눈·귀·다리 관절·등뼈·꼬리 위치와 좌우 색상 규칙 정리된 자료)와 산에서 앉아 쉬고 있는 소 사진 한 장을 준비했습니다.
작업 과정
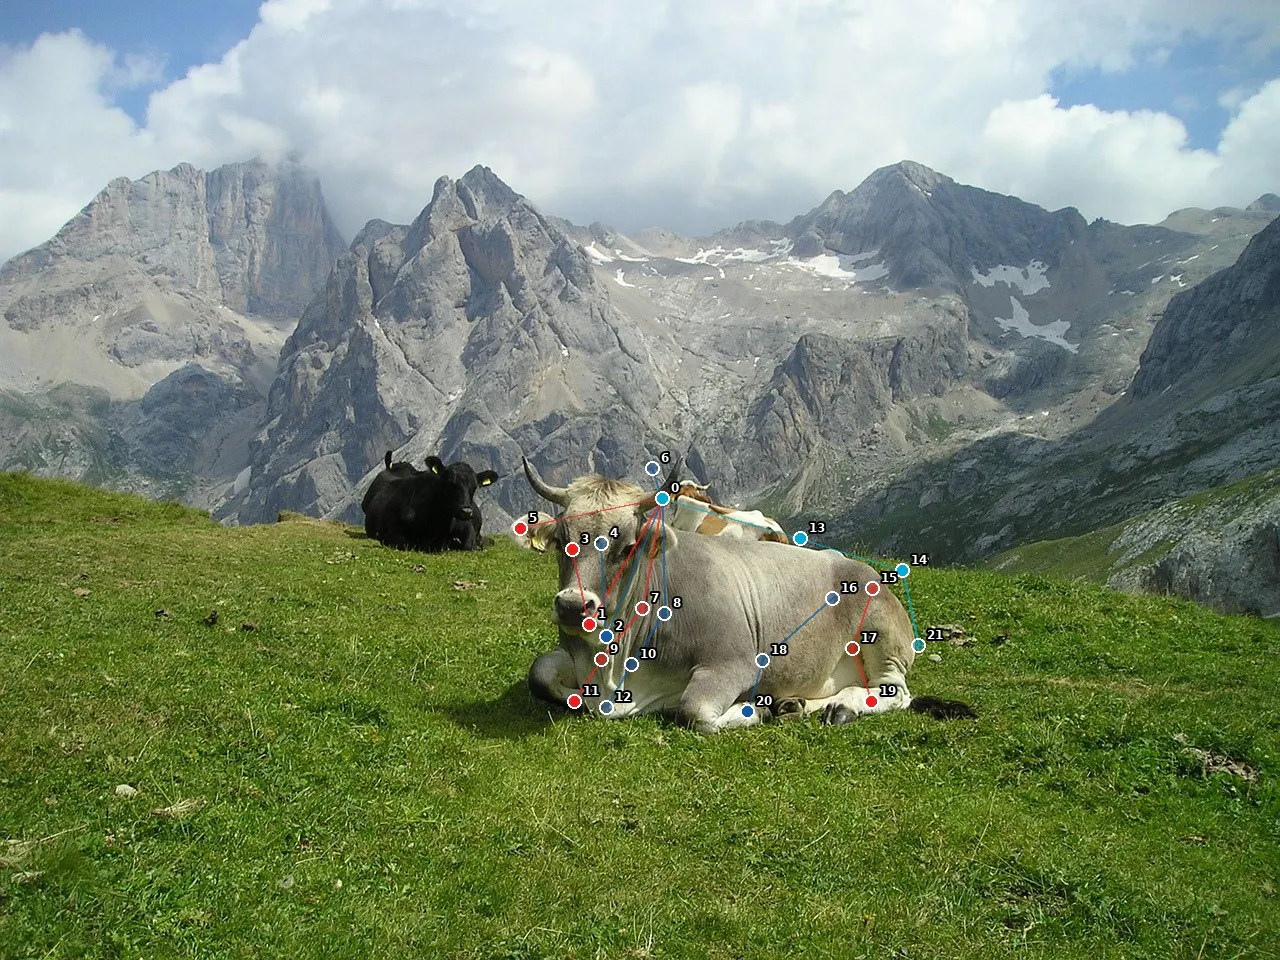
산을 배경으로 풀밭에 누워 있는 소
1단계 — 클로드에게 직접 점 찍히기
이 가이드대로 맨 앞 소한테 점을 찍어줘, 다리는 안 보이니까 해부학적으로 추론해봐
클로드는 가이드 PDF의 표(태깅 대상-번호-색상 매핑)를 읽고, 사진을 여러 구역으로 잘라 확대해가며 눈·코·귀처럼 실제로 보이는 부위 좌표를 먼저 잡았습니다. 보이는 점은 진한 원, 완전히 가려져서 추정한 점은 반투명한 원으로 구분해서 표시한 아이디어 자체는 괜찮았습니다.
그런데 완성된 첫 결과물을 자세히 보니 구조적인 오류가 있었습니다. 등뼈 라인 일부가 바로 뒤에 앉아있는 다른 소 위로 잘못 그어져 있었고, 앞다리/뒷다리, 왼쪽/오른쪽 관절 포인트들이 머리 근처에서 서로 뒤섞여 있었습니다. 좌표를 텍스트로 "추정"해서 코드로 그리는 방식이다 보니, 소 한 마리의 골격 구조를 하나의 일관된 틀로 유지하지 못하고 부분부분 어긋난 겁니다.
그럼 이번엔 점 대신 골격 구조 자체를 그려줘
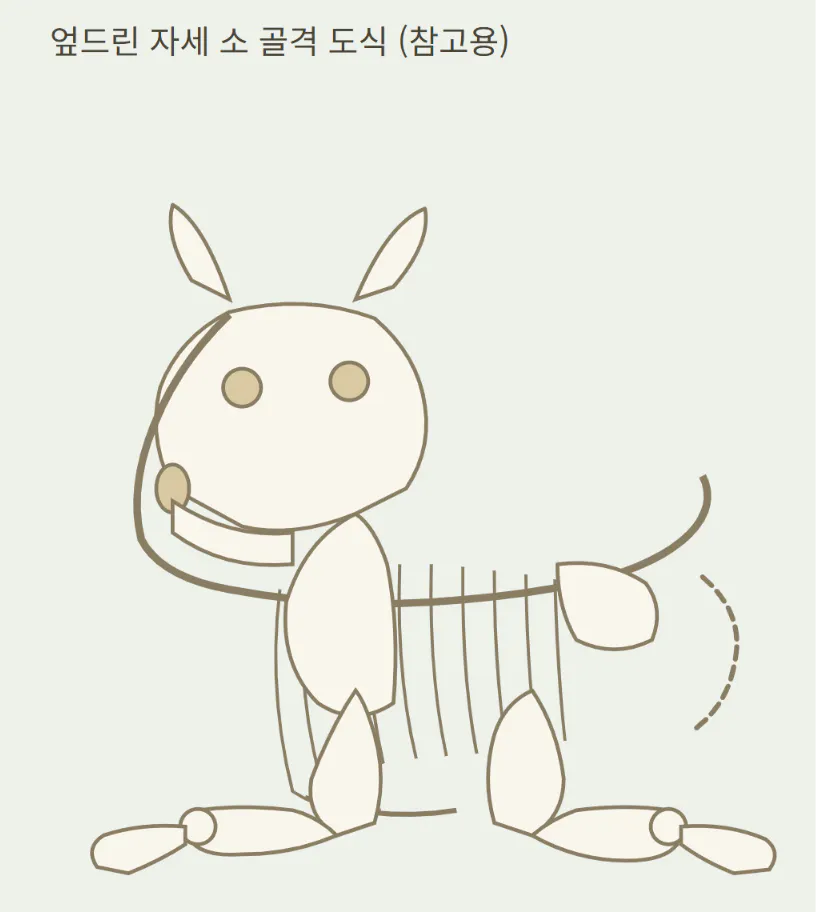
한국어로 개 그림
이번엔 실제 사진과 무관하게 뚝 떨어진 일반적인 참고용 도식 하나가 나왔습니다. 제가 준 사진의 자세·비율·구도에 맞춰 합성된 게 아니라, 그냥 "엎드린 소는 대략 이렇게 생겼다"는 정도의 별도 스케치였던 셈입니다. 음 적잖게 당황했습니다. ^^
2단계 — 챗지피티·제미니와 나란히 비교
같은 원본 사진과 같은 요청을 챗지피티, 제미니에도 그대로 던져봤습니다. 결과는 확실히 차이가 났습니다. 두 서비스 모두 소 사진 위에 골격을 실제로 겹쳐 그려서, 갈비뼈·다리뼈·두개골이 사진 속 자세·비율과 얼추 맞아떨어지는 이미지를 바로 내놓았습니다. 완벽한 해부학적 정확도까지는 아니어도, 최소한 "이 사진 속 이 자세의 소"라는 맥락 위에서 그럴듯하게 나온 겁니다.
상-챗지피티 / 하-제미나이
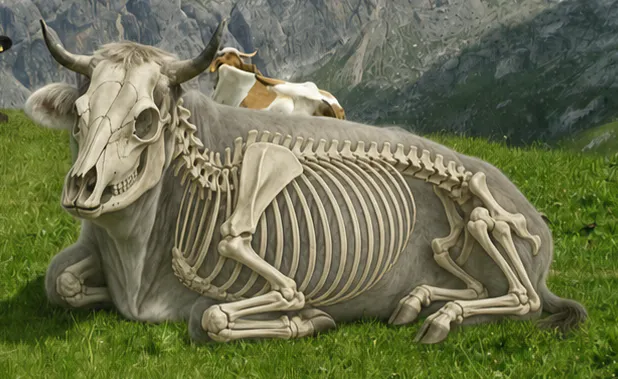
풀밭에 있는 소 뼈대
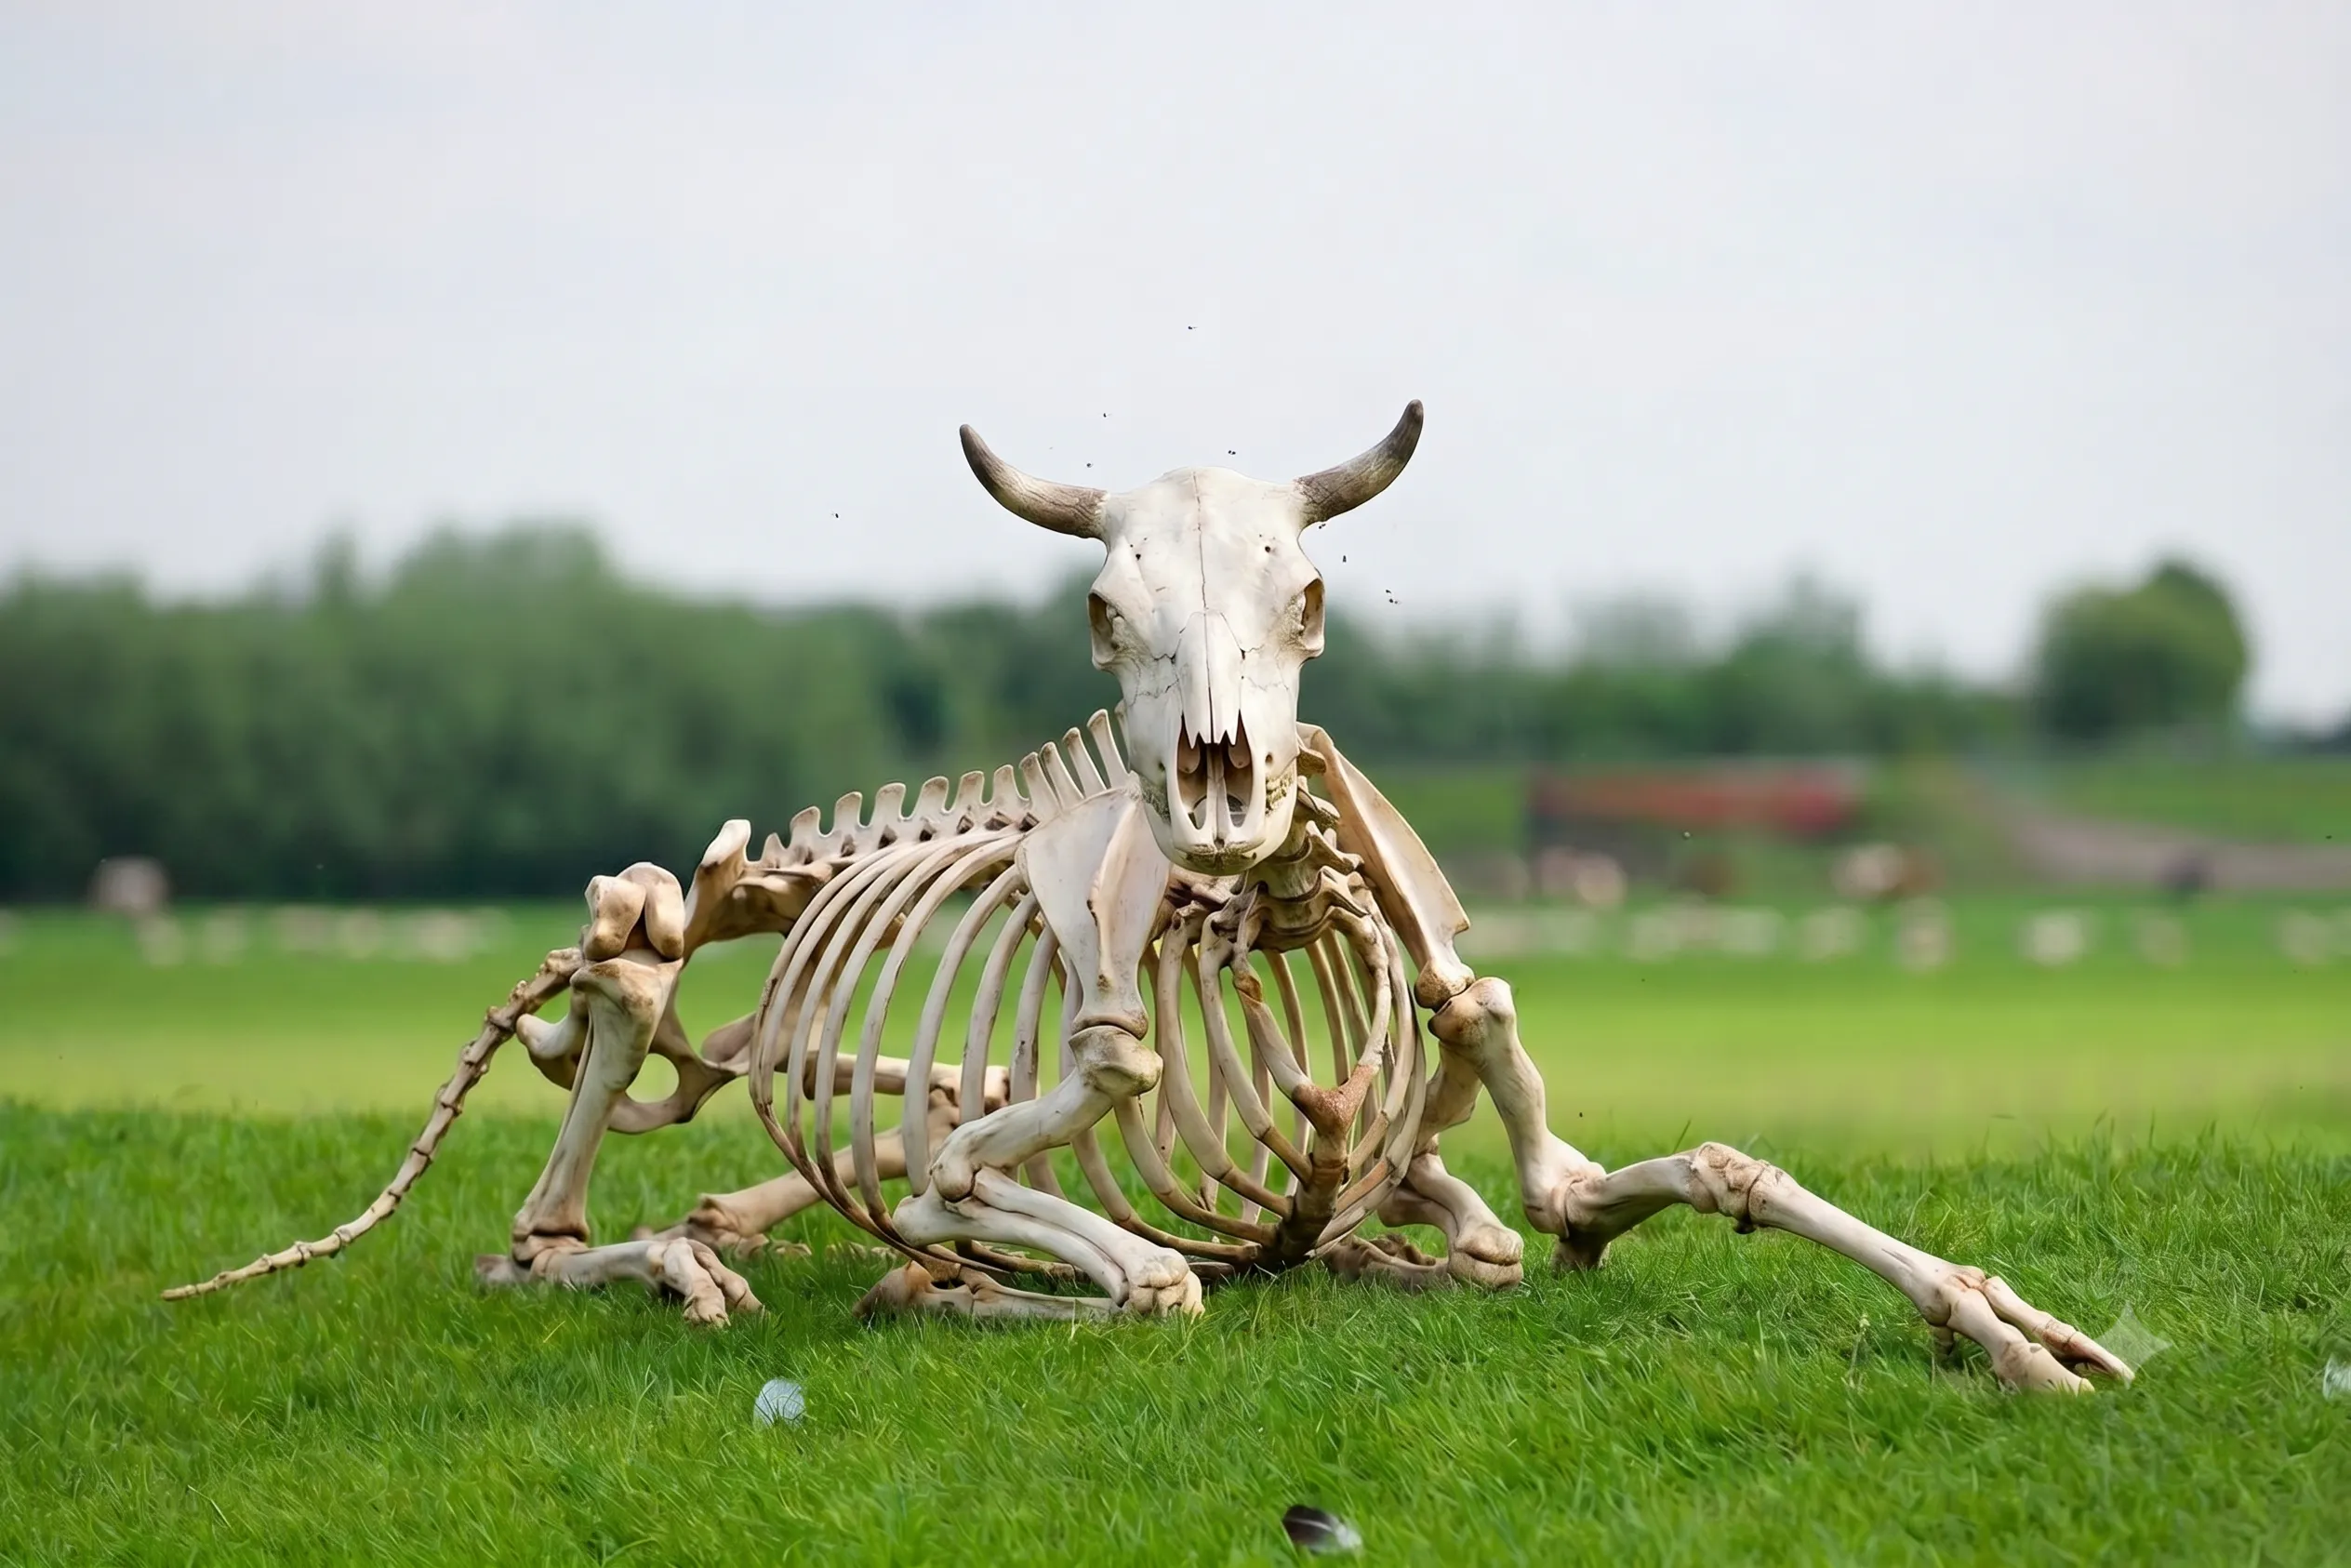
풀밭에 누워 있는 소의 뼈대
3단계 — 이번엔 클로드에게 "검증"을 시켜봄
여기서 끝내지 않고, 제미니·챗지피티가 만든 골격 이미지 두 장을 다시 클로드에게 주고 아래처럼 시켜봤습니다.
이거 실제 소 골격구조 맞는지 확인해봐
클로드는 이미지를 구역별로 잘라 확대하면서 갈비뼈 개수, 발굽 모양, 다리 관절 마디를 하나씩 짚어가며 비교했는데, 특히 제가 중요하게 보는 다리 관절 구조에서 둘의 차이가 뚜렷하게 갈렸습니다.
제미니: 앞다리는 견갑골-위팔뼈-요골/척골-완관절(손목)-중수골-발굽까지, 뒷다리는 대퇴골-슬관절-정강이뼈-비절(발목)-중족골-발굽까지 마디가 거의 다 구분되게 그려져 있었습니다. 앞다리는 앞으로, 뒷다리는 반대로 뒤로 꺾이는 방향성도 정확했습니다.
챗지피티: 앞다리·뒷다리 모두 방향성(앞다리는 앞으로, 뒷다리는 뒤로)은 맞게 잡았지만, 뼈 마디 하나하나가 뭉개져서 위쪽 뼈-굴곡점-아래쪽 캐논본 정도로 단순화돼 있었습니다. 실루엣은 그럴듯한데 중간 관절이 정확히 어디인지 짚기 애매한 수준이었습니다.
가이드가 다리 하나당 관절을 3개(상단/중간/하단)로 나눠 찍게 되어 있다 보니, 이 "관절 마디가 실제로 구분되는가"가 저한테는 제일 중요한 기준이었는데, 이 기준으로는 제미니 쪽이 훨씬 더 태깅 실습 자료에 가까웠습니다.
결과 같은 과제를 세 가지 AI로 비교해보니 접근 방식의 차이가 뚜렷하게 드러났습니다. 클로드는 좌표를 텍스트/코드로 추정해서 이미지 위에 점을 찍는 방식이라, 직접 그리는 결과물의 구조적 일관성은 챗지피티·제미니의 이미지 생성 방식을 못 따라갔습니다. 반대로 챗지피티·제미니는 사진에 자연스럽게 합성된 그럴듯한 골격 이미지를 만들어냈지만, 제미니가 챗지피티보다 다리 관절 마디를 훨씬 세밀하게 구분해서 그렸습니다.
흥미로웠던 건 마지막 단계였습니다. 클로드는 스스로 그림을 그리는 건 서툴렀지만, 이미 나온 결과물을 구역별로 뜯어보며 "이 관절이 실제로 있는 마디인지, 방향이 맞는지"를 짚어내는 검증 작업은 꽤 쓸모가 있었습니다. 생성과 검증이 서로 다른 역량이라는 걸 실감한 지점이었습니다.
핵심 팁
이미지 생성이 필요한 작업은 챗지피티·제미니류가, 생성된 결과물을 규칙(가이드)에 맞춰 검증·설명하는 작업은 클로드가 상대적으로 낫다는 인상을 받았습니다. 한 AI에 전 과정을 다 맡기기보다 단계별로 나눠 쓰는 게 효율적입니다.
여러 AI에게 같은 사진·같은 요청을 그대로 던져서 나란히 비교해보면, 어떤 AI가 어떤 유형의 실수를 하는지(구조 어긋남 vs 맥락 없는 참고 이미지 vs 관절 마디 뭉개짐) 훨씬 선명하게 보입니다.
가이드에서 요구하는 세부 기준(예: 관절 3분할)을 검증 기준으로 그대로 사용하면, "그럴듯해 보인다"는 인상이 아니라 실습 자료로 쓸 수 있는지 없는지를 구체적으로 판단할 수 있습니다.
재사용 프롬프트:
가려진 부위는 "추정"이라고 시각적으로 구분 표시해줘/[생성된 결과물]이 실제 [대상]의 구조상 맞는지 확인해줘. 구역별로 잘라서 하나씩 비교해줘
