


AI로 가상의 웰니스 전략가(Wellness Strategist) 캐릭터를 만들고,
이 인물이 스톡홀름 → 서울 → LA를 오가며 웰니스에 대해 이야기하는 영상을 만들어봤다.
영상은 6초씩 6개 장면으로 구성했고,
수면과 회복 → 움직임 → 뇌 건강 → 음식 → 근력 → 삶으로 이어지도록 했다.
단순히 한 사람이 카메라 앞에서 설명하는 영상보다는,
다양한 장소와 일상의 장면을 통해 웰니스에 대한 관점을 보여주고 싶었다.
진행 방법
먼저 ChatGPT와 함께 캐릭터의 프로필과 방향을 정하고 메인 이미지를 제작했다.
이 이미지를 Google Flow의 Character X-ray에 넣어 캐릭터를 좀 더 정교하게 만들어보려 했지만 원하는 결과가 나오지 않았다. 이후 Grid Architecture를 이용해 다양한 각도와 구도의 캐릭터 시트도 만들어봤다. 기능 자체는 흥미로웠지만, 이미지를 반복 수정하다 보니 어느 순간 얼굴이 달라지는 문제가 생겼다.
결국 처음 만든 메인 이미지 한 장을 Google Flow에 캐릭터로 저장하고, 6개 장면에서 동일하게 반복 사용했다. 오히려 이 방법이 캐릭터의 일관성을 유지하는 데 가장 안정적이었다.
영상은 Google Flow에서 6초짜리 장면 6개를 각각 제작했다. 각 장면마다 배경, 의상, 동작, 카메라 구도와 함께 한국어 대사와 음성까지 프롬프트에 포함했다
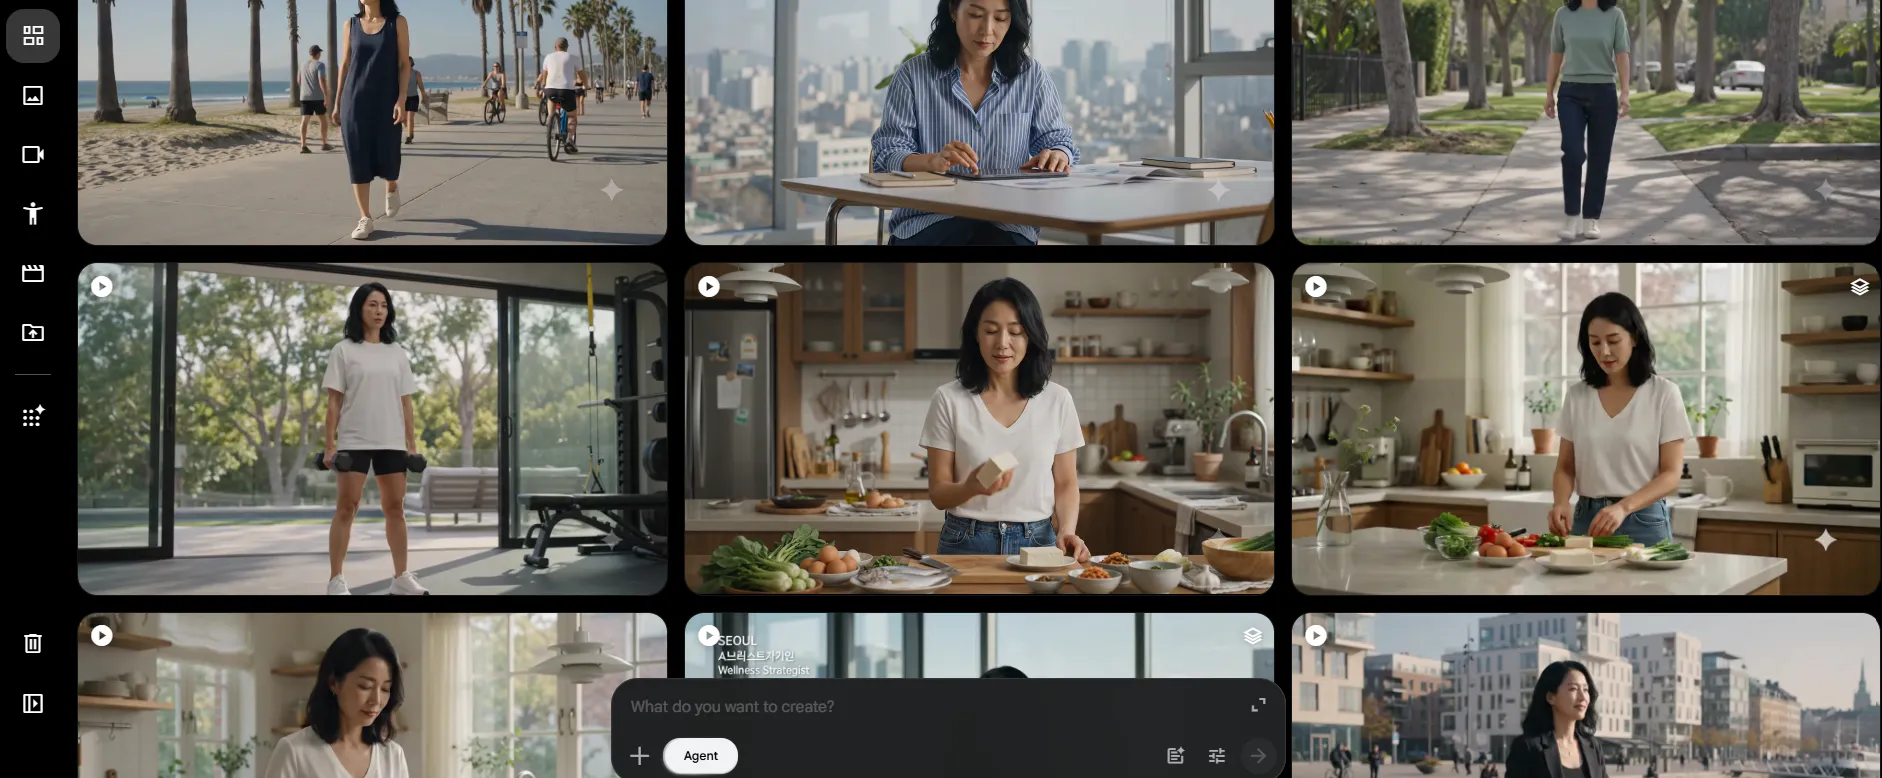
여러 장의 사진이 표시된 여성의 휴대전화 화면 스크린샷
수업에서는 Vrew에서 음성과 자막을 추가하는 방법을 배웠지만, 이번에는 Google Flow에서 음성까지 완성한 뒤 Vrew에서는 6개 영상을 순서대로 연결하는 최종 편집만 했다.
결과와 배운 점
가장 크게 배운 것은 AI 영상에서는 장면과 움직임을 단순하게 만드는 것이 중요하다는 점이었다.
예를 들어 식재료를 칼로 써는 장면은 손과 칼의 움직임이 어색하게 나왔다. 한 장면에 여러 행동을 넣었을 때도 결과가 불안정했다. 음성 역시 문장이 길거나 복잡하면 말을 버벅거리는 경우가 있어 몇몇 장면은 여러 번 다시 만들었다.
결국 가장 안정적이었던 방식은:
한 장면 = 한 장소 + 한 가지 주요 행동 + 짧은 대사 하나
캐릭터 역시 여러 이미지를 계속 만들어가는 것보다 잘 나온 기준 이미지 하나를 고정해서 반복 사용하는 방식이 효과적이었다.
또 의외로 어려웠던 것이 패션 스타일링이었다. ‘고급스러운 디자이너 스타일’처럼 여러 방식으로 프롬프트를 바꿔도 원하는 세련된 느낌을 정확하게 구현하기는 쉽지 않았다. 결국 프롬프트를 계속 수정하기보다 장면 자체를 바꾸기도 했다.
이번 실습에서 가장 크게 느낀 것은 AI에게 많은 것을 요구하는 것보다, AI가 잘할 수 있는 장면으로 설계하는 것이 더 중요하다는 것이었다.
제작 과정:
ChatGPT에서 캐릭터 기획·메인 이미지 제작 → Google Flow에서 캐릭터와 6개 영상·음성 제작 → Vrew에서 최종 연결 및 편집
