


회사에서 AI를 쓰는 사람이 늘면, 제일 먼저 떠오르는 걱정이 "이러다 비용 터지는 거 아냐?"예요. 그래서 대부분의 회사가 가장 먼저 손대는 게 1인당 사용량 상한(usage cap)입니다. 그런데 코인베이스(Coinbase)는 정반대로 갔어요. 사용을 막기는커녕 토큰은 더 쓰게 두면서, AI 지출을 거의 절반으로 줄였습니다.
브라이언 암스트롱(Brian Armstrong) 코인베이스 CEO가 그 방법을 직접 공개했습니다. 핵심 한 줄은 이거예요. "AI 지출을 그대로(flat) 유지하는 건 마찰과 경고 알림이 아니라, 더 나은 기본값·라우팅·캐싱으로 한다."
한줄 요약
코인베이스는 AI 사용을 "통제"하는 대신 "인프라"로 풀어서, 토큰 사용량은 계속 늘리면서도 AI 지출을 거의 절반으로 줄였습니다.
무슨 일이 있었나?
암스트롱이 공개한 접근법은 다섯 가지로 정리됩니다. 공통점은 전부 "사람을 제한하는 정책"이 아니라 "엔지니어링으로 해결한 인프라"라는 점입니다.
1. 더 나은 기본값 (사용량 상한이 아니라)
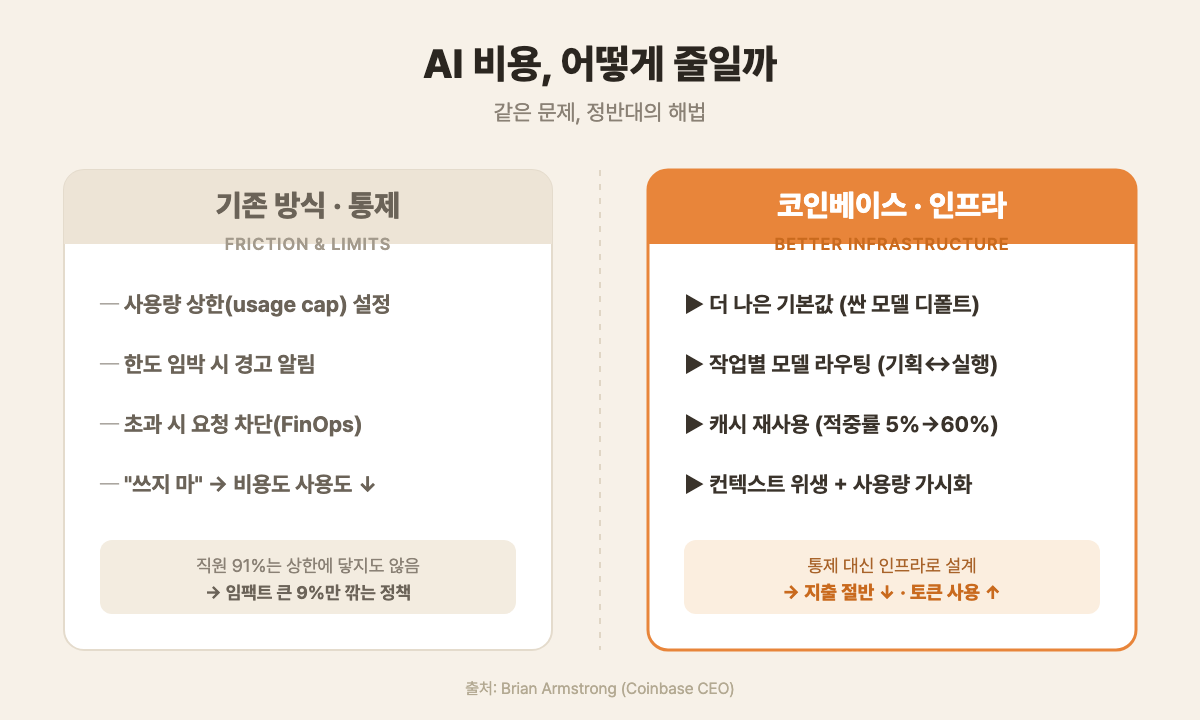
엔지니어는 원하는 모델을 자유롭게 고를 수 있지만, 기본값을 바꾸는 게 핵심입니다. 코인베이스는 LLM 게이트웨이를 통해 기본 모델을 GLM 5.2, Kimi 2.7 같은 오픈웨이트(저가) 모델로 두는 실험을 하고 있습니다. 근거가 인상적인데, 직원의 91%는 애초에 사용량 상한에 닿지도 않았다고 합니다. 그러니 상한을 낮춰서 알림만 늘릴 게 아니라, 기본값을 싼 모델로 바꾸는 게 낫다는 거죠. 참고로 코드 리뷰는 여러 모델을 섞어 서로의 작업을 교차 검증하게 했습니다.
2. 더 나은 라우팅
자체 하니스(harness)에서 프롬프트를 전처리한 뒤, 캐시 적중과 모델 가격을 고려해 작업에 가장 맞는 모델로 자동 분배합니다. 예를 들어 기획(planning)에는 프론티어 모델이 좋지만, 단순 실행(execution)에는 과합니다. 암스트롱의 결론은 명확합니다. "모델 선택은 사람이 할 일이 아니라 AI가 자동화할 작업이다."
3. 더 나은 캐싱
캐시 미스(cache miss)가 비용을 올리는 가장 쉬운 경로입니다. 코인베이스는 모든 요청을 캐시 인식(cache-aware)으로 만들어 따뜻한 캐시를 최대한 재사용합니다. 그 결과 LibreChat에서 캐시 적중률이 5%에서 60%로 뛰었습니다.
4. 컨텍스트를 가볍게 유지
토큰을 적게 쓰는 게 목표가 아니라, 낭비되는 토큰을 줄이는 게 목표입니다. 방법은 단순합니다. 작업을 바꾸면 새 세션으로 시작하고, 파일 컨텍스트는 좁게 잡고, 안 쓰는 도구는 연결을 끊습니다. "그냥 compact(압축)만 하지 마라"는 조언이 핵심이에요.
5. 더 나은 가시성 (제한이 아니라)
엔지니어는 원하는 만큼, 원하는 모델로 토큰을 쓸 수 있습니다. 대신 사용량을 투명하게 보이게 만들었습니다. 그리고 "AI를 많이 쓸수록 그만큼 임팩트를 기대한다"는 메시지를 분명히 합니다.
왜 중요한가?
비즈니스 관점에서 이 사례의 무게중심은 한 문장에 있습니다. "AI 지출은 거의 절반으로 줄었고, 토큰 사용량은 계속 늘고 있다."
보통 비용을 줄이면 사용량도 같이 줄어듭니다. 쓰는 걸 막으니까요. 그런데 코인베이스는 둘을 분리했습니다. 비용은 절반으로, 사용은 우상향으로. 이게 가능한 이유는 비용 문제를 "누가 얼마나 쓰느냐"가 아니라 "같은 결과를 얼마나 싸게 내느냐"로 재정의했기 때문입니다.
한국 기업들이 흔히 채택하는 방식과 비교하면 차이가 선명합니다. 국내 AI 비용 가이드 대부분은 사용자·팀·프로젝트별 예산 한도를 걸고, 한도에 가까워지면 알림을 보내거나 초과 시 요청을 차단하는 FinOps 통제를 핵심으로 봅니다. 암스트롱은 바로 그 통제를 "마찰과 경고 알림"이라며 가장 먼저 부정했습니다. 같은 문제를 두고 한쪽은 "사람을 막아서", 다른 한쪽은 "인프라를 깔아서" 풀고 있는 셈입니다.
실전에서 어떻게 쓸 수 있을까?
대기업이 아니어도, 심지어 1인이어도 바로 적용할 수 있는 게 많습니다.
작업별로 모델을 나눠 쓰기. 기획·설계처럼 어려운 판단은 비싼 프론티어 모델, 단순 실행·반복 작업은 저렴한 모델로 분리하세요. 실제로 단순 분류 작업에서 경량 모델이 80% 저렴하면서도 비슷한 정확도를 낸 사례가 보고됩니다.
세션 위생 챙기기. 작업이 바뀌면 새 대화를 시작하고, 지금 작업에 필요한 파일·도구만 컨텍스트에 남기세요. 안 쓰는 도구 연결을 끊는 것만으로도 매 요청의 토큰 낭비가 줄어듭니다.
캐시가 깨지지 않게 쓰기. 반복되는 시스템 프롬프트·문서는 앞쪽에 고정해 두고 뒤쪽만 바꾸는 식으로, 캐시를 최대한 재사용하세요. 캐시 적중률을 높이는 것만으로 같은 작업의 비용이 크게 떨어집니다.
인사이트
원문에서 가장 과소평가된 숫자는 "91%"입니다. 직원의 91%가 상한에 닿지 않는다는 건, 흔히 쓰는 사용량 상한이 사실상 상위 9%의 헤비유저만 잡는 정책이라는 뜻이에요. 그런데 그 9%가 회사에서 AI로 가장 큰 가치를 만드는 사람일 가능성이 높습니다. 비용을 아끼려고 건 상한이, 정작 임팩트가 큰 사용을 깎고 있던 거죠. "통제가 아니라 가시성"이라는 마지막 전략이 단순한 구호가 아니라 이 데이터에서 나온 결론입니다.
이걸 한국 조직에 그대로 옮길 때 주의할 점이 하나 있습니다. 코인베이스의 다섯 전략 중 라우팅·캐싱·하니스는 엔지니어링 리소스가 있어야 구현됩니다. 인프라 투자 여력이 없는 팀이라면, 우선순위는 "기본값"과 "세션 위생" 두 가지예요. 팀의 기본 모델을 한 단계 저렴한 것으로 내리고, "작업 바뀌면 새 세션" 같은 행동 규칙만 합의해도 체감 비용이 줄어듭니다. 인프라는 그다음에 붙이면 됩니다.
마지막으로, 이 글은 단순한 비용 절감 팁이 아니라 AX(AI Transformation) 운영 철학으로 읽는 게 맞습니다. "AI를 어떻게 못 쓰게 할까"가 아니라 "어떻게 마음껏 쓰게 하면서 지속 가능하게 만들까". 비용을 통제 대상이 아니라 설계 대상으로 보는 순간, 조직이 AI를 대하는 태도 자체가 달라집니다.