


새 모델이 나오면 표부터 보게 되죠. 우리 모델이 몇 퍼센트, 남의 모델이 몇 퍼센트. 숫자가 크면 좋아 보이고요.
그런데 그 표 아래 각주를 읽어보신 적 있으세요? 저는 이번에 처음 끝까지 읽어봤는데, 표만 봤을 때랑 인상이 꽤 달라지더라고요.
GPT-6 아스트라(Astra) 발표문에서 찾은 조건 네 개를 보여드릴게요. 아스트라 이야기지만 다음에 어떤 모델이 나와도 똑같이 쓰실 수 있는 안목이에요!
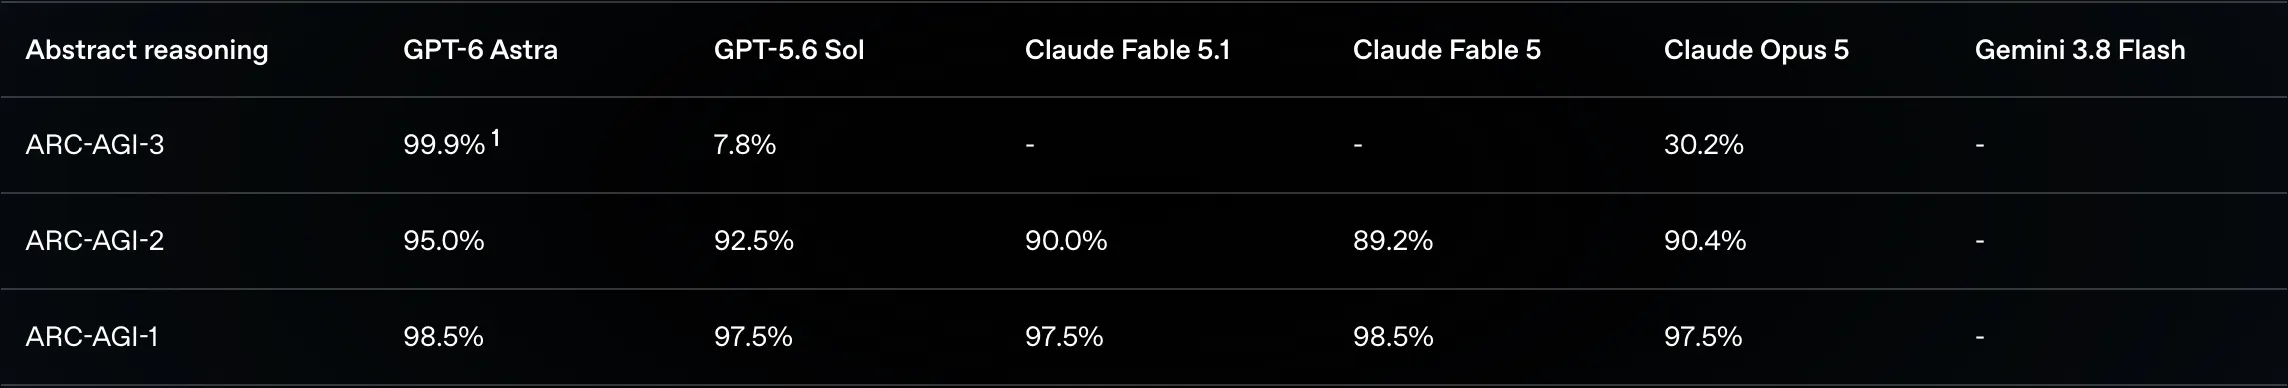
오픈AI 발표문의 추상 추론 벤치마크 표. ARC-AGI-3 행에서 아스트라 99.9% 옆에 각주 번호 1이 작게 붙어 있다
이런 건 혼자 파면 놓치기 쉽죠. 지피터스는 같이 뜯어보는 사람들이 모인 곳이에요. 24기 AI 스터디 둘러보기 ->
조건 1: 99.9%는 설정을 바꾼 실행이었어요
제일 화제가 된 숫자예요. ARC-AGI-3에서 99.9%. 같은 표에서 GPT-5.6 Sol이 7.8%니까 격차가 어마어마해 보이죠.
각주 1번에 이렇게 적혀 있어요.
ARC-AGI-3에서 GPT-6 아스트라는 responses API 하네스로 실행했고, 이는 실사용 성능에 더 맞추려고 설정 두 개를 바꾼 것입니다. 그 변경이 ARC-AGI-3를 특정해 겨냥한 건 아닙니다.
숨긴 게 아니에요. 오픈AI가 각주로 밝혔고, 겨냥한 게 아니라는 설명도 붙였어요. 다만 표만 보면 이 조건이 안 보입니다. 99.9와 7.8을 나란히 놓고 "13배"라고 말하려면 조건이 같아야 하잖아요.
표지 이미지를 보시면 하나 더 보여요. ARC-AGI-3 줄만 빈칸이 많아요. 페이블 5.1도 페이블 5도 점수가 아예 없어요. 반면 아래 두 줄(ARC-AGI-2, ARC-AGI-1)은 다 채워져 있고 90%대로 몰려 있고요. 격차가 제일 큰 줄에 비교 대상이 비어 있는 셈이에요.
조건 2: 비교 대상 점수의 출처가 다를 수 있어요
BenchCAD라는 3D 설계 벤치마크가 있어요. 아스트라 95.9%, GPT-5.6 Sol 83.3%, 클로드 페이블 5.1이 84.3%예요.
여기 각주 5번이 붙어요.
BenchCAD에서 클로드의 점수는 eval에 가한 3가지 수정을 반영한 것이며, 자세한 내용은 페이블 5.1 시스템 카드에 있습니다.
발표문 본문도 페이블 점수를 보고된 값(reported) 값이라고 표현해요. 직접 돌린 게 아니라 상대 회사가 발표한 숫자를 가져온 것이죠.
이게 나쁘다는 게 아니에요. 남의 모델을 직접 돌리려면 조건 시비가 붙으니 공개 수치를 쓰는 게 오히려 정직할 수 있고요. 다만 "우리가 같은 조건에서 재봤다"와는 다른 얘기입니다.
조건 3: 어떤 설정을 골랐는지도 조건이에요
OSWorld 2.0에서는 각주 3번이 이렇게 말해요.
OSWorld 2.0에서 클로드 점수는 공식 설정을 쓴 것이고, 페이블 5.1 시스템 카드의 수정된 태스크와 수정된 채점은 쓰지 않았습니다.
같은 벤치마크인데 설정이 두 갈래고, 오픈AI는 그중 하나를 골랐다는 뜻이에요. 어느 쪽이 옳은지는 제가 판단 못 해요. 다만 고를 여지가 있었다는 것 자체가 정보예요.
조건 4: 프롬프트를 넣고 잰 것도 있어요
FrontierCode라는 코딩 벤치마크에는 각주 8번이 붙어요. 아스트라를 실행할 때 Codex의 developer message와 비슷한 지시문을 넣었다는 거예요. 실제 문구도 공개했는데 이런 내용이에요.
- 테스트 파일을 과하게 만들지 말 것
- 무관한 정리나 불필요한 복잡함을 피할 것
- 기존 유틸리티를 재사용할 것
- 저장소 관례와 주변 코드, 테스트, 문서, CI를 읽고 따를 것
각주는 "이 프롬프트가 해당 평가용으로 최적화된 건 아니다"라고 덧붙여요. 그래도 지시문 없이 잰 게 아니라는 건 알고 봐야죠.
그래서 뭘 보면 되나요
각주를 다 읽을 필요는 없어요. 저는 이 네 가지만 봐요.
하네스나 설정을 바꿨다는 말이 있나. "harness", "settings", "configuration" 같은 단어가 각주에 있으면 조건이 다른 실행이에요.
상대 모델 점수를 직접 쟀나, 가져왔나. "reported", "official leaderboard" 같은 표현이 있으면 가져온 값이에요.
프롬프트나 지시문을 넣었나. "developer message", "system prompt"가 나오면 맨몸 실행이 아니에요.
어느 설정을 골랐는지 밝혔나. 선택지가 있었다는 뜻이고, 다른 선택에선 다른 숫자가 나와요.
표를 아예 믿지 말라는 건 아니에요
오해하실까 봐 덧붙일게요. 이 각주들은 오픈AI가 스스로 붙인 거예요. 감추려 했으면 안 썼겠죠. 조건을 밝힌 건 오히려 성실한 쪽이에요.
그리고 조건이 붙었다고 성과가 가짜인 것도 아니에요. 같은 발표문에서 조건 없이 인상적인 숫자도 나와요. Agents' Last Exam 59.3%에 출력 토큰을 Opus 5보다 약 65% 적게 썼고, OSWorld 2.0에서는 GPT-5.6 Sol보다 작업당 시간을 약 47% 줄이면서 점수는 더 높았어요. 이런 건 조건보다 방향이 뚜렷해요.
제가 말씀드리고 싶은 건 하나예요. 표의 숫자 하나로 도구를 갈아타지는 마세요. 각주를 30초만 훑어도 그 숫자가 내 상황에 해당하는지 아닌지가 보여요.
정리하면
- ARC-AGI-3의 99.9점은 설정 두 개를 바꾼 하네스로 잰 값이에요 (각주 1)
- BenchCAD의 클로드 점수는 수정 3가지가 반영된, 상대가 보고한 값이에요 (각주 5)
- OSWorld 2.0은 설정이 두 갈래였고 그중 하나를 골랐어요 (각주 3)
- FrontierCode는 지시문을 넣고 잰 결과예요 (각주 8)
- 각주에서 볼 것: 하네스 변경 · 점수 출처 · 프롬프트 주입 · 설정 선택
지난주에 코딩 AI 순위표를 뜯어봤을 때도 비슷했어요. 화면에는 Preliminary라고 잠정 표시가 붙어 있는데 텍스트로만 보면 안 보이더라고요. 숫자는 늘 조건을 달고 다니는데, 그 조건이 표 밖에 있어요.
다음에 새 모델 발표 나오면 표 보시고 바로 스크롤 내려서 각주 한 번 훑어보세요. 30초면 됩니다!
같이 보면 좋은 글
- 코딩 잘하는 AI 순위 실측: 순위표의 잠정 표시를 찾아낸 글이에요
- GPT-6 아스트라 오늘 공개: 값과 사양을 정리한 글이고요
확인일: 2026년 9월 6일
출처
- GPT-6 Astra 공식 발표문 (각주 1·3·5·8)