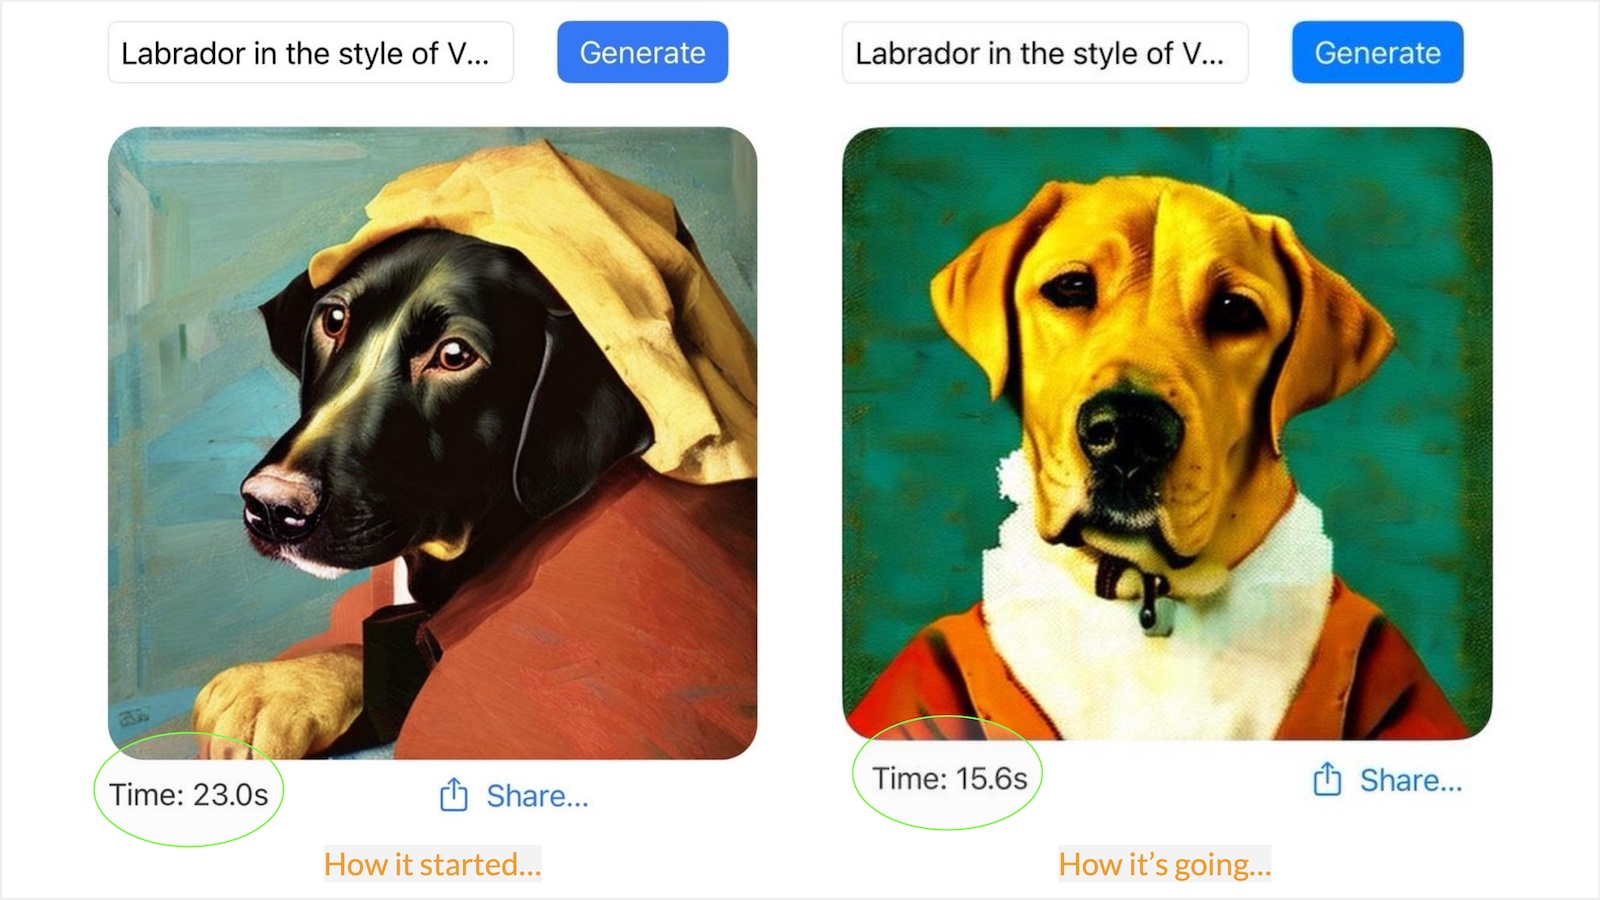
애플기기에서 Stable-diffusion을 빠르게 사용할 수 있는 최적화 신기술 적용
Ditto
2023.06.26
WWDC'23에서는 Apple 기기에서 머신러닝 모델을 실행하기 위한 압축 및 최적화 기술을 포함하는 새로운 핵심 ML 최적화를 소개했습니다.
최신 버전의 Core ML 및 coremltools는 적용하기 쉽고 품질에 미치는 영향을 최소화하는 6비트 palettization과 같은 기술을 지원합니다. 유니티는 6비트 palettization 모델을 허브에 추가했으며, 이 모델은 iOS와 macOS 모두에서 실행할 수 있을 정도로 크기가 작습니다.
또, quantization 방법을 사용하면 안정적 확산 모델의 크기를 줄이고, 디바이스에서 더 빠르게 실행하며, 리소스를 덜 소비할 수 있습니다.
ml-stable-diffusion 오픈 소스 저장소가 업데이트되어 정량화 및 추가 최적화를 지원하며, 공식 Stable Diffusion 모델은 코어 ML 형식과 zip 아카이브로 제공되어 Xcode 프로젝트에 쉽게 통합할 수 있습니다.
https://huggingface.co/blog/fast-diffusers-coreml
로그인하고 댓글을 남겨 주세요
Ditto2023.06.26
GilddongGo2023.06.26
애플이 맘만 먹으면 AI에서 MS를 압도하는건 껌인데..
도통 관심이 없으니..
비젼글래스 같은거나 만들고 ~
도통 관심이 없으니..
비젼글래스 같은거나 만들고 ~
GilddongGo2023.06.26
애플 실리콘맥에서 LLaMA(오픈소스 chatGPT)를 C++로
엔비댜 A100 보다 빠르게 돌리는데 성공했다는 이야기도 있었죠.
https://github.com/ggerganov/llama.cpp/pull/1642m2 max기준으로 65b llama로 5토큰/s 속도가 나온답니다.....
그리고 m1 ultra 기준으로 7.8토큰/s 요.
그것은 a100 80기가보다 빠른 속도 였다는...
엔비댜 A100 보다 빠르게 돌리는데 성공했다는 이야기도 있었죠.
https://github.com/ggerganov/llama.cpp/pull/1642m2 max기준으로 65b llama로 5토큰/s 속도가 나온답니다.....
그리고 m1 ultra 기준으로 7.8토큰/s 요.
그것은 a100 80기가보다 빠른 속도 였다는...

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요