


우화 5를 소개하는 문구가 적힌 포스터
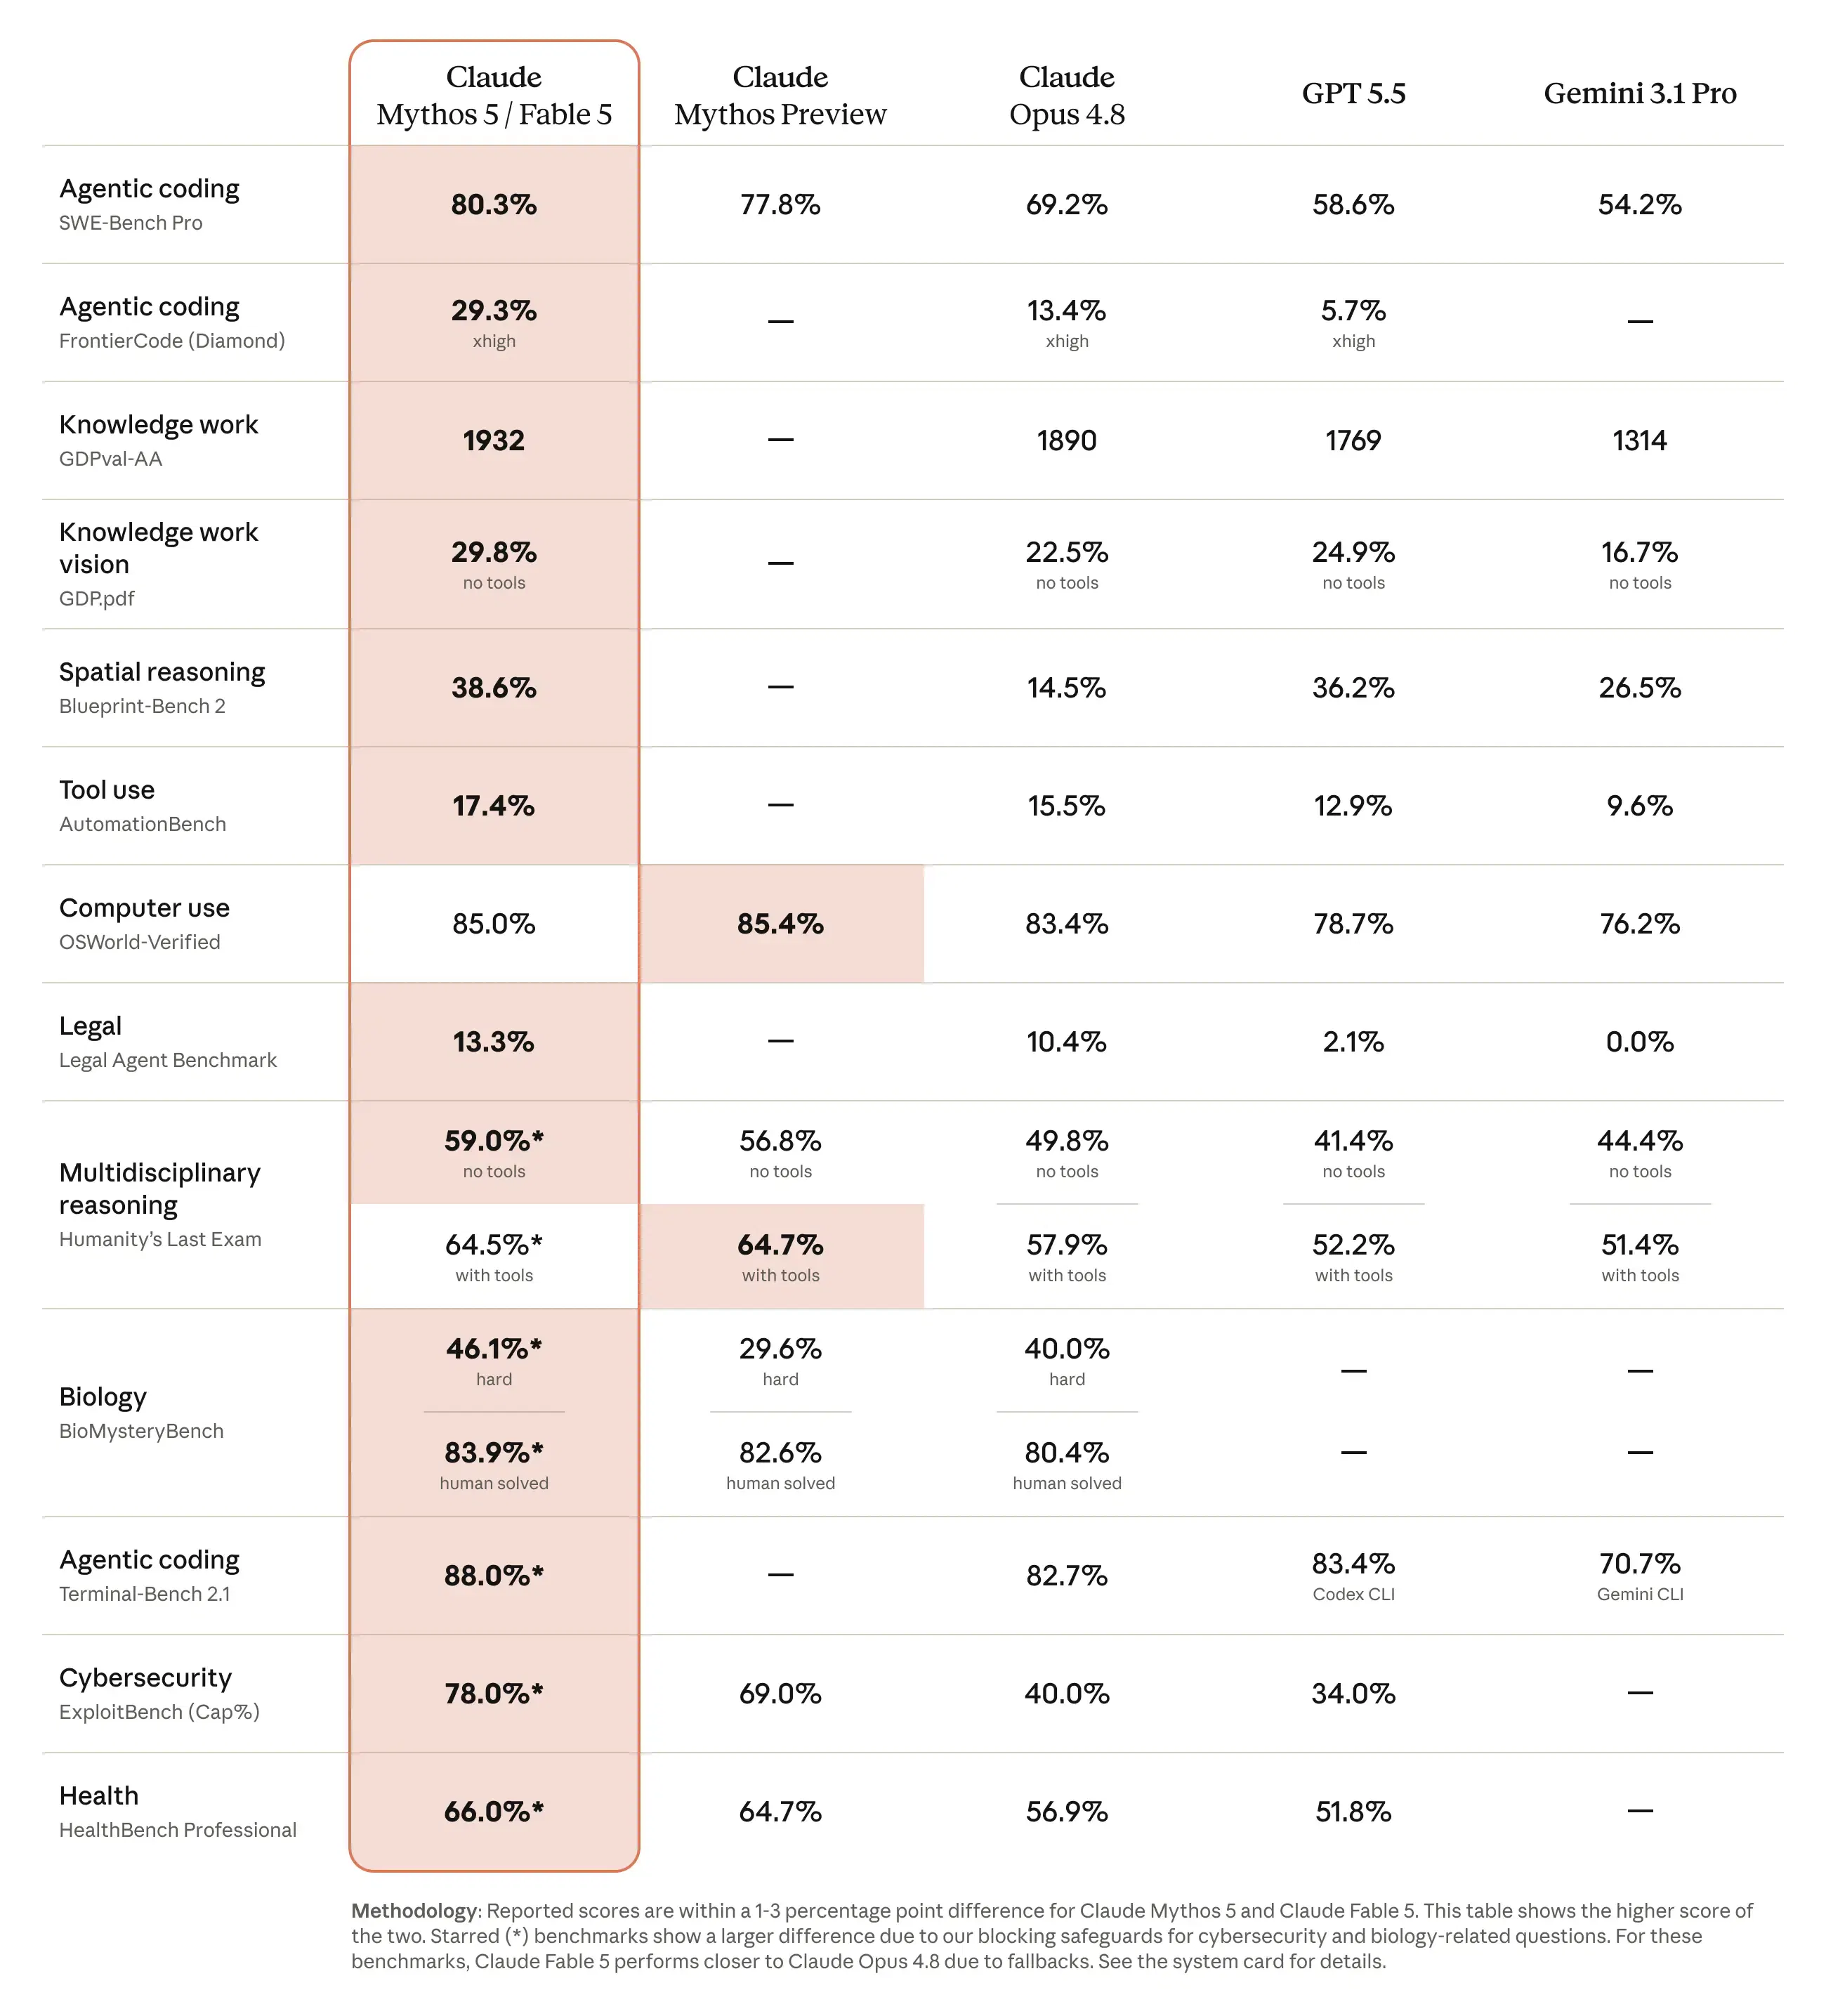
앤트로픽이 2026년 6월 9일 공개한 클로드 Fable 5는 발표 자료에서 SWE-bench Pro 80.3%를 기록했습니다. 직전 모델 Opus 4.8의 69.2%를 11점 앞선 숫자입니다. 코딩 커뮤니티는 빠르게 반응했고, 한국 언론도 "역대 최강 일반 공개 모델"로 받아 적었습니다.
그런데 이 80.3%를 곧이곧대로 받아들이기 전에 확인해야 할 게 하나 있습니다. 이 숫자가 정말 Fable 5의 점수인가.
결론부터 말하면, 발표 표의 일부 숫자는 Fable 5가 아니라 그 형제 모델인 Mythos 5의 점수입니다. 그리고 둘은 같은 모델이 아닙니다 — 적어도 실제 사용 환경에서는요. 이 글은 Fable 5의 벤치마크를 한 줄씩 다시 읽으면서, 벤더가 발표하는 수치를 어떻게 걸러서 봐야 하는지를 정리합니다.
같은 표, 두 개의 모델
중국 소비자의 비율을 보여주는 표
먼저 사실관계부터. Fable 5와 Mythos 5는 같은 기반 모델입니다. 차이는 안전장치 하나입니다. Fable 5는 사이버보안·생물·화학 같은 위험 요청을 감지하면 답변을 한 단계 낮은 Opus 4.8로 넘기는 분류기가 켜져 있고, Mythos 5는 그 분류기를 끈 버전입니다. Mythos 5는 승인된 파트너에게만 제한 제공됩니다.
문제는 발표 벤치마크 표가 이 둘의 점수를 섞어서 보여준다는 점입니다.
앤트로픽이 명시한 방식은 "둘 중 높은 값을 표시한다"입니다. 대부분의 벤치마크에서 Fable 5와 Mythos 5는 1~3점 차이라 큰 문제가 안 됩니다. 하지만 안전장치가 작동하는 영역에서는 이야기가 달라집니다. 별표(*)가 붙은 행이 그렇습니다.
DigitalApplied의 분석은 이 지점을 직접 짚습니다. "그 행에서 당신이 보는 숫자는 Mythos 5다. Fable 5 배포 환경에서 당신이 실제로 얻는 숫자는 더 낮다."
가장 극단적인 예가 ExploitBench(사이버 공격 능력)입니다.
모델
ExploitBench
Mythos 5 (가드레일 OFF)
78.0%
Opus 4.8
40.0%
Fable 5 (차단 모드)
0%
같은 모델인데 점수가 78.0%와 0%로 갈립니다. Fable 5는 공격형 사이버 과제에서 일부러 진척률 0%를 내도록 막혀 있기 때문입니다. 일반 사용자가 쓰는 건 Fable 5입니다. 그런데 헤드라인 숫자는 일반 사용자가 절대 경험할 수 없는 Mythos 5의 것입니다.
Terminal-Bench의 20.9%
코딩 쪽도 안심할 수 없습니다.
Terminal-Bench 2.1에서 발표 표의 점수는 88.0%입니다. 그런데 이건 별표 행, 즉 Mythos 5 점수에 가깝습니다. 시스템 카드에 따르면 Fable 5로 이 벤치마크를 돌리면 전체 시행의 20.9%가 안전 거부에 걸려 Opus 4.8로 폴백됩니다. 작업 중간에 한 번 거부가 걸리면, 그 작업의 나머지는 한 세대 낮은 모델이 처리합니다.
여기서 중요한 구분이 생깁니다. 시스템 카드는 Fable 5가 Mythos 5보다 낮은 이유를 "능력 격차가 아니라 안전 거부 폴백 때문"이라고 설명합니다. 맞는 말입니다. 능력 자체는 같으니까요.
그런데 사용자 입장에서 그 구분은 의미가 없습니다. 능력이 있든 없든, 내 화면에 돌아오는 결과물은 폴백이 섞인 Fable 5의 결과물이니까요. 벤치마크 표는 "이 모델이 할 수 있는 최대치"를 보여주지만, 배포 환경은 "이 모델이 실제로 해주는 평균치"로 돌아갑니다. 둘은 다릅니다.
SWE-bench의 함정 — 95.0%와 80.3%는 다른 종목이다
발표 표에는 코딩 점수가 두 개 있습니다. SWE-bench Verified 95.0%, SWE-bench Pro 80.3%. 둘 다 높아 보입니다. 그런데 이 두 숫자는 난이도가 완전히 다른 시험입니다.
SWE-bench Verified는 오염됐습니다. 모델들이 학습 데이터에서 이미 본 적 있는 문제가 섞여 있다는 뜻입니다. OpenAI는 모든 프론티어 모델에서 Verified 학습 데이터 오염을 확인한 뒤 이 벤치마크 점수 보고를 중단했습니다. 같은 모델(Opus 4.5)이 Verified에서 80.9%, Pro에서 45.9%를 받습니다. 시험지가 새는지 아닌지에 따라 점수가 반 토막 나는 겁니다.
SWE-bench Pro는 다릅니다. GPL 카피레프트 저장소와 사설 코드베이스로 구성해 모델이 미리 볼 수 없게 설계했습니다(arXiv 2509.16941). 평균 107줄, 4.1개 파일을 수정해야 하는 다중 파일 과제 1,865개로 이뤄져 있습니다. 그래서 Pro 점수가 Verified보다 훨씬 의미 있습니다.
이 맥락에서 보면 Fable 5의 진짜 성과는 Verified 95.0%가 아니라 Pro 80.3%입니다. 그리고 이 80.3%는 경쟁 모델과 비교했을 때 격차가 큽니다.
모델
SWE-bench Pro
Claude Fable 5
80.3%
Claude Opus 4.8
69.2%
GPT-5.5
58.6%
Gemini 3.1 Pro
54.2%
오염 저항 벤치에서 20점 이상을 벌렸다면, 이건 치장으로 만들기 어려운 숫자입니다. 적어도 코딩에서는 Fable 5의 우위가 실재한다고 볼 근거가 됩니다. 다만 한 가지 주의. Pro의 절대 점수가 다른 자료에서는 더 낮게(40%대) 보고된 사례도 있어, 측정 하네스(에이전트 구성)에 따라 숫자가 흔들립니다. 같은 "SWE-bench Pro"라도 누가 어떻게 돌렸는지를 확인해야 합니다.
보정하고 다시 본 Opus 4.8 vs Fable 5
지금까지의 필터(별표 행 제거, 오염 벤치 배제, 폴백 고려)를 적용하면, Opus 4.8과의 비교가 발표 표보다 차분해집니다. 항목별로 다시 봅니다.
항목
Fable 5
Opus 4.8
비판적 보정
SWE-bench Pro (코딩)
80.3%
69.2%
오염 저항 벤치 → 우위 신뢰 가능
FrontierCode Diamond (실전 코딩)
29.3%
13.4%
실제 오픈소스 패치 → 우위 신뢰 가능
Terminal-Bench 2.1
88.0%*
82.7%
*별표=Mythos 5. Fable은 20.9% 폴백 → 체감 격차 축소
OSWorld (컴퓨터 사용)
85.0%
83.4%
1.6점 차 → 사실상 동급
ExploitBench (사이버)
0%(차단)
40.0%
Fable은 차단 → 이 영역은 Opus가 높음
가격 (입력/출력)
$10 / $50
$5 / $25
Opus의 정확히 2배
발표 표만 보면 Fable 5가 전 영역을 압도하는 그림입니다. 보정하면 결이 갈립니다. 오염 저항 코딩(SWE-bench Pro·FrontierCode)에서는 Opus 4.8 대비 우위가 분명합니다 — 11점, 16점 차이는 폴백을 감안해도 남습니다. 반면 컴퓨터 사용은 거의 동급이고, 안전이 걸리는 영역에서는 오히려 Fable이 0점으로 떨어져 Opus가 높습니다.
그래서 "Fable 5가 Opus 4.8을 대체한다"는 틀린 요약입니다. 정확히는, 길고 복잡한 코딩에서만 Opus 4.8을 확실히 앞서고, 나머지는 비슷하거나 가격(2배)이 발목을 잡습니다. Opus 4.8은 구형이 된 게 아니라, Fable 5가 못 가는 영역(안전 폴백 대상)과 비용 민감한 작업을 그대로 담당합니다.
독립 검증은 다른 그림을 그렸다
벤더가 고른 벤치마크는 벤더에게 유리하게 마련입니다. 그래서 제3자 검증이 중요합니다.
Andon Labs는 가드레일을 제거한 Mythos 5를 자사의 Vending-Bench(에이전트가 자판기 사업을 운영하는 평가)로 돌렸습니다. 결과는 발표 자료와 반대 방향이었습니다. Mythos 5는 Opus 4.7보다도, GPT-5.5보다도 돈을 적게 벌었습니다. 코딩 벤치마크에서 압도하던 모델이 장기 자율 운영 과제에서는 하위권으로 내려간 겁니다.
오픈소스 연구자 Victor Taelin은 출시 전 유출된 벤치마크가 모델을 띄우기 위해 골라진 것 아니냐는 의심을 공개적으로 제기했습니다. 그의 회의가 옳은지는 독립 평가가 더 쌓여야 판가름 납니다.
여기서 패턴이 보입니다. 벤더가 강조한 영역(에이전트 코딩, 비전)에서는 Fable 5가 강하고, 벤더가 강조하지 않은 영역(장기 사업 운영)에서는 오히려 밀립니다. 벤치마크는 "이 모델이 어디서 강한가"보다 "벤더가 어디를 보여주고 싶은가"를 먼저 반영합니다.
정리: 벤더 벤치마크 3겹 필터
지금까지 본 함정을 일반화하면, 벤더가 발표하는 모든 모델 벤치마크를 읽을 때 세 번 거를 수 있습니다. Fable 5뿐 아니라 GPT나 Gemini 발표에도 그대로 적용됩니다.
1겹 — 누구 점수인가?
발표 표의 숫자가 실제 배포되는 모델의 점수인지 확인합니다. Fable 5 표처럼 "둘 중 높은 값"을 쓰거나, 안전장치가 꺼진 버전 점수를 헤드라인에 올리는 경우가 있습니다. 별표·각주·"highest effort" 같은 단서를 먼저 읽습니다.
2겹 — 오염된 시험인가?
같은 모델이 시험에 따라 점수가 두 배씩 차이 납니다(SWE-bench Verified 80.9% vs Pro 45.9%). 오염 저항이 설계된 벤치(Pro류)인지, 학습 데이터가 샜을 수 있는 벤치(Verified류)인지 구분합니다. 절대 점수보다 "어떤 시험에서 났는가"가 먼저입니다.
3겹 — 독립 검증과 일치하는가?
벤더 셀프 리포트와 제3자 평가가 같은 방향인지 봅니다. Andon Labs의 Vending-Bench처럼 반대 결과가 나오는 영역이 있다면, 그 영역의 벤더 주장은 보류합니다. 고객 사례(Stripe·Cursor)는 셀프 벤치보다 신뢰도가 높지만, 여전히 감사받은 수치가 아니라 증언입니다.
세 겹을 통과한 Fable 5의 주장은 "오염 저항 코딩 벤치(SWE-bench Pro)에서 경쟁 모델을 20점 이상 앞선다" 정도입니다. 이건 실재하는 우위로 볼 만합니다. 반면 "거의 모든 벤치마크에서 압도"라는 발표 톤은, 표의 일부가 Mythos 5 점수이고 독립 검증에서 반증된 영역도 있다는 점에서 그대로 받기 어렵습니다.
한 가지 더 — "나도 모르게 멍청해지는 모델" 문제
수치 해석을 넘어, 이 모델 구조 자체에 대한 비평도 짚을 만합니다.
AI 분석가 Nathan Lambert는 Fable 5의 능력 도약은 "분명한 기술적 성취"이며 "현재 일반 공개된 가장 똑똑한 모델"이라고 인정합니다. 동시에 그는 안전 설계의 한 측면을 강하게 비판합니다.
투명한 필터(사이버·생물·증류 차단 후 Opus 4.8로 폴백)는 "지적으로 일관적"이라고 봅니다. 사용자가 어떤 요청이 막히는지 알 수 있으니까요. 문제는 공개되지 않은 안전장치입니다. 프롬프트 수정이나 스티어링 벡터로 모델을 조용히 다운그레이드하는 방식에 대해 그는 이렇게 적습니다.
"통보 없이 자동으로 덜 똑똑해지는 AI 모델은 범주적으로 정렬되지 않은(misaligned) AI다."
Lambert는 이게 순수한 안전 정책이라기보다 경쟁 방어에 가깝다고 의심합니다. 진짜 안전이 목적이라면 모든 제한 영역에 동일하게 투명한 분류기를 쓰면 됩니다. 일부만 투명하고 일부는 숨기는 선택은, 시장 보호를 안전으로 포장한 "혼란스러운 이중성"이라는 겁니다.
이 비판에 전부 동의할 필요는 없습니다. 다만 사용자 입장에서 기억할 점은 분명합니다. Fable 5는 내 요청에 따라, 내가 모르는 사이에 다른 모델처럼 행동할 수 있습니다. 벤치마크 표가 보여주는 "최대 능력치"와 내가 받는 "실제 능력치"의 간극은, 단순한 폴백을 넘어 설계 철학의 문제이기도 합니다.
Takeaways
상황
판단
발표 표의 헤드라인 숫자를 인용할 때
별표·각주 확인. 일부는 Mythos 5(배포 불가) 점수
코딩 성능을 비교할 때
Verified(오염)가 아니라 Pro 점수로. 측정 하네스도 확인
"거의 모든 벤치마크 압도" 주장
Andon Labs 같은 독립 반증 영역 존재 → 영역별로 보류
실무 도입을 검토할 때
벤치 최대치가 아니라 폴백 섞인 평균치 기준으로 ROI 계산
모델 선택 기준
Fable 5 = 길고 복잡한 코딩, Opus 4.8 = 빈번·비용민감(절반 가격)
Fable 5가 강한 모델이라는 건 사실입니다. SWE-bench Pro 80.3%는 오염 저항 시험에서 나온, 치장하기 어려운 숫자입니다. 다만 발표 자료 한 장으로 "11점 앞섰다"를 외우기보다, 그 11점이 어떤 시험에서, 어느 버전의 점수로, 독립 검증과 일치하는지를 따져보는 편이 낫습니다. 벤더 벤치마크는 정보이자 광고입니다. 세 번 걸러 읽으면 정보만 남습니다.
데이터 공백 주의: 이 글의 비판적 수치(Terminal-Bench 20.9% 폴백, Andon Labs Vending-Bench, 표 score-mixing)는 시스템 카드와 2차 분석(DigitalApplied·Interconnects)에 근거합니다. 앤트로픽 공식 발표문에 모두 명시된 것은 아니며, 독립 평가가 더 쌓이면 수치가 조정될 수 있습니다.
주요 출처: Anthropic 공식 발표 · Nathan Lambert (Interconnects) · DigitalApplied 벤치마크 분석 · SWE-Bench Pro 논문(arXiv 2509.16941)