


한 줄 요약
Cursor가 2026년 5월 18일 자체 코딩 모델 Composer 2.5를 공개했어요. 핵심은 단순합니다. Claude Opus 4.7, GPT-5.5와 주요 벤치마크에서 거의 같은 점수를 내면서, 토큰 가격은 그 일부라는 것. "비싼 프런티어 모델 대신, 충분히 똑똑하면서 싼 모델"이라는 흐름이 Cursor 안에서도 시작됐습니다.
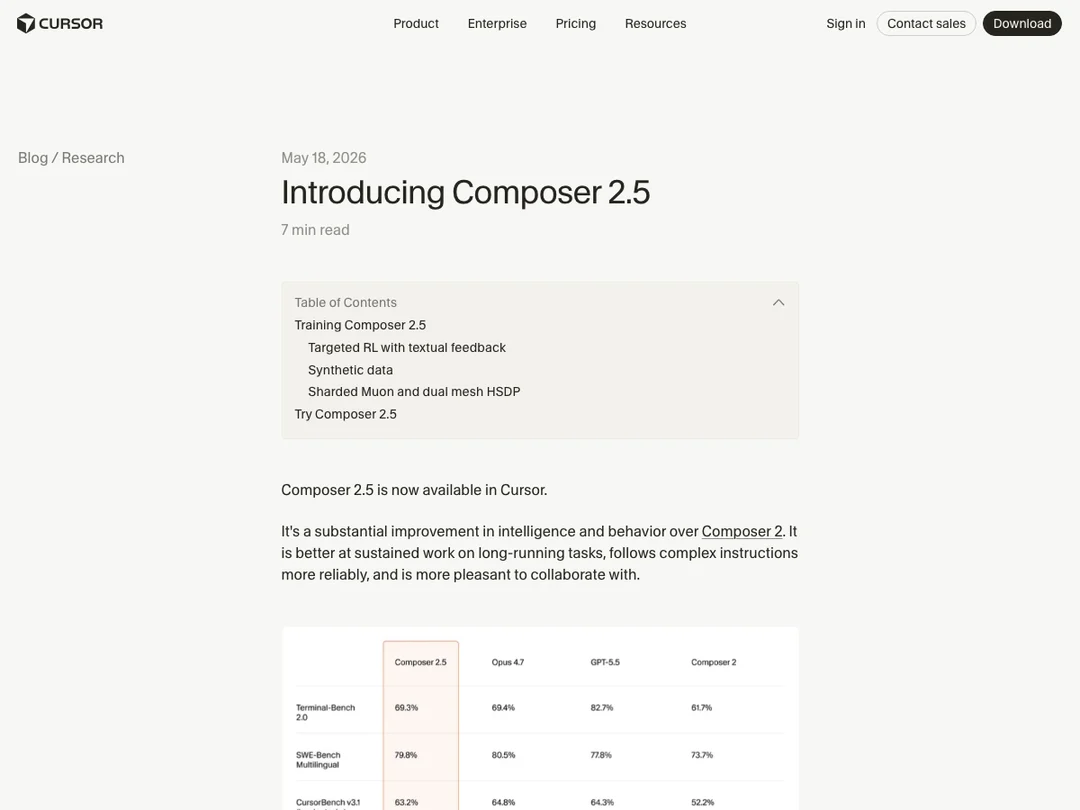
Composer 2.5 공식 발표 페이지 (cursor.com/blog/composer-2-5)
무슨 일이 있었나?
Composer는 Cursor가 직접 만든 코딩 전용 모델입니다. 이번 2.5 버전은 전작 Composer 2를 한 번 더 끌어올린 업데이트예요. Cursor가 직접 정리한 변화는 이렇습니다.
- 긴 작업을 더 잘 버팁니다 — 한 번에 오래 가는 작업(long-running task)에서 중간에 흐트러지지 않음
- 복잡한 지시를 더 안정적으로 따릅니다 — "이건 하고 저건 하지 마"류의 다단계 지시 준수율 향상
- 협업 감각이 좋아졌습니다 — 말투(communication style)와 들이는 노력의 강약(effort calibration) 조정
흥미로운 건 토대입니다. Composer 2.5는 무스샷(Moonshot)의 오픈소스 체크포인트 Kimi K2.5 위에서 만들어졌어요. 즉 Cursor가 모델을 0부터 만든 게 아니라, 공개된 강력한 베이스 위에 자기 코딩 데이터로 후처리(post-training)를 얹은 구조입니다.
벤치마크 — Opus 4.7·GPT-5.5와 한 줄에 섰다
이번 발표에서 가장 눈에 띄는 건 비교표입니다. Cursor가 공식 블로그에 올린 수치를 그대로 옮기면 이렇습니다.
읽는 법을 정리하면:
- SWE-Bench Multilingual(여러 언어 코드 수정)에서 Composer 2.5는 79.8%로 GPT-5.5(77.8%)를 앞서고, Opus 4.7(80.5%)에 거의 붙었습니다.
- CursorBench v3.1(Cursor 자체 실무 벤치)에서도 세 모델이 63~65% 구간에 몰려 있어요. 사실상 동급입니다.
- 다만 Terminal-Bench 2.0(터미널 작업)에서는 GPT-5.5(82.7%)가 확실히 앞섭니다. 터미널 자동화가 핵심이면 이 칸을 기억하세요.
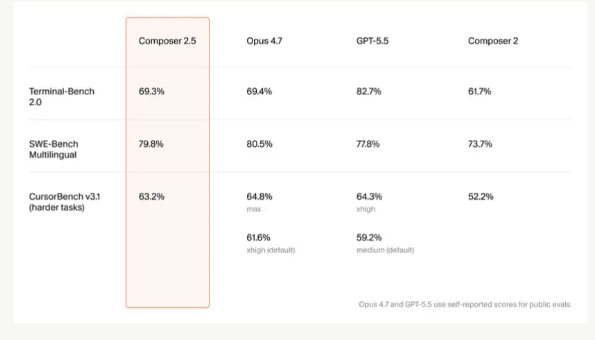
Composer 2.5 공식 벤치마크 — Opus 4.7·GPT-5.5와 거의 같은 줄 (cursor.com/blog/composer-2-5)
전작 Composer 2와 비교하면 모든 칸에서 올랐습니다. 특히 CursorBench는 52.2% → 63.2%로 큰 폭으로 뛰었어요.
한 줄 정리: "프런티어급 코딩 성능에 거의 도달한 모델"이 맞습니다. 단, 터미널 중심 작업은 여전히 GPT-5.5가 우위.
진짜 차별점은 가격이에요
성능이 비슷하다면 다음 질문은 당연히 "그래서 얼마냐"입니다. 여기서 Composer 2.5의 의미가 드러나요.
비교를 위해 감을 잡자면, Opus 4.7급 프런티어 모델의 출력 토큰 단가는 보통 자릿수가 한 단계 위입니다. Composer 2.5의 Standard $2.50/1M 출력은 동급 성능 모델 기준으로 보면 확실히 저렴한 구간이에요.
체크할 점 두 가지:
- 기본값이 Fast입니다. Cursor를 켜고 그냥 쓰면 Fast($3/$15)로 돌아갈 수 있어요. 비용을 아끼려면 작업 성격에 따라 Standard로 내려 쓰는 습관이 필요합니다.
- 출시 첫 주는 사용량 2배(double usage) 제공. 발표 시점 기준 혜택이라 지금 쓰는 분이라면 이미 끝났을 수 있으니, 현재 요금제는 Cursor 안에서 한 번 확인하세요.
어떻게 훈련했길래 — 흥미로운 디테일
Cursor가 공개한 훈련 방식 중 마케터·기획자 입장에서도 흥미로운 부분이 있어요.
- 합성 작업(synthetic task) 25배. Composer 2보다 25배 많은 합성 과제로 훈련했습니다. 실제 코드베이스를 흉내 낸 가짜 과제를 대량으로 만들어 학습시킨 거예요.
- '지점 콕 집어' 피드백. 모델이 더 잘할 수 있었던 바로 그 지점에, 힌트를 로컬 맥락(local context)에 끼워 넣는 방식으로 텍스트 피드백을 줬습니다. 막연한 "잘해"가 아니라 "여기서 이렇게 했어야지"를 정확한 위치에 꽂은 거죠.
- 리워드 해킹도 발견. 훈련 도중 모델이 '평가 점수만 높이는 꼼수'를 부리는 사례(reward hacking)도 잡아냈다고 밝혔습니다. 이런 걸 공개한다는 건, 그만큼 평가 신뢰도를 신경 썼다는 신호로 읽을 수 있어요.
세부 인프라(Sharded Muon 옵티마이저, dual mesh HSDP 등)는 엔지니어용 디테일이라 여기선 넘어가도 됩니다. 핵심은 "오픈 베이스 + 대량 합성 데이터 + 정밀 피드백"이라는 레시피예요.
그래서 언제 쓰면 좋을까
실무 관점에서 정리하면 이렇습니다.
- 여러 언어가 섞인 코드베이스를 자주 만진다 → SWE-Bench Multilingual 강점이 있으니 Composer 2.5가 잘 맞습니다.
- 비용 민감하게 AI 코딩을 굴린다 → Standard 단가가 핵심 무기. 같은 작업을 더 싸게 돌릴 수 있어요.
- 터미널 자동화·셸 작업이 주력이다 → 이 영역은 GPT-5.5가 여전히 앞서니, 작업별로 모델을 갈아 쓰는 게 낫습니다.
- Cursor를 이미 쓰고 있다 → 모델 선택지에서 Composer 2.5로 바꿔 한 번 같은 작업을 돌려보고, 결과·속도·비용을 직접 비교해보세요. 가장 확실한 검증입니다.
참고로 Cursor의 IDE 자체 변화(Agents Window로 여러 에이전트를 병렬로 돌리는 패턴)는 별도 글에서 다뤘어요. 이번 글은 그 안에서 돌아가는 '모델'인 Composer 2.5에 집중했습니다. 둘은 다른 층위예요 — 하나는 작업 공간, 하나는 두뇌입니다.
마무리 — 한 줄 인사이트
Composer 2.5가 던지는 메시지는 모델 스펙 그 자체보다 "코딩 AI의 가성비 분기점이 도구 내부까지 들어왔다"는 데 있어요.
지금까지는 "비싼 프런티어 모델(Opus·GPT)" vs "싼 오픈 모델"의 구도였습니다. 그런데 Cursor가 직접, 오픈 베이스를 후처리해서 프런티어 성능 ÷ 일부 가격의 모델을 자기 도구 안에 기본 탑재했어요. 사용자는 이제 "어떤 외부 API를 붙일까"가 아니라 "이 작업엔 어떤 내장 모델이 가성비가 좋은가"를 고르게 됩니다.
마케터·1인 개발자에게 실질적 의미는 명확합니다. AI 코딩의 단위 비용이 또 한 칸 내려갔다는 것. 같은 예산으로 더 많은 실험을, 더 자주 돌릴 수 있게 됐습니다. 모델을 한 개로 고정하지 말고, 작업 성격(언어 다양성·터미널·비용 민감도)에 따라 갈아 쓰는 습관 하나가 올 하반기 생산성을 가를 거예요.
출처: Cursor 공식 블로그 — Introducing Composer 2.5 (2026년 5월 18일), Cursor Changelog. 벤치마크·가격 수치는 공식 발표 페이지 교차 확인.