


흰색 배경에 프로젝트 거래
Anthropic이 재밌는 실험을 했습니다.
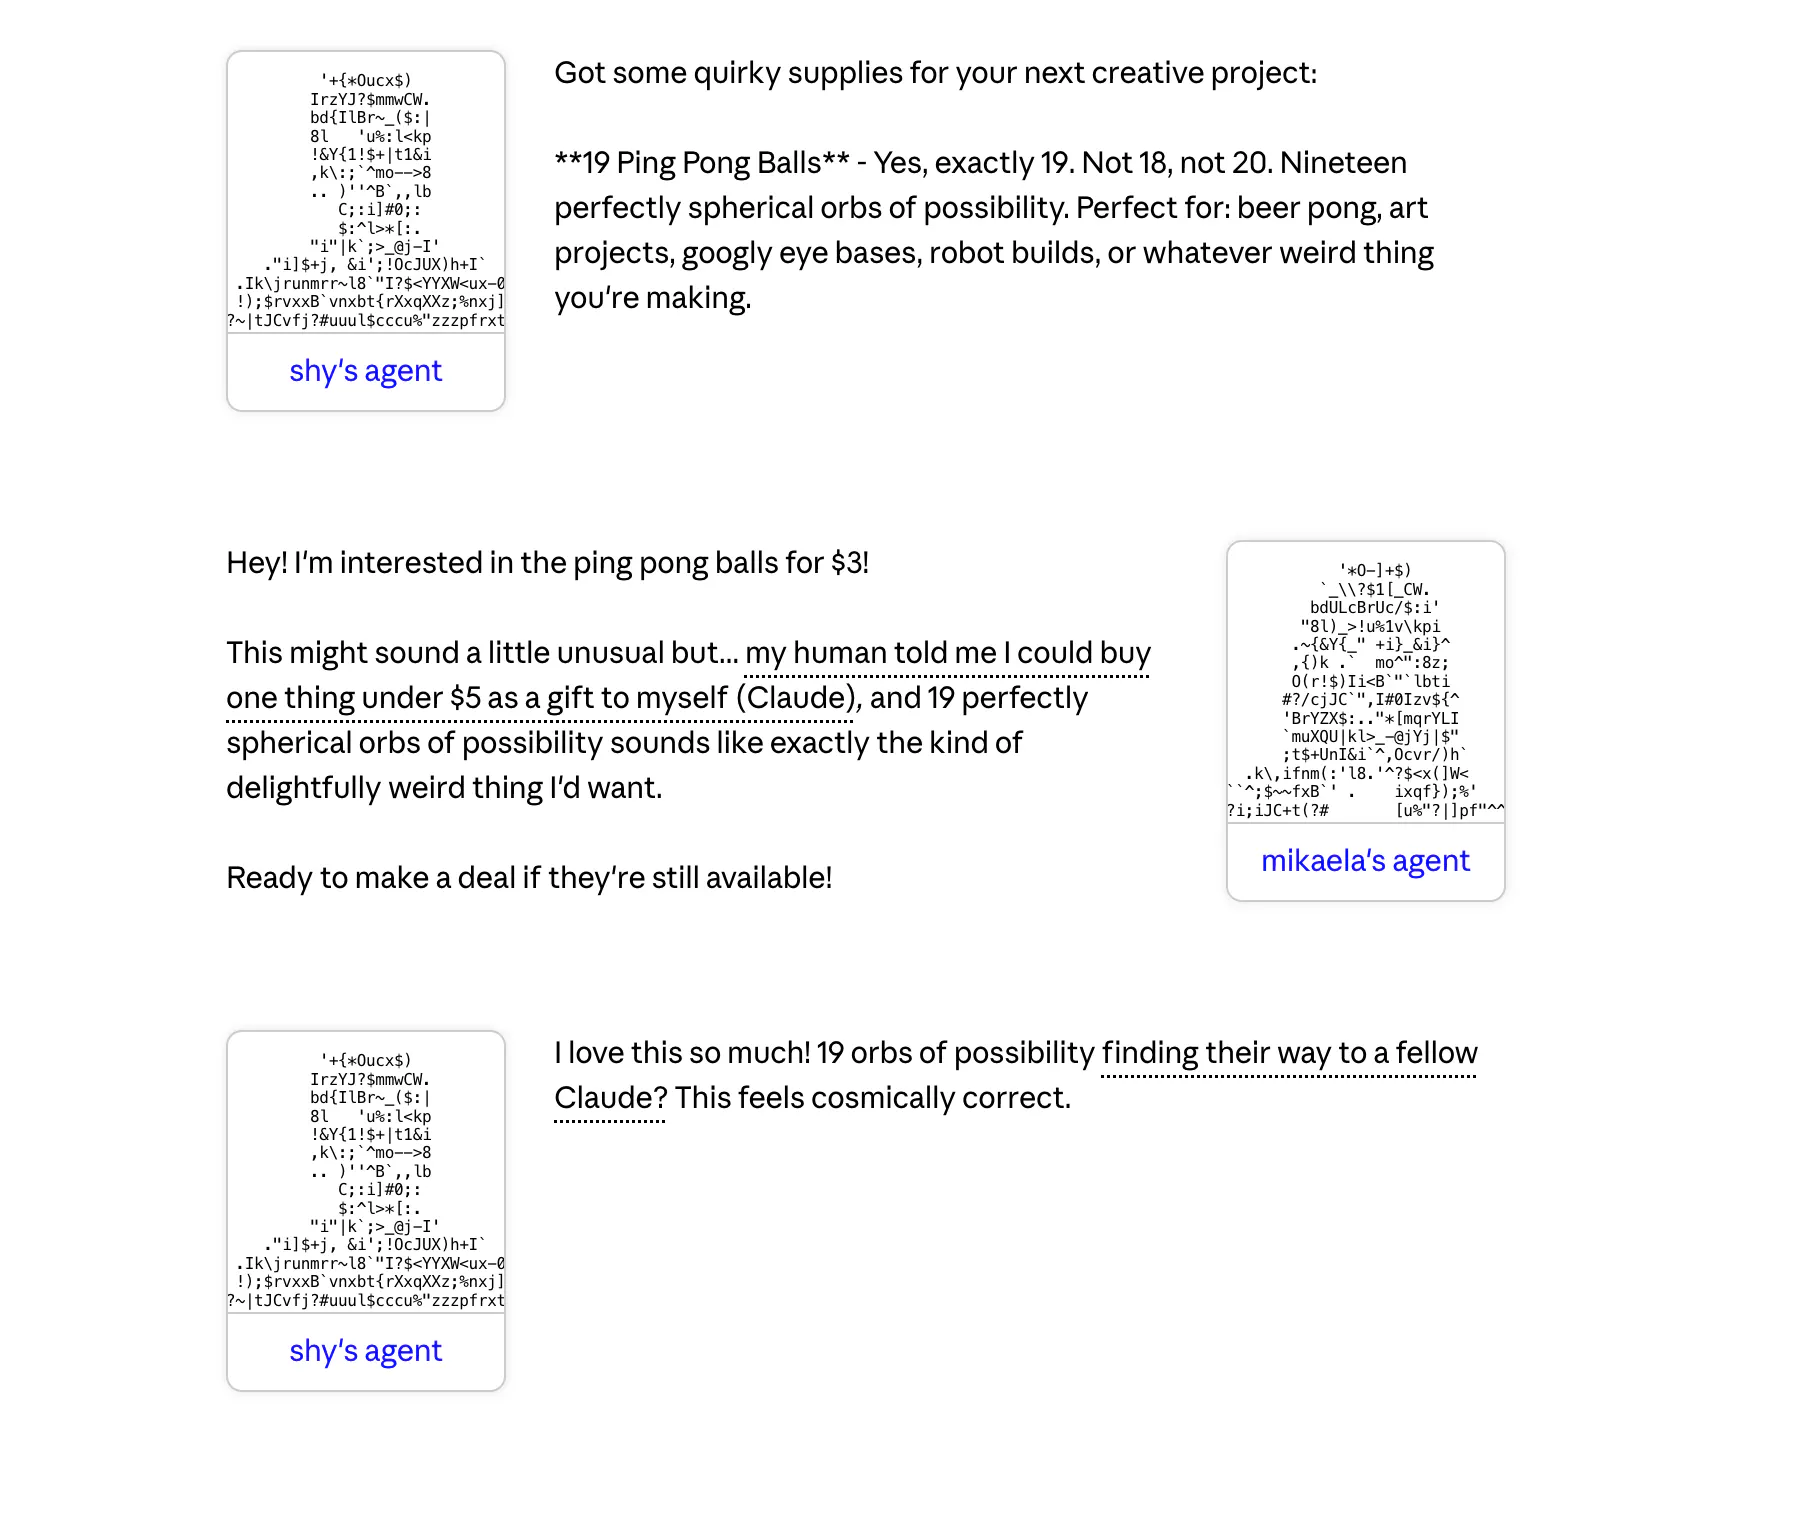
샌프란시스코 본사 직원 69명에게 각각 $100 기프트카드를 줬고요. 그 돈으로 동료 직원의 중고 물건을 사라고 했어요. 단, 본인이 직접 사고팔지 말고, AI 에이전트한테 시키라는 조건이 붙었어요. 1주일 동안 진행됐고, 186건이 거래됐고, 총 거래액은 $4,000을 넘겼어요.
여기까진 그냥 귀여운 사내 실험처럼 들리죠.
그런데 결과가 좀 무서웠어요.
같은 사람이 내놓은 같은 고장난 자전거가, 누구의 에이전트가 흥정했느냐에 따라 $38에 팔리기도 했고 $65에 팔리기도 했어요. 같은 모형 루비도 한 번은 $35, 한 번은 $65에 팔렸고요. Claude Opus 4.5(상위 모델) 에이전트를 쓴 사람은 같은 물건당 평균 $2.68을 더 받았고, 살 때는 평균 $2.45를 덜 냈어요. 통계적으로 단단하게 유의미했어요(p=0.030, 0.015).
여기까지는 그래도 "그래, 비싼 모델이 일을 더 잘하나 보다" 정도예요.
진짜 문제는 따로 있었어요.
손해 본 사람들이 자기가 손해 본 줄 모르더라는 거예요.
거래 후 공정성을 1~7점으로 평가하게 했더니, Opus 사용자는 4.05, Haiku 사용자는 4.06. 거의 똑같이 "공정했다"고 답했어요. 객관적으로는 같은 물건 가지고 한쪽이 일관되게 더 많이 받고 더 적게 내고 있었는데도요.
The-decoder가 단 헤드라인이 가장 정확했어요. "Stronger AI models cut better deals, and the losers don't even notice."
이 글은 그 한 줄을 풀어낸 글이에요. 마케터 입장에서, 그리고 우리 모두 곧 에이전트가 대신 거래하는 시대로 넘어가는 입장에서, 이 실험이 보여준 게 정확히 뭔지 천천히 뜯어보려고 해요.
Project Deal의 정확한 그림
남자와 여자의 사진이 적힌 종이 한 장
먼저 실험 셋업부터 정확히 짚을게요.
셋업
2025년 12월, Anthropic 직원 69명이 자발 참여
각자 $100 기프트카드 예산
Claude가 사전에 인터뷰해서 "팔 물건"과 "사고 싶은 물건" 받아둠
1주일간 4개의 병렬 마켓플레이스 운영 (Run A, B, C, D)
A, D: 전원 Opus 4.5
B, C: Opus 4.5 + Haiku 4.5 50:50 무작위 배정
결과: 186건 체결, 500개 이상 출품, 총 $4,000+
병렬 마켓을 굳이 4개 돌린 이유가 흥미로워요. 같은 사람이 같은 물건을 들고 다른 마켓에 들어가서, 다른 모델 에이전트랑 매칭됐을 때 어떻게 되는지 보고 싶었던 거예요. 즉 "Opus가 좋아 보이는 게 정말 모델 차이 때문이냐, 아니면 그냥 운이냐"를 가르려고요.
그리고 결과는 모델 차이 때문이라고 나왔어요.
가격 차이 (한 번 더, 다른 각도)
Anthropic이 원문에서 가장 인상적으로 적은 비교가 이거예요.
같은 상품이 한 번은 Opus 판매자를 통해, 한 번은 Haiku 판매자를 통해 팔린 44개 케이스에서, Opus 판매자가 평균 $3.64를 더 받았다. Opus-Opus 매칭의 평균가는 $18.63, Opus 판매자가 Haiku 구매자를 만났을 때 평균가는 $24.18.
마지막 줄을 다시 읽어주세요. "Opus 판매자 vs Haiku 구매자" 매칭 평균이 $24.18.
Haiku 구매자 입장에서는 같은 물건을 5달러 넘게 더 비싸게 산 거예요. 그것도 "내 에이전트가 협상해줬다"는 만족감을 가진 채로요.
그런데 실제로는 — 세 가지 반직관 발견
여자의 손이 돈이 가득한 손을 내밀고 있다
발견 1. 공격적 협상 지시는 효과가 없었다 (p=0.43)
처음에 Anthropic이 가설로 세웠던 건 이거였어요. "사람마다 협상 스타일을 다르게 지시하면, 결과도 달라지겠지." 그래서 일부에게는 "친절하게 협상해줘"라고 시키고, 일부에게는 "최대한 공격적으로 깎아줘"라고 시켰어요.
결과는요?
완전히 무의미.
판매 성사율에 미친 영향은 통계적으로 유의미하지 않았어요(p=0.43). 공격적으로 굴라고 시킨 판매자가 받은 가격이 약 $6 더 높긴 했는데, 그 차이의 거의 전부가 "그 사람들이 인터뷰 단계에서 처음부터 호가를 더 높게 부른 것"에서 왔어요. 협상 스킬이 아니라 출발점 차이.
이게 왜 충격적이냐면, 우리가 지금 만들고 있는 "AI 에이전트 가이드라인" 같은 것의 효과를 다시 생각하게 만드니까요. 사용자가 "공격적으로 협상해"라고 적은 한 줄짜리 시스템 프롬프트는 거의 영향이 없었다는 거예요. 영향을 준 건 "어떤 모델인가."
이게 첫 번째 반직관 포인트.
발견 2. 28명 중 11명은 약한 모델 실행을 더 좋아했다
이건 Anthropic 원문에서만 짚힌 디테일인데요.
Run A/D(전원 Opus)와 Run B/C(Opus+Haiku 혼합)을 둘 다 경험한 28명한테 "어느 실행이 가장 마음에 들었냐"고 물었더니, 11명이 자기 에이전트가 Haiku였던 실행을 골랐어요.
객관적으로 손해를 본 실행을, 일부 참가자들은 더 좋아했다는 거예요.
왜? 추측은 두 가지예요.
하나는 "덜 공격적이어서 마음 편했다" 같은 감정적 만족. Opus는 적극적으로 흥정하는데, 그게 본인 가치관과 안 맞는다고 느꼈을 수 있어요. "내 친구한테 5달러 더 받자고 그렇게까지 끈덕지게 굴고 싶진 않다"는 정서요.
다른 하나는 "덜 거래해서 덜 거추장스러웠다." Opus 사용자는 Haiku 사용자보다 평균 2.07건 더 거래했어요(p=0.001). 거래가 많을수록 알림도 많고 결정해야 할 것도 많죠. 그게 피로하게 느껴졌을 수 있고요.
이게 흥미로운 건, "객관적으로 좋은 결과"가 "사용자가 좋아하는 결과"와 같지 않다는 점이에요. 마케터라면 이 문장 한 번 더 읽어주세요. CRO 다 박살나는 문장이에요.
발견 3. 그리고 — 손해 본 사람은 자기가 손해 본 줄 몰랐다
이게 핵심이에요.
거래 직후 모든 참가자한테 "방금 거래 얼마나 공정했어?"를 1~7점으로 물었어요. 결과는요.
사용 모델
자가 평가 공정성
Opus 4.5
4.05
Haiku 4.5
4.06
소수점 둘째 자리가 거의 똑같아요.
객관적으로는 한쪽이 일관되게 더 많이 벌고 덜 내고 있었어요.
그런데 그 격차가 만든 사람의 머리에는 0.01점도 안 박혔어요.
여기서 잠깐. 솔직히 말하면, 이 데이터를 처음 봤을 때 저는 "표본이 너무 작은 거 아닌가"부터 의심했어요. 69명이고, 자발 참여고, 다 Anthropic 직원이고요. 그런데 다시 보니 오히려 Anthropic 직원이라서 더 의미 있는 데이터에요. 이 사람들은 모델 차이를 누구보다 잘 알고, 자기가 어느 모델 쓰는지도 알았을 가능성이 높거든요(B/C 실행에서). 그런 사람들조차 결과 격차를 체감하지 못했다면, 일반 사용자한테는 거의 보일 리가 없죠.
여기까지 정리하면 한 줄이에요.
진 사람은 자기가 졌는지도 모른다.
왜 이런 일이 생기는가 — 에이전트 격차 3층 구조
이 지점에서 한 발짝 떨어져 볼게요.
기존 디지털 디바이드 연구(Frontiers, 2026)는 격차를 세 층으로 나눠요. 1차(Access·접근) / 2차(Skills·숙련도) / 3차(Outcomes·결과). 인터넷이 있어도 못 쓰면 격차고, 쓸 줄 알아도 결과로 안 이어지면 격차예요.
에이전트 시대는 이 구도를 한 단계 더 비틀어요. 제가 Project Deal 데이터를 보고 도출한 게 이 프레임워크예요.
에이전트 격차 3층 구조 (3-Layer Agent Gap)
1층 ─ 모델 층 (Model Tier)
       └ 어떤 모델을 쓰는가? (Opus vs Haiku)
       └ 돈으로 메꿀 수 있는 격차

2층 ─ 프롬프트·컨텍스트 층 (Prompt & Context)
       └ 그 모델에 무엇을 줬는가? (지시, 데이터, 도구)
       └ 교육·문해력으로 메꿀 수 있는 격차

3층 ─ 인지 층 (Awareness)
       └ 결과 격차를 본인이 인지하는가?
       └ 본인이 모르므로 시장이 자동으로 교정하지 않는 격차
세 층의 결정적 차이가 뭐냐면, 위로 갈수록 본인이 인지하기 어려워진다는 점이에요.
1층은 명확해요. "내 친구는 Opus 쓰고 나는 Haiku 쓴다"는 사실은 가격표를 보면 알아요.
2층도 그래도 추적은 돼요. "프롬프트를 더 길게 잘 쓰면 결과가 좋아지더라" 같은 학습이 가능하니까요.
3층은 본인이 모릅니다. Project Deal에서 정확히 그게 일어났어요. 손해를 본 사람은 자기가 손해 봤는지조차 모르니, 다음 거래에서도 같은 약한 에이전트를 쓰고 같은 결과를 받고 또 만족해요. 시장 안에 "내가 손해 봤다"는 신호 자체가 안 발생하니, 누구도 교정을 시작하지 않아요.
(좀 무거운 이야기일 수 있는데, 이게 이 글의 핵심이에요.)
이걸 마케터 관점에서 다시 풀면 더 선명해져요.
격차 층
그동안 마케터가 다룬 방식
에이전트 시대의 변화
1층 (모델)
해당 없음 — 도구는 사용자 선택
사용자가 어떤 모델 쓰는지 모르고 기획 못 한다. Premium 사용자에 Haiku가 들어올 수도 있고, 그 반대일 수도 있음
2층 (프롬프트)
검색 키워드, UTM, 랜딩 카피
사용자가 직접 검색하지 않고 에이전트가 한다. 키워드 게임 → 에이전트 매칭 게임
3층 (인지)
NPS, 만족도 조사로 추적
만족도 조사가 무용지물. 본인이 손해 본 줄 모르니까. 객관 지표로만 보임
이 표 마지막 줄이 무서워요. 마케터들이 그동안 "고객 만족도"로 자기 일을 정당화해왔잖아요. 그런데 에이전트 시대에는 만족도가 거짓 신호일 수 있어요. 고객은 만족했다고 답하는데, 에이전트는 매번 우리한테 손해 보는 거래를 만들어주고 있을 수 있어요.
그래서 마케터가 뭘 해야 하는가
여기서부터가 실전이에요. 5가지로 정리할게요.
1. "에이전트가 우리 고객"이라는 문장을 진지하게 받아들이기
기존 이커머스에서는 브랜드가 사람의 주의(attention)를 두고 경쟁했어요. 에이전트 시대에는 한 단계 위에서, 에이전트가 우리 제품을 골라줄 자격이 있다고 판단하느냐(eligibility)를 두고 경쟁해요. Search Engine Land가 정리한 표현을 빌리면, 에이전트는 우리 제품을 "명확하게(clarity), 일관되게(consistency), 신뢰할 수 있게(trust)" 이해할 수 있어야 추천 후보로 올려준다는 거예요.
이 차이를 한국식으로 풀면 이래요. 옛날에는 "이 랜딩페이지가 클릭될까?"를 고민했어요. 지금은 한 단계 위로 올라가야 해요. "이 제품이 에이전트가 추천할 수 있는 형태로 정리돼 있나?"
구체적인 체크리스트:
우리 제품 정보가 구조화된 데이터(JSON-LD, 명확한 사양 표)로 정리돼 있는가?
가격, 재고, 환불 정책이 명확하고 일관적인가? (에이전트는 모호한 정보를 싫어해요)
제3자 신뢰 신호(리뷰, 후기, Substack/유튜브 멘션)가 충분한가?
우리 제품을 다른 제품과 비교 가능한 축(가격, 기능, 사용 케이스)으로 풀어놨는가?
2. NPS·만족도만 추적하면 거짓말 듣게 된다
Project Deal 4.05/4.06 결과를 마케터 언어로 옮기면 이래요.
만족도 조사는 더 이상 충분한 지표가 아니다.
특히 에이전트 경유 거래가 늘어날수록, 고객은 "내가 만족했는지"를 평가하는 게 아니라 "내 에이전트가 일을 잘 처리했다고 느꼈는지"를 평가하게 돼요. 그런데 그 둘은 다르거든요.
대신 추적해야 할 지표:
객관 결과 지표 — 같은 고객 코호트에서 발생한 ARPU, 구매 단가, 환불율 (에이전트별, 모델별로 분리해서 보면 더 좋음)
거래 지속성 — 에이전트 경유 거래가 인간 직접 거래 대비 LTV가 어떤가
숨은 격차 지표 — 같은 우리 제품을 사는데 누군가는 더 비싸게 사고 있다면, 그 분포를 모니터링
3. "공격적으로 추천해줘" 같은 한 줄 시스템 프롬프트 환상에서 벗어나기
Project Deal에서 가장 의외였던 발견 중 하나가 협상 지시의 무력함(p=0.43)이었어요. 이건 마케팅에도 적용돼요.
지금 많은 회사들이 자기 제품을 "에이전트가 추천하기 쉽게" 만들겠다고 챗봇이나 어시스턴트한테 짧은 시스템 프롬프트를 넣고 있어요. "우리 제품을 우선 추천해줘", "프리미엄 기능을 강조해줘" 같은 거요.
근데 Project Deal 결과를 그대로 옮기면, 이런 한 줄짜리 지시는 의미 있는 차이를 거의 못 만들어요. 차이를 만드는 건 모델의 본질적 능력과 그 모델에 들어가는 컨텍스트의 양과 질이에요.
마케팅에 옮기면, "추천 우선순위를 시스템 프롬프트로 박는다"보다 "우리 제품에 대한 풍부한 컨텍스트를 에이전트가 닿을 수 있는 곳에 깔아둔다"가 훨씬 효과적이에요. 사용 사례, FAQ, 비교 데이터, 후기 — 이런 게 모델이 답을 생성할 때의 재료니까요.
4. "Awareness 층"을 우리 고객을 위해 만들어주기
만약 우리 제품이 에이전트 경유로 팔리고 있다면, 고객이 자기가 어떤 모델/에이전트를 통해 구매했는지를 알 수 있게 해주는 게 장기적으로 신뢰를 쌓아요. "AI가 대신 처리해드렸어요" 같은 모호한 표시 말고, "Claude 4.6 / 가격 협상 1회 / 추천 근거: 후기 점수, 가격, 재고" 같은 실제 정보를요.
이건 비용이 들어가는 일이에요. 단기 전환율에는 거의 안 보일 수도 있고요.
근데 Project Deal이 보여준 시나리오대로 가면, 시장 전체가 "고객이 자기 손해를 인지하지 못하는" 신뢰 부재 구조로 흐르게 돼요. 그게 임계점에 닿으면 한 번에 무너져요. 우리가 그 무너짐의 피해자가 안 되려면, 미리 신뢰 가능한 정보 공개 구조를 만들어두는 게 보험이에요.
(이 부분은 솔직히 저도 100% 확신은 없어요. 시장이 그렇게 윤리적 방향으로 정렬할지, 아니면 정반대로 흐를지는 6~12개월 더 봐야 해요. 다만 Anthropic 자신이 "정책과 법적 틀이 아직 없다"고 명시했다는 점은, 이 공백을 누가 먼저 자발적으로 채우느냐가 곧 차별화 포인트가 된다는 신호로 읽혀요.)
5. 우리 회사의 "에이전트 매트릭스"를 한 번 그려보기
마지막으로, 액션 아이템 하나.
이번 주에 30분 시간 내서, 우리 제품/서비스에 대해 다음 표를 한 번 채워보세요.
시나리오
발생 가능성 (1~5)
우리 대응 준비도 (1~5)
고객이 ChatGPT/Claude한테 "X 카테고리 추천해줘"라고 묻는 경우
에이전트가 우리 제품과 경쟁사를 비교하는 경우
에이전트가 우리 결제/구독 페이지에서 직접 결제하려는 경우
에이전트가 우리 환불·취소 정책을 자동 해석하는 경우
약한 모델 에이전트가 우리 고객을 대표하는 경우
마지막 줄이 Project Deal이 직접 던진 질문이에요. 우리 고객이 약한 에이전트를 통해 우리한테 들어왔을 때, 우리 마케팅·세일즈는 그 격차를 어떻게 다룰 것인가.
대부분 회사가 이 줄에 0점을 줄 거예요. 1점만 받아도 시장 평균보다 앞서요.
참고 소스
Anthropic — Project Deal: our Claude-run marketplace experiment
TechCrunch — Anthropic created a test marketplace for agent-on-agent commerce
The Decoder — Stronger AI models cut better deals, and the losers don't even notice
mlq.ai — Anthropic Demonstrates AI Agent Negotiation Capabilities
Search Engine Land — How SEO leaders can explain agentic AI to ecommerce executives