


graphify는 코드베이스를 AI 코딩 도구가 조회할 수 있는 지식 그래프로 바꾸는 무료 오픈소스 도구입니다. 설치 두 줄이면 클로드 코드·커서·코덱스에서 쓸 수 있습니다. 설치법과 명령어, 그리고 어디서 안 되는지까지 공식 문서와 실측으로 정리했습니다.
3줄 요약
- graphify는 코드베이스를 AI 코딩 도구가 조회할 수 있는 지식 그래프로 바꾸는 무료 오픈소스 도구입니다. Apache-2.0이고 계정 없이 로컬에서 돌아갑니다. 최신 버전은 0.9.38(2026년 8월 9일 릴리스), Python 3.10 이상이 필요합니다.
- 설치는
uv tool install graphifyy두 줄, 실행은/graphify .한 줄입니다. 클로드 코드·커서·코덱스·제미나이 CLI 등 20종 이상에서 쓸 수 있고 코드 언어 36종을 읽습니다. - 노드가 5,000개를 넘으면 그래프 화면이 버겁습니다. 공식 문서가 직접 밝힌 한계이고, 그때부터는
query·path같은 조회 명령을 씁니다.
작성자 — 지피터스에서 마케팅을 하고 있습니다. 개발자는 아니지만 클로드 코드로 매일 도구를 만들어 씁니다. 이 글의 사양은 공식 문서와 GitHub API로 직접 확인했고, 실측 수치는 지피터스 회원이 자기 레포에서 돌린 기록을 인용했습니다.
graphify가 뭔가요?
graphify는 코드베이스와 문서를 AI 코딩 도구가 조회할 수 있는 지식 그래프(Knowledge Graph)로 바꾸는 무료 오픈소스 도구입니다. 프로젝트 폴더에서 명령 하나를 치면 함수·클래스·파일을 노드로, 호출·임포트·참조를 엣지로 만든 지도를 그려줍니다.
AI가 코드를 찾는 방식을 바꾸는 게 핵심입니다. 지금 클로드 코드나 커서는 질문을 받으면 파일을 검색해서 훑습니다. graphify를 붙이면 훑는 대신 미리 그려둔 지도를 따라갑니다.
확인된 기본 사양은 이렇습니다.
- 가격 — 설치해서 쓰는 graphify 자체는 무료입니다. Apache-2.0 오픈소스이고 공식 요금 페이지에도 계정 없이 사용량 제한 없이 쓴다고 적혀 있습니다. 별도로 준비 중인 엔터프라이즈 버전만 얼리액세스 단계이고, 이쪽은 가격이 공개돼 있지 않습니다.
- 최신 버전 — PyPI 기준 0.9.38, 2026년 8월 9일 릴리스입니다.
- 요구 사항 — Python 3.10 이상.
- 동작 위치 — 전부 내 컴퓨터에서 돕니다. 계정도, 텔레메트리도 없습니다.
- 만든 곳 — Graphify Labs. 공식 저장소에 Y Combinator S26 배치 표기가 있습니다.
graphify 공식 사이트 첫 화면 — 지식 그래프를 형상화한 와이어프레임 큐브와 v0.9.38 릴리스 배너
GitHub 저장소는 2026년 4월 3일에 처음 올라왔는데, 8월 10일 현재 스타 104,622개에 포크 10,175개입니다(GitHub API 실측). 4개월 남짓한 기간에 쌓인 숫자입니다.
graphify는 grep이나 벡터 검색과 뭐가 다른가요?
답의 근거를 되짚을 수 있느냐가 갈립니다.
지금 AI 코딩 도구가 코드를 이해하는 방법은 크게 둘입니다. 하나는 grep처럼 문자열을 검색하는 것, 다른 하나는 벡터 임베딩으로 "비슷한 것"을 찾는 것입니다. 둘 다 잘 되지만 공통 약점이 있습니다. 왜 그 파일을 골랐는지 사람이 확인하기 어렵습니다.
graphify는 답을 낼 때 파일명과 줄 번호가 붙은 경로를 같이 내놓습니다. "이 함수를 누가 호출하는가"라고 물으면 추측한 목록이 아니라 실제로 이어진 선을 보여주는 식입니다.
한 가지 더 눈여겨볼 설계가 있습니다. graphify는 모든 관계에 출처 표시를 붙입니다.
- EXTRACTED — 코드 문법을 파싱해서 확정한 관계
- INFERRED — 모델이 추론해서 이은 관계
- AMBIGUOUS — 확정하지 못한 관계
코드 파싱은 tree-sitter라는 구문 분석기가 로컬에서 처리합니다. 여기엔 LLM 호출이 없어서 토큰 비용도 들지 않고, 실행할 때마다 결과가 달라지지도 않습니다. 반대로 PDF·이미지 같은 문서에서 의미를 뽑는 부분은 모델을 씁니다.
공식 저장소에 있는 시연 화면이 이 차이를 잘 보여줍니다. graphify path "FastAPI" "ModelField"라고 물으면, 두 지점이 어떤 관계로 몇 단계 만에 이어지는지를 경로로 되돌려줍니다.
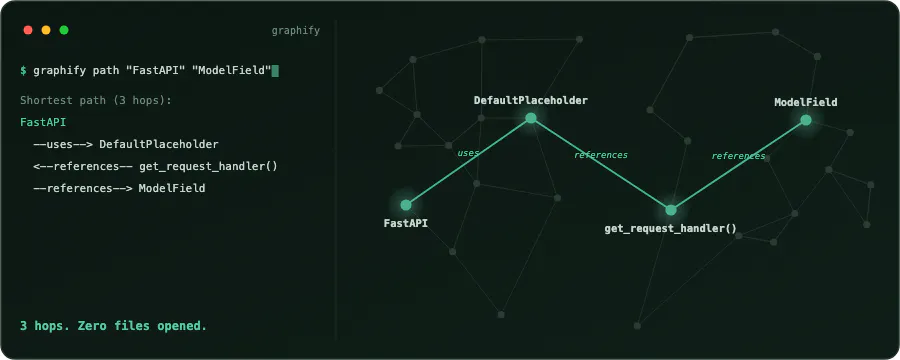
graphify path 명령 실행 화면 — 왼쪽 터미널에 FastAPI에서 ModelField까지 3단계 경로가 uses·references 관계로 표시되고, 오른쪽 그래프에서 해당 경로만 초록색으로 밝게 이어져 있음
하단의 Zero files opened가 핵심입니다. 파일을 한 개도 열지 않고 답이 나옵니다. 출처: Graphify-Labs/graphify (Apache-2.0)
공식 README에는 벤치마크도 실려 있습니다. 장기 기억 평가인 LOCOMO recall@10에서 0.497로, 같은 표에 있는 mem0(0.048)·supermemory(0.149)보다 높게 적혀 있습니다. 다만 이건 개발사가 자기 저장소에 올린 자체 측정치입니다. 제3자가 재현한 결과가 아니라는 점은 감안하고 보시는 게 좋겠습니다.
graphify는 어떤 AI 코딩 도구에서 쓸 수 있나요?
클로드 코드 전용이 아닙니다. PyPI 문서 기준으로 20종 이상의 AI 코딩 어시스턴트를 지원합니다.
주요 지원 목록은 Claude Code, Codex, OpenCode, Cursor, GitHub Copilot CLI, VS Code Copilot Chat, Gemini CLI, Aider, Amp, Kiro, Trae, Kilo Code, Factory Droid, Devin CLI, Google Antigravity, OpenClaw, Hermes, Kimi Code, Pi, CodeBuddy입니다.
읽는 범위도 코드에 한정되지 않습니다. 코드 언어 36종에 더해 마크다운·PDF·오피스 문서·SQL 스키마를 읽고, 라이브 PostgreSQL에도 붙습니다. 코드 쪽은 파이썬·자바스크립트·타입스크립트·Go·러스트·자바·C·C++·루비·C#·코틀린·스위프트·PHP 등이 들어 있습니다.
윈도우·맥·리눅스에서 모두 돕니다.
graphify 설치와 사용법
설치는 두 줄입니다.
uv tool install graphifyy
graphify install
패키지 이름이 graphifyy로 y가 두 개입니다. 명령어는 graphify로 하나입니다. uv 대신 pipx를 써도 됩니다.
터미널 명령이 익숙하지 않으시면 CLI 뜻과 터미널·셸 차이를 먼저 보시면 됩니다. graphify는 클로드 코드에 스킬로 붙는 방식이라, 클로드 스킬 추천 3개에서 스킬이 어떻게 동작하는지 보고 오셔도 좋습니다.
그다음 프로젝트 폴더에서 AI 코딩 도구를 열고 이렇게 칩니다.
/graphify .
끝나면 graphify-out/ 폴더에 결과물 세 개가 생깁니다.
- graph.html — 브라우저로 여는 대화형 그래프
- GRAPH_REPORT.md — 핵심 개념과 연결을 정리한 보고서
- graph.json — 조회용 원본 데이터
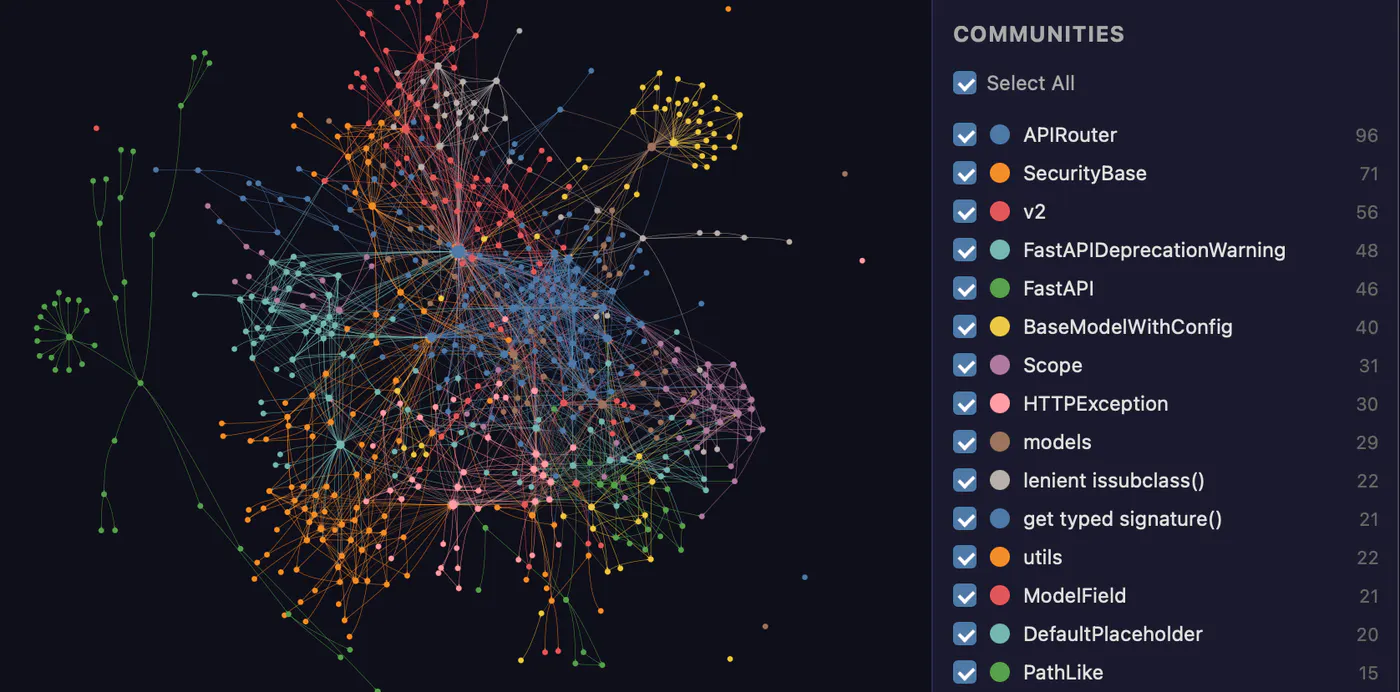
graphify가 만든 graph.html 실제 화면 — 왼쪽은 색깔별로 묶인 노드와 엣지 그래프, 오른쪽은 APIRouter 96개·SecurityBase 71개처럼 클러스터마다 몇 개의 노드가 묶였는지 보여주는 목록
오른쪽 목록이 클러스터입니다. 관련된 코드끼리 자동으로 묶여서, 어느 덩어리가 큰지 한눈에 보입니다. 출처: Graphify-Labs/graphify (Apache-2.0)
이후 쓰는 명령어는 다섯 가지입니다.
graphify query "질문"— 그래프에 질문하기graphify path A B— 두 지점 사이 연결 추적graphify explain X— 특정 노드 설명graphify prs— PR 리뷰 분석/graphify . --watch— 코드가 바뀔 때 그래프 자동 갱신
MCP 서버로도 띄울 수 있습니다. python -m graphify.serve graph.json을 실행하면 그래프 조회 도구 10종이 MCP로 열립니다.
graphify를 실제로 돌려본 결과는 어땠나요?
지피터스 회원이 자사 서비스 레포 3개(portal·study·renewal)에 실제로 돌린 기록이 커뮤니티에 올라와 있습니다. 공개된 실측치는 이렇습니다.
- 분석한 파일 1,643개, 단어 약 152만 개
- 만들어진 노드 4,942개, 엣지 9,235개, 클러스터 166개
- 실행 시간 약 1분, 토큰 비용 0원
숫자보다 눈에 띈 건 그래프가 잡아낸 것들이었습니다. 따로 논의되던 출시 차단 이슈 5건이 사실 한 묶음이었다는 점, Product 모델이 없어서 기능 4개가 동시에 막혀 있었다는 점, 서로 다른 두 레포에 같은 미들웨어가 중복돼 있었다는 점이 나왔습니다. 연결이 50개로 가장 많은 AuthService가 위험 지점으로 표시되기도 했습니다.
이 글에서 클로드 코드의 토큰 효율이 71.5배 개선됐다는 수치도 함께 제시됐는데, 작성자가 자기 환경에서 잰 값입니다. 공식 문서에서는 같은 수치를 찾지 못했으니 일반적인 성능 수치로 옮기지는 마세요.
자세한 과정과 실제 그래프 화면은 원문에 있습니다. → GPTers 3개 레포 152만 단어를 하루 만에 정리한 이야기
graphify가 안 되는 곳은 어디인가요?
공식 README가 스스로 밝힌 제약이 셋 있습니다. 이걸 모르고 큰 레포에 돌리면 첫 실행에서 막힙니다.
- 노드 5,000개가 넘으면 HTML 그래프가 버겁습니다. 공식 문서도 이 경우 HTML을 건너뛰고 JSON을 직접 조회하라고 안내합니다. 앞의 지피터스 사례가 4,942개였으니, 레포 서너 개 규모면 곧 이 선에 닿습니다.
- 기본 용량 상한이 512MiB입니다. 큰 코퍼스는 넘길 수 있고,
GRAPHIFY_MAX_GRAPH_BYTES환경변수로 조정합니다. - 문서·PDF에서 의미를 뽑으려면 별도 설정이 필요합니다. 코드만 읽는 건 API 키 없이 되지만, 멀티모달 추출은 백엔드를 붙여야 합니다.
여기에 하나 더 있습니다. INFERRED와 AMBIGUOUS로 표시된 관계는 모델이 이어붙인 추측입니다. 태그를 달아주는 설계 자체는 정직하지만, 그 태그를 무시하고 전부 사실로 읽으면 소용이 없습니다.
graphify 자주 묻는 질문
graphify는 무료인가요?
설치해서 쓰는 graphify 자체는 무료입니다. Apache-2.0 오픈소스로 공개돼 있고 계정이나 API 키 없이 로컬에서 돌아갑니다. 별도로 준비 중인 엔터프라이즈 버전은 얼리액세스 단계이며 가격이 공개돼 있지 않습니다.
비개발자도 쓸 수 있나요?
설치와 실행 자체는 명령 두 줄이라 어렵지 않습니다. 다만 나오는 결과물이 함수·클래스·의존성 지도라서, 읽을 대상이 없으면 쓸 일도 없습니다. 클로드 코드로 이미 자기 도구를 만들어 쓰고 있고 코드가 여러 파일로 늘어난 시점이라면 그때 의미가 생깁니다.
한국어 문서나 PDF도 읽나요?
마크다운·PDF·오피스 문서를 읽는 기능이 있습니다. 다만 문서에서 의미를 뽑는 단계는 코드 파싱과 달리 모델을 쓰기 때문에 별도 백엔드 설정이 필요하고, 한국어 문서에서의 정확도는 공식 문서에 따로 명시돼 있지 않습니다.
설치할 때 자꾸 패키지를 못 찾는다고 나옵니다
패키지 이름과 명령어 이름이 다릅니다. 설치는 graphifyy로 y가 두 개, 실행 명령은 graphify로 하나입니다. Python 3.10 이상인지도 함께 확인해 보세요.
클로드 코드의 메모리 기능과 뭐가 다른가요?
클로드 코드가 기억하는 것은 대화와 지시사항이고, graphify가 만드는 것은 코드 구조 자체의 지도입니다. 그래서 대화가 바뀌거나 세션이 끊겨도 그래프는 남아 있고, 코드가 바뀌면 --watch로 갱신합니다.
클로드 코드 스킬을 늘리는 다른 방법도 있나요?
스킬을 직접 만들거나 플러그인으로 한 번에 여러 개를 붙이는 방법이 있습니다. 플러그인 쪽은 슈퍼파워스를 반나절 써본 기록에 설치부터 실제로 뭘 얻었는지까지 정리해 뒀습니다.
인사이트
이 도구에서 가장 눈에 띄는 설계는 엣지마다 EXTRACTED와 INFERRED를 나눠 적는다는 점입니다.
AI 도구를 쓰다 보면 답이 틀린 것보다 곤란한 상황이 있습니다. 확인한 것과 추측한 것이 같은 말투로 섞여 나오는 경우입니다. 저도 마케팅 지표를 AI 에이전트에 붙이면서 같은 문제를 만났습니다. 관측된 숫자와 지어낸 원인이 한 문장에 붙어 나오면, 매일 읽는 사람은 그 둘을 구분하지 못한 채 판단 기준으로 삼게 됩니다.
graphify가 엣지마다 출처 태그를 붙이는 건 그 구분을 도구 차원에서 강제하는 방식입니다. 정확도를 높이는 것과는 다른 접근인데, 실무에서는 이쪽이 더 오래 쓰이는 조건 같습니다. 틀릴 수 있다는 걸 전제하고 어디가 틀릴 수 있는지 표시해두는 쪽이요.
다만 지피터스 회원 사례에서 노드가 이미 4,942개였다는 점은 짚어둘 만합니다. 공식 문서가 말하는 HTML 한계선이 5,000개니까, 실무 규모에서는 예쁜 그래프 화면보다 query와 path 같은 조회 명령이 주력이 될 가능성이 큽니다. 처음 돌려보고 "그림이 복잡해서 못 보겠다"로 끝내면 정작 쓸모 있는 부분을 안 쓰게 됩니다.
지피터스에는 클로드 코드로 뭘 만들다 막힌 이야기가 자주 올라옵니다. graphify 써보신 분 있으면 후기 남겨주세요. 레포가 어느 정도 커졌을 때부터 쓸 만해지던가요? 그게 제일 궁금합니다.
확인일: 2026년 8월 10일 원문: graphify.com · GitHub — Graphify-Labs/graphify · PyPI — graphifyy