3D 모델링 적재 시뮬레이션 - 휴리스틱 vs RL (강화학습)
2026.06.10
소개
이번 22기의 목표는 3D 모델링 적재 시뮬레이션을 위한 여러 접근법을 탐구하고 있습니다.
리서치를 위한 하네스를 만들고 그것을 이용해서 Tech Reasearch를 진행한 결과 두가지 방향이 나왔습니다.
3D 모델링 시뮬레이션의 리서치 접근 2가지
1.지금까지 경과
1. 휴리스틱 / 최적화 기반 접근 ( Rule Based 접근)
장점은 구현 가능성이 높고, 제약을 직접 통제하기 쉽다는 점입니다. 예를 들어 충돌 검사, 지지면, 중심 안정성, 회전 후보, 상자 경계 조건 등을 명시적으로 넣을 수 있습니다.
단점은 좋은 규칙과 점수 함수를 사람이 설계해야 한다는 점입니다. 복잡한 비정형 형상에서는 후보 배치 수가 급격히 많아져 탐색 비용이 커질 수 있습니다.
2. ML / RL 기반 접근
장점은 반복 경험을 통해 복잡한 배치 패턴, 물리적으로 가능한 행동, 좋은 후보 선택 전략을 학습할 수 있다는 점입니다. 특히 온라인 적재처럼 물체가 순차적으로 들어오는 상황에 강합니다.
단점은 초기 비용이 큽니다. 시뮬레이터, 학습 환경, 보상 함수, 데이터셋, 벤치마크가 필요하고, 결과를 해석하거나 통제하기가 휴리스틱보다 어렵습니다.
3.휴리스틱 vs ML/RL 방식 비교
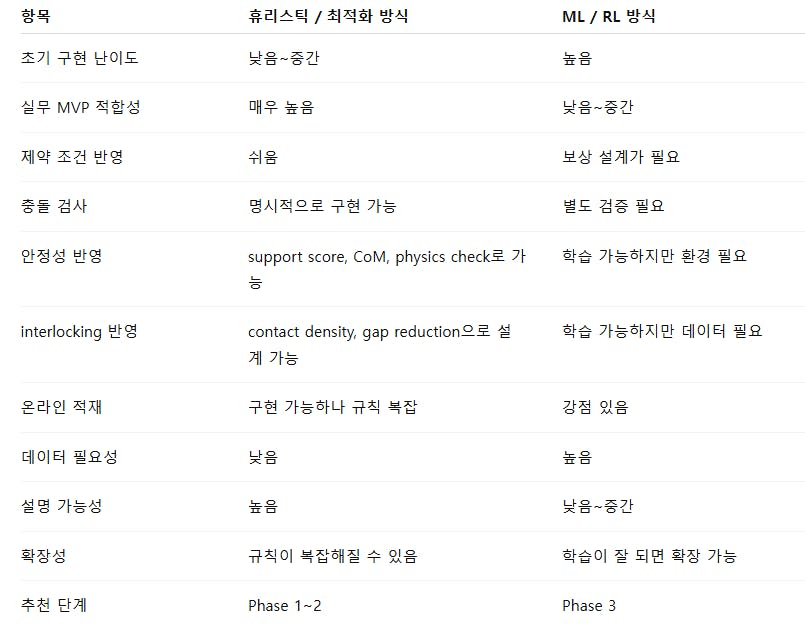
1번의 방법은 이미 전에도 한땀씩 구축해 보았던 것이었고,
2번도 이번 참에 한번 들어가 볼까 했습니다.
2. ML/RL 시도
1. Unity ML-Agents 구현시도.
- 예시로 나온 예제는 코드를 돌려볼 수는 있었습니다.
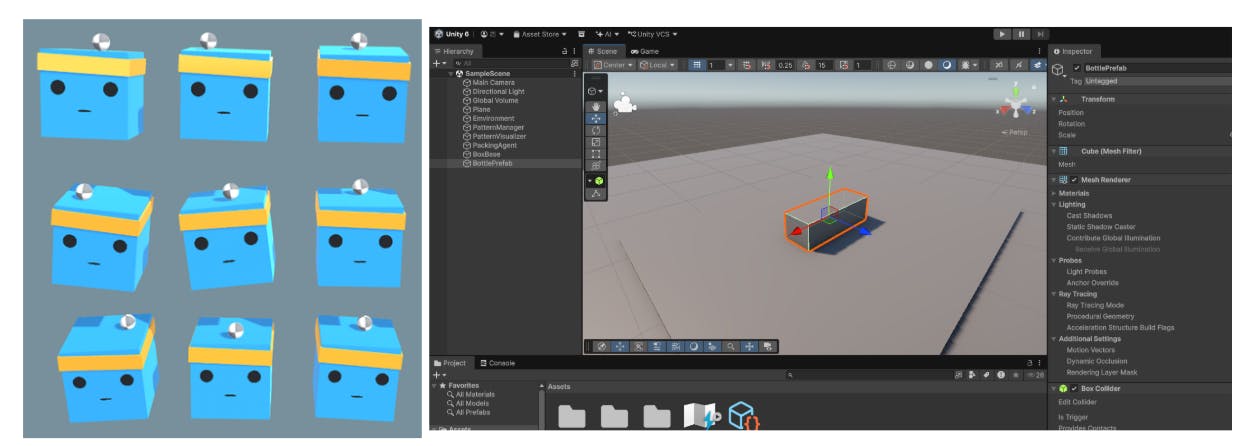
그러나 막상 내가 원하는 Case를 구현하려니, Unity에서 강화 학습을 위한 환경 설정들 Cube를 만들고 세팅하고, 코드를 어떻게 작성해야 할지 쉽지가 않았음.
Learning Curve가 상당해서 이걸 세팅하고 설정하는 것 부터 시간 소요가 많을 듯 해서, 좌절하고
아쉽지만 다음 기회를 기약하기로 했습니다.
결정적 질문: 이 문제가 정말 RL 문제인가?
환경 커스터마이징이 어려워지면서 더 중요한 질문이 생겼다.
> 우리가 풀려는 문제는 정말 RL 문제인가?
질문을 바꿔 문제를 다시 보니, 내 과업의 조건은 대부분 고정되어 있었다.
용기는 1종이고, 상자 크기도 정해져 있다.
원하는 적재 형태가 이미 어느 정도 명확하다.
목표는 실시간 의사결정이 아니라 오프라인 배치 최적화에 가깝다.
이건 "학습해서 발견해야 할 미지의 정책"이 아니라, 이미 아는 기하 제약을 만족하는 배치를 계산하는 문제였다. 그 순간 RL은 핵심 도구의 자리에서 내려왔다.
RL이 더 좋은 문제의 네 가지 신호
첫째, 지금의 선택이 미래를 바꾸고 보상이 나중에 몰려오는 긴 호흡의 의사결정일 때입니다. 한 수 한 수가 끝에 가서야 승패로 드러나는 바둑이나 스타크래프트가 전형이죠. 눈앞만 보는 탐욕적 선택으로는 안 되고, 앞을 내다보며 "공을 들이는" 전략이 필요할 때 RL의 보상 누적 학습이 빛납니다.
둘째, 사람이 정답 규칙을 못 쓰는데, 결과는 점수로 평가할 수 있을 때입니다. 다리 두 개로 걷는 로봇의 관절 제어나 접촉이 많은 손동작은 물리가 너무 복잡해 손으로 규칙을 못 짭니다. 대신 "넘어졌나/앞으로 갔나"는 평가할 수 있죠. RL은 바로 이 교환을 합니다 — "정책은 못 쓰겠으니, 보상만 정의하고 시행착오로 정책을 찾자."
셋째, 환경이 불확실하고 계속 변해, 예상 못 한 상황에 실시간으로 대응해야 할 때입니다.
넷째, 현실적 전제로 값싼 시뮬레이터(혹은 값싼 실제 시도)가 있어야 합니다. RL은 수백만 번의 시행을 먹는 도구라, 좋은 시뮬레이터가 없으면 그림의 떡입니다.
같은 적재 분야에서도 대비가 선명합니다. 물건이 어떤 순서로 들어올지 모른 채 하나씩 도착하고, 미래를 못 보면서 지금 당장 자리를 정해야 하는 "온라인 적재"(IR-BPP 같은 연구)는 RL이 진짜 잘 맞습니다. 미래가 불확실하고, 좋은 규칙을 못 쓰겠고, 시뮬레이션은 싸니까요.
그래서 이문제 는 왜 RL까지 안 가도 되나
당신 문제를 이 기준에 대보면 거의 모든 칸이 반대쪽을 가리킵니다.
오프라인·고정: 용기 1종, 상자 규격 고정, 원하는 형태도 명확. 학습으로 적응할 "변하는 미래"가 없습니다.
규칙으로 쓸 수 있음: 눕히기, 양쪽 캡, 엇갈림 — 전부 문장으로 받아쓸 수 있는 규칙이었죠. RL의 핵심 교환("못 쓰는 정책을 학습으로 발견")이 살 게 없습니다. 이미 아는 규칙을 굳이 비싸게 재발견시키는 셈이고, 게다가 그 규칙 지식을 다시 보상으로 번역해 넣어야 하니 일이 더 늘어요.
보상이 사실은 계산 가능한 점수: 밀도·겹침 없음·안정성은 후보 배치마다 직접 점수로 매길 수 있습니다. 점수를 매길 수 있으면 후보를 직접 탐색·최적화하면 됩니다(휴리스틱 + 로컬 서치 + 충돌검사). 게다가 후보 공간도 작고 구조적이라(회전 몇 가지, 격자 피치, 패턴 몇 종) 굳이 학습으로 헤맬 이유가 없습니다.
검증·설명이 중요: 제조·포장은 결정론적이고 설명 가능한 배치를 원합니다. RL의 블랙박스 정책 + 시뮬레이터 + 학습 비용은 회수가 안 됩니다.
휴리스틱 기반으로 PRD를 작성해서 앱 만들기
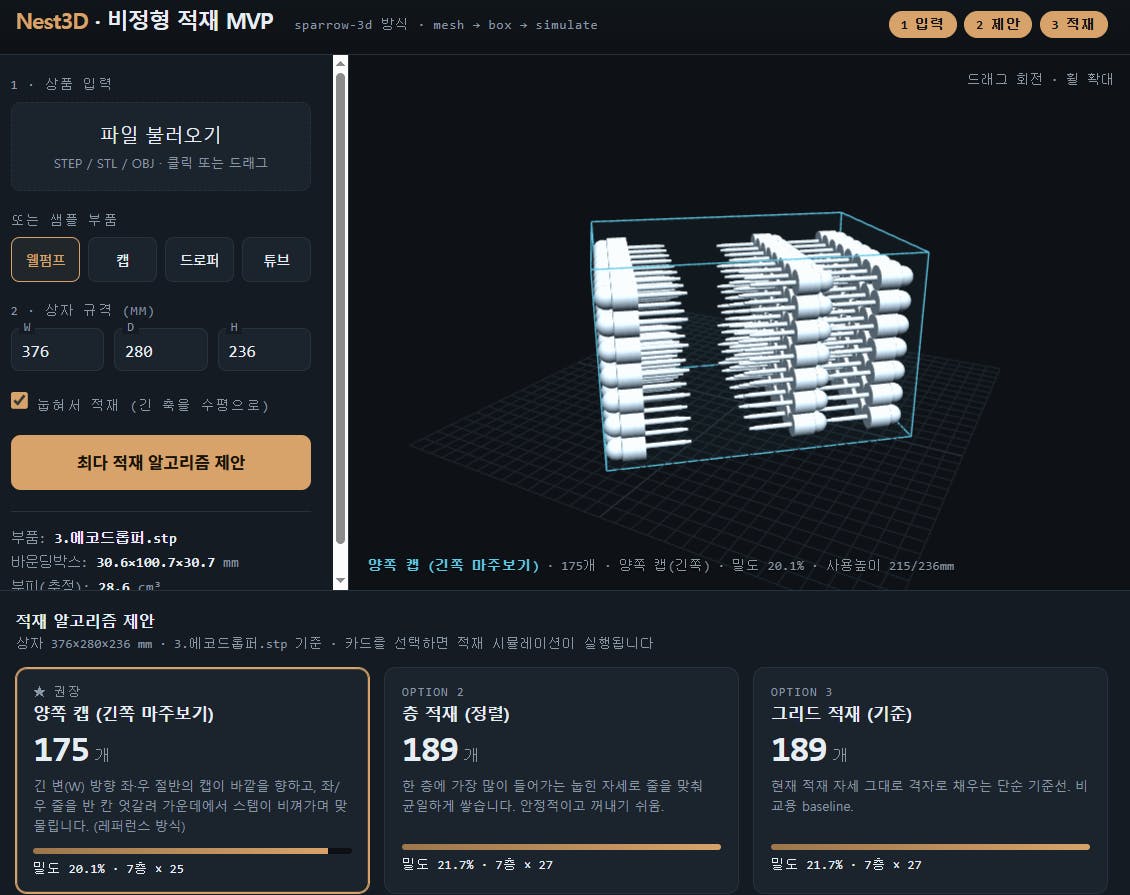
하면서 느낀점
첫째, 도구가 아니라 문제의 성격이 먼저다. "RL을 써야지"로 출발했을 때 과업은 불필요하게 어려워졌다. "이게 무슨 문제지?"로 출발하자 답이 단순해졌다. 도구를 먼저 고르면, 문제를 도구에 맞추느라 힘이 빠진다.
둘째, 규칙으로 쓸 수 있는 건 규칙으로 푼다. 학습은 미지(未知)를 위한 무기다. 이미 아는 제약과 선호를 비싸게 재발견시키는 도구가 아니다. 명확한 기하 제약이 있는 문제에선 최적화와 휴리스틱이 더 빠르고 더 정직하다.
셋째, 리서치에서 부터 앱생성까지 한번에 간다. 기술적 내용을 기반으로 선택가능한 옵션을 모두 도출해보고, 해당 내용에 대한 의사결정의 이유를 좀 더 명확히 알 수 있었다.
참고내용
IR-BPP: Irregular Bin Packing, Learning Physically Realizable Skills for Online Packing of General 3D Shapes
HAPE3D : Human Pose Estimation
ML-Agents: Unity ML-Agents Toolkit

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


Unity ML-Agents 설정 비용에서 막히고 나서 "이게 정말 RL 문제인가?" 질문으로 방향을 틀어버린 순간이 글 전체의 하이라이트예요. 용기 1종·상자 규격 고정·오프라인 배치라는 조건을 RL이 잘 맞는 4가지 기준에 대입해서 스스로 반박하신 분석이 탄탄합니다.
온라인 적재(IR-BPP)는 RL 적합, 오프라인 고정 문제는 RL 불필요 — 이 대비 구도가 명확해서 같은 고민을 하시는 분들께 실질적인 판단 기준이 될 것 같아요. 다음 기수에서 RL 도전편도 나오면 좋겠네요!