팀 위키에 '뇌'를 달다 — gbrain으로 LLM 위키 검색 레이어 만들기 (1편)
2026.08.04
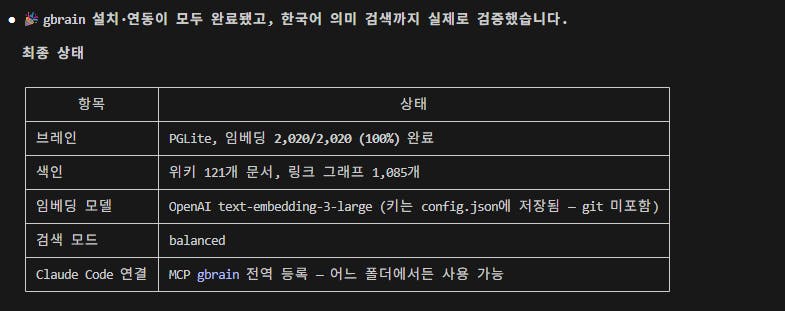
소개
시도하고자 했던 것과 그 이유
저희 팀은 사내 프로젝트의 기획서·회의록·피드백을 마크다운 위키(GitHub 저장소)로 관리하고 있습니다. 현재 문서 146개, 본문 분량 약 100만 토큰(2MB+)인데, Claude Code가 이 위키에서 답을 찾는 방식은 여전히 원시적입니다.
키워드 검색(Grep) — 글자가 정확히 일치해야만 찾습니다. 같은 기능을 문서마다 다른 이름으로 부르면 그대로 놓칩니다.
파일 통째로 읽기 — 기획서 한 편이 수천~수만 토큰인데 여러 편을 다 읽습니다. 질문 1건에 수만 토큰이 소모됩니다.
세션마다 반복 — 세션이 바뀌면 같은 검색을 처음부터 되풀이합니다.
문서가 늘수록 느려지고, 놓치고, 비싸지는 구조입니다. 146개에서도 체감되는데 300~500개가 되면 격차가 훨씬 커질 겁니다.
그래서 Y Combinator CEO Garry Tan이 공개한 오픈소스 gbrain(질문하면 근거를 달아 답하는 '검색 담당 뇌')을 위키 위에 검색·합성 레이어로 얹는 도입을 기획했고, 이번 주에는 팀 설득용 도입 제안 PPT(본편 10장 + 설치·운영 부록 5장)를 만들었습니다. 실제 설치·운영 실습은 다음 주에 이어서 진행합니다.
진행 방법
사용 도구: Claude Code(조사·초안·비용 추정), gbrain(도입 대상, 오픈소스), PowerPoint
제안서를 "왜 필요한가 → 무엇이 달라지나 → 좋은 점 → 팀 영향 → 도입 계획 → 정직한 유의사항 → 결정 요청" 순서로 구성했습니다. 핵심 내용을 풀면 이렇습니다.
1) gbrain이 하는 일 세 가지
기능 | 설명 |
|---|---|
의미 기반 검색 | 표현이 달라도 뜻으로 찾는다. 기능의 별칭·비유적 표현으로 물어도 해당 기획 문서를 잡아낸다 |
지식 그래프 | 문서 사이의 |
합성 답변 + 출처 | 조각이 아닌 완성된 답을 주고, 근거 문서와 '위키에 없는 것(빈틈)'까지 밝힌다 |
[📷 슬라이드 3 캡처 — gbrain이란]
답변 예시가 핵심 차별점을 잘 보여줍니다 (기능명은 가명 처리):
"기능 A는 7월 회의에서 확정. 세부 정책은 미정(기획서 v4 참조). 다만 기능 B 연동은 위키에 아직 결정 기록이 없습니다."
답과 함께 출처가 붙고, 위키에 아직 없는 것(빈틈)까지 알려줍니다. 저희 위키의 '[검증 필요]' 문화와 같은 발상이라 도입 명분이 자연스러웠습니다.
2) 기대 효과 (제안서에 넣은 추정치)
속도·정확도: 검색↔읽기 왕복이 사라져 답이 몇 배 빨리 나오고, 동의어·다른 표현도 의미로 찾아 누락이 줍니다. 개발사가 공개한 벤치마크(영어 문서 240페이지 기준)에서는 "검색 결과 상위 5개 중 정답 문서 비율"이 grep류 키워드 검색은 약 18%, gbrain은 약 49%로 나왔습니다. 검색 5건 중 정답이 1건도 안 되던 게 2~3건으로 늘어난 셈(약 2.8배)입니다. 다만 영어 기준 수치라 한국어 위키에서 실제로 어떤지는 다음 주 실습에서 직접 재볼 예정입니다.
비용: 질문 1건당 토큰이 파일 통읽기 약 30,000 → 색인 조회 약 2,000으로 약 1/10 (실사용 추정치). 최초 색인 비용은 몇백 원 수준의 일회성이고 이후엔 바뀐 파일만 증분 색인이라, 새로 드는 비용을 포함해도 총액은 순감소입니다.
팀 영향 0: gbrain은 위키를 읽어 색인만 만드는 파생 레이어라 원본 마크다운·Git·배포 중인 웹앱·온보딩 모두 그대로입니다. 설치도 제 PC에만 하고, 색인 DB만 지우면 도입 전과 완전히 동일(언제든 원상복구).
[📷 슬라이드 6 캡처 — 토큰 1/10 비교]
3) 도입 계획 4단계
설치 + 위키 임포트 — 내 PC에만 설치, 서버 불필요 (약 30분)
Claude Code 연결 — 명령 한 줄로 MCP 연결, 바로 질문 가능
자동 동기화 — 위키 수정이 몇 분 내 검색에 반영
(옵션) 웹앱 질문창 — 팀원도 '위키에게 질문' (나중 단계)
3단계까지는 팀에 노출되지 않으므로, 부담 없이 시작해서 효과를 보고 4단계를 결정하는 구조로 짰습니다.
4) 설치 명령 (부록에 정리한 것 — 다음 주 실습 예정)
# 1. Bun 런타임 설치 (Node와 비슷한 실행 환경, 5분)
powershell -c "irm bun.sh/install.ps1 | iex"

# 2. gbrain 설치 — ⚠️ npm의 gbrain은 다른 패키지! 반드시 github: 경로로
bun install -g github:garrytan/gbrain

# 3. 브레인 생성 + 위키 임포트 (init 중 임베딩 API 키 질문에 답하면 설정 완료)
gbrain init --pglite
gbrain import D:\team-wiki

# 4. Claude Code 연결 (MCP)
claude mcp add gbrain -- gbrain serve
두 PC(회사·집) 운영 루틴도 부록으로 설계했습니다. 원본은 git이 나르고, 색인은 각 PC가 독립적으로 따라잡는 구조입니다:
# 작업 시작할 때
git pull
gbrain sync --repo D:\team-wiki && gbrain embed --stale

# 작업 마칠 때
git push   # 커밋 규칙은 CLAUDE.md대로
5) 사용 프롬프트 (연결 후 Claude Code에서 이렇게 물을 예정)
브레인에서 기능 A 관련 확정 사항 검색해줘
이 결정을 인용하는 문서 전부 찾아줘        ← 정합 스윕
내일 회의 안건 관련 결정 이력 브리핑해줘
위키에 아직 없는(빈틈) 부분도 같이 알려줘
그리고 CLAUDE.md에 넣을 brain-first 규칙 세 줄:
① 사람·결정·과거 맥락 질문은 답하기 전에 브레인 먼저 검색 ② 새 지식은 마크다운 파일로 기록 후 git ③ 답변에는 출처 문서 명시
[📷 슬라이드 15 캡처 — 일상 사용법]
결과와 배운 점
배운 점 & 꿀팁
혼자 도입하더라도 '도입 근거 문서'를 먼저 만들어두는 게 남는 장사입니다. 누굴 설득하려던 게 아니라, 왜 도입하는지·비용이 얼마나 드는지·문제가 생기면 어떻게 되돌리는지를 시작 전에 스스로 정리해두려고 PPT를 만들었습니다. 만들다 보니 막연했던 부분(토큰 비용 추정, 두 PC 동기화 설계, 원상복구 경로)이 전부 구체화됐고, 2주 시범 운영이 끝났을 때 "계속 쓸지"를 판단할 기준도 미리 생겼습니다. 나중에 팀에 공유하게 되면 그대로 꺼내 쓸 수 있는 건 덤입니다.
'파생 색인 레이어' 개념이 핵심입니다. 지식의 원본(마크다운+git)과 파생물(색인 DB)을 분리하면, 색인은 언제든 재생성 가능하므로 도입 리스크가 사실상 사라집니다. 잘못되면 색인 DB만 지우면 도입 전과 완전히 동일합니다.
보관 위치 규칙: 위키 마크다운·CLAUDE.md 규칙·설치 문서는 git에, gbrain 프로그램·
~/.gbrain(색인 DB + API 키)은 각 PC 로컬에. 특히~/.gbrain을 git이나 클라우드 드라이브에 올리면 바이너리 충돌로 DB 파손 + API 키 유출이 나므로 절대 금지.벤치마크 수치를 그대로 믿지 않기: 자료에 넣은 "검색 상위 5개 중 정답 비율 18% → 49%"는 개발사가 영어 문서 240페이지로 직접 잰 수치입니다. 한국어 위키에서는 다르게 나올 수 있어서, 자료에도 "시범 운영으로 직접 검증"을 명시해뒀습니다. 남의 벤치마크는 인용하되, 내 데이터로 재는 계획을 반드시 붙이는 게 꿀팁입니다.
시행착오
조사 중 발견한 함정: npm에 같은 이름의 무관한
gbrain패키지가 있습니다.npm install -g gbrain하면 엉뚱한 게 깔립니다. 반드시bun install -g github:garrytan/gbrain으로 설치해야 합니다. 부록에 경고로 박아뒀습니다.토큰 비용 추정이 생각보다 까다로웠습니다. 세션 토큰은 크게 줄지만 임베딩(일회성 소액)과 합성 호출(더 싼 모델)이 새로 드는 비용이라, "조회당 30,000 → 2,000"이라는 단순 비교 대신 신규 비용 포함 총액 순감소로 정리했습니다.
capture 같은 브레인 직접 저장 기능을 쓰면 그 PC에만 남아 두 PC 동기화가 깨집니다. "지식은 항상 마크다운 파일로 쓰고 git push, 브레인은 읽기·검색 전용"이라는 규칙으로 해결했습니다.
앞으로의 계획
다음 주에 실습을 이어갑니다:
실제 설치 + 위키 146개 문서 임포트 (목표 30분)
Claude Code MCP 연결 후 브레인 검색으로 동작 확인
한국어 질문으로 grep 방식 vs gbrain 검색 품질·토큰 비교 측정
2주 시범 운영 시작 → 효과 확인 후 팀 공유(웹앱 질문창) 여부 결정
점검 명령 3종(gbrain doctor 상태 진단 / gbrain stats 색인 수 확인 / gbrain query "..." 터미널 직접 질문)도 실습 때 함께 익힐 예정입니다.
도움 받은 글 (옵션)
gbrain 오픈소스 저장소 — Garry Tan(Y Combinator CEO)이 본인 브레인 146,646페이지를 운영 중인 도구
저희 위키의 2층 문서 구조(요약층 + 상세층)와 같은 설계 철학이라는 점이 도입 결정에 큰 참고가 됐습니다

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


설치보다 도입 근거 문서를 먼저 만드신 순서가 이 글에서 가장 값이 큽니다. "혼자 도입하더라도 '도입 근거 문서'를 먼저 만들어두는 게 남는 장사입니다" 라고 쓰셨는데, 설득 대상이 없는 상태에서도 그걸 만든 이유가 명확합니다. 만들면서 토큰 비용 추정과 두 PC 동기화와 원상복구 경로가 구체화됐고, 시범 운영이 끝났을 때 계속 쓸지 판단할 기준이 미리 생겼습니다. 문제 진단도 "문서가 늘수록 느려지고, 놓치고, 비싸지는 구조입니다" 로 세 축을 갈라 적으셔서 무엇이 개선됐는지 나중에 따로 잴 수 있게 돼 있습니다.
남의 수치를 다루신 태도도 같은 계열입니다. 개발사 벤치마크를 인용하면서 "한국어 위키에서 실제로 어떤지는 다음 주 실습에서 직접 재볼 예정입니다" 를 붙이고, "남의 벤치마크는 인용하되, 내 데이터로 재는 계획을 반드시 붙이는 게 꿀팁입니다" 로 원칙까지 정리하셨습니다. 앞선 글에서 자기가 만든 예시로 자기 커버율을 재던 순환을 발견하셨던 것과 같은 규율이 이번에는 바깥으로 향한 셈입니다. 자기 답안지를 못 믿었던 사람이 남의 답안지도 그대로 쓰지 않는 것이라 앞뒤가 맞습니다.
여기에 한 가지를 보태고 싶습니다. 판단 기준이 생겼다고 쓰셨는데, 그 기준의 임계값을 실습 전에 숫자로 적어두시면 좋겠습니다. 지금은 직접 재보겠다는 계획까지 와 있고 무엇이 나오면 계속 쓰고 무엇이 나오면 접을지는 아직 열려 있습니다. 관측 뒤에 임계를 정하면 나온 결과를 설명하는 선이 되기 쉽고, 관측 전에 정하면 결정을 만드는 선이 됩니다. 특히 갈리기 쉬운 국면을 미리 갈라두시면 좋겠습니다. 검색 정확도 쪽에서 개발사 수치가 한국어에서 재현되지 않았을 때도 토큰 비용만으로 도입할 값이 있는지 같은 조건이요. 두 축이 서로 반대 방향으로 나오는 경우가 실제로 흔하고, 그때 기준이 없으면 이미 들인 준비 비용이 판단을 끌고 갑니다.
파생 레이어로 잡으신 설계도 값이 큽니다. "지식의 원본(마크다운+git)과 파생물(색인 DB)을 분리하면, 색인은 언제든 재생성 가능하므로 도입 리스크가 사실상 사라집니다" 와 "잘못되면 색인 DB만 지우면 도입 전과 완전히 동일합니다" 는 도입 결정을 가볍게 만드는 정확한 근거입니다.
그리고 이 성질이 유지되는 조건을 이미 갖고 계신데, 두 규칙이 따로 적혀 있습니다. "지식은 항상 마크다운 파일로 쓰고 git push, 브레인은 읽기·검색 전용" 을 동기화 문제의 해법으로 쓰셨는데, 실은 이 규칙이 원상복구 가능성을 지키는 필수 조건입니다. 색인에만 있고 원본에 없는 지식이 하나라도 쌓이면 색인 DB를 지우는 일이 더는 무해하지 않고, 그 순간 파생 레이어가 원본 레이어로 바뀝니다. 두 PC 동기화보다 이쪽이 더 무거운 이유라서, 규칙 문서에 원상복구를 지키기 위한 조건이라고 함께 적어두시면 나중에 편의를 위해 완화하려는 국면에서 먼저 걸릴 것 같습니다.
비용을 정리하신 방식도 정직합니다. 조회당 토큰만 비교하면 유리한 숫자가 나오는데 임베딩과 합성 호출이 새로 든다는 점을 넣어 "신규 비용 포함 총액 순감소" 로 바꾸셨습니다. 유리한 분모를 고르지 않은 것이라 이 추정치는 나중에 실측과 대조할 수 있습니다. "npm에 같은 이름의 무관한 gbrain 패키지가 있습니다" 를 부록에 경고로 박아두신 것도 같은 자리에서 넘어질 사람을 막는 기록입니다.