AI 데이터 검증 단계: 부동산·주식 데이터 활용
2026.07.27
AI 데이터 검증을 위한 준비 상태
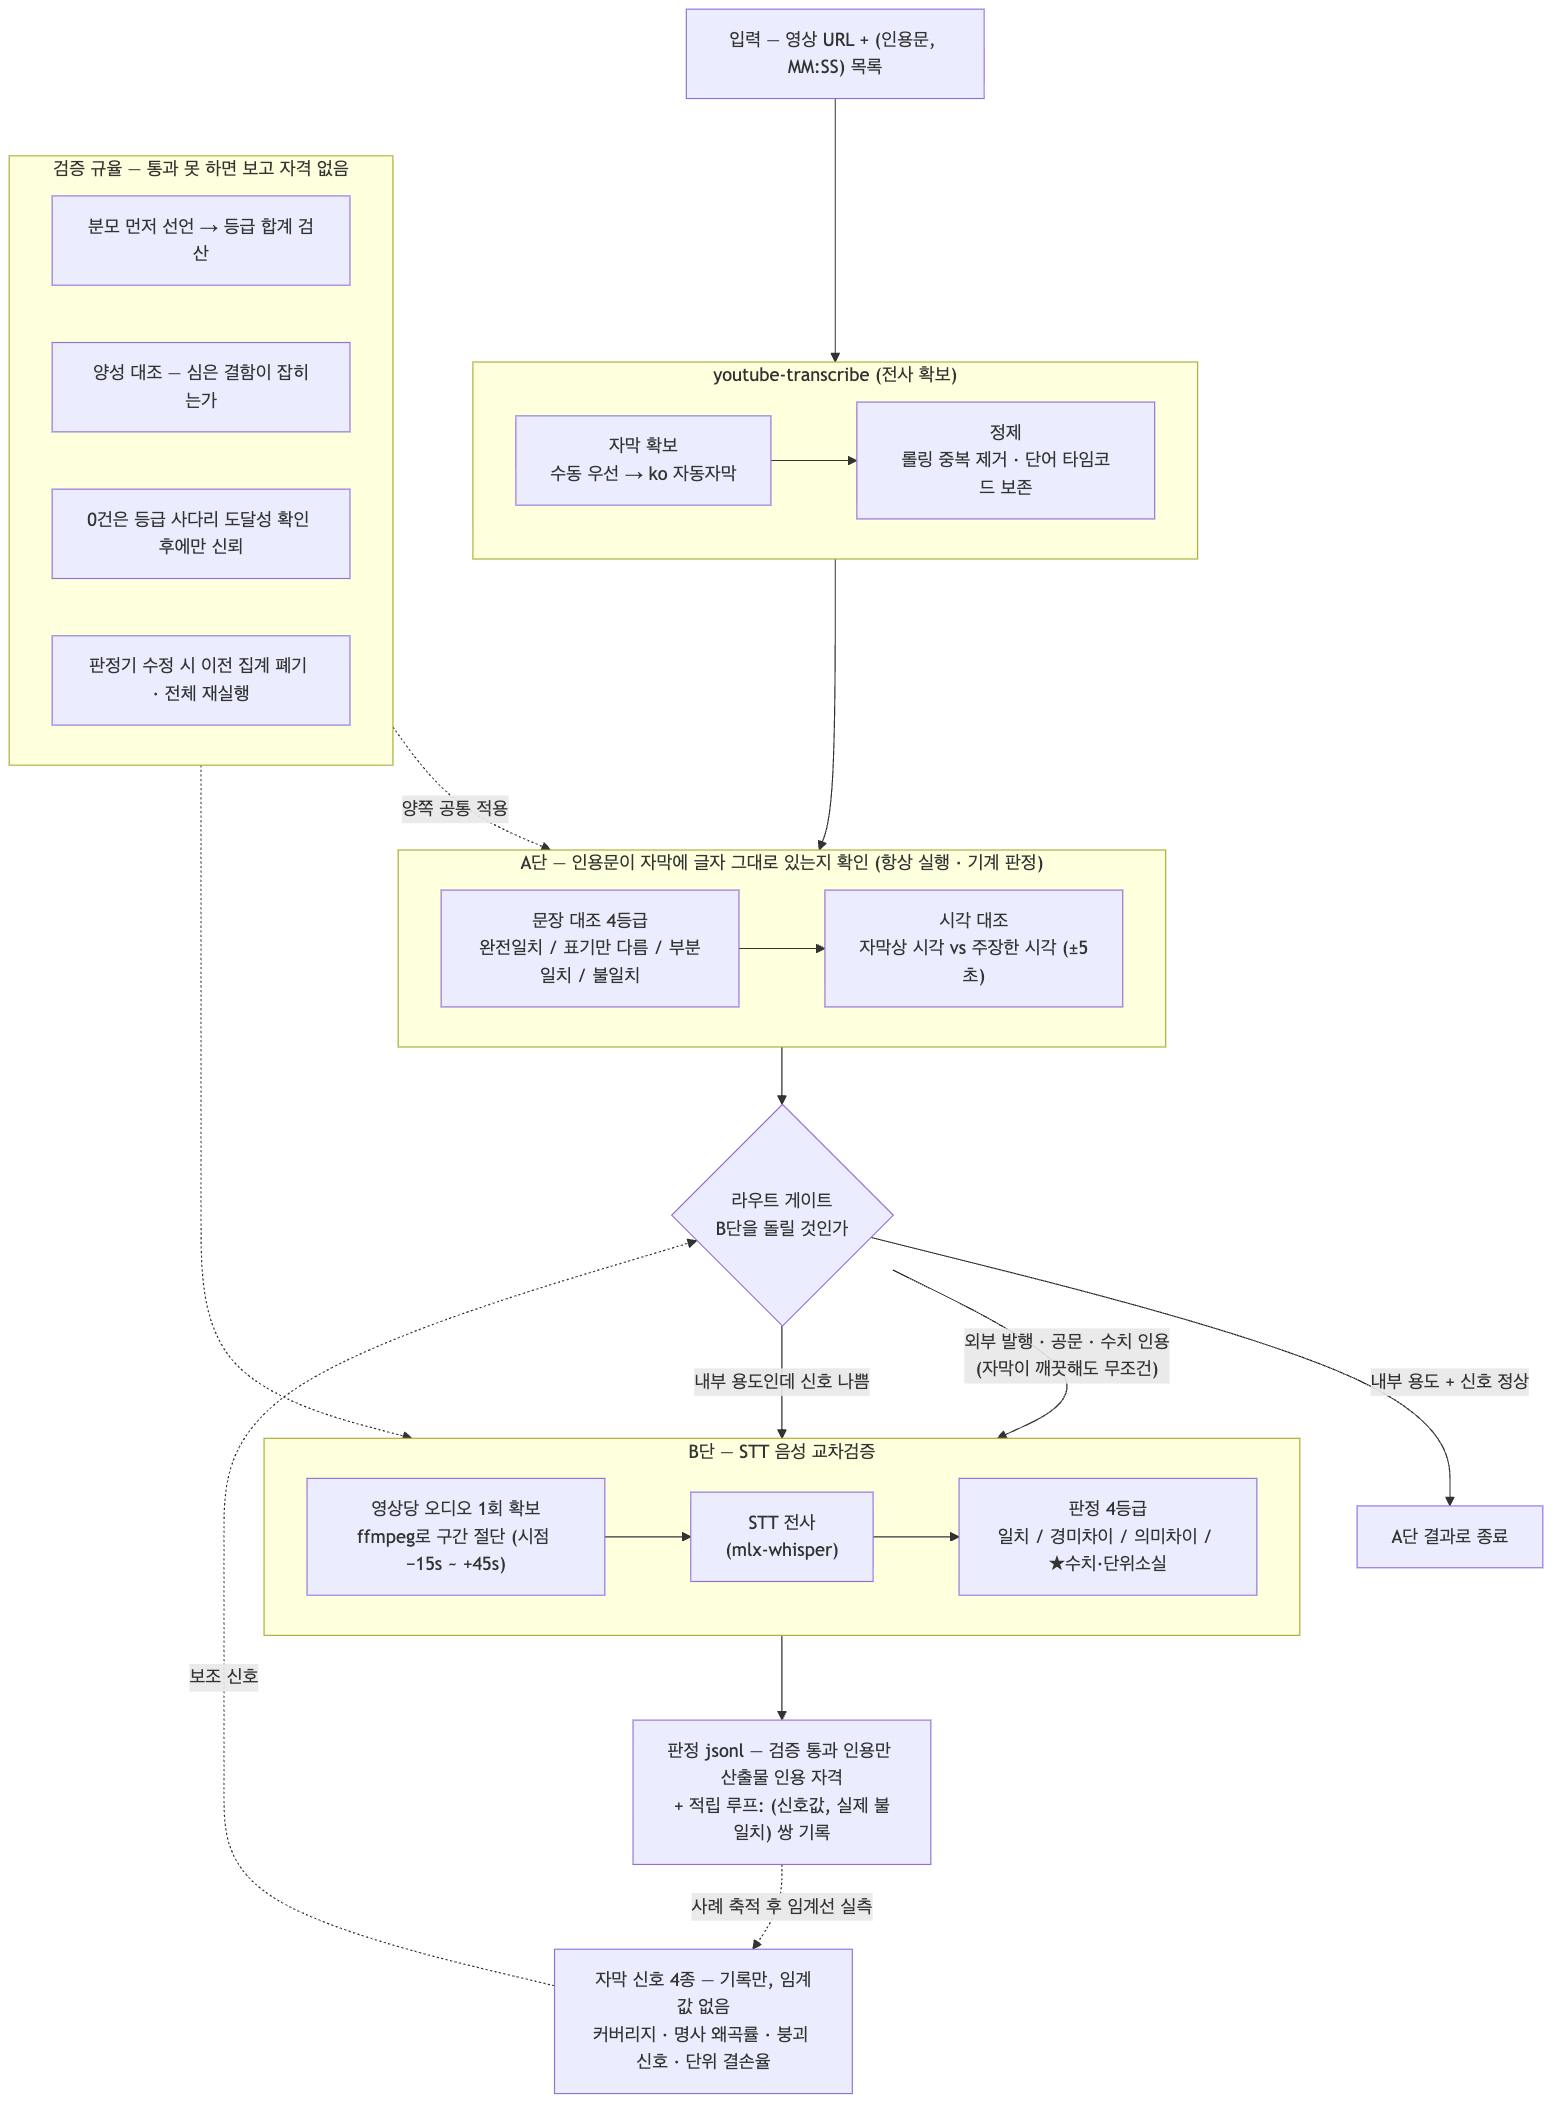
"AI결과물검수" 스터디(청강)를 들으면서, 버디 리토 님의 세법 위키 시연(법조문 원문을 인제스트해두고 AI 답변을 조문 근거와 기계적으로 대조하는 방식)이 인상 깊었지만, 나는 법률 도메인이 없었다. 대신 이미 다른 스터디(데이터·투자·재테크)에서 만들어둔 서울 아파트 실거래가·KB지수·주식 데이터 DuckDB가 있어서, 같은 검증 패턴을 이 데이터에 그대로 적용해보고 싶었다.
해결하고자 하는 문제
"AI가 데이터를 보고 요약/분석 리포트를 써준다"고 할 때, 그 안의 숫자 주장들이 실제로 원본 데이터와 맞는지 사람이 눈으로 일일이 확인하기는 번거롭고 놓치기 쉽다. 이걸 클레임 단위로 쪼개서 기계적으로 자동 대조하는 최소한의 검증 스크립트를 만들어보고 싶었다.
활용한 도구와 방법
Claude Code: 이번 실습은 코드를 직접 짜기보다, "이 스터디가 가르치는 검증 패턴(클레임 분해 → 원본 대조 → 판정)을 내가 가진 부동산·주식 데이터에 적용해줘"라고 요청하고, 실제 탐색 쿼리·
ai_report.md·verify_claims.py·결과 정리는 전부 클로드 코드가 작성 → 대화하며 검토하는 방식으로 진행했다. 이 스터디의 취지(에이전트를 활용해 워크스페이스/검증 파이프라인을 만들어보는 것) 자체가 "혼자 코딩"이 아니라 "에이전트에게 위임"이라 이 방식이 맞다고 판단.
실습 과정과 단계
스터디 1주차 오리엔테이션이 명시한 핵심 실습은 "워크스페이스 → 인제스트 → 일반 분석과 하네스 기반 검수 비교" 세 단계였는데, 처음엔 3번째(비교)를 빼먹고 검증 스크립트만 만들었다가 뒤늦게 채워 넣었다.
이미 갖고 있던
real_estate.duckdb(아파트 매매/전월세 실거래가, KB 매매·전세 가격지수, 삼성전자 등 주가, KOSPI/KOSDAQ)의 스키마와 실제 집계값을 클로드 코드가 먼저 조회.일반 분석 재현 (
general_analysis.md): 각 테이블 앞 5행만 보고 가드레일 없이 답하는 상황을 그대로 재현. "종로구 위주"라는 표본 편향 결론, "며칠간 상승했으니 안정적 상승 국면"이라는 성급한 일반화가 실제로 나왔다."AI가 썼다"고 가정한 하네스 기반 분석 보고서(
ai_report.md)를 클로드 코드가 클레임 5개로 작성. 세법 위키 시연처럼 그중 하나(KB지수 최신값·추세)는 검증이 제대로 작동하는지 보려고 일부러 틀리게 심어달라고 요청.각 클레임을 SQL 쿼리로 원본 전체 데이터(124,136건 등)와 대조하는
verify_claims.py도 클로드 코드가 작성해 Supported/Contradicted로 자동 판정.일반 분석 vs 하네스 기반 검수를 나란히 비교(
comparison.md) — 일반 분석은 표본 편향을 스스로 알아챌 방법이 없고, 하네스 기반은 전체 집계로 즉시 반증된다는 걸 확인.
실습 중 겪은 문제와 해결
실습을 시작하기 전,
uv run python이 전부uv trampoline failed to spawn Python child process (os error 4551)에러로 막혀 있었다. 원인은 Windows의 Smart App Control이uv가 자체적으로 내려받은 서명 없는 파이썬 배포판(및 로컬에서 만드는 빌드도구 실행파일)을 전부 차단하고 있던 것.Smart App Control을 끄는 대신, 이미 설치돼 있던 python.org 정식 3.14로 가상환경을 다시 만들고, 소스 빌드가 필요 없는 최신
pandas버전으로 의존성을 override해서 우회했다. (.python-version을 정식 인터프리터로 고정해서 앞으로는 이 문제가 안 생기게 함)검증 스크립트를 돌려보니, 일부러 틀리게 심은 클레임 외에 의도치 않은 실수 하나도 잡혔다. 클로드가
ai_report.md를 쓰면서 "29억원"이라고 적었는데, 실제로는dealAmount(만원 단위) 환산을 잘못해서 실제 금액은 290억원이었다 — 검증 스크립트가 아니었으면 AI가 만든 보고서의 이 실수를 그냥 사람이 눈으로 못 잡고 넘어갔을 것.
결과물과 배운 점
ai-review-workspace/general_analysis.md(일반 분석 재현),ai_report.md(검증 대상 보고서),verify_claims.py(검증 스크립트),verification_report.md(최종 판정표),comparison.md(둘의 비교) 5개 파일로 완성.5개 클레임 중 3개 Supported, 2개 Contradicted(의도적 1개 + 실수 1개).
가장 크게 느낀 점: "일부러 심어둔 틀린 것만 검증하면 된다"고 생각했는데, 실제로 돌려보니 AI(클로드)가 무심코 저지른 실수까지 똑같이 걸러졌다. 검수 하네스의 진짜 가치는 "AI가 거짓말할 때"보다 오히려 "AI도 사람도 무심코 실수할 때" 더 크게 드러난다는 걸 체감했다 — 그리고 그 AI를 검증하는 스크립트조차 AI(클로드)가 짰다는 점도, 이 스터디가 다루는 "AI로 AI를 검수하기"라는 주제를 그대로 보여준다.
로그인하고 댓글을 남겨 주세요

일부러 심은 오답 말고 의도치 않은 실수 하나가 같이 걸렸다는 대목이 이 글에서 가장 오래 남습니다. 29억으로 적힌 금액이 환산 실수로 열 배인 290억원이었다는 부분이요. 심으려던 함정이 아니라 심으려다 딸려 나온 진짜 실수라는 점이 이 사례의 무게를 만듭니다.
이 실수가 왜 위험한지는 그것이 거짓말이 아니었다는 데 있습니다. 속일 의도가 없었고 산술도 맞았습니다. 잘못된 건 두 숫자가 같은 것을 재고 있다는 전제였고, 그 전제는 문장 어디에도 드러나 있지 않았습니다. 결과 숫자만 보면 완벽하게 그럴듯합니다. 그래서 이런 실수는 성실하게 정독해도 걸러지지 않습니다. 문법이 멀쩡하고 값이 자연스러우면 사람 눈은 그냥 통과시킵니다. 이 글이 "검증 스크립트가 아니었으면 AI가 만든 보고서의 이 실수를 그냥 사람이 눈으로 못 잡고 넘어갔을 것" 이라고 적은 자리가 정확히 그 지점입니다.
옮겨갈 범위는 숫자가 들어가는 모든 산출물입니다. 단위 환산, 시점이 다른 값의 혼합, 출처가 다른 수치의 병합처럼 서술 습관에서 자동으로 나오고 결과가 문법적으로 멀쩡한 자리는 전부 같은 조건에 걸립니다. 다만 조건이 하나 있습니다 — 검사기가 통과만 내놓으면 그게 원래 다 통과시키는 문인지 알 수 없습니다. 그래서 이 글이 일부러 틀린 클레임 하나를 먼저 심어 그게 걸리는지부터 확인한 순서가 결정적입니다. 통과가 먼저 나오는 검사기는 그 통과가 판별의 결과인지 문이 처음부터 열려 있어서인지 구분해주지 못하니까요. 5개 중 2개가 걸렸다는 결과는 그 심어둔 1개가 있어서 비로소 해석이 됩니다.
의도적 오답 하나와 의도치 않은 실수 하나가 같은 방식으로 걸렸다는 비율이, 하네스가 붙어야 할 자리를 조용히 가리킵니다. 검수가 잡아낸 것이 성실함이 아니라 구조라는 걸, 이 두 개의 숫자가 보여준 것 같습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


서울 아파트 실거래가·KB지수·주식 데이터를 이미 갖고 있던 DuckDB에 클레임 분해부터 원본 대조, Supported/Contradicted 판정까지 적용하신 과정이 정말 구체적이고 인상적입니다. 특히 의도적으로 심은 오류뿐 아니라 ‘29억원’과 ‘290억원’의 환산 실수까지 검증 스크립트로 잡아낸 결과에서 이 방식의 실제 효용이 선명하게 드러났어요. 일반 분석과 하네스 기반 검수 결과를 5개 파일로 나란히 남겨 다른 사람도 따라가 볼 수 있게 정리하신 점도 좋았습니다.