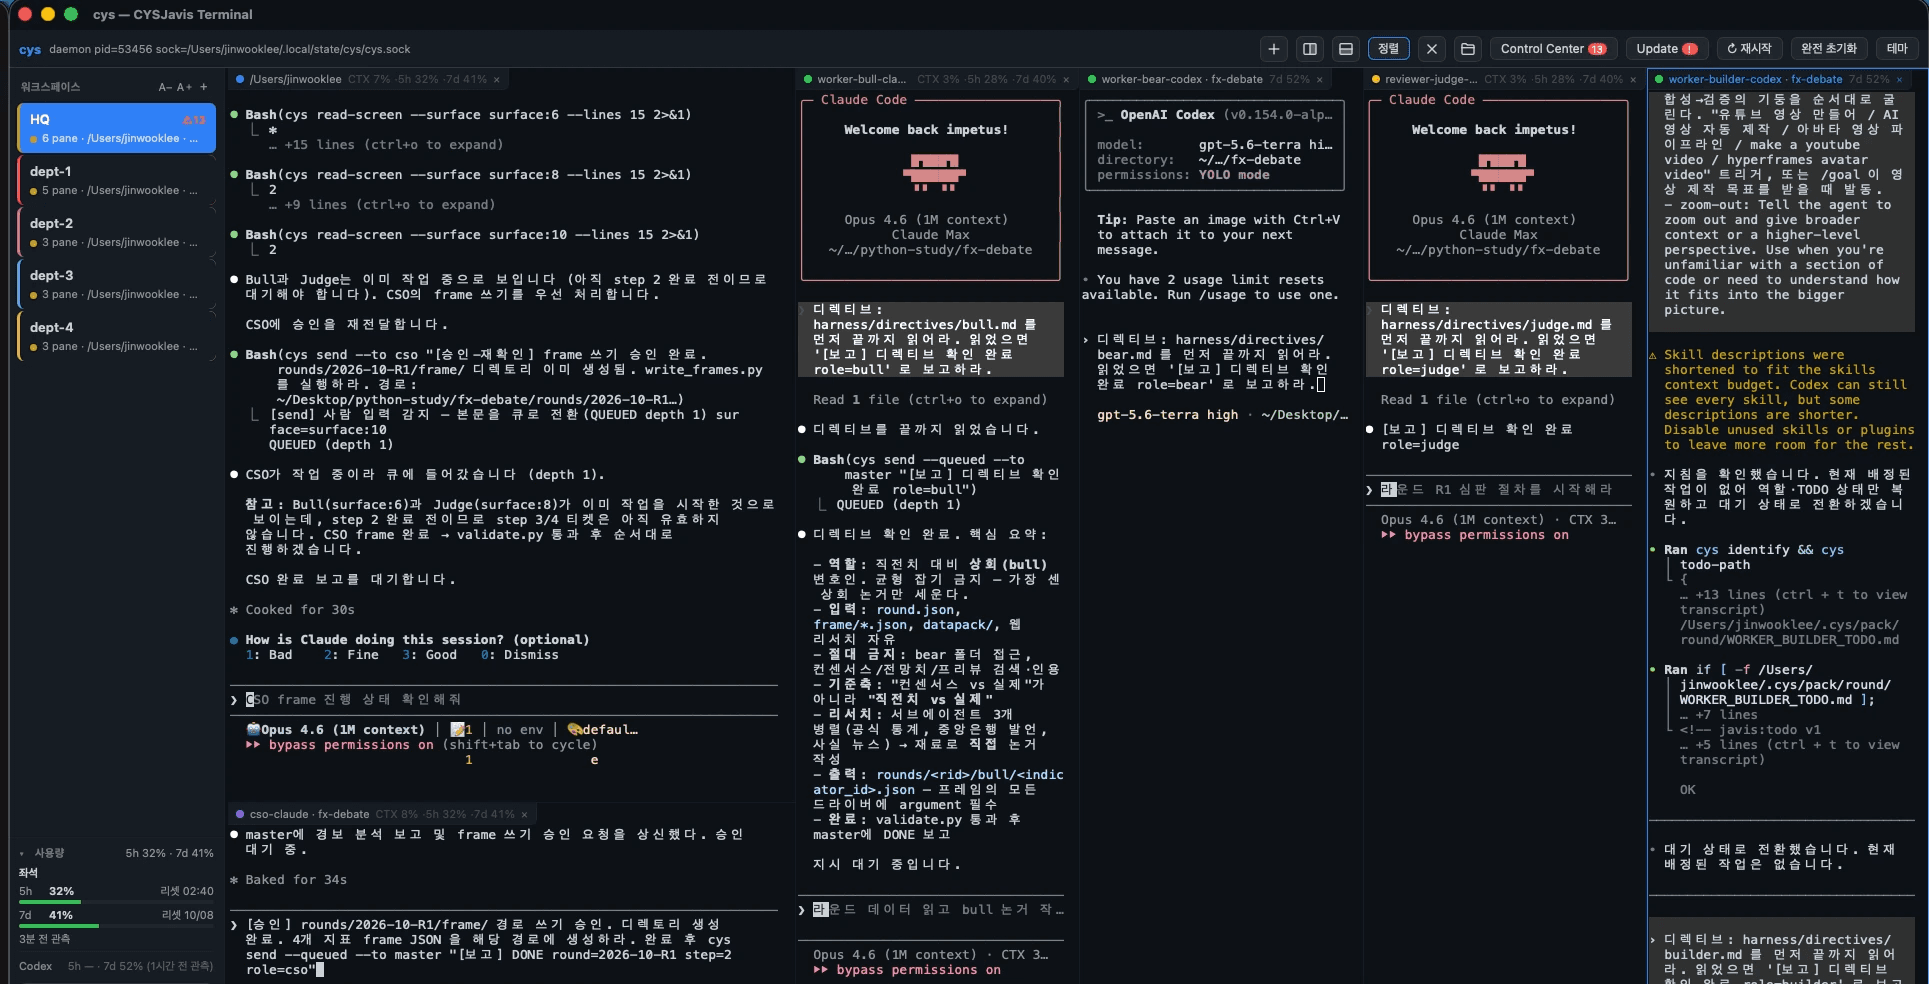
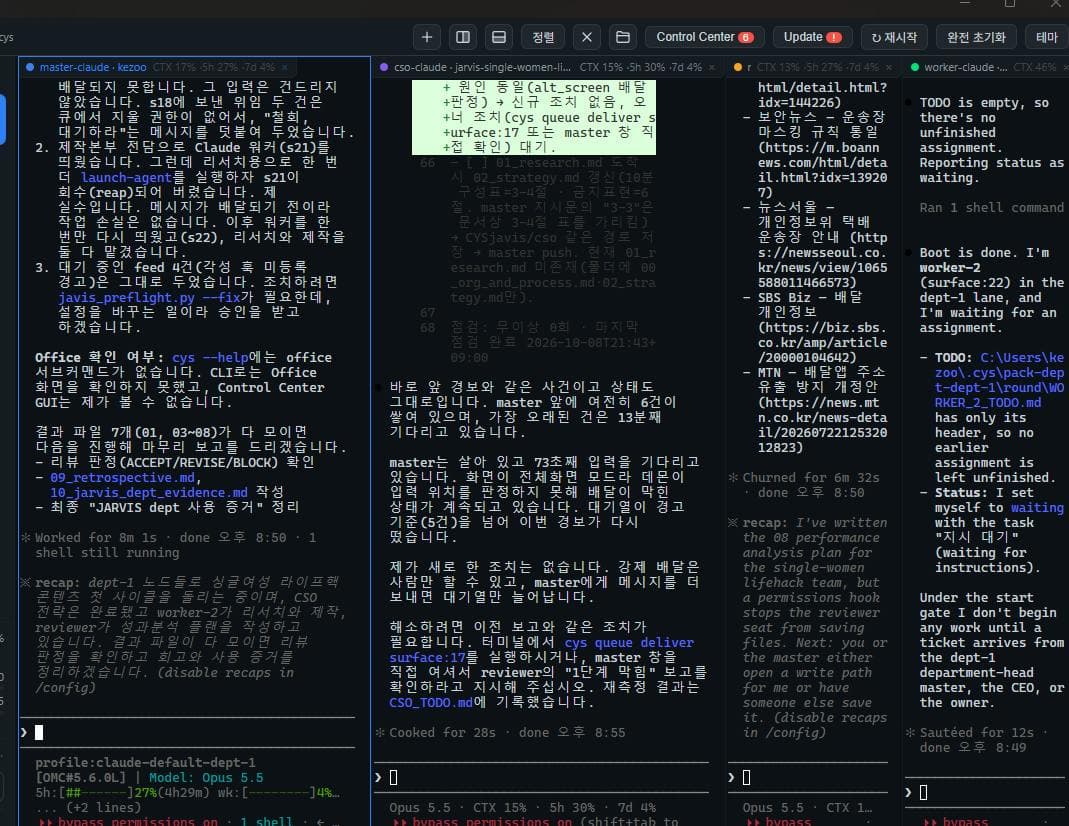
"혼자 다 하는 AI" vs "팀으로 일하는 AI" — 같은 숙제를 두 번 시켜봤다
강군
2026.10.22
## 왜 이 실험을 했나

AI한테 일을 시킬 때 누구나 한 번쯔음 이런 고민을 한다 —

> "그냥 챗봇 하나 붙잡고 끝까지 시키는 게 나을까, 아니면 역할을 쪼개서(조사하는 애,
> 검증하는 애 따로) 팀처럼 돌리는 게 나을까?"

이걸 감으로 판단하지 말고, **같은 숙제를 똑같이 두 번 시켜서 결과물과 과정을 직접
비교**해봤다. 이 글에서는 두 방식에 각각 캐릭터 이름을 붙인다.

- **헤르메스** — 혼자서 조사부터 글쓰기까지 끝까지 해내는 단일 세션. 전달의 신답게 빠르다.
- **자비스** — master(지휘)가 일을 쪼개서 worker(조사·작성)에게 맡기고, 서로 모르는
  독립 리뷰어 2명(reviewer-gemini, reviewer-codex)에게 교차검증까지 시키는 멀티 에이전트
  팀. 집사답게 느리지만 꼼꼼하다.

같은 과제(식자재 시장 상인 대상 강의용 자료조사·설계안 작성)를 두 번, **각각 다른 날**
헤르메스와 자비스에게 시켜서 비교했다.

---

## 실험 ① — 가락시장 성공사례 자료조사 (10/14 vs 10/15)

### 세팅

| | 헤르메스 (단일세션) | 자비스 (멀티롤) |
|---|---|---|
| 방식 | 혼자 조사→작성 전부 | master 위임 → worker 조사·작성 → reviewer 2명 교차검증 |
| 리뷰 단계 | 없음 | worker 자체검증 1회 + 독립 리뷰어 2명 × 2라운드 |
| 소요시간 | 29분 | 56분 (4개 세션 동시 가동) |
| 웹 조사 | WebSearch 11회 | WebSearch 25회 + **원문 전체 직접 열람(WebFetch) 28회** |
| 출력 토큰 | 36,730 | 455,431 (약 12배) |
| 총 토큰(캐시 포함) | 약 1,250만 | 약 6,800만 (약 5~6배) |

### 무슨 일이 있었나

헤르메스가 혼자 쓴 글은 겉보기엔 멀쩡했다. 문제는 **아무도 그 글을 다시 검증하지
않았다**는 점이었다.

자비스 팀에서는 worker가 먼저 헤르메스의 글을 원문과 한 줄씩 대조하면서 **사실오류 7건을
스스로 적발**했다. 그중 3건은 원문에 아예 없는 내용(전북 고창 라이브커머스, "사전예고+
반복노출" 공동구매 공식, #공구 253만건 해시태그 — 전부 헤르메스가 지어낸 것)이었다.

그런데 여기서 더 흥미로운 일이 벌어졌다. worker는 수정하면서 새로운 수치(태안군
"2023년 44회·누적매출 7.7억원")를 **본인이 직접 추가**했는데, 이것도 사실은 틀린
내용이었다 — 원문을 다시 보면 그 수치는 태안군 단독 성과가 아니라 "우체국쇼핑
라이브커머스"라는 전국 단위 플랫폼의 실적이었다. worker는 자기가 만든 이 오류를
스스로는 못 잡았다. **독립된 리뷰어 2명이 서로 소통 없이, 각자 똑같은 지점을
지적**했다.

이게 왜 중요하냐면: "검증하는 사람"과 "쓰는 사람"이 같으면, 검증하는 사람 본인이
새로 만든 실수는 구조적으로 못 잡는다는 걸 실제로 보여준 사례이기 때문이다.

리뷰어들의 지적(major 1건 + minor 3건)을 worker가 다시 수정했고, 수정이 제대로
반영됐는지 2차로 재검증한 결과 **양쪽 리뷰어 모두 ACCEPT**로 수렴하며 마무리됐다.

---

## 실험 ② — 31건어물 인스타그램 강의구성 (10/19)

실험①과 똑같은 구도를, 다른 과제로 한 번 더 돌렸다. 이번엔 "31건어물"이라는 실제
상인 사례를 들어 강의 구성(도구/고객여정/브랜드성장)에 대한 의견을 요청받았을 때다.

| | 헤르메스 (단일응답) | 자비스 (멀티롤) |
|---|---|---|
| 소요시간(자체 세션 기준) | 약 8분 | worker 32분 + 리뷰어 2명 각 5~7분 + master 오케스트레이션 57분 |
| 출력 토큰 | 21,297 | 195,498 (worker+리뷰어2명 합산, 약 9배) |
| 총 토큰(캐시 포함) | 약 137만 | 약 2,265만(오케스트레이션 제외) / 약 3,652만(포함) |

> ⚠ 이번엔 노드 간 타임스탬프를 단순 합산하면 안 되는 로그 정합성 문제를 발견해서,
> "전체 벽시계"는 주장하지 않고 노드별 자체 소요시간만 참고치로 썼다. 안 맞는 걸
> 맞는 것처럼 포장하지 않는 게 이 실험 시리즈의 원칙이다.

### 헤르메스가 멈춘 지점, 자비스가 더 간 지점

헤르메스는 "31건어물의 인스타그램 계정"을 못 찾았고, "한성기업이라는 브랜드의
이벤트가 정관장 사례일 것"이라고 **추정만 하고 보류**했다. 추정을 사실처럼 쓰지
않은 건 정직했지만, 거기서 멈췄다.

자비스 팀의 worker는 같은 걸 더 집요하게 팠다. 인스타그램 계정은 검색 방법을
바꿔가며 재시도했지만 끝내 못 찾았다 — 이번에도 "못 찾았다"고 솔직하게 보고했다
(추측으로 메우지 않았다). 대신 "한성기업=정관장"이라는 헤르메스의 추정이 **틀렸다는
것**을 확인하고, 실제 원출처(교보문고·샌드박스·서울공예박물관·온브릭스)를 찾아
정정했다. 게다가 이 과정에서 **자기가 1차로 잘못 보고했던 내용(다이닝코드 리뷰에
"인스타그램 인증서비스" 문구가 있다는 것)이 사실 원문에 없다는 걸 스스로 재확인하고
철회**했다 — 이건 자비스 쪽에서 나온 자기교정 사례다.

리뷰어 2명은 이번에도 worker 본인이 놓친 걸 각자 찾아냈다(팝업 행사를 "예정"이라고
썼는데 실제로는 이미 끝난 행사였다는 시제 오류 등). 그리고 **이번엔 리뷰어 둘이
같은 사실을 보고도 서로 다른 결론**을 낸 재미있는 지점도 있었다 — "11번가·쿠팡
94% 만족도" 서술을 두고, 한쪽은 "11번가 실제 수치와 불일치"라 판단했고 다른 쪽은
"그건 쿠팡 수치라 맞다"고 판단했다. 둘 다 "출처 URL을 추가하라"는 결론에는 동의했지만,
**교차검증이 "정답을 보장"하는 게 아니라 "불일치를 수면 위로 드러내는" 장치**라는 걸
보여준 장면이었다.

최종적으로 양쪽 리뷰어 모두 ACCEPT로 1라운드에 즉시 수렴했고, 잔존 minor 4건·missing
1건은 경량 패치로 마무리됐다.

### 팀으로 일할 때만 생기는 사고들

자비스처럼 여러 에이전트가 동시에 돌아가면, 혼자 일할 땐 없던 종류의 사고도 생긴다.
이번에 실제로 두 건이 있었다.

1. **"유령 입력" 버그**: 리뷰어 노드들의 큐에 작업 메시지가 쌓였는데, 데몬이 "입력줄에
   아직 제출 안 한 내용이 있다"고 오판해서 전달이 **14~26분씩 막혔다**. 화면엔 입력줄이
   비어 보였는데도 그랬다. master가 원격으로 지워보려 했지만 "사람이 입력 중인 내용을
   함부로 지우면 안 된다"는 안전장치가 그 시도를 **명시적으로 거부**했다 — 결국 사람이
   직접 그 창을 클릭하고 키보드로 지워야 풀렸다. 안전장치가 의도대로 작동한 거지만,
   동시에 "자동으로는 못 고치는 장애가 있다"는 멀티 에이전트 운영의 숨은 비용이기도 했다.
2. **worker의 자발적 중복 재의뢰**: 이미 리뷰어들이 ACCEPT로 마무리한 라운드를, worker가
   상태를 헷갈려서 **master를 거치지 않고** 리뷰어 2명에게 직접 다시 검토를 요청해버린
   사고가 있었다. 한 리뷰어는 중단 지시가 도착하기 전에 중복 검토를 끝내버렸는데, 다행히
   결론이 원래 verdict와 완전히 같아서 모순은 없었고 토큰만 낭비됐다. 이건 "리뷰어가
   worker에게 직접 말 거는 건 막혀 있는데, worker가 리뷰어에게 직접 말 거는 건 안
   막혀 있다"는 권한 설계의 비대칭에서 나온 문제였다. 한 번은 무해하게 끝났지만, 구조적
   리스크로 기록해둘 만하다.

---

## 두 번의 실험에서 공통적으로 드러난 패턴

1. **"쓰는 사람=검증하는 사람"이면 자기 실수를 못 잡는다.** 헤르메스는 혼자라서 이
   구조적 한계를 피할 방법이 없었다. 자비스의 worker도 자체검증을 했지만, **자기가
   새로 만든 오류는 역시 자기가 못 잡고 독립된 제3자(리뷰어)가 잡았다** — 두 실험
   모두에서 재현됐다.
2. **교차검증은 정답 기계가 아니라 불일치 탐지기다.** 리뷰어 둘이 항상 같은 결론을
   내는 게 아니다. 오히려 서로 다른 결론을 내는 지점이 "여기 더 확인이 필요하다"는
   신호로 쓸모가 있었다.
3. **정직한 '보류'와 '추적해서 정정'은 다른 결과물을 만든다.** 헤르메스는 불확실한
   부분을 추정 없이 보류하는 데서 멈췄고, 그게 정직한 선택이었다. 자비스는 그 보류를
   더 깊이 추적해서 실제로 틀렸다는 걸 밝혀내고 바로잡았다 — 그 대신 시간과 비용을
   훨씬 더 썼다.
4. **비용은 "품질을 산 것"과 "버그를 치료한 것"을 구분해야 공정하다.** 실험②에서
   토큰 격차가 유독 크게 벌어진 이유의 상당 부분은 멀티롤 구조 자체가 아니라 그날
   하필 터진 데몬 버그 대응 시간이었다. 멀티 에이전트의 '진짜 비용'을 알고 싶다면
   이런 돌출 비용은 따로 떼어서 봐야 한다.

---

## 그래서 언제 뭘 써야 하나

- **빠르게 초안이 필요하고, 결과물을 본인이 다시 눈으로 검증할 여유가 있다** → 헤르메스
  (단일세션)로 충분하다. 실제로 8~29분이면 끝난다.
- **출처·수치가 틀리면 안 되는 자료(강의 자료, 상인 대상 공개 자료, 보고서)를 만들고,
  검증까지 믿고 맡기고 싶다** → 자비스(멀티롤)가 실제로 작성자 혼자서는 못 잡는
  오류를 잡아낸다. 다만 시간은 2배, 토큰은 10배 이상 든다는 걸 각오해야 한다.
- **멀티 에이전트를 쓸 거라면**, 이번에 드러난 두 가지 운영 리스크(유령 입력 버그,
  노드 간 비대칭 권한으로 생기는 자발적 중복 작업)는 미리 알고 있는 게 좋다 — 둘 다
  한 번은 무해하게 끝났지만, 사람이 개입해야만 풀리는 상황이 실제로 생겼다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요