


소개
시도하고자 했던 것과 그 이유를 알려주세요.
2025년 이후 "AI가 스스로 논문을 쓴다"는 류의 연구가 급증했습니다. Co-Scientist, The AI Scientist, AI-Researcher 등 논문들이 비슷해 보이지만 제각각이라, 흐름을 잡기가 어려웠습니다.
두 가지를 동시에 해결하고 싶었습니다.
첫째, 체계적으로 논문을 정리하고 싶었습니다. 읽고 나면 머릿속에서 증발하는 논문들을 연결된 지식 그래프로 쌓고 싶었습니다.
둘째, 논문 주장을 직접 검증해보고 싶었습니다. Co-Scientist 논문은 "AI가 생성한 가설을 전문가 9명이 평가했다"고 하는데 — LLM이 그 전문가 역할을 대체할 수 있는지, 공개된 데이터로 실제로 측정해보고 싶었습니다.
Claude Code를 개발 도구가 아니라 연구 파트너로 써본 실험입니다.
진행 방법
사용 도구: Claude Code (CLI) + research-survey 플러그인 (wiki_promote, wiki_index, survey-refresh)
전체 흐름은 5단계였습니다.
Step 1. 코퍼스 수집 + 분류
arXiv에서 관련 논문을 자동으로 긁어오고, 분류기가 co-scientist / scientific-agent 두 카테고리로 나눴습니다. 처음 25편에서 survey-refresh를 돌릴 때마다 늘어나 최종 57편이 됐습니다.
co-scientist 카테고리 taxonomy 정의하고 arXiv에서 관련 논문 수집해줘survey-refresh 실행해줘Step 2. 핵심 논문 7편 → wiki 노트
분류기가 추린 상위 7편을 하나씩 읽으며 "출처 없는 내용은 한 줄도 넣지 말 것" 원칙으로 wiki 노트를 만들었습니다. 노트끼리 연결(엣지)이 쌓이면서 논문 간 구조가 보이기 시작했습니다.
2502.18864 부록 Note 4 전체 읽고 임상 전문가 평가 구조 정리해줘.
숫자는 반드시 페이지·그림 번호 명시.
여기서 핵심 수치가 나왔습니다. 전문가 9명이 서로를 평가할 때의 일치도(Spearman ρ) = 0.745. 이게 이후 실험의 기준선이 됐습니다.
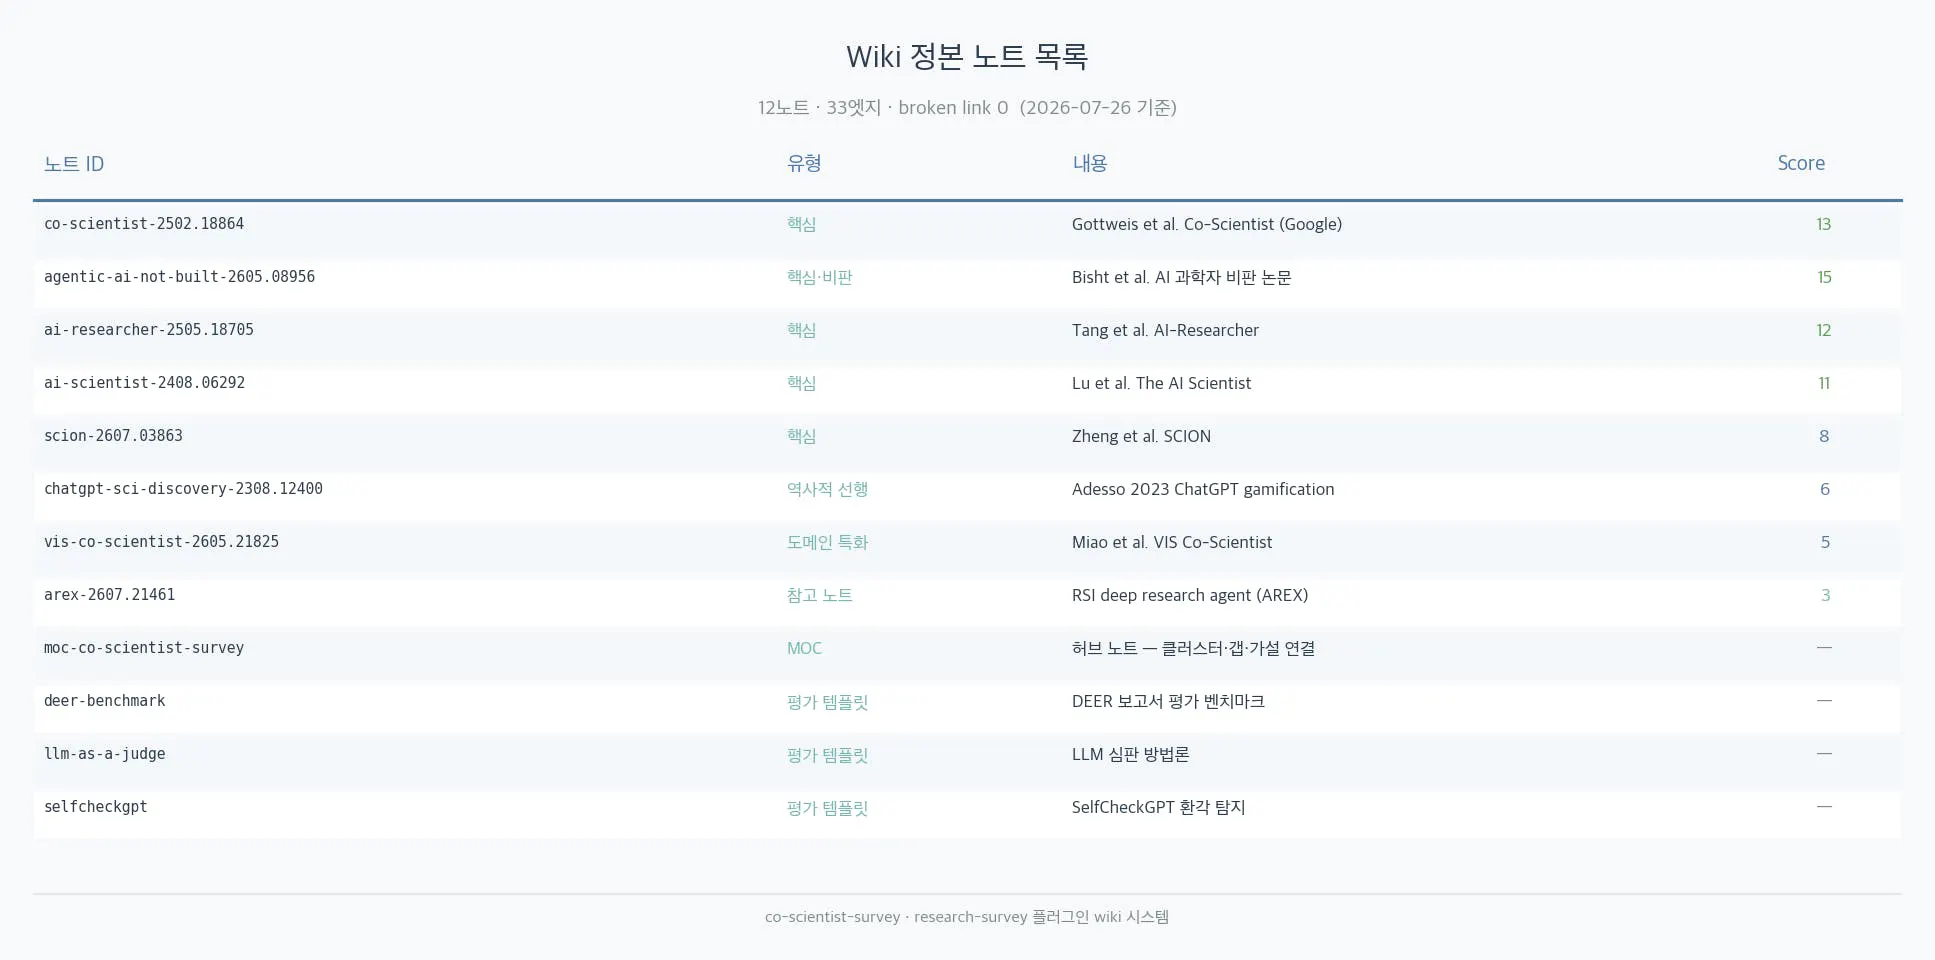
Wiki 정본 노트 목록 — 12노트 33엣지
Step 3. LLM 심판 실험 (H2)
"LLM이 전문가를 대체할 수 있는가"를 실제로 측정했습니다. Claude가 5차원 루브릭(Novelty·Feasibility·Specificity·Non-triviality·Grounding)으로 가설들을 채점하고, 논문에 실린 wet-lab 결과와 Spearman ρ를 계산했습니다.
H2 파일럿 실험 진행해줘.
2502.18864 AML 약물 8개를 5차원 루브릭으로 채점하고
wet-lab IC50 결과와 Spearman ρ 계산해줘.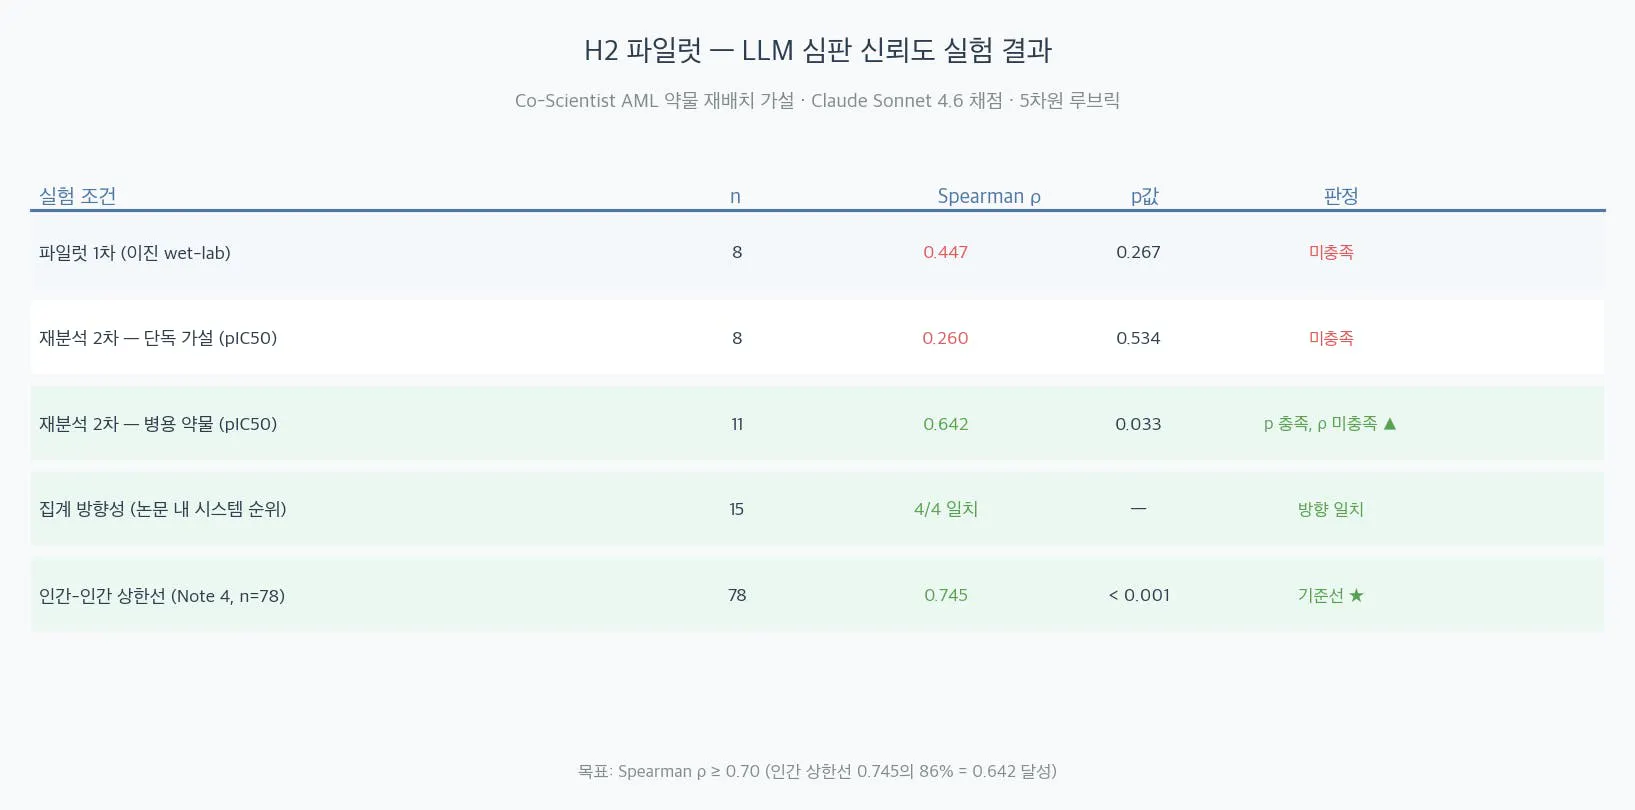
H2 실험 결과 — Spearman ρ 누적 판정
Step 4. 실패 지식 수집 실험 (H1)
논문이 주장하는 "공개 DB에 실패 지식이 없다"는 갭을 직접 확인했습니다. PLOS API와 PubMed API로 약물 재배치 실패 논문을 최대한 모아봤습니다.
H1 경량 실험 Step 1 진행.
PLOS API에서 drug repurposing negative results 관련 논문 수집해줘.
목표: 엄밀한 negative results 50편 이상.
PLOS API 수집 스크립트 (Claude가 작성):
import requests, json
from pathlib import Path

BASE_URL = "https://api.plos.org/search"
QUERIES = [
    {"name": "q1_repurposing_negative",
     "params": {
         "q": 'everything:"drug repurposing" AND everything:"negative result"',
         "fq": 'journal_key:"PLoSONE"',
         "fl": "id,title,abstract,publication_date",
         "rows": 100, "wt": "json"
     }},
]

for q in QUERIES:
    r = requests.get(BASE_URL, params=q["params"])
    docs = r.json()["response"]["docs"]
    Path(f"{q['name']}.json").write_text(json.dumps(docs, ensure_ascii=False, indent=2))
print(f"{q['name']}: {len(docs)}편")다음 단계 진행. PubMed MeSH로
"Negative Results"[pt] AND "Drug Repositioning"[MeSH] 검색 후
PLOS 결과와 합산해줘.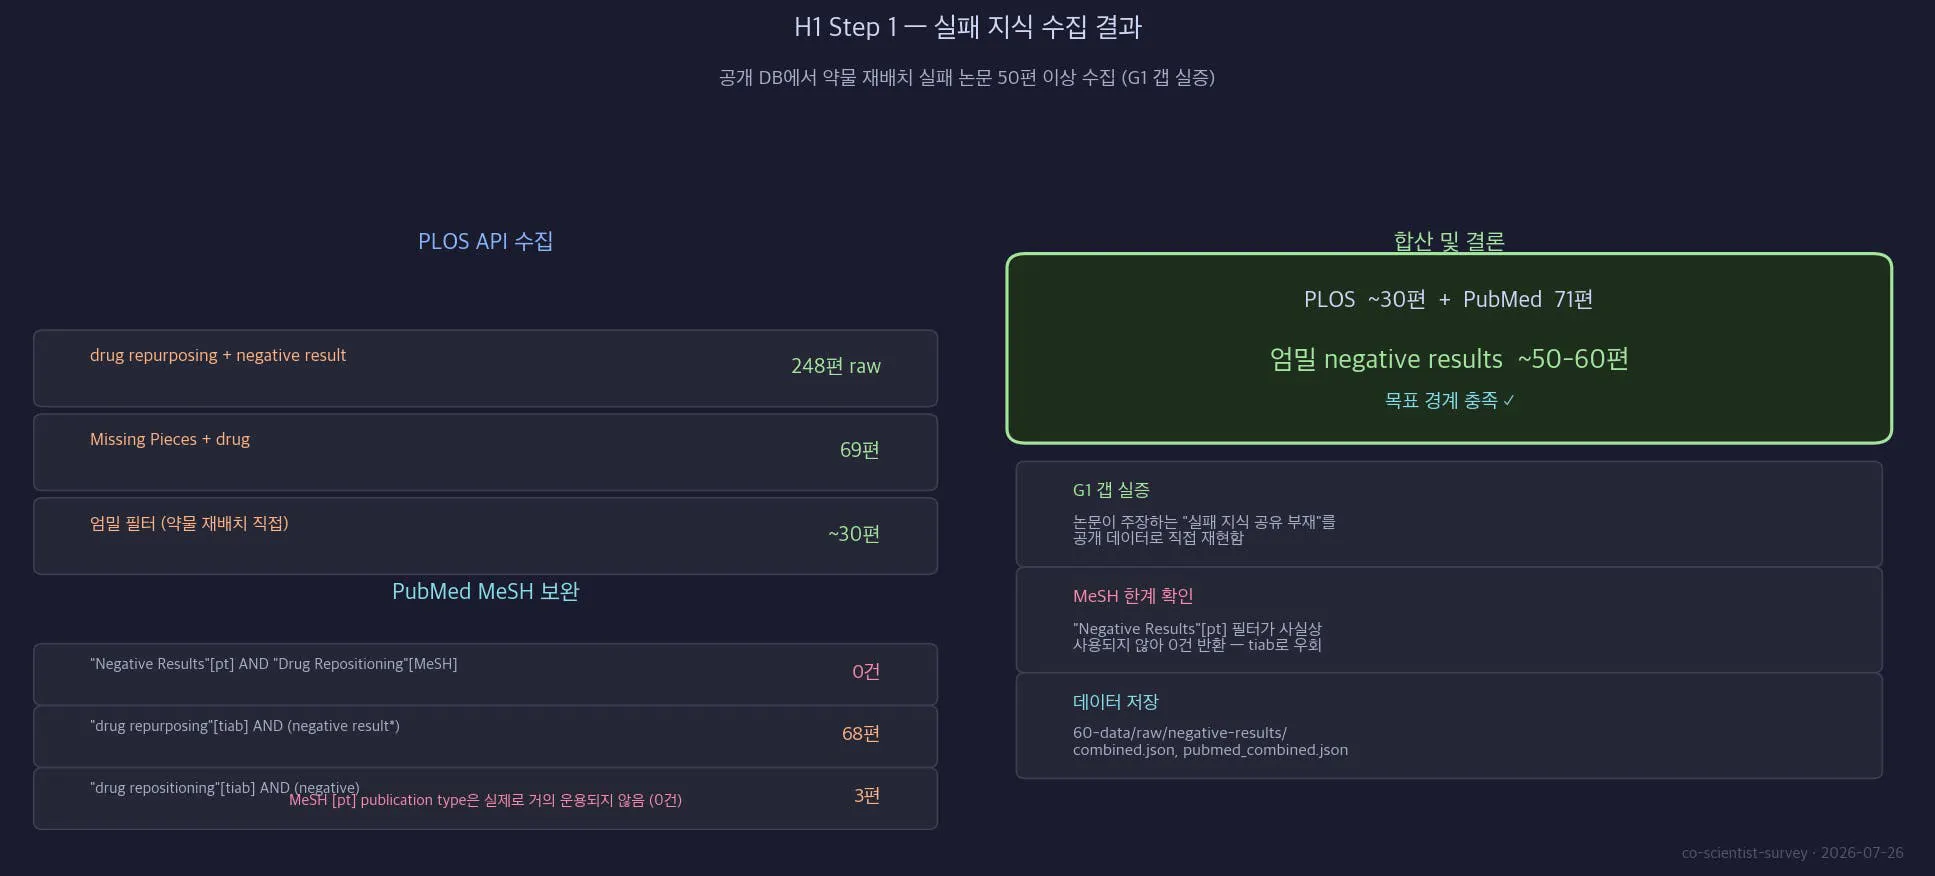
PLOS·PubMed 수집 결과
Step 5. 차원별 변별력 분석
"5개 차원 중 어떤 게 실제로 유효한가"를 통계로 확인했습니다.
남은 TODO 해.
기존 H2 데이터로 5차원 루브릭의 wet-lab 활성 예측력을
점이연상관으로 분석해줘.from scipy.stats import pointbiserialr
drugs = ['Binimetinib','Pacritinib','Cerivastatin','KIRA6',
'Pravastatin','DMF','Nanvuranlat','Leflunomide']
active = [1, 1, 1, 1, 0, 0, 0, 0]
scores = {
'Novelty': [2, 3, 3, 5, 2, 3, 4, 4],
'Feasibility': [5, 4, 2, 3, 4, 4, 3, 4],
'Specificity': [4, 4, 3, 5, 2, 2, 4, 4],
'Non-triviality': [3, 3, 3, 5, 2, 3, 4, 3],
'Grounding': [5, 4, 3, 4, 3, 3, 3, 3],
}
for dim, vals in scores.items():
r, p = pointbiserialr(active, vals)
print(f"{dim:20s} r={r:.3f} p={p:.3f}")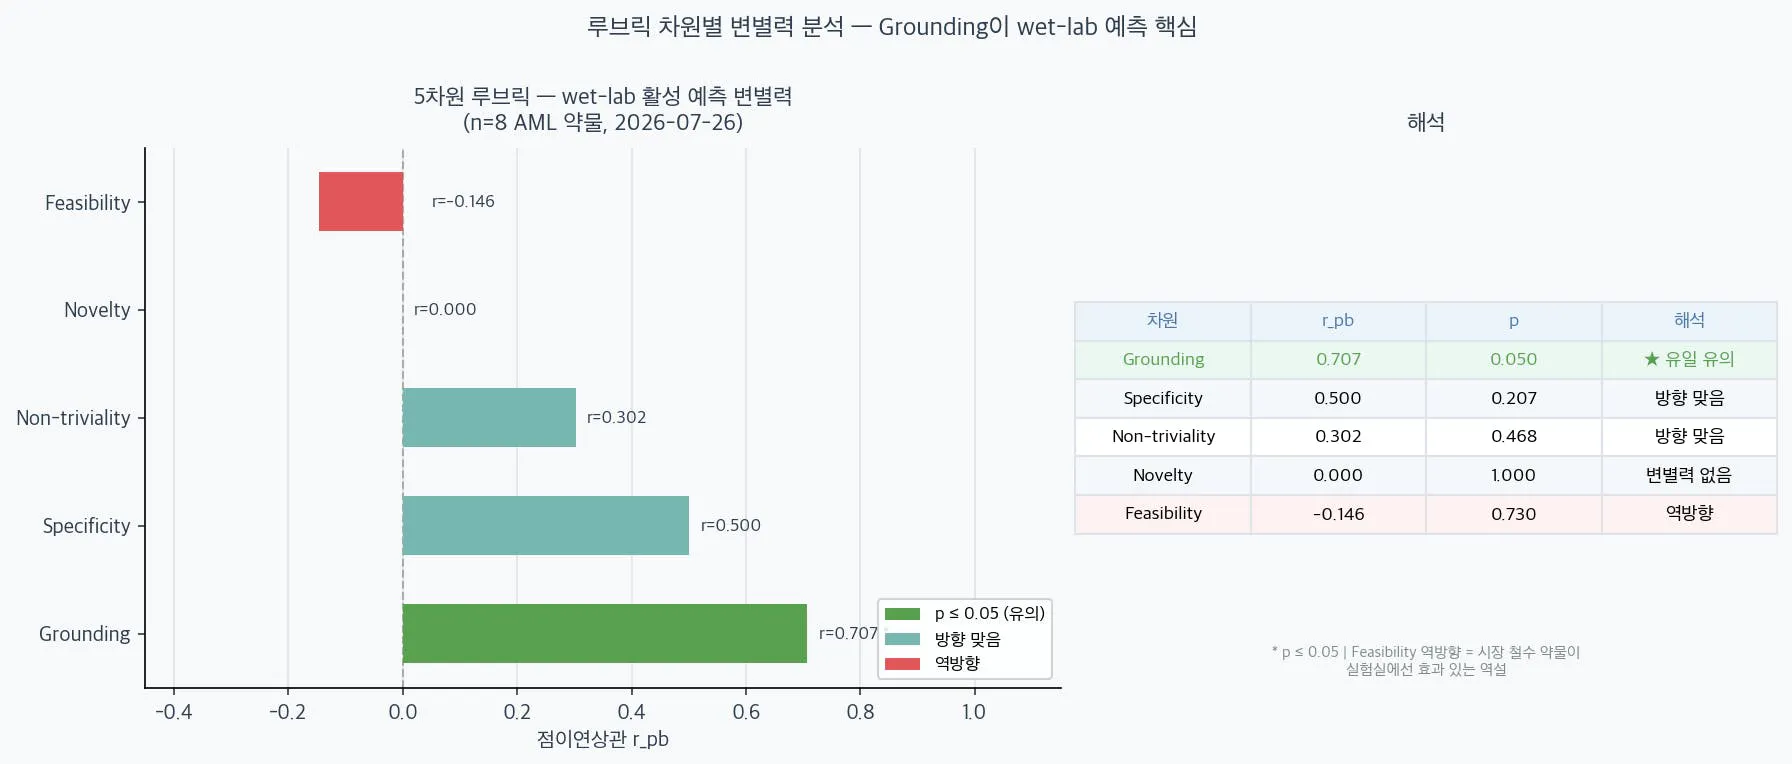
차원별 r_pb 분석 — Grounding이 유일 유의
결과와 배운 점
실험
n
Spearman ρ
p
판정
LLM 채점 vs wet-lab (이진)
8
0.447
0.267
미충족
LLM 채점 vs wet-lab (연속 척도)
11
0.642
0.033
p만 충족
인간-인간 상한선 (Note 4)
78
0.745
< 0.001
기준선
목표(ρ ≥ 0.70)에는 못 미쳤지만 인간 상한선의 86% 수준이었습니다.
배운 점
Grounding이 전부였다. 5차원 중 wet-lab 활성과 유의미하게 상관된 차원은 Grounding(r=0.707, p=0.050) 하나뿐이었습니다. 문헌 근거가 탄탄한 가설이 실험에서도 효과가 있었습니다. Feasibility는 오히려 역방향이었는데, 시장에서 철수된 약이 실험실에서는 효과가 있는 경우가 있기 때문입니다.
실패 논문은 정말 없었다. PLOS + PubMed를 다 뒤져도 약물 재배치 실패 논문 50편 확보가 어려웠습니다. 논문이 "실패 지식 공유가 부재하다"고 주장하는데, 직접 데이터로 재현한 셈입니다.
범위 제한 문제. 전문가가 사전에 말이 안 되는 가설을 걸러낸 뒤 평가하니, 남은 가설들이 모두 고품질이라 ρ가 구조적으로 낮게 나올 수밖에 없었습니다. 수치만 보면 "LLM이 아직 부족하다"지만, 실제로는 측정 설계의 문제였습니다.
시행착오
PubMed MeSH
"Negative Results"[pt]필터가 0건 반환했습니다. 해당 publication type이 실제로 거의 사용되지 않는다는 걸 직접 부딪혀서 알았습니다. tiab(제목+초록) 검색으로 우회했습니다.처음에 Scientist-Bench(AI-Researcher 논문의 벤치마크)가 전문가 채점 데이터를 제공할 거라고 기대했는데, 확인해보니 ML/CS 논문 복원 벤치마크라 바이오메디컬 가설 데이터가 없었습니다. 가정을 검증하지 않은 채 계획에 넣은 실수였습니다.
Claude Code는 세션을 기억하지 않습니다. 세션 마지막에
SESSION_HANDOFF.md저장 루틴을 넣지 않으면 다음 세션에서 처음부터 설명해야 합니다.
앞으로의 계획
Co-Scientist 저자(Gottweis et al.)에게 Note 4 전체 데이터(78가설 전문가 점수) 요청 이메일 발송 예정. 데이터를 받으면 올바른 H2 재시험 즉시 실행 가능합니다.
GPT-4o·Claude·Gemini 3종 앙상블 실험 — 루브릭을 고정하고 세 모델이 독립 채점, 일치도(Krippendorff α)를 측정할 계획입니다.
