


아무도 증명 못 한 수학 문제
세상에는 100만 달러가 걸린 수학 문제가 일곱 개 있어요. 클레이 수학연구소가 2000년에 내건 밀레니엄 문제고, 그중 하나가 나비에-스토크스 방정식이에요. 비행기 날개를 설계할 때도 기후를 모델링할 때도 쓰는 식인데, 200년 가까이 써오면서도 이 식의 해가 언제나 매끄럽게 존재하는지는 아무도 증명하지 못했어요.
OpenAI가 발표를 하나 하는데 AI를 활용해서 해당 문제를 풀었다는 거였어요.
저의 지인 중 수학을 전공하는 친구는 이 문제를 푸는게 수학을 전공하는 이유이자 꿈이라고 했는데 AI가 풀어버렸네요..
에이전트 1만 개. 88시간. 주고받은 메시지 270만 개. 출력 토큰 1,300억 개. OpenAI에서 해당 문제를 풀기 위해 들인 값이에요.
1,300억 토큰이 감이 안 와서 계산해봤어요. 실제로 돌린 건 사내 모델이라 공개된 가격이 없는데, 바깥에서 정가로 어림잡은 추정이 나와 있어요.
출력 토큰만 따져도 약 600만 달러였어요. Science 기사에 인용된 전문가 추정도 비슷한 자리에 있고요.
ChatGPT 개인 요금제 중 제일 비싼 게 월 200달러죠.
600만 달러를 월 200달러로 나누면 30,000개월이에요. 12로 나누면 2,500년이고요.
한 사람이 최고가 요금제를 2,500년 동안 결제해야 나오는 돈
공개하지 않은 최상위 모델을 사용했다는게 신기했어요
다만 이 작업에 쓴 건 공개된 모델이 아니에요. OpenAI는 "Astra보다 상당히 뛰어난" 사내 모델이라고만 밝혔어요. 이름도 없고, 8월 28일에 학습을 시작해 지금도 학습 중이라고 해요. 심지어 작업 도중에 더 훈련된 버전이 나오자 에이전트를 그 모델로 갈아끼웠다고도 적어놨어요.
그러니까 이 질문이 남아요.
모델이 좋아서 된 걸까, 1만 개를 병렬로 동시에 돌려서 된 걸까
사내 에이전트 스터디와 연결
지피터스는 지금 사내 AX 중이고, 그 일환으로 AI 에이전트 스터디를 하고 있어요. 스터디에서 본 논문이 저 질문에 흥미를 가져다 주었어요.
구글 리서치의 ReasoningBank라는 논문이에요. 에이전트가 매번 처음부터 시작하는 문제를 다루는데, 같은 종류의 과제를 수백 번 풀어도 지난 발자국은 지워지고 매번 출발선이거든요. 그래서 지난 시도에서 뭔가를 남기는데, 남기는 방식이 특이했어요. "어디를 클릭했다"가 아니라 "왜 그렇게 판단했나"를 남겨요. 성공은 "이렇게 하라"는 전략으로, 실패는 "이걸 피하라"는 예방 규칙으로 바꿔서 저장해요. 모델을 학습시키지는 않고 검색된 항목을 시스템 프롬프트에 넣을 뿐이에요.
여기까지는 그냥 메모리 얘기예요. 이 논문은 같은 과제를 한 번 풀고 끝내지 않아요. 여러 번 풀게 한 다음, 그 여러 번을 하나로 접어요. 접는 방식을 두 가지로 나눠서 비교했고요.
병렬은 같은 과제를 다섯 번 따로 풀게 한 다음, 나온 궤적 다섯 개를 한꺼번에 놓고 비교하게 해요. 논문은 이걸 자기 대조라고 불러요. 프롬프트가 이렇게 생겼어요.
어떤 궤적은 성공하고 어떤 궤적은 실패했는지를 먼저 생각하라. 특정 사이트나 검색어에 매이지 말고, 일반화되는 전략을 뽑아라.
순차는 한 번 푼 다음 그 궤적을 자기가 다시 읽게 하고요.
앞의 궤적을 처음부터 다시 검토하라. 페이지에서 맞는 요소를 썼는지, 답이 질문에 맞는지 보라. 어긋나면 고쳐라.
둘 다 하는 일은 같아요. 여러 번 한 걸 하나로 정리하는 거예요. 그렇게 정리해서 나온 게 메모리로 들어가고, 그 메모리가 다음 시도를 더 나은 쪽으로 행동해요.
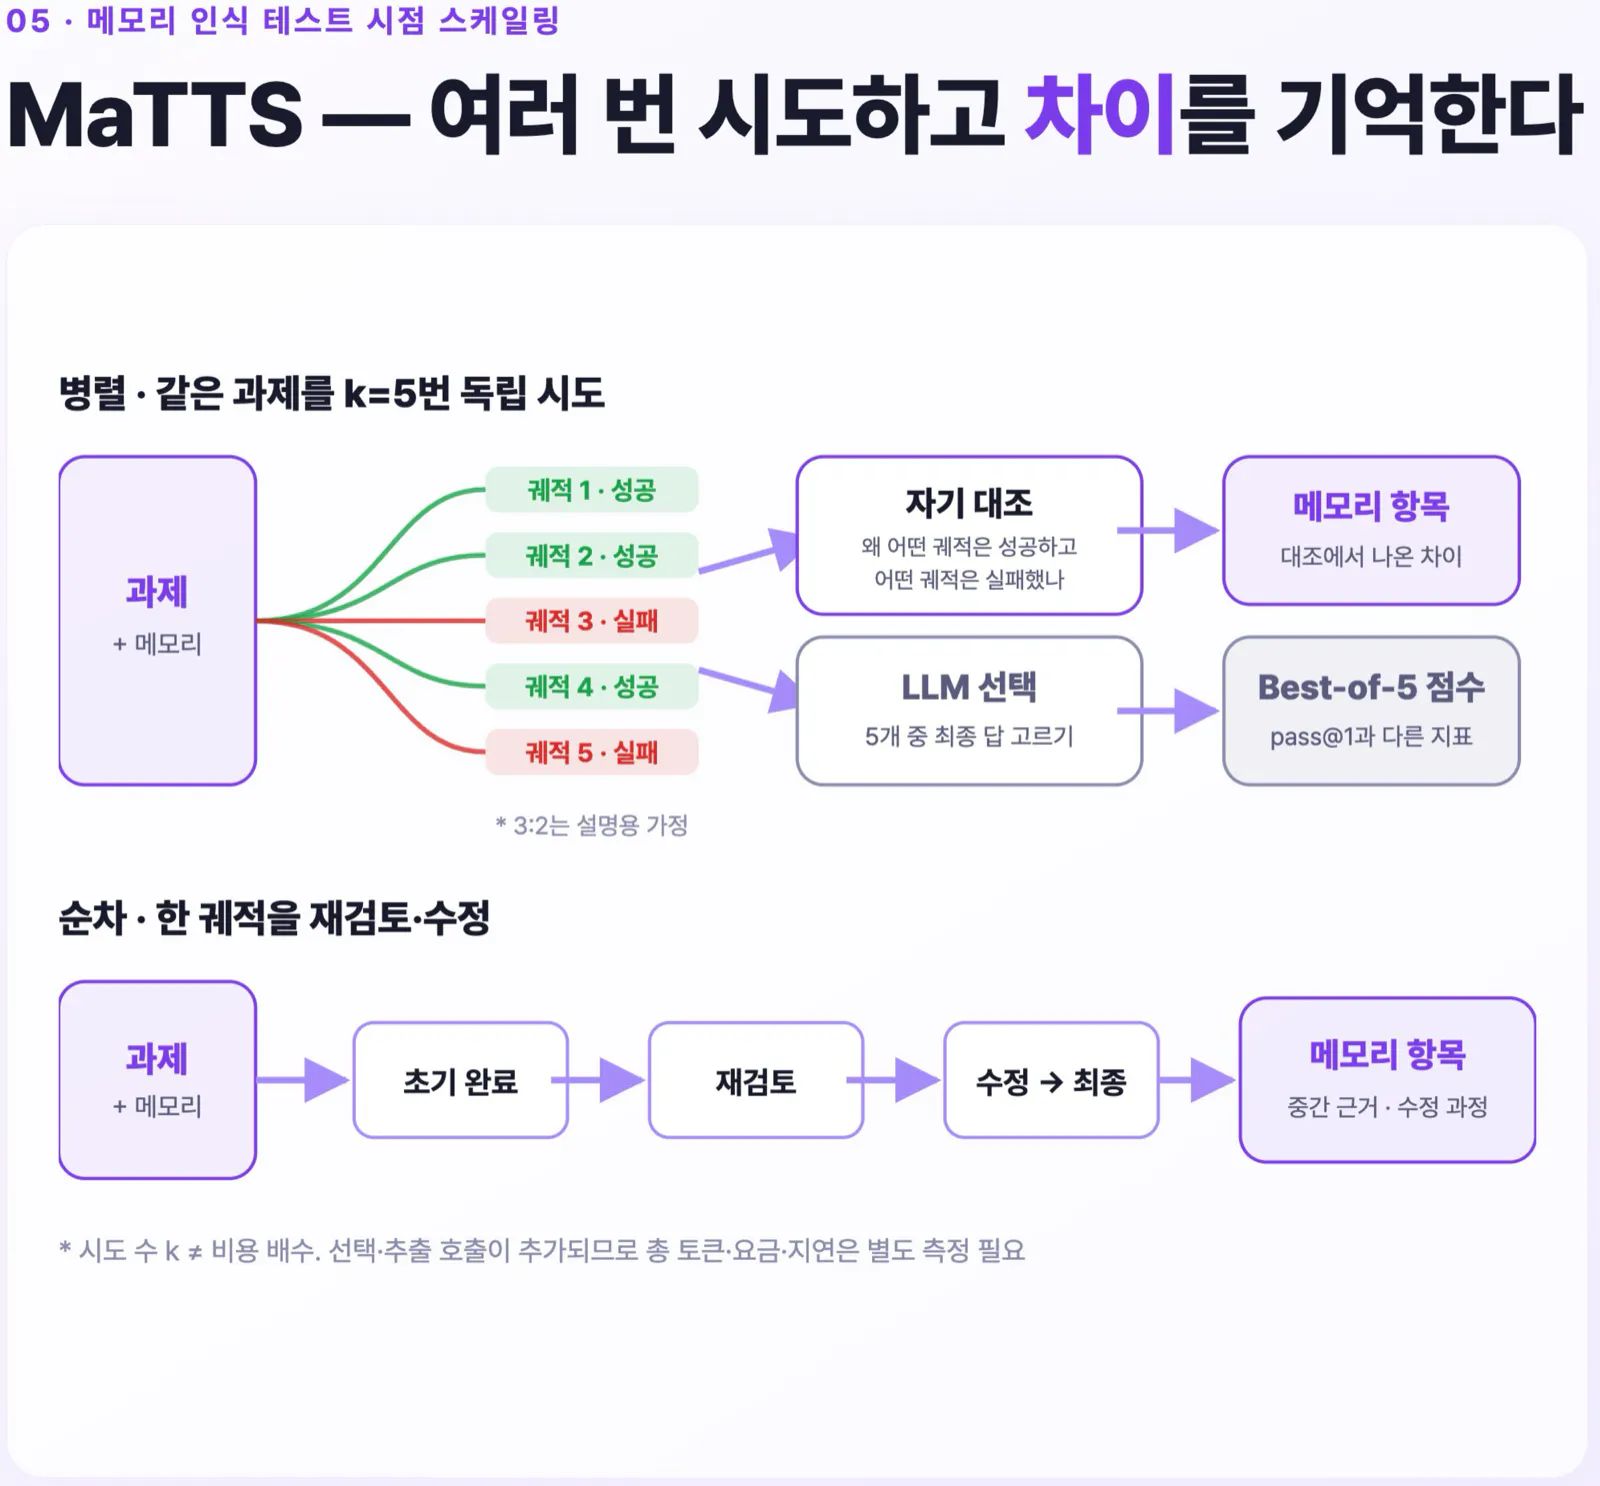
결과는 기억 없이 병렬로 돌리는 것보다는 기억을 가지며 병렬로 돌리는 것이 당연히 좋았습니다.
그리고 순차(직렬)로 돌리는 것보다 기억을 가지며 병렬로 돌리는 것이 더 좋았습니다.
OpenAI는 1만 개를 똑같이 돌리지 않았어요
이걸 보고 기사를 다시 읽으니 다르게 보였어요. OpenAI는 문제를 변형 네 개로 쪼개서, A와 B는 증명이 나올 방향으로, C와 D는 반증이 나올 방향으로 다른 그룹으로 나누어 진행을 했어요.
그리고 그룹들을 그냥 놔두지 않았어요. Codex로 각 그룹에서 쓸 만한 중간 결과를 모아 다시 뿌리고, 진전이 있는 쪽으로 에이전트를 재배분했어요. 오일러 방정식 쪽 반증은 에이전트 100개로 50시간 만에 나왔고요. 문제에 맞춰 규모를 바꾼 거죠.
논문은 같은 과제를 다섯 번 시켜요. 똑같은 걸 시켰는데 어떤 건 되고 어떤 건 안 되니까, 그 차이가 대조할 거리가 되는 거예요.
OpenAI는 다른 문제를 나눠서 맡겼어요. A와 B는 증명 쪽, C와 D는 반증 쪽. 애초에 서로 다른 일을 시킨 거예요.
하나는 같은 일을 여러 번 한 거고, 하나는 다른 일을 여러 곳에서 한 거예요. 그러니까 "둘 다 병렬이다"로 묶으면 틀려요.
겹치는 건 그다음이에요.
OpenAI는 이렇게 돌아요. A·B·C·D 그룹을 벌려놓고 → Codex가 정리하고 → 진전 있는 쪽으로 재배분하고 → 다시 시행하기.
ReasoningBank는 이렇게 돌고요. 궤적 다섯 개를 시행하고 → 자기 대조로 정리하고 → 메모리에 넣고 → 다음 과제.
둘 다 시행한 걸 그냥 두지 않았어요. 정리해서 다음 라운드로 넘겼죠.
그럼 우리는 어떻게 돌려야 할까요
앞의 질문으로 돌아가면, 모델 덕인지 에이전트를 1만 개 돌린 덕인지는 끝까지 알 수 없어요. OpenAI 쪽은 모델도 개수도 같이 바뀌었고, 논문 쪽은 모델을 고정했지만 웹 탐색과 코딩 벤치마크지 밀레니엄 문제가 아니에요. 이쪽 결과로 저쪽을 설명할 수는 없어요.
다만 "개수만 늘리면 되나"에는 답이 나와요. 안 돼요.
에이전트를 여러 개 벌려놓는 건 이제 어렵지 않아요. 서브에이전트 세 개 띄우는 데 한 줄이면 되니까요. 그런데 대부분은 같은 에이전트를 똑같이 띄우고 나온 걸 이어붙이죠. 같은 모델에 같은 프롬프트를 세 번 준 거라 답도 비슷하게 나오고, 토큰만 세 배 나가요.
이 글에 나온 두 곳이 각각 다른 답을 주는 것 같아요.
하나, 기억을 들려 보내는 방법. ReasoningBank 쪽이에요. 벌려놓기 전에 지난번에 뭐가 됐고 뭐가 안 됐는지를 먼저 쥐여주는 거죠. 다섯 번이 다 같은 기억을 들고 출발하니까 시작점 자체가 올라가요. 우리 식으로 하면 서브에이전트를 띄우기 전에 "지난번에 이렇게 했다가 이래서 틀렸다"를 프롬프트에 먼저 넣는 거예요.
둘, 역할을 갈라놓는 방법. OpenAI 쪽이에요. 같은 걸 세 번 시키는 게 아니라 아예 다른 걸 맡기는 거죠. 증명 쪽과 반증 쪽을 동시에 건 것처럼요. 우리 식으로 하면 셋 다 "이 코드 봐줘"가 아니라 하나는 버그, 하나는 성능, 하나는 빠진 요구사항을 보게 하는 거예요.
