


처음에는 단순히 “로컬봇이 좀 느린가?” 정도로 생각했습니다.
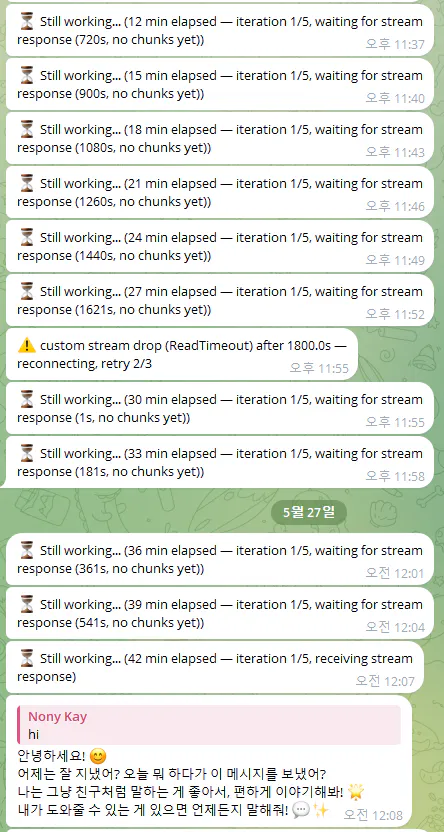
문자 메시지 그룹의 스크린샷
로컬 모델을 연결했다는 사실만으로도 기뻤습니다.
그런데 너무 느립니다.
hi하고 대답을 들으려면 42분이 걸렸습니다.
문제가 있다는 생각이 들어 살펴보기로 했습니다.
우선 간단하게 제 모델을 소개합니다.
1. 사용한 모델과 환경
모델 크기: qwen/qwen3-4b-2507
실행 환경: LM Studio
목표: 로컬에서 가볍게 대화형 봇 운영
문제 상황: 짧은 요청에도 지연시간이 지나치게 큼
제가 능력치뿜뿜이라면 로그를 봤겠지만
로그는 봐도 무슨말인지 모르겠어서... ^, ^
먼저 확인한 것은 이런 것들 입니다.
2. 처음 확인한 것들
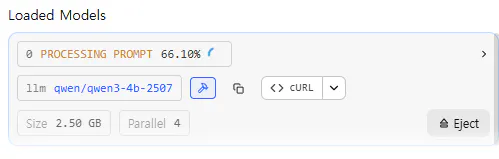
2-1. Processing Prompt
모델 로딩을 보여주는 화면의 스크린샷
지연시간동안 prompt processing이라는 시간을 거칩니다.(0%가 100%가 되어야 대답을 들을 수 있음 ㅎㅎ.)
2-2. context_length
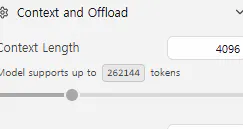
prompt processing이 100% 되면 그 이후는 대답을 곧 잘합니다. 하지만, 어느순간 또 대답을 안합니다.(Still working...)
이때 발견한 것은 lmstudio에서 4096으로 돌아가 있다라는 것입니다.(이건 제가 모델 로드 당시 context_length: 64000로 늘려 놓았던 것입니다.)
콘텐츠 및 오프로드 설정의 스크린샷
다시 context_length: 64000로 늘리고 다시 서버를 올립니다. 그리고 prompt processing가 100%가 되길 기다려야 합니다.
ㅎ
ㅎㅎㅎㅎㅎㅎ
ram 16GB 노트북에도 로컬LLM을 돌린다고 하는데,,, 64GB로 나름 어깨를 세운 제 PC에게 너무 가혹하다는 생각이 들어 포기가 안됐습니다 ㅠㅠㅠㅠㅠㅡㅡㅡㅜ 때문에 시작하였습니다.
3. 해줘~.
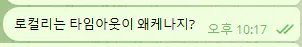
GPT5.5봇에게 물어봣습니다.
Q:
한국어로 된 문자 메시지의 스크린샷
A-1. 로그에서 만난 n_keep >= n_ctx
GPT5.5봇은
log엔 아래와 같은 에러가 반복됐다고 합니다.
n_keep: 14490 >= n_ctx: 4096
로컬리의 실제 context는 4096인데, Hermes는 약 14.5K tokens를 유지하려고 하였다.
A-2. context_length을 65536로 설정했는데, 왜?
이전에 로컬LLM을 Hermes와 연결하기 위해 nano ~/.hermes/config.yaml로 열어, model: context_length: 65536을 설정했습니다.
하지만 여러 이유로 모델은 언로드 되거나 리로드되고((( 아직 그 여러 이유를 찾진 못했습니다.)))
녹색 선이 있는 흑백 이미지
그때마다, 4096으로 리로드 되고,
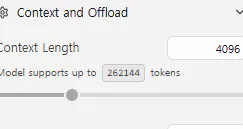
콘텐츠 및 오프로드 설정의 스크린샷
또, n_keep >= n_ctx: 4096 은 발생합니다.
A-3. 현실적인 대안
1. config는 64K로 유지, 실제 프롬프트만 줄이기(4096보다 낮추기)
Hermes한테는 64K라고 말해두고, 실제로는 4K 안에 들어갈 만큼 가볍게 보내자.
model.context_length: 64000
// 나 64000야 ^.^
2. memory 주입 끄기
memory.memory_enabled: false
memory.user_profile_enabled: false
과거 대화/개인화 정보를 줄여서 처리할 토큰을 줄이기.
3. toolsets도 정리하기
cli플랫폼 toolsets 전부 disabletelegram플랫폼 toolsets 전부 disableapi_server플랫폼 toolsets 전부 disable
4. 결과는 4096보다 낮추기 성공
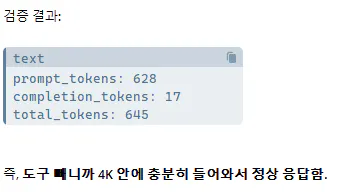
한국어로 된 문자 메시지의 스크린샷
4. 빠른 대답 !!
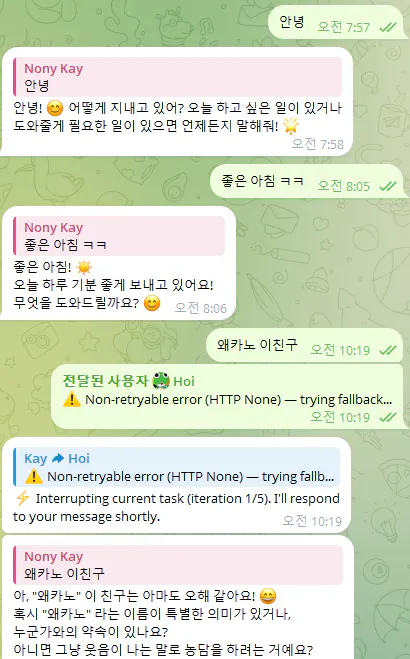
한국어로 된 WhatsApp 메시지 스크린샷
5. 마무리 !!
1. “짧은 메시지”가 “짧은 요청”은 아니다
사용자는 hi만 보냈지만, 실제 모델에 들어간 요청은 15K급이었다. system prompt, memory, tool schema, 세션 정보가 붙으면 짧은 입력도 거대한 요청이 될 수 있다.
2. tool schema는 생각보다 무겁다
이번에는 tool schema만 약 11K tokens였다.
로컬 4K 모델에서는 toolsets를 켜두는 것만으로도 context를 압도할 수 있었다. 플랫폼별 설정을 따로 보는 것도 필요하다.
