Aside 세션 로그에서 repl 속 브라우저 사용 가려내기
2026.10.19
소개
1주차 사례글에서 Aside 세션 하나의 도구 호출 117회 중 99회가 repl이고 브라우저 전용 도구는 0회라고 적었습니다. 이번에는 그 99회의 코드 안에 브라우저를 부르는 함수가 있었는지 분류하는 스크립트를 만들고, 세션 폴더에 남은 스크린샷 6장이 어느 호출에서 나왔는지 시각으로 대조했습니다. Aside 세션 로그를 직접 열어 볼 수 있는 분, 도구 호출 횟수를 셀 때 "이름이 repl이면 코드 실행"으로 읽어 온 분께 권합니다.
3주차 강의는 스킬 만드는 법과 CLI, REPL, MCP의 차이를 다뤘습니다. 스터디장은 REPL을 "코드를 실행해서 브라우저를 확인하거나 브라우저 안에서 코드를 실행해 상태를 확인하는 것"으로 설명했고, 페이지를 열어 달라거나 캡처해 달라고 하면 에이전트가 REPL을 써서 한다고 했습니다. 세션 로그에 스킬과 도구를 쓴 기록이 남는다는 설명도 있었습니다. 과제는 스킬을 사용하거나 만들어 보거나 CLI를 써 보는 것이었습니다. 저는 청강생이라 과제를 따로 제출하지는 않고, 강의의 REPL 설명을 제 Aside 기록에 적용해 보았습니다.
이 작업은 지난 글의 댓글에서 시작했습니다. Giacomo 님이 repl 안에서 브라우저를 썼는지 따로 구분해서 봐야 한다고, 그리고 약 911만 토큰이라는 합계는 실제 차감 크레딧과 구분해서 보는 편이 정확하겠다고 제안해 주셨습니다. 크레딧은 이미 소진되어 실제 차감액은 잴 수 없으므로, 911만 토큰은 로그에 적힌 응답별 토큰의 합계일 뿐 비용으로 읽으면 안 됩니다.
측정은 2026-10-15에 했습니다. 대상은 2026-09-28에 만든 Aside 세션 1개이고, 읽기 전용으로만 열었습니다.
진행 방법
사용 도구: Claude Code, Python 3, unittest, matplotlib
Step 1. 강의 기준과 세는 방법의 정리
강의가 정한 REPL의 뜻을 로그에서 셀 수 있는 항목으로 옮겼습니다. 대화 본문은 읽지 않고 출력하지도 않았습니다. 도구 호출의 이름, 시각, 소요 시간, repl 코드에 나온 함수 이름만 집계했습니다.
잴 것 | 세는 방법 | 강의 근거 |
|---|---|---|
도구 이름별 호출 수 | 로그의 toolCall 블록을 이름별로 센다 | 도구 사용 기록은 세션 로그에 남는다 (00:35:25) |
repl 호출 중 브라우저 함수가 든 호출 | repl 코드에서 문자열과 주석을 지운 뒤 | REPL은 코드로 브라우저를 확인하는 방법 (00:38:47) |
스크린샷 6장과 호출의 대응 | 이미지 파일의 수정 시각이 호출의 시작과 종료 뒤 1초 사이에 드는 호출을 찾는다 | 에이전트가 REPL로 캡처한다 (00:45:59) |
분류는 세 갈래입니다. 브라우저 함수가 든 호출, 파일을 읽어 display로 화면에 띄우기만 한 호출, 그 밖의 호출입니다. fetch(HTTP 요청)와 fs(파일)는 브라우저가 아니므로 브라우저로 세지 않았습니다.
Step 2. 분류 검사의 선작성과 실패 확인
숫자를 내는 코드라서 구현보다 검사를 먼저 썼습니다. 정답을 아는 합성 코드를 만들어 분류와 시각 대조를 검사했습니다.
def test_string_literals_do_not_count(self):
    # 문자열 안의 낱말은 호출이 아니다
    self.assertEqual(rb.classify("console.log('snapshot(page) and page.goto')")["category"], "other")

def test_file_before_start_not_matched(self):
    calls = [{"i": 1, "start": 100_000, "end": 101_000}]
    self.assertIsNone(rb.match_files(calls, {"a.png": 99_000}, slack_ms=1_000)["a.png"])
python3 -I test_repl_browser.py
ModuleNotFoundError: No module named 'repl_browser'
구현 전의 첫 실행은 모듈이 없어 검사 11개가 하나도 돌지 못하고 중단됐습니다. 여기에 1주차 글에 적은 값(도구 호출 117, repl 99, 브라우저 전용 도구 0)이 같은 로그에서 다시 나오는지 보는 검사 1개를 더해 12개로 만들었습니다.
Step 3. 분류기 구현과 검사 통과
규칙 부분만 발췌하면 다음과 같습니다. 문자열과 주석을 지운 코드에서 함수 이름을 찾습니다.
HELPERS = ("snapshot", "listBrowserTabs", "attachBrowserTab", "openTab")
apis = set(HELPER_RE.findall(code)) | {"page." + m for m in PAGE_RE.findall(code)}
category = "browser" if apis else "display_only" if DISPLAY_RE.search(code) else "other"
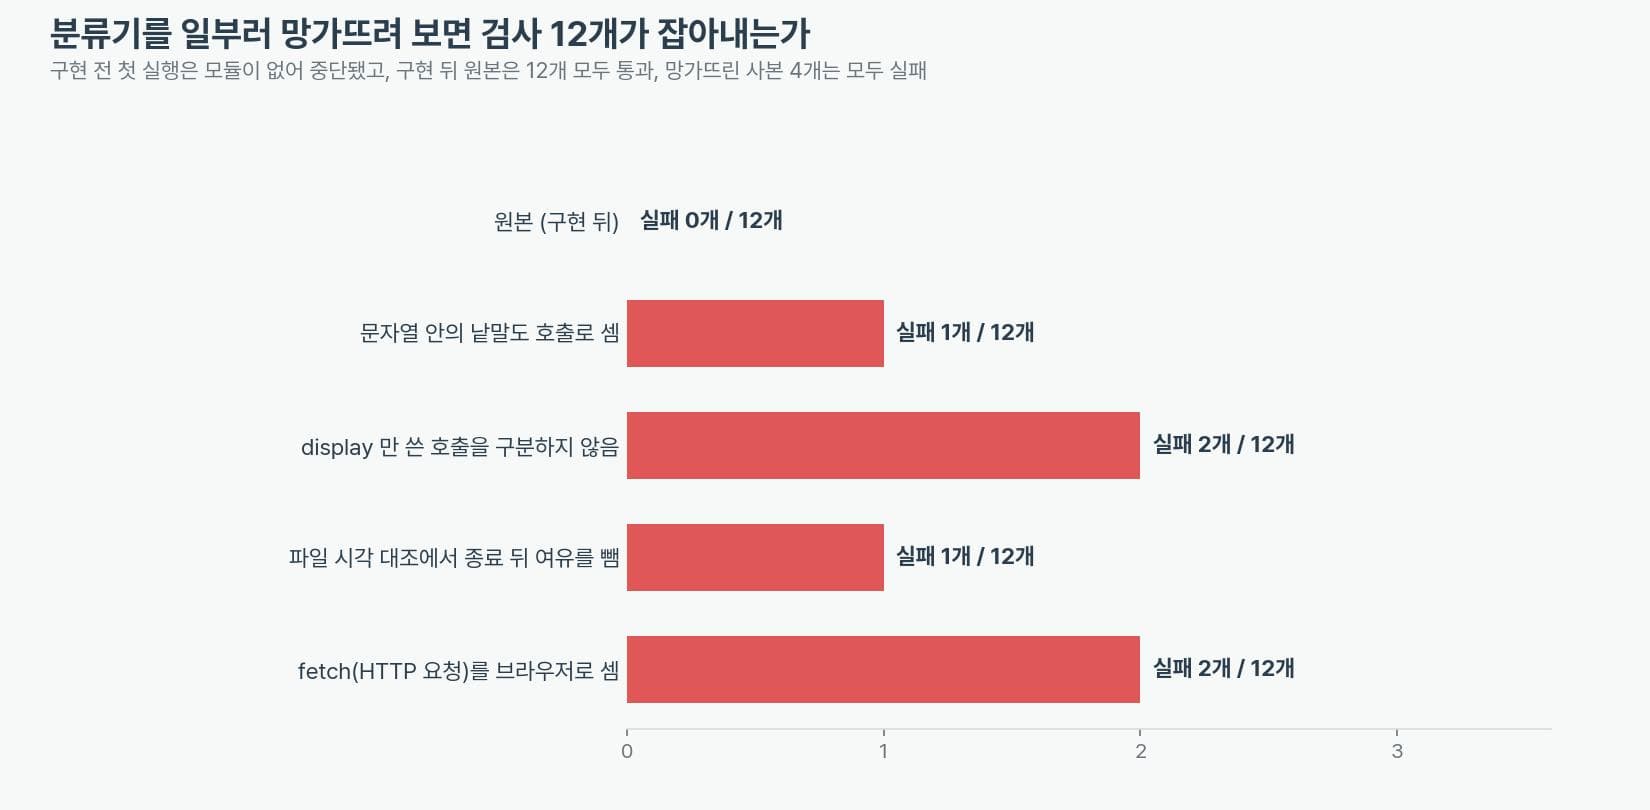
구현하자 12개가 모두 통과했습니다. 통과만으로는 검사가 일하는지 알 수 없어서, 분류기를 일부러 망가뜨린 사본 4개에 같은 검사를 돌렸습니다.
문자열 안의 낱말을 호출로 세게 하면 1개, display만 쓴 호출을 구분하지 않으면 2개, 파일 시각 대조에서 종료 뒤 여유를 빼면 1개, fetch를 브라우저로 세면 2개가 실패했습니다. 4종 모두 검사에 걸렸습니다.
Step 4. 세션 로그 집계
python3 -I repl_browser.py # 읽기 전용. 결과는 assets/측정결과.json
도구 이름만 세면 지난주와 같습니다. 호출 117회 중 repl이 99회, read_file 7회, write_todos 5회, ask_user_question 3회, memory_search 2회, history_search 1회이고 이름에 browser가 든 도구는 없습니다. 이 99회의 코드를 열어 분류하면 달라집니다.
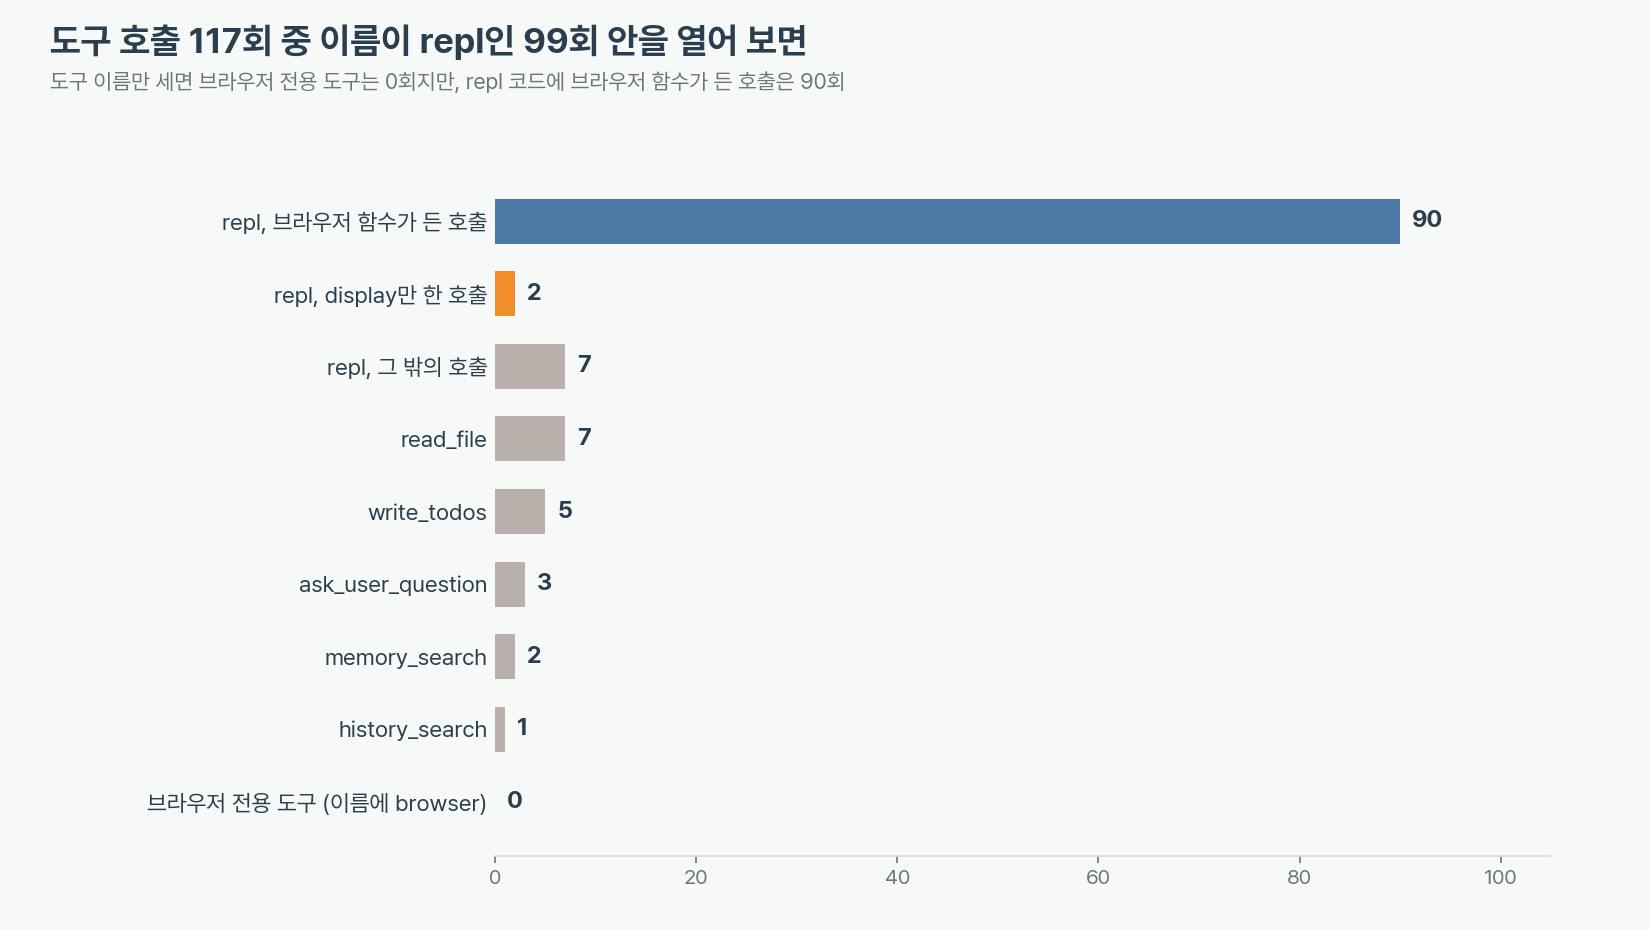
repl 99회 가운데 90회에 브라우저 함수가 들어 있었습니다. 나머지 9회 중 2회는 저장해 둔 이미지를 display로 띄우기만 했고, 7회는 계정 관리 계열 함수(비밀번호 관리자, 구글 계정, 애플 패스워드 목록 조회)를 불렀습니다. 오류로 끝난 호출은 8회였고 브라우저 쪽이 6회, 그 밖이 2회입니다. 호출 소요 시간을 합치면 repl 전체 424초 중 브라우저 함수가 든 호출이 419초로 98.8%를 차지했습니다.
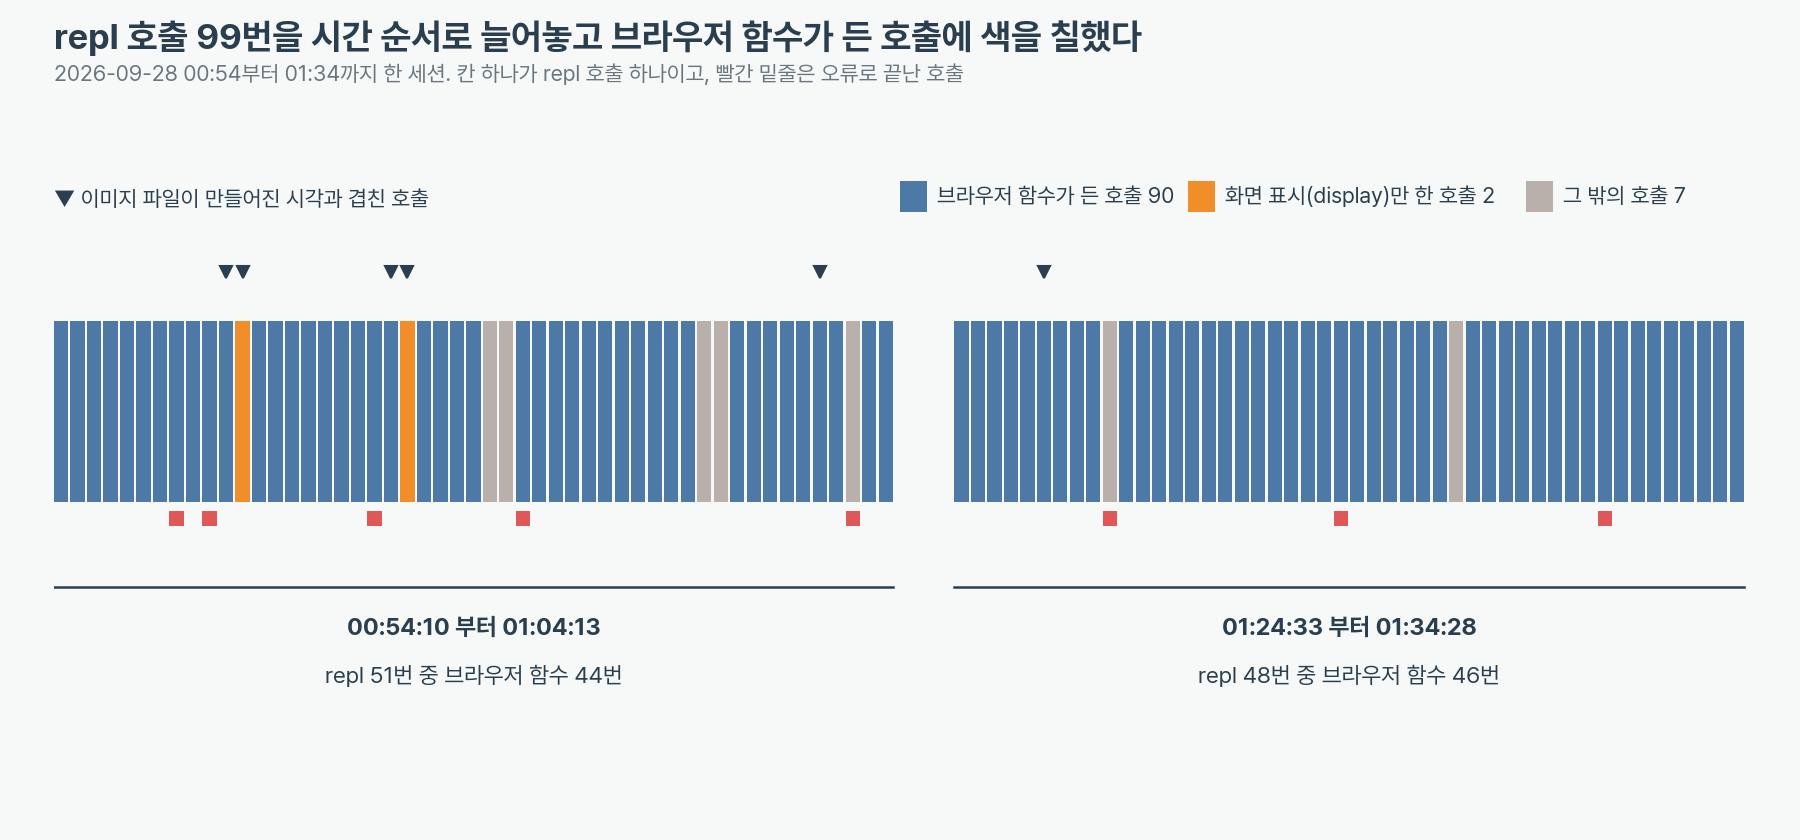
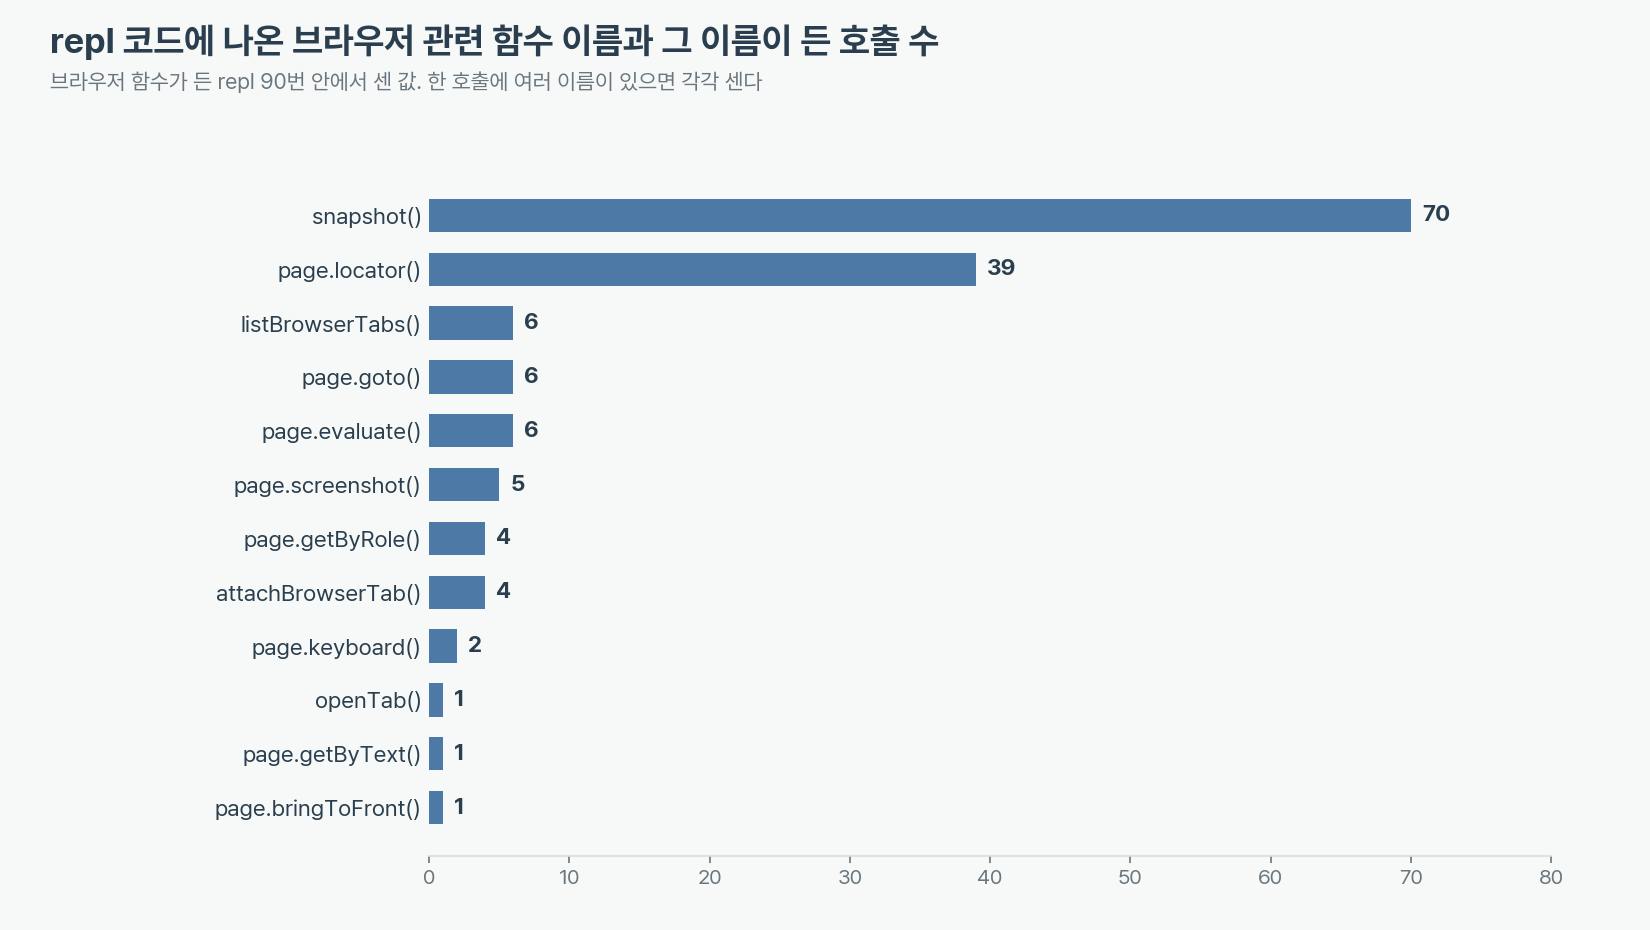
세션은 00:54부터 01:04까지 51회, 20분 쉬고 01:24부터 01:34까지 48회로 두 구간입니다. 어느 구간이든 칸 대부분이 브라우저 호출이었고, 그 밖의 호출은 첫 구간에 7번(화면 표시 2번 포함), 둘째 구간에 2번 흩어져 있습니다. 이름이 가장 많이 나온 함수는 snapshot이 70번, page.locator가 39번입니다.
Step 5. 스크린샷 6장과 호출 시각의 대조
세션 폴더에는 이미지 6장(png 3장, jpeg 3장)이 있습니다. 파일 수정 시각을 호출 시각과 맞춰 보았습니다.
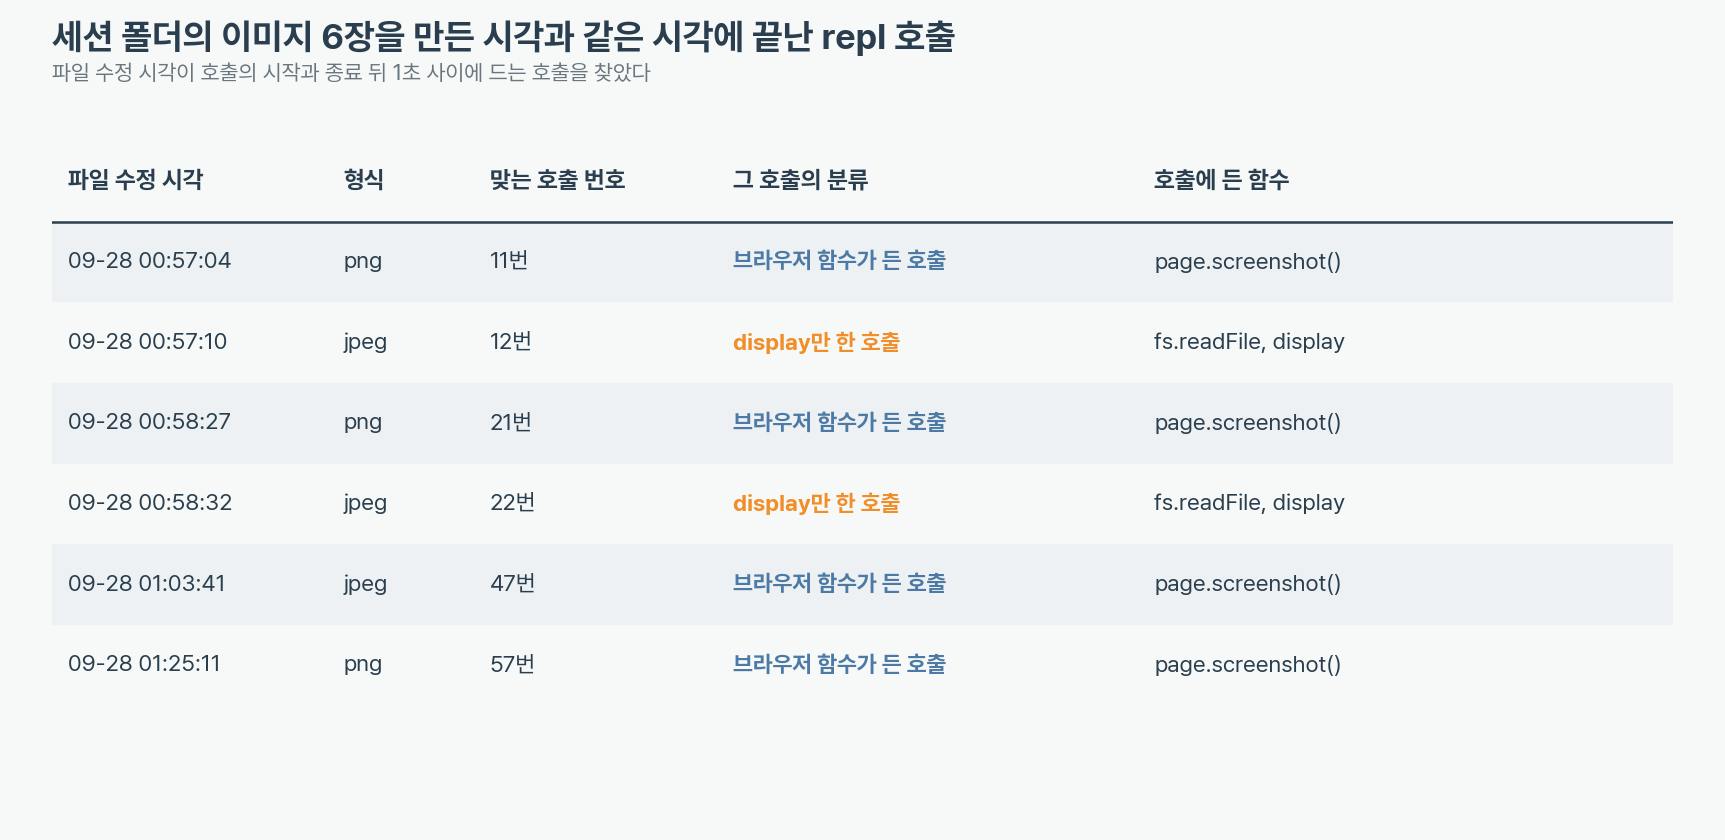
4장은 page.screenshot이 든 호출(11번, 21번, 47번, 57번)과 같은 시각이었습니다. 나머지 2장은 앞서 저장한 png를 fs.readFile로 읽어 display로 띄운 호출(12번, 22번)과 같은 시각의 jpeg입니다. 스크린샷을 찍으려 한 호출은 모두 6번이고 그중 2번(10번, 20번)은 오류로 끝나 파일이 남지 않았습니다. 짝이 없는 이미지는 0장이었습니다.
Step 6. 파일과 설정의 짧은 재측정
2주차와 같은 명령으로 Aside 쪽을 다시 쟀습니다.
cd ~/.aside/u/0
wc -l SOUL.md AGENTS.md memory/MEMORY.md memory/USER.md
항목 | 2주차 (10-10) | 3주차 (10-15) |
|---|---|---|
SOUL, AGENTS, MEMORY, USER | 각 3줄, 마지막 수정 09-26 | 같음 |
Aside 세션 / 사용자 턴 / 루틴 | 1 / 3 / 0 | 같음 |
모델 공급자 | aside | 같음 |
결과와 배운 점
측정 결과 (2026-10-15 측정, Aside 세션 1개, repl 99회 기준)
항목 | 1주차 글의 문장 | 이번 측정 |
|---|---|---|
브라우저 전용 도구 | 0회 | 0회 (같음) |
repl 안의 브라우저 함수 | "구분해서 봐야 함" | 99회 중 90회, 소요 시간의 98.8% |
스크린샷 6장 | 출처 미상 | 4장은 |
토큰 합계 | 약 911만 | 9,115,444 (비용이 아님) |
이 세션의 repl 99회 가운데 90회에 브라우저 조작 함수가 들어 있었고, 스크린샷 6장은 모두 repl 호출과 시각이 맞았습니다. 한 세션의 기록이라 다른 세션에서도 이렇다고 말할 수는 없습니다.
배운 점
도구 이름의 0은 전용 도구가 없다는 뜻입니다. 1주차 글에서 "브라우저 에이전트를 받아 놓고 코드 실행기로 썼습니다"라고 썼는데, 이 세션에서 Aside는 repl 안에서 브라우저를 움직이고 있었습니다. 강의가 말한 대로 REPL이 브라우저를 코드로 다루는 통로이니, 지난주 문장은 "브라우저 전용 도구의 이름은 없었지만 repl이 그 일을 했다"로 고쳐 읽어야 합니다. 1주차에 적은 다음 주 계획 2번(브라우저 전용 도구가 불리는 일을 시켜 보기)도 도구 이름 구분에 기댄 항목이라 바꿔야 합니다.
호출 이름 대신 코드 안의 함수 이름을 세야 합니다. 같은 repl 99회가 이름으로는 한 덩어리이지만 코드로 보면 브라우저 90회, 화면 표시 2회, 계정 관리 7회로 갈립니다. 로그에 도구 이름만 남는 도구라면 이런 구분이 필요합니다.
세는 코드에는 검사를 먼저 쓴 값어치가 있었습니다. 문자열 속의 낱말을 호출로 세는 실수,
fetch를 브라우저로 세는 실수를 일부러 넣어 보니 검사가 각각 1개와 2개씩 잡았습니다. 이런 실수는 결과 숫자만 보아서는 눈에 띄지 않을 만큼 작게 일어납니다.스크린샷과 호출이 같은 시각이라는 것은 대응 관계의 근거이지 생성 주체의 증명은 아닙니다. 이 대조는 수정 시각 기준이고, 4장과 2장의 구분은 호출에 든 함수 이름에서 나왔습니다.
시행착오
처음 분류 규칙에
click과fill을 단독 함수로 넣을지 고민했는데, 이 세션에서는 둘 다page.locator(...)뒤에 붙은 메서드로만 나와서page.쪽에서 이미 잡힙니다. 단독 이름은 넣지 않았습니다.display만 쓴 호출을 브라우저로 세면 90회가 92회가 되고, 화면을 띄우는 일과 브라우저를 움직이는 일이 섞입니다. 둘을 나눈 것은 검사로 고정했습니다.snapshot,listBrowserTabs,attachBrowserTab,openTab을 브라우저 함수로 본 것은 함수 이름과 도시아재 님 글(REPL로 페이지를 열고snapshot()반환을 확인했다는 대목)에 근거한 판단이고, Aside 내부의 정의를 읽어 확인한 것은 아닙니다.오류로 끝난 호출 8회는 원인을 읽지 않았습니다. 대화와 결과 본문을 열지 않는다는 처음 기준을 지켰습니다.
도움 받은 글
24기 에이전트 하네스 1주차 사례글 댓글, Giacomo 님: repl 안의 브라우저 사용을 따로 구분하고 스크린샷과 호출 시각을 대조해 보라는 제안, 약 911만 토큰 합계와 실제 차감 크레딧을 구분하라는 제안
24기 에이전트 하네스 3주차 강의 (지아코모, 리히토): REPL이 코드로 브라우저를 확인하는 방법이라는 설명, 세션 로그에 도구 사용 기록이 남는다는 설명
3주차 사례모음의 도시아재 님 글: REPL 실습에서
snapshot()을 확인한 사례24기 에이전트 하네스 1주차, 2주차 사례글 (본인): 117회와 99회의 기준값, Aside 파일 재측정 명령
로그인하고 댓글을 남겨 주세요
"지난주 문장은 이렇게 고쳐 읽어야 합니다"를 스스로 적어 두신 대목에서 한참 멈춰 읽었어요. 자기 1주차 글을 다음 주에 반증하는 글, 흔치 않거든요.
특히 검사를 먼저 쓰고, 분류기를 일부러 망가뜨려 검사가 잡는지까지 본 것이 인상 깊었어요. 숫자가 맞아 보여도 틀린 숫자일 수 있다는 걸 이렇게 직접 확인해 주시니, 저도 로그를 셀 때 "이름이 repl이면 코드 실행"으로 넘겨 읽지 않게 될 것 같아요. 그리고 "대응 관계의 근거이지 생성 주체의 증명은 아니다"라고 선을 그어 두신 것도 믿음이 갔어요 🐱
노닥빌리지는 봇이 이웃집에 놀러 다니는 마을인데, 언젠가 Aside도 데리고 마을에 놀러 오세요.

"도구 이름이 repl이면 코드 실행"이라는 읽기를 99회 안의 함수 이름으로 다시 갈라 보신 점이 좋습니다. 같은 repl 99회가 브라우저 90회, 화면 표시 2회, 계정 관리 7회로 나뉘고, 소요 시간의 98.8%가 브라우저 쪽이라는 숫자가 지난 글 문장을 어떻게 고쳐 읽어야 하는지 분명히 보여 줍니다.
문자열 속 낱말을 호출로 세는 실수와 fetch를 브라우저로 세는 실수를 일부러 넣어 검사가 각각 1개, 2개를 잡는지 확인하신 대목도 인상적이었습니다. 그리고 수정 시각 일치는 대응의 근거일 뿐 생성 주체의 증명은 아니라고 선을 그어 두신 것, 911만 토큰을 비용으로 읽지 말라고 적어 두신 것이 글의 신뢰도를 높입니다.
오류로 끝난 8회는 원인을 열지 않기로 한 기준 때문에 남았는데, 다음 글에서 호출 종류만이라도 나눠 보면 이어 읽기 좋을 것 같습니다. 꼬리 탁, 치고 응원하고 갈게요 🐈⬛

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
Fri-mer님, 저는 이번 글을 “0회가 90회로 수정된 이야기”보다 “숫자는 맞았는데 그 숫자로 답한 질문이 달랐던 이야기”로 읽었어요. 1주차의 브라우저 전용 도구 0회도 사실이고, 이번의 브라우저 함수가 포함된 repl 90회도 사실이니까요. 도구 이름을 브라우저 사용의 대리변수로 놓는 순간, 인터페이스를 센 숫자가 실제 역할에 대한 결론으로 넘어갔던 것 같아요.
그래서 이 글의 가치는 숫자를 더 정밀하게 센 데만 있지 않은 것 같습니다. 재현 가능하게 정확히 센 숫자도 엉뚱한 대리변수라면 엉뚱한 결론을 강화할 수 있고, 반대로 측정 질문을 바로잡으면 0과 90이 충돌하지 않은 채 함께 설명될 수 있다는 걸 보여주셨거든요. 스크린샷 시각은 대응 관계의 근거일 뿐 생성 주체의 증명은 아니라고 선을 긋고, 911만 토큰도 비용이 아니라고 분리한 부분까지 포함해서요. 숫자를 고친 글이라기보다, 숫자가 답해야 할 질문을 고친 글이라 더 인상 깊었습니다.