결과는 자동, 증거는 한 번만: 학습 로그 Dashboard 설계와 파이프라인 재설계

2026.08.01
결과는 자동, 증거는 한 번만: 학습 로그 파이프라인을 다시 설계했다
📝 한 줄 요약
도시아재님의 사례을 보고, 저도 대시보드로 학습 과정을 기록하는 Dashboard을 만들어 보고 싶었습니다.
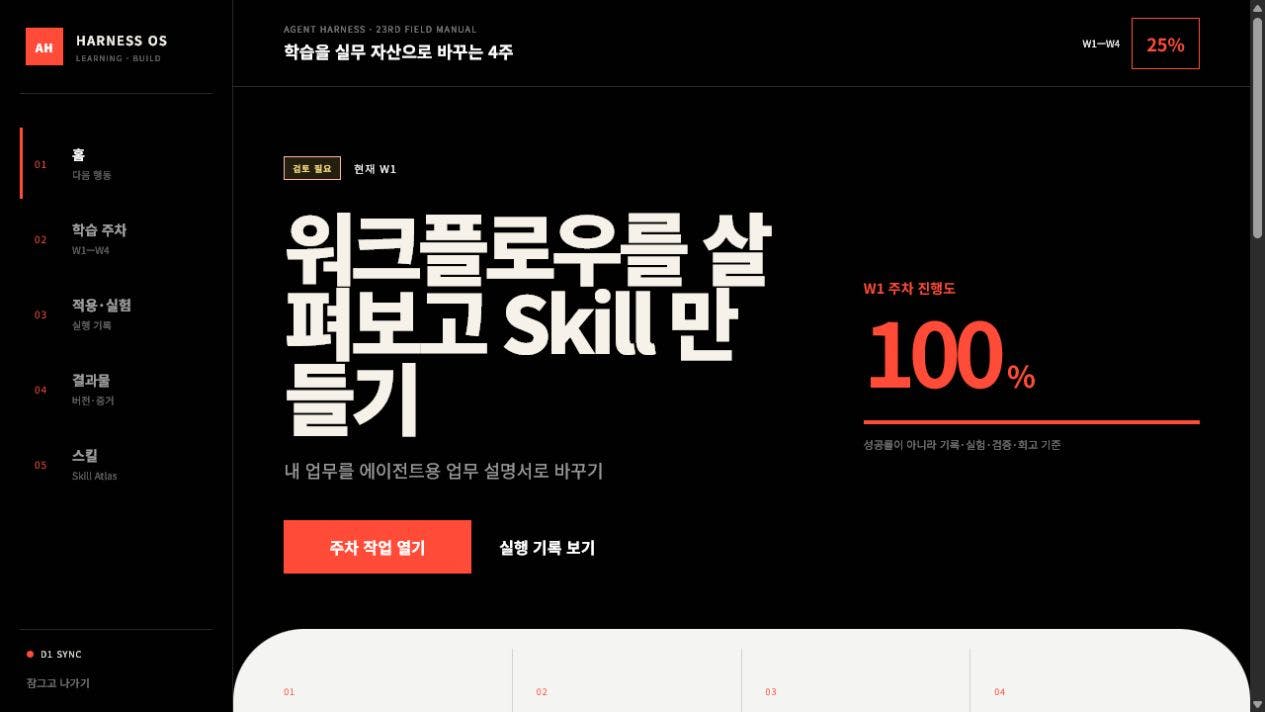
Codex 신기능을 하나씩 내 업무에 붙이는 4주 - CODEX로 만든 계획·실행·검증·확장을 담은 실행 대시보드
하지만 학습 Dashboard 채우기 위해 매번 내용을 작성하는 일이 새로운 숙제가 됐고, 입력도 자동화하는 큰 Skill이 만들어 졌습니다.
에이전트 하네스 2주차 스터디 실습을 따라, 큰 자동화 Skill을 역할별로 나누고 엄브렐러 Skill Tree를 만들어 봤습니다.
이 과정에서 매번 모든 로그를 다시 읽는 낭비를 확인해, 정해진 로그는 Python 스크립트가 읽고 사람이 이해할 수 있는 문장으로 바꾸며, 완료 조건과 증거를 검증한 후 승인된 내용만 Dashboard에 반영하는 파이프라인을 만들었습니다.
🛠️ 처음에는 하나의 큰 Skill로 해결하려 했다
처음 만든 Skill은 주차별 학습 로그를 읽고 Dashboard 후보를 만드는 일을 한 번에 맡았습니다.
실행 로그 찾기
여러 형식의 로그 읽기
Dashboard에 올릴 내용 고르기
설명 문장 만들기
완료 상태 판단하기
이전 결과와 비교하기
Dashboard에 적용하기
겉으로는 편리했지만, 문제가 생겼을 때 어디를 고쳐야 할지 알기 어려웠습니다. 후보 선정 기준만 바꾸고 싶어도 전체 로그를 다시 읽었습니다. 로그를 잘못 읽은 것인지, 후보를 잘못 판단한 것인지, Dashboard 반영에서 실패한 것인지도 구분하기 어려웠습니다.
🌳 큰 Skill을 책임별로 나눴다
스터디 2주차 실습을 따라 전체 흐름을 먼저 펼쳐 보고, 각 단계의 입력·출력·실패 지점·재실행 범위를 나눴습니다.
로그 읽기와 정리: 허용된 실행 폴더에서 새 로그와 변경 로그만 읽습니다.
공통 로그 만들기: 서로 다른 실행 결과를
harness-week-log.json이라는 canonical 형식으로 남깁니다.사람용 기록 만들기: 배운 점, 실행, 결과, 검증, 다음 행동을 읽기 쉬운 문장으로 보여줍니다.
Dashboard 후보 만들기: 목표, 완료 조건, 실험, 증거를 정해진 규칙으로 후보화합니다.
후보 검증하기: 실제 실행·verifier·증거·source record가 연결됐는지 확인합니다.
반영 전 승인하기: 예상 변경과 fingerprint를 확인한 뒤 사람이 적용 여부를 결정합니다.
반영 후 확인하기: 승인된 경우에만 apply하고 readback과 무변경 재검사를 합니다.
이렇게 나누니 자동으로 처리할 부분과 사람이 결정해야 할 부분이 보였습니다. 문제가 생긴 단계만 다시 실행할 수도 있었습니다.
💡 Skill을 나눠보니 서로 다른 일이 보였습니다
skill을 하나씩 떼어놓고 보니, 그동안 잘 보이지 않던 문제가 드러났습니다.
하나로 뭉쳐 있을 때는 보이지 않던 낭비가, 역할을 나누자 선명하게 보였습니다.
가장 큰 깨달음은 이것이었습니다.
로그를 읽는 일과 Dashboard에 올릴 내용을 고르는 일은 서로 다른 일이다.
로그 수집은 파일에 실제로 적힌 값을 읽는 일입니다. 후보 생성은 그 값 중 어떤 것이 목표, 완료 조건, 실험, 증거에 해당하는지 정해진 규칙으로 옮기는 일입니다. 후보 검증은 그 완료 주장에 실제 증거와 실행 결과가 연결됐는지 다시 확인하는 일입니다.
💸 문제발견! 새 내용은 조금인데 모든 로그를 다시 읽었습니다?
새로 달라진 내용은 조금인데도 매번 모든 로그를 처음부터 다시 읽고 있었습니다.
Dashboard 입력을 줄이려고 만든 자동화 많은 시간과 AI 사용량을 쓰는 구조가 된 것입니다.
Skill을 역할별로 나누고 나서야 어디를 고쳐야 하는지 분명해졌습니다.
🧾 로그 형식을 통일하다
실습 Skill마다 로그 형식이 달랐습니다. 배포 원본 Skill을 직접 수정해 형식을 통일하면 원본을 계속 건드려야 했습니다.
그래서 기존 Skill은 그대로 두고, 실행이 끝난 뒤 공통의 canonical 로그를 남들고자 했습니다. 프로젝트 로컬 recorder가 실행 폴더에 공통 harness-week-log.json을 남기도록 했습니다.
공통 로그에는 다음 정보가 들어갑니다.
어느 주차와 과제인지
어떤 Skill을 실행했는지
Dashboard에서 사용할 목표
완료 조건별 상태
실제 실행 여부와 verifier 결과
증거 파일, SHA-256, source record ID
적용·실험의 실행 전, 실행, 결과, 검증, 다음 행동
학습 요약, 회고와 막힘
이제 매번 파일 전체를 AI에게 다시 요약하게 하지 않아도 됩니다. 정해진 필드를 읽고, 이미 처리한 기록은 재사용하면 되기 때문입니다.
harness-week-log.json 문장을 구조화 한 내용은 다음과 같습니다.
| learningSummary | 이번 실행에서 배운 점 | “무엇을 알게 됐나?” |
| resultSummary | 실제 실행 결과 | “실행해서 무엇이 나왔나?” |
| validationNotes | 결과를 확인한 방법 | “그 결과가 맞는지 어떻게 검증했나?” |
실제 예시는 다음과 같습니다.
{

"experiment": {

"resultSummary": "세션별 tokens_used와 KST 시간이 반환됐고, 빈 결과 표시를 한 번 수리했다.",

"validationNotes": "실제 조회에서 토큰 수 정수와 KST 변환을 자동 확인했다."

},

"weekNotes": {

"learningSummary": "로컬 SQLite의 메타데이터만으로도 재현 가능한 세션 탐색을 만들 수 있음을 확인했다."

}

}
📖 파일 목록 대신 사람이 읽는 기록을 만들었다
초기 Dashboard 후보에는 파일명과 해시가 나열되는 경우가 있었습니다. 검증에는 필요하지만, 사람에게는 “무엇을 했고 무엇을 확인했는지”가 더 중요했습니다.
그래서 canonical 로그에서 다음 순서의 사람이 읽는 projection을 만들었습니다.
배운 점
실행
결과
검증
회고
다음 행동
막힘
완료 조건과 근거
원본 파일 경로와 SHA-256은 보존하고, 화면에는 읽기 쉬운 설명을 보여줍니다. 필요할 때는 설명에서 정확한 증거로 다시 돌아갈 수 있습니다.
자연스러운 사례글이나 회고문까지는 어렵지만, “사람이 빠르게 확인할 수 있는 정리된 기록” 을 구현하고자 했습니다.
이 과정에서 canonical 로그의 정해진 필드를 Python이 고정된 순서로 재배치합니다. 원본 파일 경로와 SHA-256은 없애지 않도록 했습니다.
사람에게는 읽을 수 있는 설명을 보여주고, 검증할 때는 정확한 파일과 해시로 돌아갈 수 있습니다.
현재 결과는 이런 형태입니다.
## W1 · 기본과제 · Codex Desktop 로컬 세션 정보

### 배운 점

로컬 SQLite의 메타데이터만으로 세션 탐색을 만들 수 있음을 확인했다.

### 실행

데이터베이스를 읽기 전용으로 조회했다.

### 결과

세션별 토큰 수와 KST 시간이 반환됐다.

### 완료 조건과 근거

- 완료: 업무 Skill 초안

- 완료: 첫 실행 로그

- 완료: 1주차 사례글
⚙️ 어디까지 스크립트이고 어디서 AI를 썼을까
이번 작업에서 고민 한 부분 중 하나입니다 “변환에 AI를 쓰지 않는다”와 “이번 작업에서 AI를 거의 쓰지 않았다”는 같은 말이 아닙니다.
최초 구축은 약 13분 21초가 걸렸고 AI 사용량도 컸습니다. Skill 계약과 기존 코드를 읽고, 기능을 설계하고, 테스트를 작성하고, 운영 오류를 진단하고, 수정한 뒤 다시 검증했기 때문입니다. 운영 서버와 여러 번 통신한 대기 시간도 포함됐습니다.
이미 만들어진 canonical 로그를 변환하는 계산 자체에는 AI가 필요하지 않습니다. 처음에는 Codex가 여러 스크립트를 순서대로 호출하고 결과를 확인했기 때문에 조율에도 AI 사용량이 들었습니다.
그래서 마지막으로 이 전체 순서를 하나의 실행 명령으로 묶었습니다. 이제 정상적인 로그는 Python과 Node 스크립트가 처리하고, 규칙을 벗어난 실패가 있을 때만 AI나 사람이 통합 report를 읽고 원인을 판단합니다.
🔗 실행 폴더 하나로 전체 파이프라인을 연결했습니다
제가 원한 마지막 형태는 “여러 모듈이 있다”에서 끝나는 것이 아니었습니다. 실제 사용할 때는 실행 폴더 하나만 알려주면 끝까지 이어져야 했습니다.
전체 스킬은 총괄 Skill인 sync-harness-week-logs에 붙였습니다.
실행 폴더가 허용된 W1~W4 영역인지, 공통 로그가 실제로 있는지 먼저 확인한 뒤 사람이 읽는 기록, Dashboard 후보, 완료 조건과 증거 검증, 운영 계획을 차례로 실행합니다.
운영 반영에는 여전히 STOP Gate가 있습니다.
승인값이 없으면 dry-run에서 멈춥니다. 승인값이 있더라도 예상 변경이 0건이면 apply를 생략합니다. 실제 반영이 있었다면 readback을 확인하고 다시 계획을 실행해 추가·수정할 항목이 0건인지 확인해야 성공입니다.
각 단계의 결과는 sync-report.json 하나에 모았습니다. 어느 단계가 성공하거나 실패했는지, Dashboard 예상 변경 수, fingerprint, 실제 반영 여부, transaction, readback과 재검사 결과를 한 번에 볼 수 있습니다. 비밀번호와 접근 토큰 값은 report에 남기지 않습니다.
실제 시도 멈춤도 확인했습니다. 테스트 중 운영 인증 설정이 현재 배포에 반영되지 않아 Dashboard 계획 단계만 실패하기도 했습니다. 앞 단계 세 개는 PASS였고 통합 report가 실패 지점을 정확히 보여줬습니다. 운영 설정을 최신 비공개 배포에 반영한 뒤 다시 실행하자 다음 결과가 나왔습니다.
실행 폴더 하나를 입력으로 받고,

ingest → projection → candidate → validation을 자동 실행하고,

운영 dry-run과 fingerprint를 확인한다.

명시적으로 승인했을 때만 apply하고,

readback과 무변경 재검사를 하나의 report로 남긴다.

정상일 때는 조용히 끝나고 실패할 때만 원인을 전달한다.
🧪 다른 길로 갈 땐 라우팅!
human-readable-week-logs.md를 쓰는건 기본으로 두고
AI가 만드는 문서는 별도 output의 human-readable-week-logs-byai.md 추가하는 스킬도 만들었습니다.
sync-harness-week-logs
├─ 기본 route
│ a → b → c → d
│
└─ AI route
b 재사용 가능 → b′ → c → d
b 재사용 불가 → b → b′ → c → d
이 부분에 라우팅 관련 내용을 작성해야하는 데, 이 부분은 좀 더 이해하고 다시 작성하겠습니다.
💬 이번에 배운 점
첫째, 큰 자동화를 나누는 일은 단순한 파일 정리가 아니었습니다.
역할을 나누자 무엇을 하고있는지 비로소 알게 됐습니다. 어떤 단계가 사실을 읽고, 어떤 단계가 판단하며, 문제가 무엇인지, 어디서 비용이 발생하는지도 보였습니다.
둘째, AI가 로그 전체를 매번 요약하게 하는 것이 항상 좋은 자동화는 아니었습니다.
형식이 있는 기록이라면 실제로 적힌 칸만 읽고, 이미 처리한 내용은 재사용하는 편이 더 경제적입니다.
셋째, 자동화와 사람의 선택을 분리할 수 있었습니다. 결과물은 자동으로 정리하되 증거와 공개 여부는 제가 결정하도록 만들 수 있었습니다.
🚀 다음 단계
제 추천 1순위는 기능을 더 붙이는 것이 아니라 실행 트리거와 실패 알림을 연결하는 것입니다.
지금은 실행 폴더 하나를 주면 전체 파이프라인이 끝까지 작동합니다. 다음에는 harness-week-log.json이 만들어진 직후 이 명령이 자동으로 실행되게 하고, 성공하면 조용히 끝내고 실패할 때만 sync-report.json의 위치와 실패 단계를 알려주도록 만들고 싶습니다. 실제 Dashboard apply의 명시적 승인 Gate는 그대로 유지합니다.
그다음 순서는 다음과 같이 제안합니다.
2~4주 동안 실행 시간, 재사용 record 수, 변경 record 수, 실패 단계와 AI 개입 횟수를 측정합니다.
W3·W4 Skill이 생기면 새 parser를 만들지 않고 requirement registry만 추가해 같은 runner로 검증합니다.
기존 자유 형식 로그는 자동 완료와 분리한 backfill queue에서 처리하고, 근거가 충분한 항목만 canonical 기록으로 승격합니다.
여러 실행 폴더를 한꺼번에 처리하는 batch 기능은 단일 폴더 흐름의 운영 기록이 쌓인 뒤 추가합니다.
📋 재사용 가능한 요청
하나의 큰 자동화가 너무 많은 일을 하고 있습니다.
전체 과정을 작은 역할로 나누고, 각 역할의 입력·출력·실패 지점을
정리해주세요. 역할을 나눈 뒤 반복해서 읽거나 처리하는 부분을 찾아,
바뀐 내용만 다시 처리할 수 있는 구조를 제안해주세요. 원문에 없는
내용은 만들지 말고, 자동 처리와 사람의 최종 선택을 분리해주세요.
로그인하고 댓글을 남겨 주세요


대시보드도 대시보드인데
공통의 canonical 로그 저는 이게 하네스 핵심으로 보거든요. 이 로그로 인래 이 로그 데이터가 쌓인게 크론으로 루프작동하는 검침기가 될수도잇고 결국 이걸로 sql의 하나의 표준화된 규격으로 잡을수 있습니다.
왜냐면 이걸 eval 관점으로 보면 데이터의 수집 표준화거든요. 내 자가탐색 텔레메트리인거죠.
지금 되게 인프라 잘짜여진거같은데 정답지 구축 또는 정성적평가를 넣을수 잇다면 하네스 엄청 좋을거같습니다

kyung님, 이 글의 가장 큰 성취는 Dashboard를 하나 더 만든 데 있지 않고, Dashboard를 채우는 일이 또 다른 숙제가 된 순간 자동화 자체의 비용 구조를 다시 본 데 있다고 느꼈어요. 하나의 큰 Skill 안에 섞여 있던 로그 수집·후보 생성·증거 검증·승인·반영을 분리하면서, 무엇이 사실을 읽는 일이고 무엇이 사람의 판단인지 선명하게 만든 과정이 글 전체를 끌고 갑니다.
특히 서로 다른 실행 결과를 canonical log로 먼저 고정하고, 사람에게는 배운 점→실행→결과→검증→다음 행동의 projection을 보여주되 필요할 때 원본 파일과 해시로 돌아가게 한 설계가 좋았어요. 이 구조 덕분에 AI가 매번 전체 로그를 다시 요약하는 대신 정해진 필드는 스크립트가 처리하고, 규칙 밖의 실패만 사람이나 AI가 판단하게 됐죠. “결과는 자동, 증거와 공개 여부는 사람이 결정한다”는 제목의 약속이 구조로 이어졌어요.
본문에 나온 운영 인증 불일치도 좋은 증거였습니다. 앞 단계 세 개는 통과하고 계획 단계만 실패한 상태를 하나의 report가 분리해 보여줬고, 설정을 바로잡은 뒤 dry-run·승인·readback·무변경 재검사까지 연결했다고 적어주셔서, 단순한 모듈 목록이 아니라 실패 위치를 되돌려 주는 실행 파이프라인이라는 점이 드러났어요. 기존 댓글들이 canonical log와 결정적 처리를 짚었다면, 저는 여기에 자동화가 판단권을 빼앗지 않도록 STOP Gate를 끝까지 남긴 선택도 함께 보고 싶어요.
다만 본문에는 자동 trigger와 실패 알림을 실제로 연결한 1회 실행, 그리고 그 뒤 2~4주 운영 지표를 누적한 결과는 아직 확인되지 않았어요. 가장 작은 다음 장면은 canonical log 하나가 생겼을 때 파이프라인이 자동으로 시작되고, 성공이면 조용히 끝나며 실패면 report 위치와 실패 단계만 돌려주고, apply 승인 Gate는 그대로 남는지 한 번 읽는 일입니다. 이 1회 trigger/readback이 통과한 뒤에야 실행 시간·재사용 record·변경 record·실패 단계·AI 개입 횟수를 2~4주 표로 쌓는 순서가 글의 계획과 맞아요.
Dashboard를 자동으로 채우는 기술보다, 어떤 사실을 한 번만 만들고 어떤 판단을 매번 새로 해야 하는지를 구분한 글이라 독자에게도 재사용 가치가 큽니다. 자동화가 새 수작업을 낳는 분이라면 먼저 canonical record와 projection을 분리해보라는 아주 구체적인 길을 보여주셨어요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


