이미지로 저장된 PDF의 텍스트까지 자동으로 추출후 공유까지

2026.01.24
소개
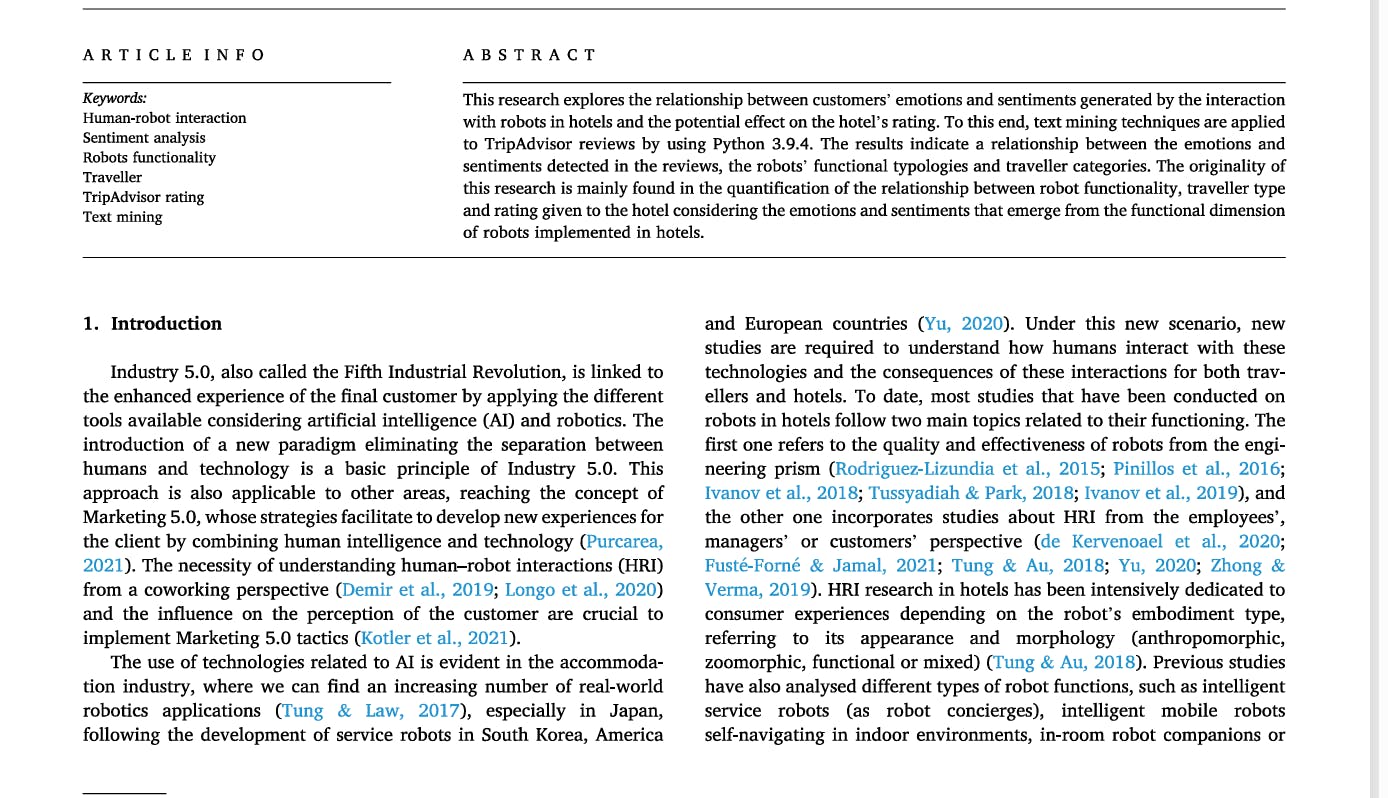
PDF를 많이 보는 일을 하고 있음. 그런데 PDF 파일 중에 이상하게도 드래그도 안되고, CTRL+F에 반응이 없는 파일이 있음. (종이를 스캔한이미지 파일이 있음)
이런 파일은 활용하기가 너무 어려워서, 기존에는 이런 파일을 보면 그냥 넘기고 다른 파일을 찾곤했었음
진행 방법
클로드 코드를 사용함
최초 조장님이 보내주신 클로드스킬을 활용
해당 스킬을 수정해서
1) OCR 기능을 추가
2) 다른사람도 사용할 수있게 ZIP 파일 형태로 제작
결과와 배운 점
원본
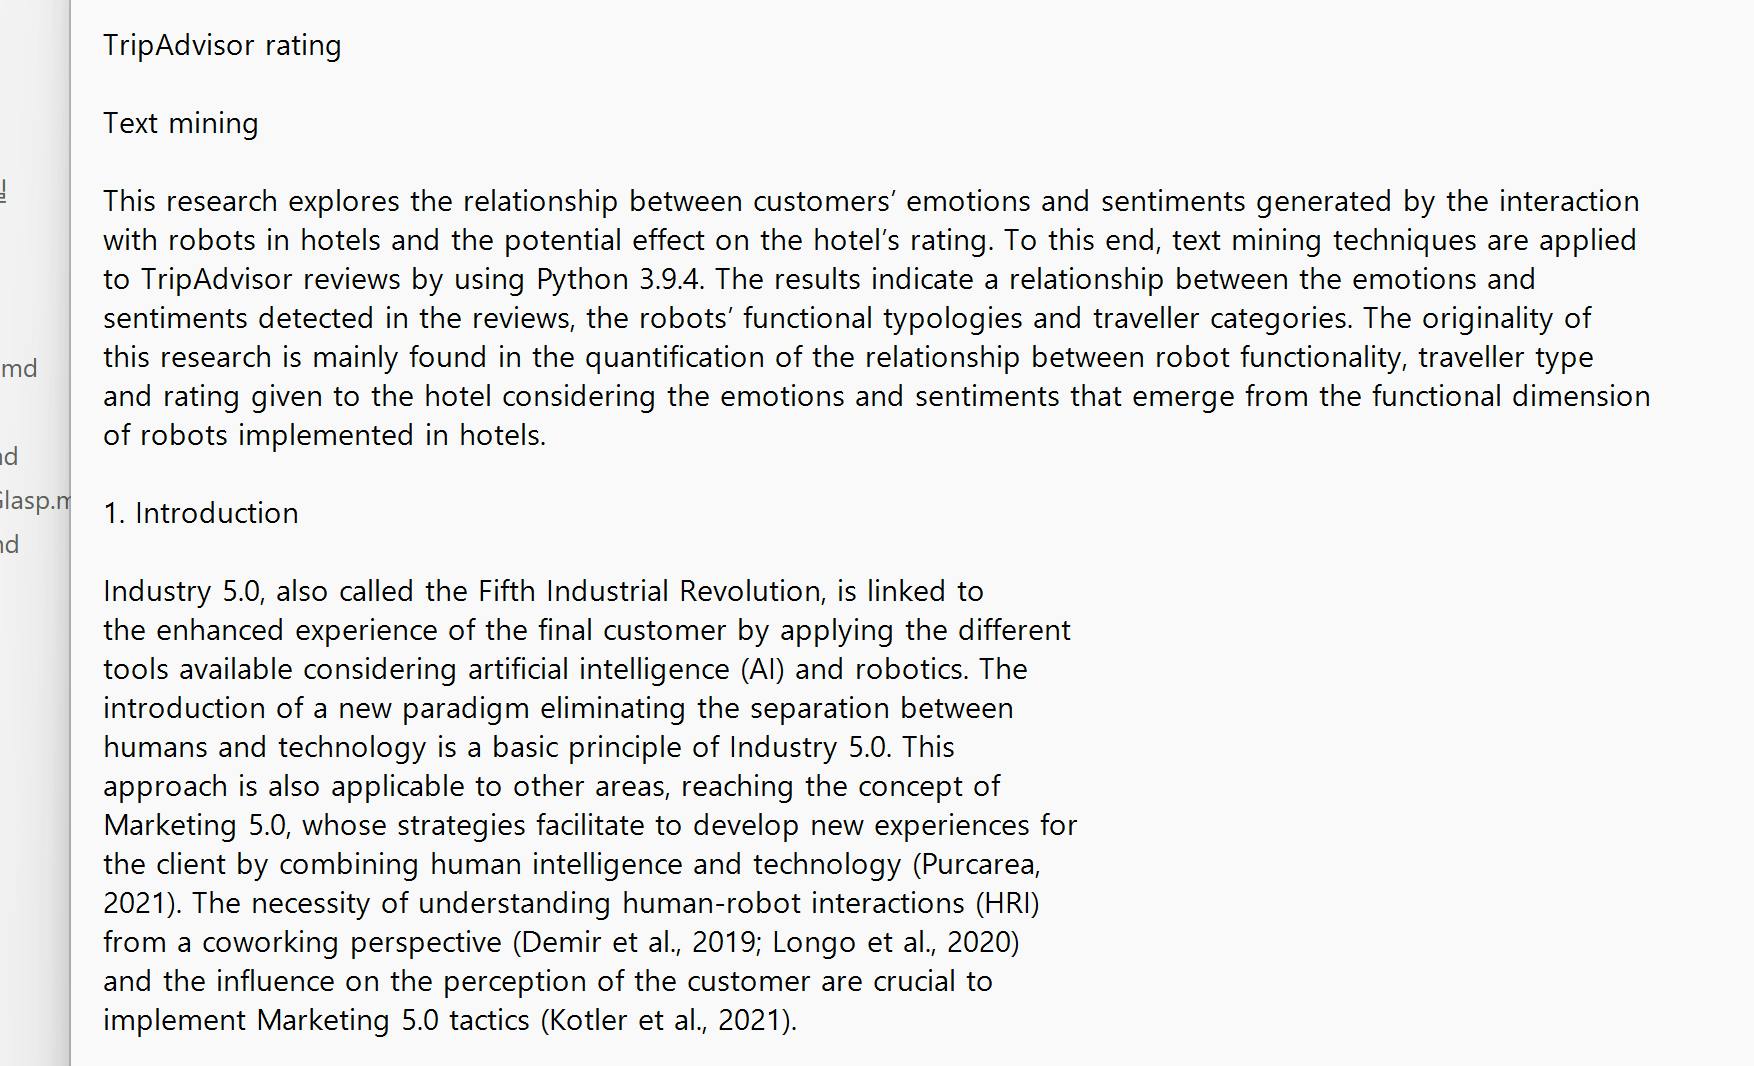
결과물
어려웠던 점
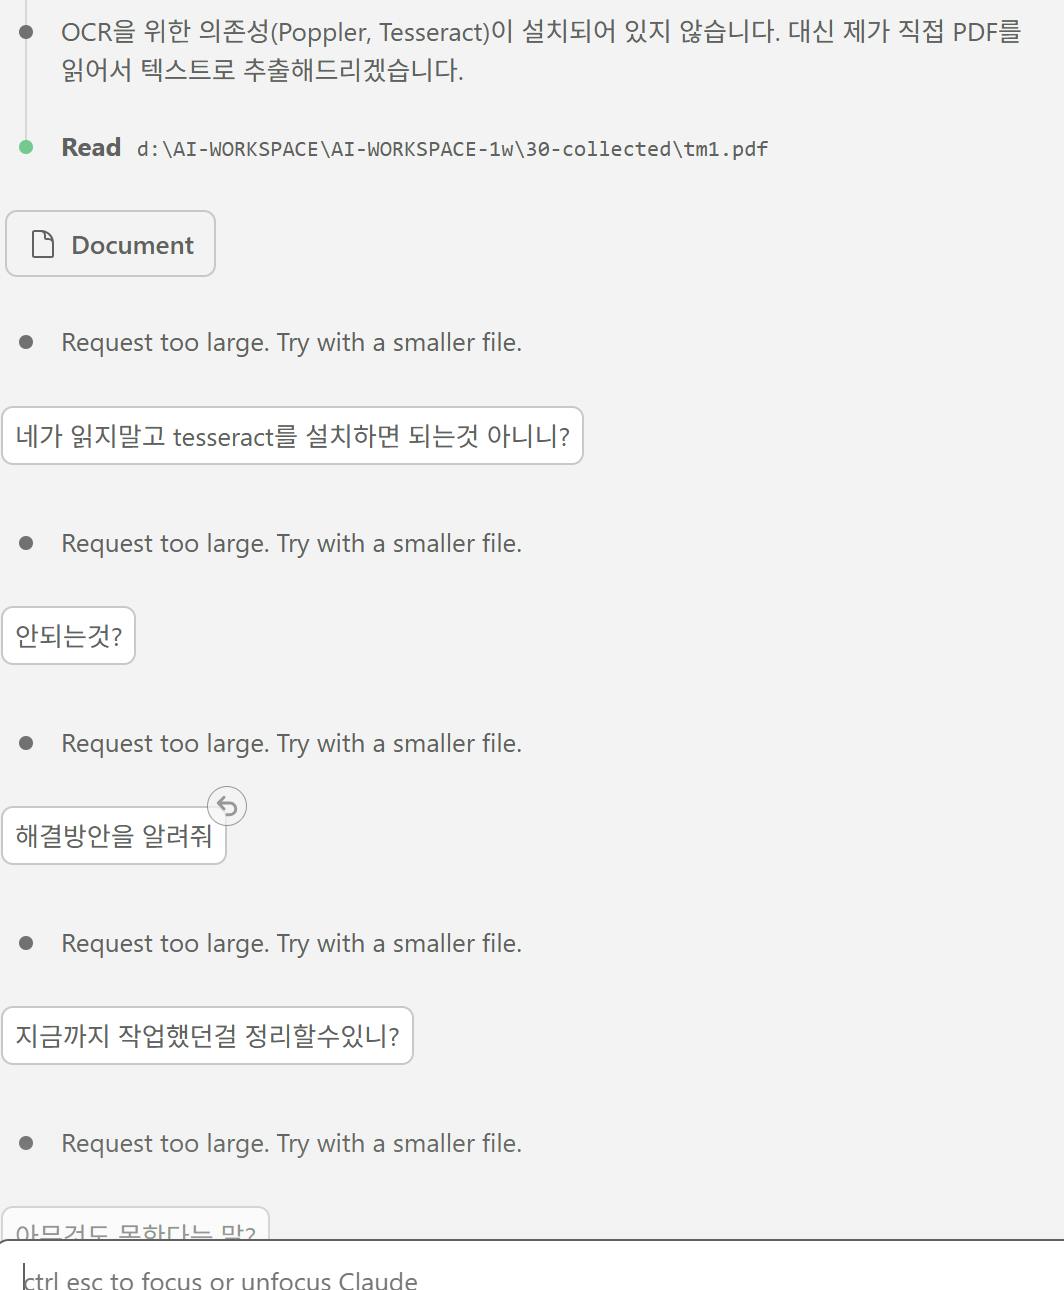
중간에 클로드코드에서 "Request too large. Try with a smaller file."라고 응답하며
작업이 멈춤. 아무키나 눌러도 전부 똑같이 응답해서,
그냥 지금까지 했던 대화를 전부 복붙해서
GPT에 넣고, 해당 대화중 쓸데없는것은 삭제하고 필요한것만 남겨
라고 말한 다음
그 대화로 다시 새 창을 열어서 클로드코드에서 작업 시작함
도움 받은 글 (옵션)
AI워크스페이스 조장님 강의 + 스킬
로그인하고 댓글을 남겨 주세요
앍... 기록물 중에 고문서 같은 경우는 OCR 처리를 많이 하는데요. 클로드 코드의 경우 자체 OCR 기능이 좋긴 하지만 상영님 말씀처럼 파일 용량 제한이 있어요.
혹시 논문이나 문서류 쪽으로 많이 보시는 거면, 스캔한 논문은 용량 괜히 큰 것도 많으니 상영님의 리사이징 방법 강추드립니다. 글자만 있는 논문은 요즘엔 웬만해선 사이즈 조금 줄인다고 많이 깨지거나 하지 않으니까요!

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


OCR을 바로 넣으셨군요!!?
좋은 아이디어입니다.
클로드코드에서 "Request too large...."
클로드코드 자체 내장 OCR을 하시면
파일 규격 제한이 5MB입니다.
오늘님의 case에서 해결방법은 2가지입니다.
* 방법1: (추천)
이미지 용량/품질을 낮춰서 편하게 클로드 코드로 OCR 하겠다
▶ 추출한 이미지를 리사이징해서 크기를 5MB이하로 줄입니다.
- 모든 이미지 줄이면 안되고
5MB넘는 기준 사이즈 크기 확인
>> 일정 사이즈 크기의 이미지만 줄이도록 조건처리
>> 조건에 맞는 이미지 OCR처리
※ 클로드 코드 내장 이미지OCR 약 +/-2000토큰 정도 사용.
* 방법2: 이미지의 용량/품질은 그대로 두고 이미지를 분석하겠다.
▶ OCR 파싱 개발, AI API 활용
- AI사용: 돈/토큰은 발생하지만 딸각으로 쉬움
- OCR도 파고들면 다양성에 case 커스텀해야 함. 피곤함.
* 이미 제가 드린 PDF 추출스킬에 Pillow라는 라이브러리가 들어있습니다.
함수 기능 중 image.resize()라는 기능을 사용하면 PDF 추출시 이미지 크기 한도를 정하여 리사이징 및 특정 수준으로 변경가능합니다.
- 텍스트가 아닌 이미지도 만나시게 될텐데
그것만 더 정제되면 좋을 것 같아요(이것도 깊어지는 영역)
- 불필요한 이미지, 품질 및 비표준 이미지도 많을텐데
불필요한 글자나 이상한 문자 등이 생기거든요
오늘도 아웃풋!!!
화이팅입니다!!