바이오 데이터 분석팀 AX 제안서 최종판과 PoC 설계
2026.10.26
소개
24기 AX코칭 4주차 최종 과제 글을 발표에서 받은 질문과 피드백으로 보강한 최종판입니다. 4주 동안 진단해 온 바이오 데이터 분석팀에 대해 AX 제안서를 완성하고, 사람과 AI의 역할을 나누는 4대 역할 장표와 시제품 두 개, 활용 중심 교안 두 편을 만들었습니다. 이번 판에는 사례글 댓글로 받은 질문 세 가지에 대한 답, AX 전후 비교표, 실제 리포트로 확인할 PoC 설계, 경영자에게 드리는 의사결정안을 더했습니다. 고객 조직을 진단해 제안서와 교안을 쓰는 AX 코치, 그리고 시제품 결과를 실제 PoC로 이어 가는 방법이 궁금한 분께 도움이 될 것 같습니다.
대상 조직은 제 경력을 바탕으로 구성한 가상 조직입니다. 병원과 제약사의 의뢰로 NGS 유전체 데이터와 세포 이미지를 분석해 리포트로 돌려주는 약 120명 규모 회사의 바이오인포 분석팀입니다. 실존 회사와는 일치하지 않고, 시제품 데이터는 전부 합성입니다.
과제 | 본문 위치 |
|---|---|
1. AX 진단 제안서 완성과 4대 역할 장표 | Step 1, Step 2, Step 6, Step 7 |
2. NotebookLM MCP 연결 | Step 5 |
3. 구현 기술 최신 자료 조사와 노트북 등록 | Step 5 |
4. 구현 교육 교안 작성 | Step 3, Step 4, Step 5 |
5. 사례 포스팅 | 이 글 |
진행 방법
사용 도구: Claude Code, NotebookLM(교안 제작 스킬 notebook-research-builder, NotebookLM MCP), codex와 Gemini CLI(교차 검수)
Step 1. 고객 조직의 문제와 진단
1주차 진단서와 2주차 청사진을 거쳐 문제를 세 가지로 좁혔습니다.
우선 문제 | 지금 | 구조적 원인(가설) |
|---|---|---|
검체 ID 불일치 | 샘플시트를 의뢰 정보에서 옮겨 적음 | 인계 시점의 대조 기록이 남지 않음 |
팀장 전수 대조 | 분석팀장이 초안 전체를 원자료와 대조 | 검토 항목이 문서화되지 않아 매 건 전체를 다시 봄 |
판단 근거의 개인 의존 | 담당자의 경험과 메모 | 해석 문구와 변이 분류 기준이 형식까지만 표준화됨 |
세 문제는 모두 인계 지점에서 사람의 기억과 수작업에 기대는 곳입니다. 프로세스 청사진에 인계 지점을 그려 보니 8곳 가운데 양쪽에서 확인하는 곳은 4곳뿐이었습니다. 서비스 청사진에서는 결과 문의와 오류 제기를 받는 내부 단계가 없는 등 끊긴 구간 다섯 군데가 나왔습니다. 그래서 최종 고객가치를 "다른 환자의 결과나 틀린 리포트를 받지 않는 것"으로 정했습니다.
Step 2. 사람과 AI의 역할 재설계
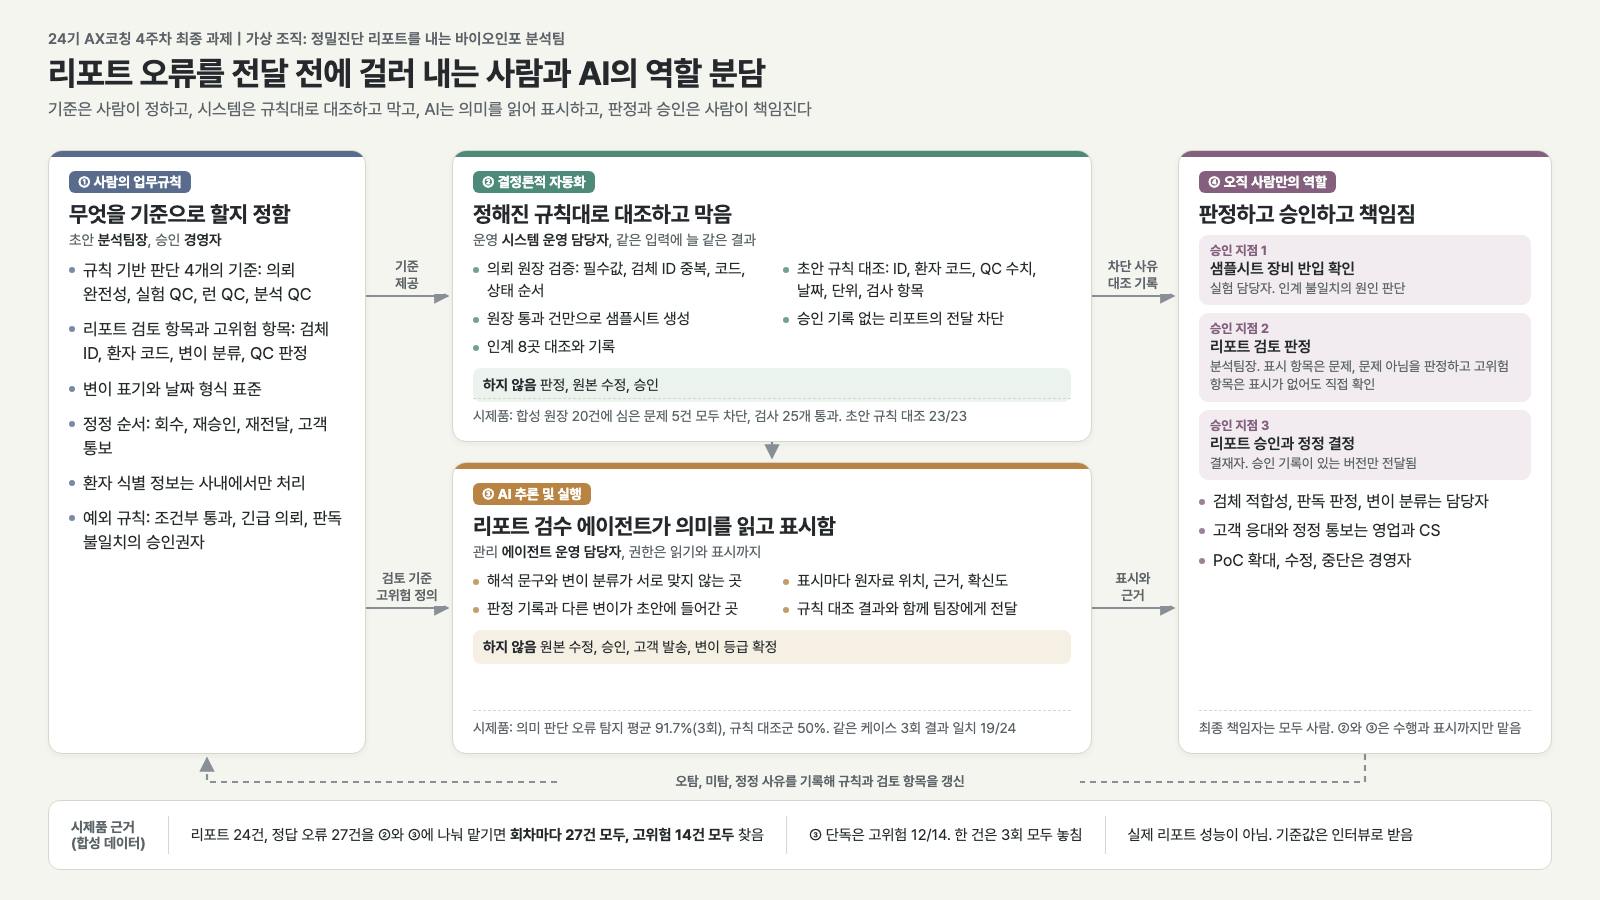
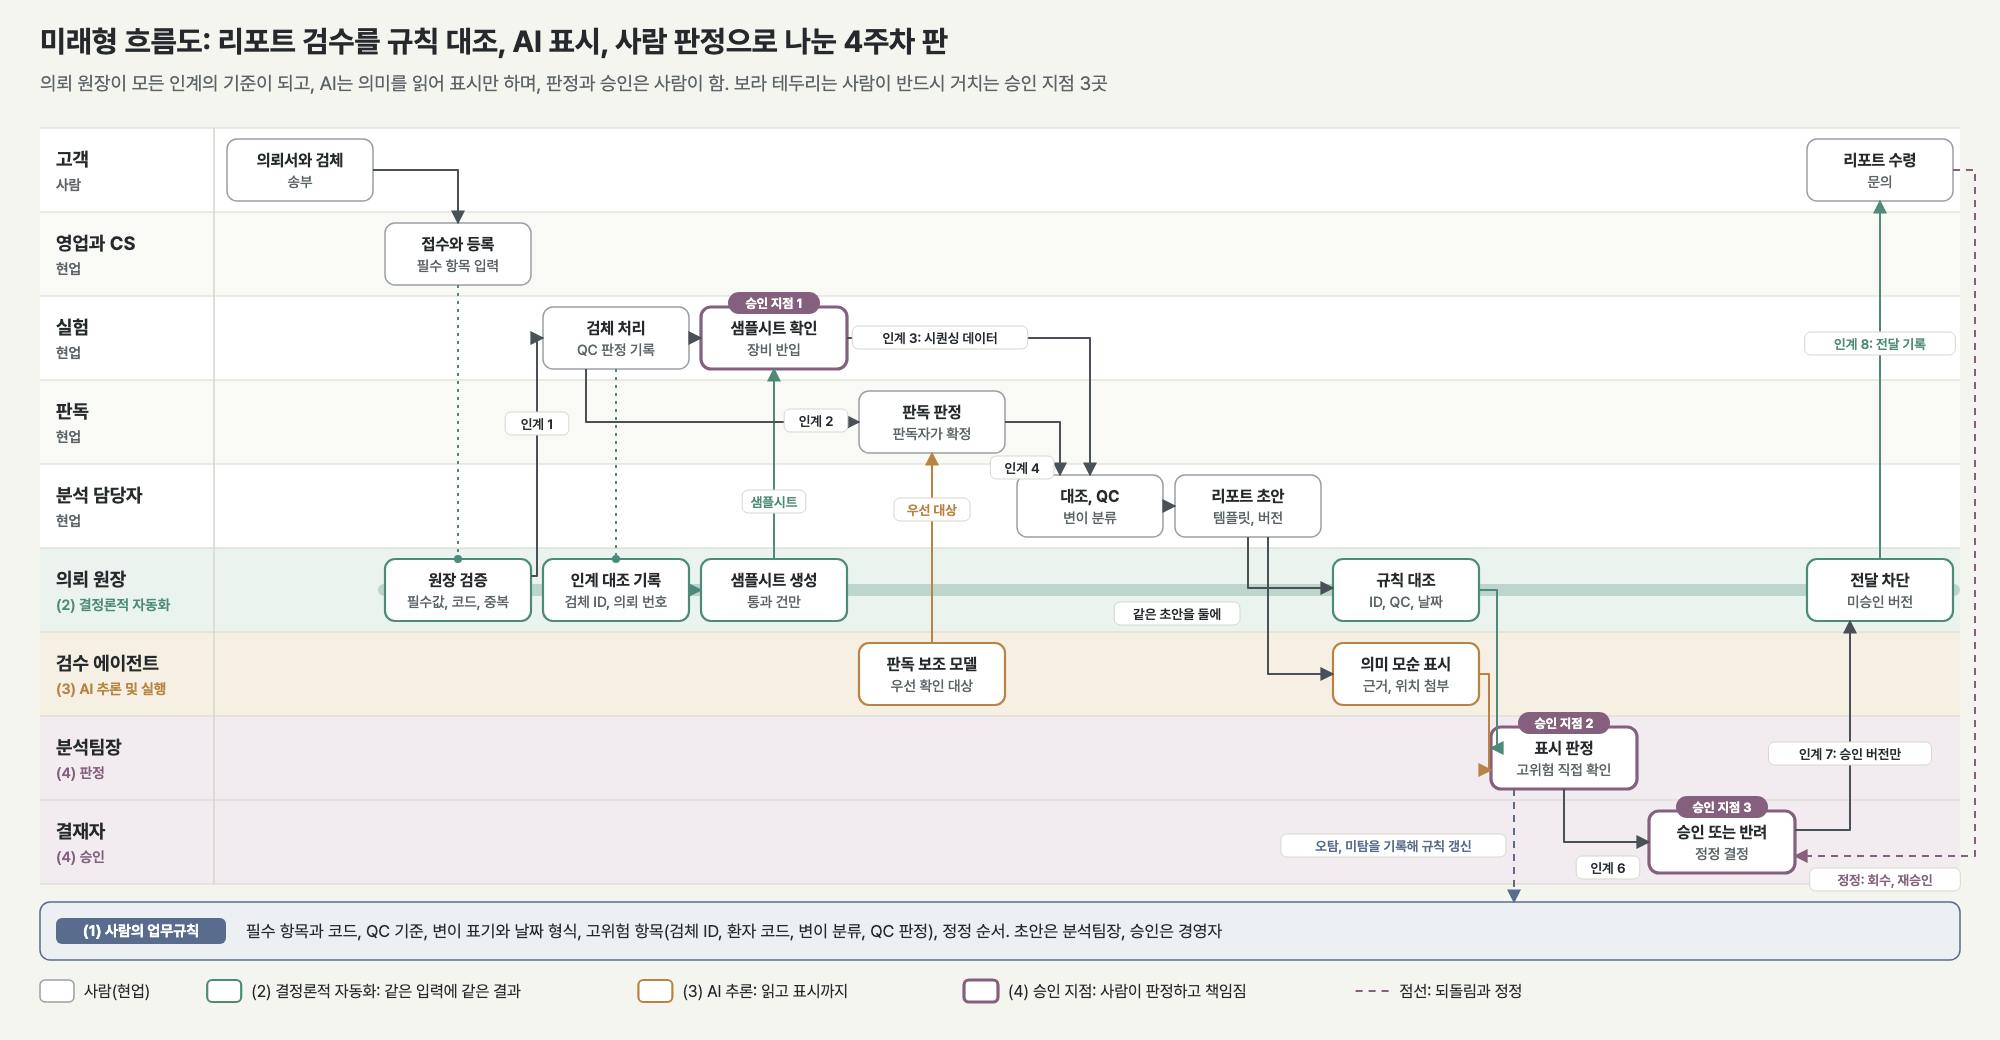
기준은 사람이 정하고, 시스템은 규칙대로 대조하고 막고, AI는 의미를 읽어 표시하고, 판정과 승인은 사람이 책임집니다. 사람이 반드시 거치는 승인 지점은 세 곳(샘플시트 장비 반입 확인, 리포트 검토 판정, 결재자 승인)입니다.
업무 16개 행에 역할을 배정해 보니 결정론적 자동화가 11행으로 가장 많았고, AI 추론은 판독 선별과 리포트 검토 두 단계에 그쳤습니다. 이 조직의 오류가 주로 옮겨 적기와 대조 누락에서 생기므로 자동화 비중이 가장 컸습니다. 자동화와 AI를 가른 질문은 "같은 입력에 늘 같은 답이 나와야 하는가"였습니다. 미래형 흐름도에서는 리포트 검수를 AI 상자 하나로 그리던 3주차 초안을 바꿔 규칙 대조, AI 표시, 팀장 판정을 각자의 레인에 나눠 그렸습니다.
Step 3. 구현 기술: 시제품 두 개
역할 배정이 맞는지 보려고 결정론적 자동화(같은 입력에 늘 같은 결과를 내는 고정 규칙)와 AI 검수를 각각 시제품으로 만들어 합성 데이터로 시험했습니다. 두 시제품 모두 검사를 먼저 쓰고 실패를 본 뒤 구현했습니다.
시제품 A (결정론적 자동화): 의뢰 원장 검증, 샘플시트 생성, 인계 대조, 리포트 전달 차단을 파이썬으로 만들었습니다. 합성 의뢰 20건에 일부러 심은 문제 5건을 모두 찾았고 정상 행은 하나도 잘못 막지 않았습니다. 리포트 9건 가운데 승인 조건을 갖춘 4건만 전달 가능으로 나왔습니다.
$ bash run_all.sh
원장 20건 중 통과 15, 차단 5
샘플시트 15행 생성, 사유 목록 5건
인계 대조 불일치 1건
전달 가능 4건, 차단 5건
$ python3 -m pytest -q
25 passed
시제품 B (AI 검수 에이전트): 도구를 모두 끄고 읽기와 표시만 허용한 에이전트가 리포트 초안과 원자료를 대조합니다. 1차 시험은 8건을 모두 찾았지만 오류를 한 군데씩만 심은 쉬운 시험이어서 믿지 않았습니다. 2차에서는 초안 24건에 정답 오류 27건(고위험 14건)을 넣고 세 번씩 반복해 고정 규칙 대조군과 비교했습니다.
지표 | 에이전트 3회 평균 | 규칙 대조군 |
|---|---|---|
규칙으로 판정되는 오류 23건 | 91.3% | 23/23 |
의미 판단이 필요한 오류 4건 | 91.7% | 2/4 |
고위험 탐지 | 매회 12/14 | 12/14 |
둘을 합친 탐지 | 세 회차 모두 27/27, 고위험 14/14 |
어느 한쪽만으로는 고위험 14건 가운데 2건씩 빠졌고, 둘이 놓친 오류가 겹치지 않아 합치면 다 찾았습니다. 규칙 대조군의 잘못된 경고 세 건은 같은 변이를 다른 약어로 적거나(p.V600E와 p.Val600Glu) 날짜를 점과 줄표로 달리 적은 표기 차이였고, 그래서 변이 표기와 날짜 형식 표준을 업무규칙에 넣었습니다. 합성 24건의 결과라 실제 리포트 성능은 Step 7의 PoC에서 따로 재야 합니다.
Step 4. 에피소드 11 기준의 교안 분량 측정
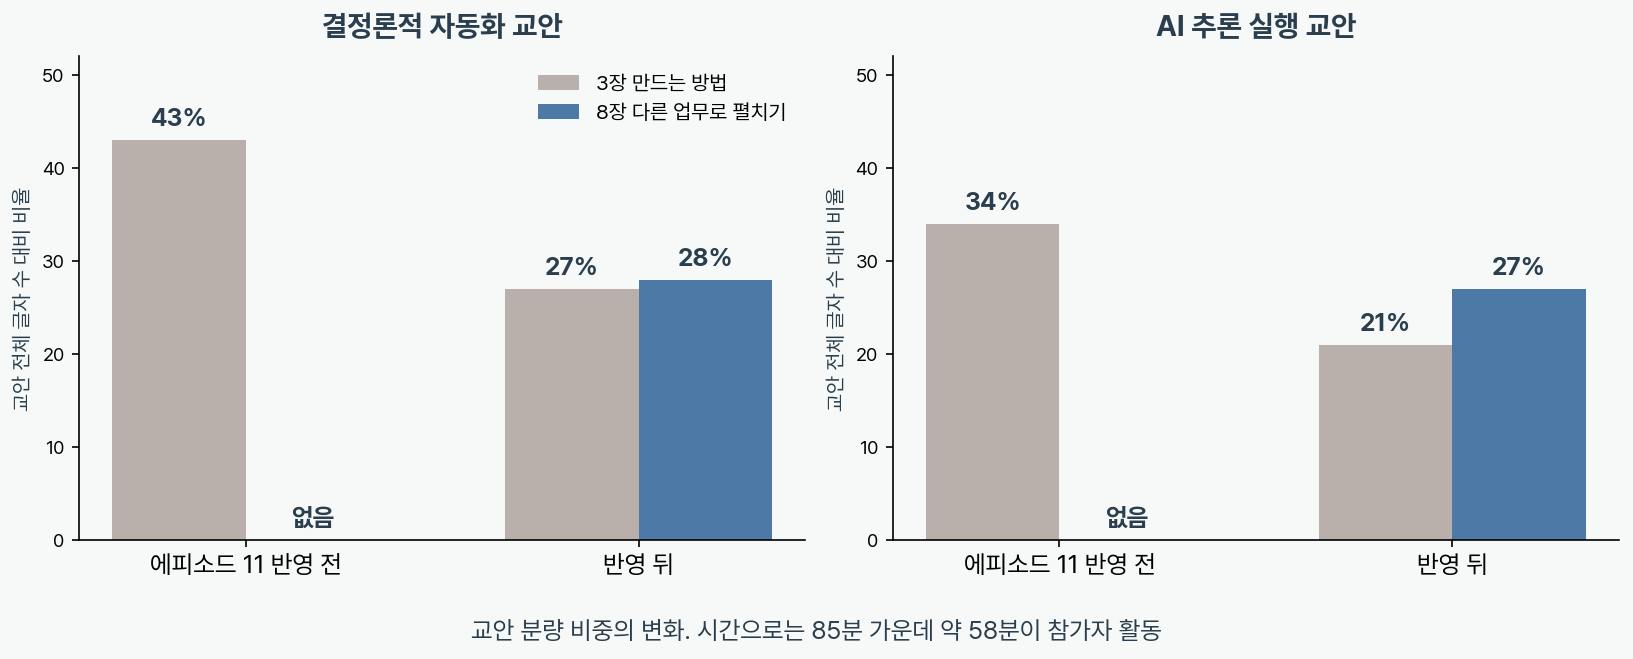
두 영역의 교안을 거의 다 썼을 때 김길호 스터디장님의 「슬기로운 AX 코치」 에피소드 11이 올라왔습니다. 교안의 무게를 만드는 방법보다 고객이 자기 조직의 활용 아이디어를 찾는 과정에 두어야 한다는 글이었습니다. 이 기준으로 장별 분량과 활용 관련 단어를 셌습니다.
교안 | 3장 만드는 방법 | 4장 같은 업무 시험 | "응용, 다른 업무, 아이디어, 대입" |
|---|---|---|---|
결정론적 자동화 | 43% | 9% | 0회 |
AI 추론 실행 | 34% | 16% | 0회 |
분량이 "이렇게 만드세요"에 몰려 있었고, 원리를 다른 업무로 펼치는 절은 없었습니다. 처음에는 Claude Code가 8장을 바로 써 주었습니다. 응용 후보표가 그럴듯했지만 근거가 없어 이 표는 쓰지 않았습니다.
Step 5. 교안 제작 스킬을 이용한 8장 재작성
배포된 교안 제작 스킬은 "모든 문장은 노트북에서"가 원칙입니다. 기존 노트북 두 개를 원천으로 프로젝트를 만들고, 검색 계획, 수집 결과, 목차, 초안의 네 지점에서 제가 확인했습니다.
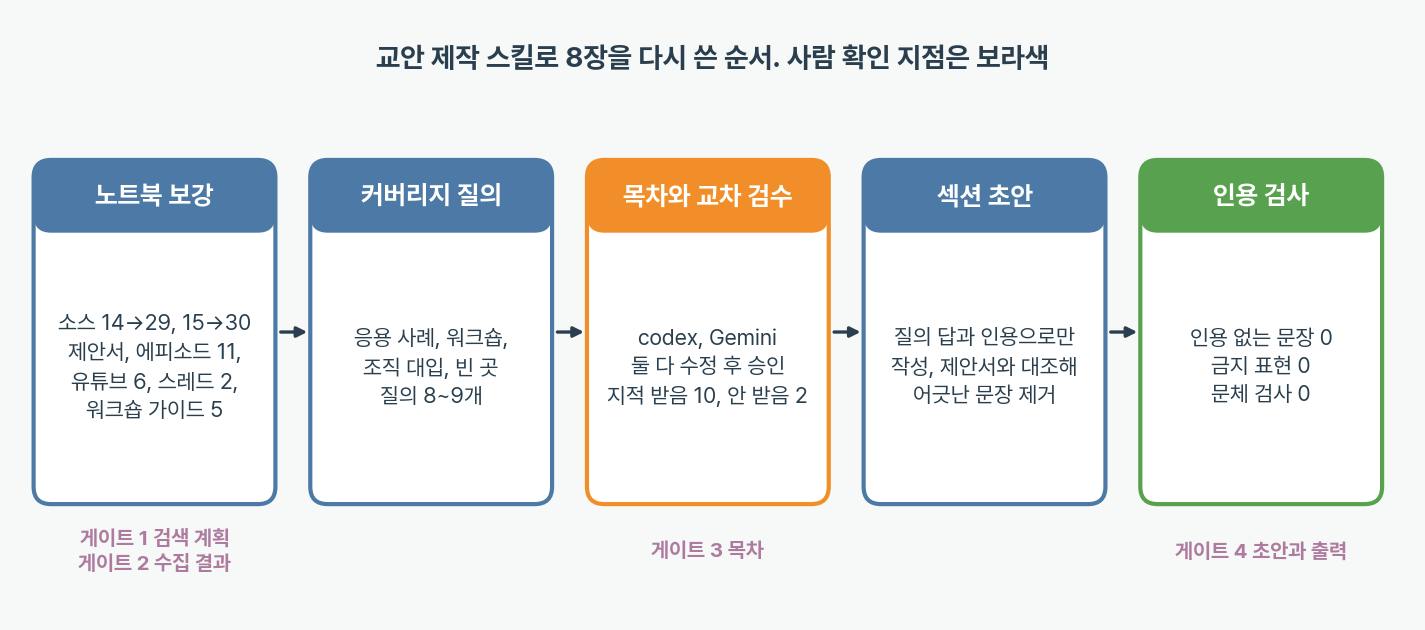
노트북 보강: 최종제안서와 에피소드 11을 먼저 넣고, 워크숍 진행법이라는 빈 곳을 채우려고 유튜브 6개, 스레드 2개, 워크숍 진행 가이드 5개를 넣었습니다. 소스가 14개에서 29개, 15개에서 30개로 늘었습니다.
MCP 연결: GitHub 후보 8개를 스타, 최근 3개월 커밋, 열린 이슈로 비교해 커밋과 릴리스가 가장 활발한 저장소를 골라 Claude Code에 MCP 서버로 등록했습니다. 공식 API가 아니고 로그인 쿠키가 로컬에 저장되는 위험이 있어 민감 문서는 올리지 않았습니다.
교차 검수: 목차를 codex와 Gemini에 읽기 전용으로 동시에 맡겼고, 둘 다 "수정 후 승인"이었습니다.
초안과 검사: 섹션마다 질의 답과 인용으로만 쓰고, 인용 없는 문장을 스크립트로 셌습니다.
$ uv run nrb.py check -P 2026-10-18_AI추론실행-교안 --draft draft/08-원리펼치기.md
인용된 소스 16개 / 노트북 소스 30개
✓ 모든 문장이 노트북 소스에 근거함
MCP 도구로 같은 노트북에 "AI 검수 에이전트를 다른 업무에 옮길 때 가장 먼저 정할 세 가지"를 물었더니 검토 시점, 결과를 받아 넘기는 주체, 사람이 승인할 책임 범위가 나왔고, 이 세 질문이 8장 활용 설계표가 됐습니다. 새 8장은 다섯 단계로 짰습니다. 원리 한 줄 쓰기, 같은 조직의 다른 인계 표 채우기, 다른 업무 사례를 규칙과 AI 두 열로 나누기, 활용 설계표 작성, 사용 사례 카드 워크숍 순서로 진행하고, 85분 가운데 약 58분은 참가자가 직접 작업합니다.
Step 6. 받은 질문 세 가지와 AX 전후 비교
사례글에 달린 질문 세 개에 답을 정리해 발표에서 함께 보여 드렸습니다. 첫 질문은 효승 님이 남긴 것으로, AX 전후로 무엇이 바뀌고 어떤 문제에 어떤 AX가 어떤 효과를 주는지였습니다. 세 문제로 답했습니다.
문제 | 지금 | 바뀐 뒤 | 기대 효과 | 잴 값 |
|---|---|---|---|---|
검체 ID 불일치 | 샘플시트를 손으로 옮겨 적음 | 원장에서 만들고 검증 통과 건만 장비로 | 다른 환자 결과가 나갈 위험 감소 | 정정 리포트 건수 |
팀장 전수 대조 | 초안 전체를 원자료와 한 줄씩 | 규칙 대조와 AI 표시, 팀장은 표시와 고위험만 판정 | 검토 시간 감소, 전달 전 발견 증가 | 검토 시간, 전달 전 발견 건수 |
판단 근거의 개인 의존 | 담당자의 경험과 메모 | 규칙 판단 4개와 표기 형식을 문서로 | 누가 봐도 같은 판정 | 담당자별 판정 차이 |
현재값과 목표값은 인터뷰로 받기 전이라 비워 두었습니다. 순효과는 개선분에서 잘못된 경고를 처리하는 시간, 운영 비용, 새로 생기는 위험을 뺀 값으로 정의했습니다.
나머지 두 질문은 갓생오리 님이 1, 2주차 글에 남겼습니다.
남길 확인 행동의 기준. 기준을 둘로 정했습니다. 틀리면 되돌릴 수 없는 지점(결과가 나가기 전, 검체 정보 대조)이고, 다른 확인이나 기록이 이미 막지 않는 확인입니다. 확인 행동 후보 13개에 적용하니 6개는 사람에게 남고(승인 지점 2와 3 포함), 6개는 자동화의 차단 규칙으로 옮겼으며, 1개는 팀장 판정 양식에 합쳤습니다. 오류 빈도는 인터뷰에서 받아 확정합니다.
다음 판 검증 담당 에이전트. 새 에이전트에게 맡겼습니다. 같은 에이전트는 이전 판의 기억으로 빈칸을 채울 수 있어서, 진단서와 이전 복원 결과를 보지 않은 에이전트에게 질문지와 교안만 줬습니다. 시제품 B도 같은 원칙으로 케이스마다 새 세션으로 호출하고, 다른 케이스와 정답 목록을 읽지 못하는지 검사로 확인했습니다.
Step 7. PoC 설계와 경영자 의사결정안
시제품은 합성 데이터에서 구조가 작동한다는 것까지만 보여 줍니다. 실제 리포트에서도 같은 효과가 나는지는 PoC로 확인하도록 설계했습니다.
항목 | 내용 |
|---|---|
가설 | 규칙 대조와 AI 표시를 함께 붙이고 팀장이 판정하면 검토 시간이 줄고 전달 전 발견 오류가 늘 것으로 기대 |
대상 | 이미 전달된 리포트. 정정 이력이 있는 건의 실제 오류와, 검증 책임자만 아는 위치에 넣은 오류를 정답으로 |
진행 | 1차 후향 검증, 2차 현행 병행. 병행 중에도 팀장은 기존 방식으로 검토를 끝냄 |
권한 | 읽기와 표시만. 원본 수정, 승인, 고객 발송 금지. 환자 식별 정보는 사내에서만 |
지표 | 탐지율, 고위험 미탐, 잘못된 경고, 검토 시간, 근거 제시율, 반복 일치도, 유형별 탐지율 |
성공 기준 | 둘을 합친 결과에서 고위험 미탐 0, 탐지율과 검토 시간이 기존보다 나음. 수치는 결과를 보기 전에 정함 |
중단 기준 | 고위험 미탐, 환자 정보 외부 전송이나 권한 밖 실행, 잘못된 경고 처리 시간이 검토 시간 감소분을 넘을 때 |
지표 가운데 반복 일치도와 유형별 탐지율은 시제품에서 배운 것을 더한 항목입니다. 시제품 B에서 같은 케이스를 세 번 돌리면 24건 중 19건만 결과가 같았고, 규칙형 오류와 의미형 오류는 잘 찾는 쪽이 달랐습니다.
경영자에게 드리는 결정안은 "리포트 검수 PoC를 업무규칙 정비와 함께 먼저 시작하고, 원장 자동화는 PoC 결과와 기준값을 본 뒤 범위를 정한다"입니다.
결정 사항 | 제안안 |
|---|---|
우선 문제 | 팀장 전수 대조를 먼저, 검체 ID 대조는 원장 설계와 함께 |
AI 권한 | 읽기와 표시까지. 원본 수정, 승인, 발송, 등급 확정 금지 |
업무규칙 승인 | 규칙 기반 판단 4개, 고위험 항목, 표기 형식 표준, 정정 순서 |
PoC 대상과 책임자 | 후향 검증 건수, 검증 책임자, 에이전트 운영 담당자 |
데이터 범위와 예산 | 검사 라인과 기간, 환자 정보 처리 위치, 개발과 운영 비용 |
결정은 경영자가 하고, 그 전에 인원과 결재선, 정상 사례의 순서와 시간, 성과 현재값, 승인 권한을 인터뷰로 먼저 받아야 합니다.
Step 8. 다른 수강생 발표에서 얻은 것과 받은 피드백
다른 수강생 발표 세 편에서 가져온 것이 있습니다.
오쌤 님은 배포된 교안 제작 스킬로 수묵 모션그래픽 쇼츠 교안을 만들었습니다. 같은 스킬을 저는 근거 검사에, 오쌤 님은 영상 스타일 선택에 써서 쓰임이 달랐습니다.
갓생오리 님은 혼자 하는 협찬 리뷰 업무를 스스로 인터뷰해 4대 역할로 나눴습니다. 조건이나 사진이 불분명하면 AI가 임의로 정하지 않고 사람에게 묻게 한 규칙이, 제 에이전트를 읽기와 표시로 묶은 것과 같은 생각이었습니다.
한 수강생은 2년 동안 컨설팅해 온 실제 사출 협력사에 낼 AX 로드맵을 발표했고 베스트 발표로 뽑혔습니다. 효과를 품질, 원가, 납기 가운데 하나의 금액으로 환산해 투자비와 견주는 구성이 인상적이었습니다.
제 발표에는 두 스터디장님이 코멘트를 주셨습니다. 허세임 스터디장님은 가상 조직인데도 디테일하고, 받은 질문의 답까지 정리해 4주 흐름이 그대로 보였다고 하셨습니다. 김길호 스터디장님은 원래 데이터 분석을 이런 흐름으로 하는지 물으셨고, 제 경험을 많이 녹였다고 답했습니다. 구조화된 사고와 현업 이해가 보이고 프로세스를 교과서대로 적용했는데, 현업 적용성을 더하면 훨씬 강한 결과물이 나오겠다는 말씀이었습니다.
김길호 스터디장님은 발표마다 기술보다 그 기술을 들인 뒤 조직에 무엇이 달라지는지, 곧 성과의 정의를 먼저 두라고 하셨습니다. 제 제안서에 비춰 보면, 성과의 정의(Step 6의 잴 값과 순효과)는 적어 두었지만 그 값의 현재 수준은 아직 비어 있습니다.
결과와 배운 점
항목 | 이전 글 | 이번 판 |
|---|---|---|
받은 질문에 대한 답 | 없음 | 질문 3개, 확인 행동 후보 13개 분류(사람 6, 자동화 6, 양식 1) |
AX 전후 비교 | 성과 항목 나열 | 문제 3개별 바뀐 뒤, 기대 효과, 잴 값 |
PoC | "PoC로 확인" 한 줄 | 가설, 대상, 진행, 권한, 지표 7개, 성공과 중단 기준 |
경영자 의사결정안 | 없음 | 결정 사항 5개와 제안안 |
고객에게 줄 성과는 정정 보고서 감소, 팀장 검토 시간 감소, 전달 전 오류 발견 증가, 담당자별 판정 차이 감소입니다. 아직은 실제 성과 대신 합성 데이터의 간접 수치로만 확인했습니다. 원장 문제는 5건을 모두 차단했고, 두 방식을 합친 탐지는 27건 중 27건이었습니다.
배운 점
에피소드 11의 기준을 단어 수와 분량으로 재 보니 활용을 다룬 절이 0개라는 사실이 보였습니다. 읽어서는 잘 보이지 않던 빈 곳이었습니다.
AI 혼자보다 규칙과 AI가 서로 다른 오류를 찾게 둘 때 빠짐이 없었습니다. 같은 이유로 PoC의 성공도 에이전트 단독 결과로 판정하지 않게 했습니다.
받은 질문에 답하려고 기준을 적다 보니 제안서가 단단해졌습니다. 확인 행동 13개를 "되돌릴 수 없는가, 이미 다른 확인이 막는가"로 나눈 표는 질문이 없었다면 만들지 않았을 것 같습니다.
김길호 스터디장님의 "현업 적용성"은 제 제안서에서 비어 있는 현재값을 정확히 가리켰습니다. 가상 조직으로는 구조까지 보일 수 있고, 성과의 현재값은 실제 인터뷰가 있어야 채워집니다.
시행착오
처음 쓴 8장의 응용 사례는 근거가 없어 전부 교체했습니다.
NotebookLM 답에도 제안서와 어긋난 내용이 섞여 있었습니다. 승인 지점의 범위를 넓혀 적거나, 사람이 쓰는 리포트 초안을 시스템이 자동 생성한다고 적은 곳이 있어 원문과 대조해 뺐습니다.
교차 검수에서 "워크숍 30~35분에 자기 파일 실습까지는 불가능하다"는 지적을 받아 워크숍은 후보 발굴과 카드 초안까지로 줄이고, 자기 파일 실행은 후속 실습으로 넘겼습니다.
발표에서 "고위험 14/14"가 무엇의 14인지 질문을 받았습니다. 합성 리포트 24건에 심은 고위험 오류 14건을 모두 찾았다는 뜻인데, 슬라이드에 분모의 뜻을 적지 않아 Step 3 표에 풀어 적었습니다.
도움 받은 글
바이오 데이터 분석팀 AX 제안서와 활용 중심 교안 만들기 (이 글의 바탕이 된 4주차 과제글)
김길호, 「슬기로운 AX 코치」 에피소드 11: 어떻게 활용할 것인가? 어떻게 만들 것인가?
김길호, 허세임 스터디장님의 4주차 교안 제작 스킬(수강생 배포)
아리랑 어원을 수묵 모션그래픽 쇼츠로: NotebookLM 교안 제작 스킬로 코드 영상 교안 만들기 (오쌤 님)
외부 자료: 8장의 근거 자료는 교안 8장 끝에 번호 목록으로 붙였습니다. 워크숍 진행법은 SAP AppHaus 진행 가이드, AI 기회 지도와 사용 사례 카드 영상, 사내 AI 워크샵 운영 팁 스레드를 주로 참고했습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
우리 회사에도 이런 자동화를 도입하고 싶다면
회사 업무에 맞춘 AI 교육을 함께 설계해요.


안녕하세요, Fri-mer님! 4주차 최종판 잘 읽었어요.
시제품 B 부분이 특히 좋았어요. 오류를 한 군데씩만 심은 1차 시험이 8건을 모두 찾았는데도 쉬운 시험이라 믿지 않으시고, 초안 24건에 정답 오류 27건(고위험 14건)을 넣어 세 번 반복하고 규칙 대조군과 비교하신 점이요. 규칙으로 판정되는 오류는 대조군이 23/23, 에이전트는 91.3%라는 숫자가 사람과 규칙과 AI의 역할 분담을 근거 있게 보여 줬어요.
"같은 입력에 늘 같은 답이 나와야 하는가"를 자동화와 AI를 가르는 질문으로 삼으신 것도 명쾌했고, 미래형 흐름도에서 AI 상자 하나를 규칙 대조, AI 표시, 팀장 판정 레인으로 나누신 수정도 설득력 있었어요. 4주 동안 수고 많으셨어요, 고롱고롱 ✨