연구 LLM wiki의 Raw data 쌓기: PubMed부터 Zotero까지

의학 연구자(비개발자)가 연구 LLM 위키의 raw 자료층을 자동화하는 큰 그림 안에서, 오늘은 옛날에 기워 만든 PubMed → Zotero 스킬들을 Claude Code와 한 번 정리했다.

연구 LLM wiki 구축 배경

연구용 LLM wiki 구축하는 과정에서 raw data를 수집하는 과정의 스킬을 정리하는 과정의 사례글.

  • raw: PubMed/Consensus 등에서 검색한 논문, Zotero에 담을 메타데이터(bibtex citation key, PMID 등), 추출한 PDF 본문 — 가공 안 된 1차 자료

  • ingested data: raw를 받아 기본 메타데이터가 들어간 요약 노트

오늘 작업은 raw 층 중 "Zotero 등록까지" 단계를 구축한 기록이다.

PubMed, Consensus에서 원하는 조건으로 검색 → 큐레이션 → Zotero에 정리되어 들어가는 흐름까지.

Consensus는 2억 건 이상의 동료 검토(peer-reviewed)를 거친 과학·의학 연구 논문을 기반으로 질문에 답변하는 AI 학술 검색 엔진이고, 최근 공식 MCP 지원을 시작한다고.. 뉴스레터에서 열심히 홍보하더라...(어쨌든 바로 연결함)..

오늘은 예전에 기워 만들어 둔 스킬 몇 개를 Claude Code와 같이 다시 펴고 합치는 작업이었다.

사용 도구 및 용어 설명

  • Claude Code: 작성일 당시 코덱스가 헤르메스에 잘 안 먹히는 관계로, 월요일에 들은 필수강의도 적용할 겸 클로드 코드와 작업하였다.

  • 스킬: AI에게 특정 작업 절차를 가르쳐둔 매뉴얼 파일. 사용자 요청 키워드를 보고 AI가 "이 매뉴얼을 보고 따른다."

  • PMID: PubMed에 등록된 모든 의학 논문에 부여되는 고유 식별 번호(예: 38492716). DOI보다 짧고, 의학 분야에서 논문을 콕 집어 가리킬 때 사실상 표준으로 쓰인다.

  • Zotero: 오픈 소스 서지관리 프로그램. Zotero API key를 받아서 활용할 수 있다.

    • (Zotero API key는 zotero 사이트 로그인 후, https://www.zotero.org/settings/security 에서 private key 생성 가능. 권한도 정해서 발급 가능하다. 필자는 읽기용, 쓰기용 따로 받아둠.)

  • Pyzotero 라이브러리: 파이썬 라이브러리로, Zotero API key를 통한 다양한 제어 가능.

원래는 위키의 "원본 자료 정리 단계"(PubMed에서 막 받은 메타데이터를 다듬는 첫 단계)용 스킬을 새로 하나 더 만들려 했는데, 기존 스킬들이 그때그때 느낌대로 만든지라, "더 만들기 전에 감사부터" 쪽으로 방향을 틀었다.

목표 플로우 및 과정

사용자: "PubMed에서 X 찾아줘"

↓ Phase A (읽기만): TLDR + PMID + 제목 + 링크

↓ ← 멈춤

사용자: "이거 좋네, Zotero에 넣을 후보 큐 정리해줘"

↓ Phase B-1: 체크박스 큐 .candidates.md 생성

↓ ← 사용자 체크

↓ 등록 직전 시뮬레이션 보고서(dry-run)

↓ ← 사용자 OK

↓ Phase B-2: Zotero API 경유하여 조테로 라이브러리에 등록

내가 예전에 봇이랑 만든 스킬 중에 pubmed-to-zotero-curated라는 게 있었다.

Pubmed, consensus에서 검색해서 좋은 걸 골라 Zotero에 등록하는 전체 흐름용으로 만든 스킬이다. 그런데 이 스킬을 명시적으로 지목해서 깨우려고 프롬프트를 짰는데도, AI는 따로 있던 단순 검색 스킬(pubmed-quick-search)만 불러오고 끝났다. 원인은 두 스킬 description이 모두 "PubMed 검색" 키워드를 강하게 가졌고, "이 스킬은 큐레이션·등록까지 한다"는 차별 키워드가 한국어 트리거에 약해서였다. AI 입장에서는 "검색"만 보였다.

두 스킬을 따로 두지 말고 스킬을 합치기로 했다. 실제 내 워크플로 자체가 "찾아서 → 좋은 거 등록"인데 굳이 두 스킬로 갈라 둘 이유가 없었다. pubmed-literature-curation 한 스킬로 2-phase 구조를 명시하였다.

★ AI가 단정한 결론을 의심한 순간

오늘 작업에서 가장 중요한 장면. 따로 빼둔다. PubMed 논문의 고유번호 PMID를 Zotero 어디에 박을지에서 Claude가 단정했다.

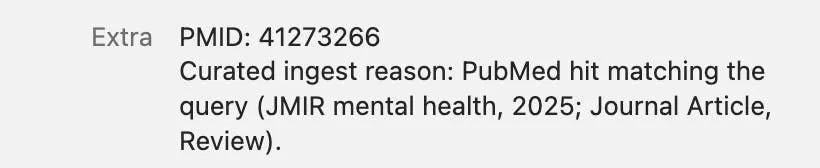
Zotero 데이터 구조에 PMID 표준 필드는 없다. extra(보조 메모) 칸 안에 PMID: ***** 로 박는 게 표준이다.

phd phd phd phd phd ph라는 단어가 적힌 백서

위의 사진이 그 결과물. PMID field가 없다고 생각해서 PMID랑 같이 큐레이션 노트를 같이 Extra field에 넣어버림.

나는 의심했다. "정말 안 돼요? 아까 같이 보낸 공식 홈페이지에서는 뭐라고 했어요? 두 링크 한 번 더 보세요."

Zotero 공식 데이터 구조 정의(https://api.zotero.org/schema)에서 journalArticle 항목에 PMID와 PMCID가 정식 표준 필드로 존재했다.

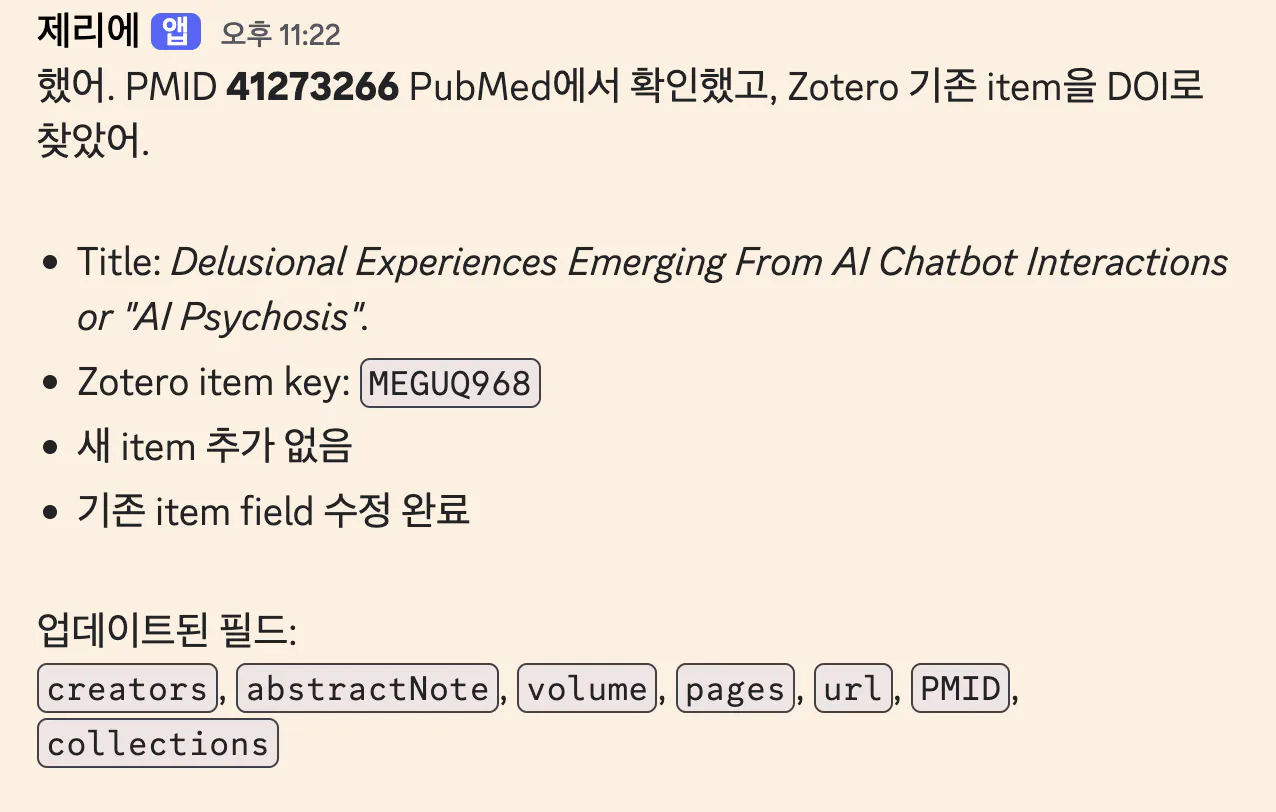
Claude는 잘못 인정하고 표준 필드로 매핑을 바꿨다. PMID는 PMID 칸으로, PubMed 링크는 url 칸으로, extra의 중복 줄은 제거. 중복 탐지도 "표준 PMID 우선, 없으면 옛 표기 확인"으로 보강.

여기서 배운 한 줄.

AI가 처음 들춘 도구가 보여주는 세계 ≠ 진짜 데이터 구조. 도구의 시야가 어디까지인지를 사용자가 의심해야 한다. AI가 제대로 코딩하게 하려면 최신, 공식 지식을 먹여줘야 한다.

Zotero 필드 매핑 디버깅

핵심 장면 외에도 다듬을 곳이 더 있었다.

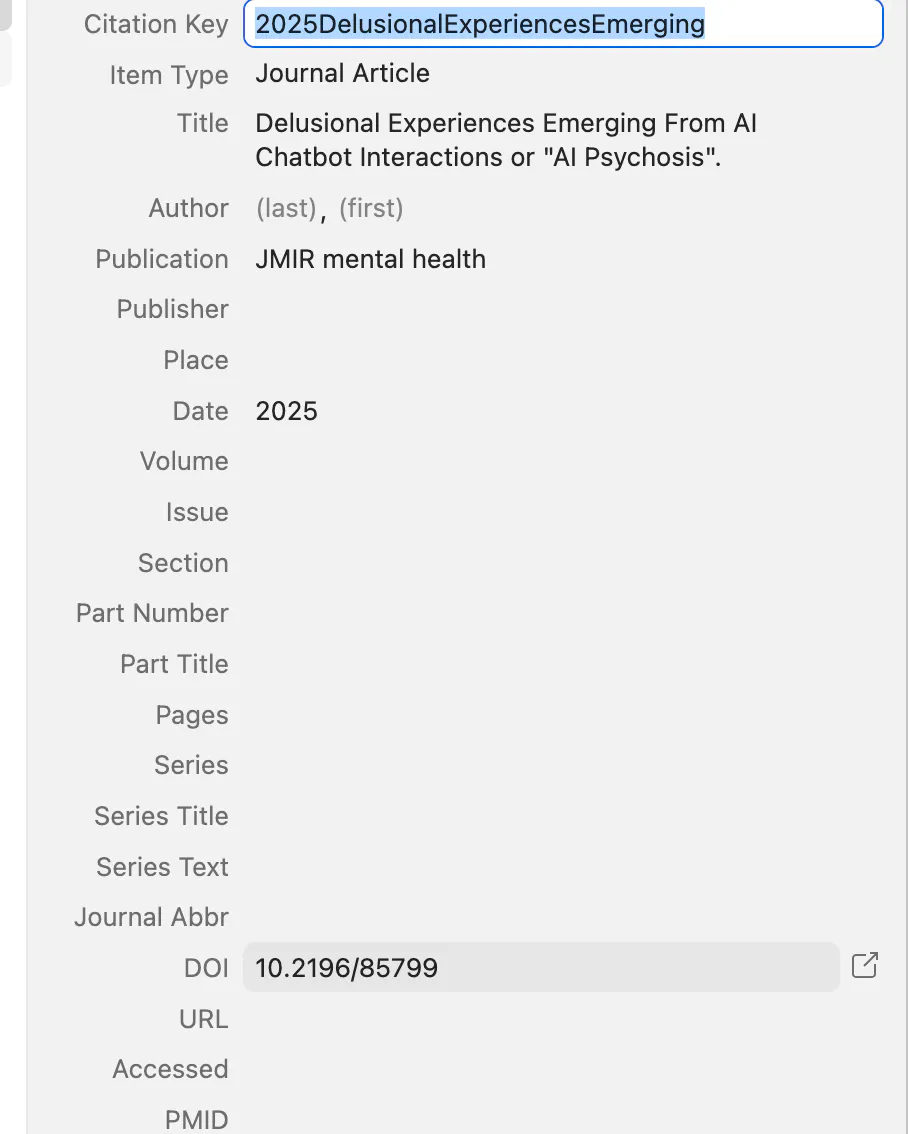
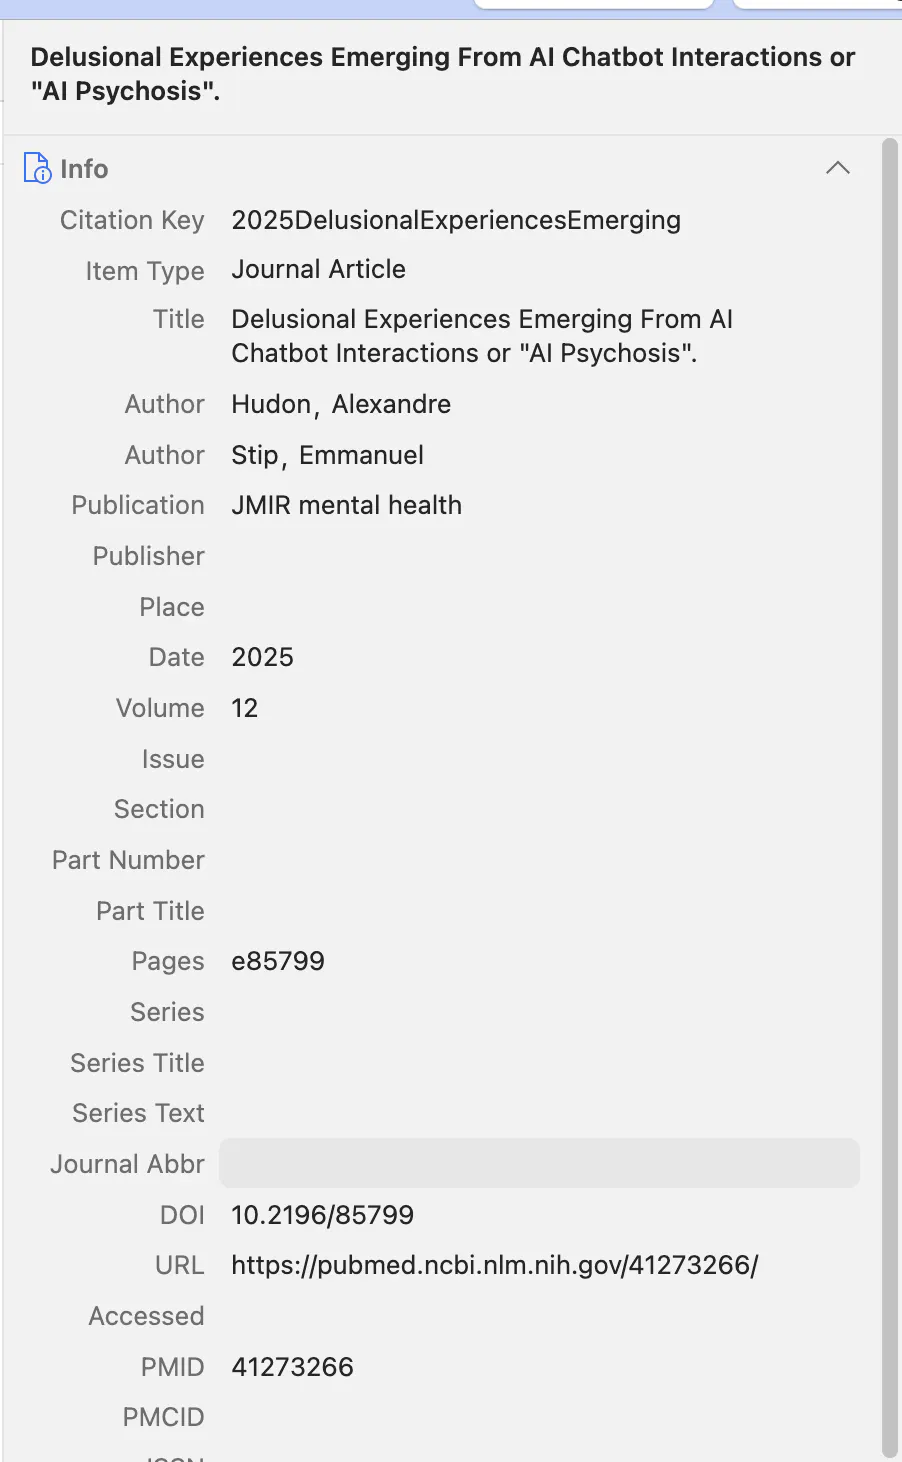
필드 누락: 밑의 예시 사진을 보면, 빈칸이 많은 걸 볼 수 있다. (스크립트 수정 전에 만들어진 결과물임).

나머지 칸도 채우기 위해, PubMed 응답에서 6개 필드만 뽑던 것을 11개 필드까지 허용으로 확장하였다.

도서관의 인용 페이지 스크린샷

최종 구현 후 헤르메스 에이전트에게 물어봄

PMID 41273266 논문 이거도 혹시 pubmed에서 찾은담에 zotero field update 해줄수있어?

아이폰의 중국 앱 스크린샷

스킬 잘 쓰는 것 확인!

다음 단어가 포함된 한국어 문자 메시지

실제 조테로 데스크탑 프로그램에서도 위에보다 필드가 채워진 것 확인하였다. PMID도 잘 들어감.

작업 요약 및 향후 계획

오늘 작업 전에는 내가 Zotero에 등록한 항목 카드를 열면 제목·저널·연도·DOI 정도만 차 있고, 정작 내가 큐레이션할 때 보고 싶은 정보 — 저자, 권/호/페이지, 초록, PMID, 그리고 내가 왜 이 논문을 담았는지 적어둔 Curation note(Extra 칸) — 가 다 비어 있었다. Zotero를 열 때마다 "이거 누구 논문이지, 왜 담았더라" 한 번 더 찾아봐야 했다.

한번 정리하고 났더니, 한 번의 자연어 요청으로 그 칸들이 다 채워진 상태로 들어간다. PMID는 Zotero가 인정하는 표준 칸에, PubMed 링크는 url 칸에, 내 메모는 Extra(Curation note)에 깔끔히 분리되어 박힌다.

검색 → 논문 큐레이션 → 등록이 한 스킬, 한 자연어 흐름으로 작동한다.

LLM wiki 구축에서 앞으로 남은 일

1. PDF 본문 추출:

Zotero에 등록된 PMID 등 메타데이터를 이용

→ 기관 도서관에서 PDF 자동 다운로드 / 만약 이미 full text가 공개되었으면, 무리해서 PDF 받지 않고 텍스트 추출 (이전 사례글. 아직 완성형은 아님. https://www.gpters.org/nocode/post/experiment-which-ai-agent-MuhOCUaZ4KCTonu)

→ PDF에서 본문을 블록(제목/문단/표/그림 캡션)으로 분류해 추출

→ (card.md / body.md / references.yaml 한 세트) (파일 구성은 좀더 고민중. 메타데이터 파일, 풀텍스트, 서지 정보 정도로 고민중. pdf에서 직접 서지 정보 뽑았을때의 퀄리티가 맘에 안들어서, 이건 그냥 cross ref나 pubmed 등에서 뽑아오라고 할 예정).

ingest 스킬 깎기:

PDF derived md 파일 기반 원하는 context의 요약 노트 만들기

참고, 관련 자료

Zotero 공식 데이터 구조 정의: https://api.zotero.org/schema

Zotero Web API v3 문서: https://www.zotero.org/support/dev/web_api/v3/start

2
1개의 답글
밀어주고 끌어주는

온·오프라인 AI 스터디

AI로 어디까지 할 수 있는지
직접 확인하실 분만 신청하세요.