AI 자동화 점수를 믿어도 될까 — 문제를 낸 쪽이 채점까지 하면
2026.08.13
📝 한줄 요약
시험 문제를 학생이 직접 내고, 채점도 그 학생이 한다고 해볼게요. 점수는 잘 나올 거예요. 자기가 아는 것만 골라 문제를 낼 테니까요. 그런데 그 점수로 실력을 알 수는 없죠.
AI 자동화에 "잘 되고 있나"를 재는 장치를 붙이면 이 일이 그대로 생겨요. 장치를 만든 쪽이 점수 매기는 기준까지 만들거든요. 저는 어제 만든 AI 장치에 자동 점검을 붙이다가 하루 사이에 두 번 걸렸어요. 한 번은 제가 문제를 쉽게 냈고, 한 번은 연습 답안이 채점 더미에 섞여 있었어요.
바쁘시면 이것만 읽어도 돼요:
점수를 만드는 쪽과 그 점수로 평가받는 쪽이 같으면, 그건 성적표가 아니에요
내가 못 만드는 숫자 하나**를 옆에 둬야 해요 (남이 낸 문제를 풀어봐야 실력을 아는 것처럼)
숫자는 두 개로 봐야 해요. 하나만 보면 그쪽만 잘하면 그만이거든요
숫자가 이상하면 계산식보다 채점 더미에 뭐가 섞였나를 먼저 봐요
데이터를 뺐으면 뺐다고 적어야 해요
🎯 이런 분들께 도움돼요
자동화를 만들어놓고 "이게 잘 돌고 있나"를 어떻게 볼지 막힌 분
AI에게 "스스로 개선해봐"를 맡겨보려는데 그 보고를 어디까지 믿을지 고민인 분
지표를 만들었는데 숫자가 현실과 따로 노는 느낌인 분
😫 문제 상황 (Before)
어제 저는 제 AI에 작은 장치를 하나 붙였어요. 제가 뭔가 부탁하면, 제가 전에 만들어둔 도구 중에 관련 있는 걸 한 줄 알려주는 장치예요. "이거 할 때 쓰던 도구 있어요" 하고 옆에서 알려주는 셈이죠.
만들고 나니 바로 다음 질문이 왔어요. "이게 맞게 알려주고 있나?"
엉뚱한 걸 계속 들이밀면 없느니만 못하거든요.
그래서 자동으로 점검하는 장치를 하나 더 붙이기로 했어요. 여기까지는 평범해요. 문제는 그다음이었어요.
🛠️ 사용한 도구
도구: 알려주는 장치, 주간 점검 스크립트, 예약 실행(정해진 시각에 알아서 도는 알람 같은 거예요)
방법론: 기준은 사람이 정하고 / 잣대 일부는 잠가두고 / 통과 여부는 코드가 판단
비용: 0원. 점검에 AI를 안 써요. 숫자 세는 일이라 코드로 충분했어요
🔧 1. 제가 문제를 쉽게 냈어요
장치를 켜보니 어떤 도구는 한 번도 안 불려 나왔어요. 안 걸리는 거예요.
그래서 저는 그 도구가 걸리는 말을 늘렸어요. "품질 봐줘", "막혔어" 같은 걸 추가했죠.
결과는 바로 나왔어요. 알려준 횟수 0회 → 2회.
숫자만 보면 개선이에요.
그런데 그 2번 중 실제로 쓴 건 0번이었어요. 저는 장치를 좋게 만든 게 아니라 점수가 잘 나오게 문제를 고친 거예요.
💡 성과 숫자를 만든 사람이 그 숫자의 재료까지 만들 수 있으면, 그건 성적표가 아니에요. 자기가 낸 문제를 자기가 푼 거니까요.
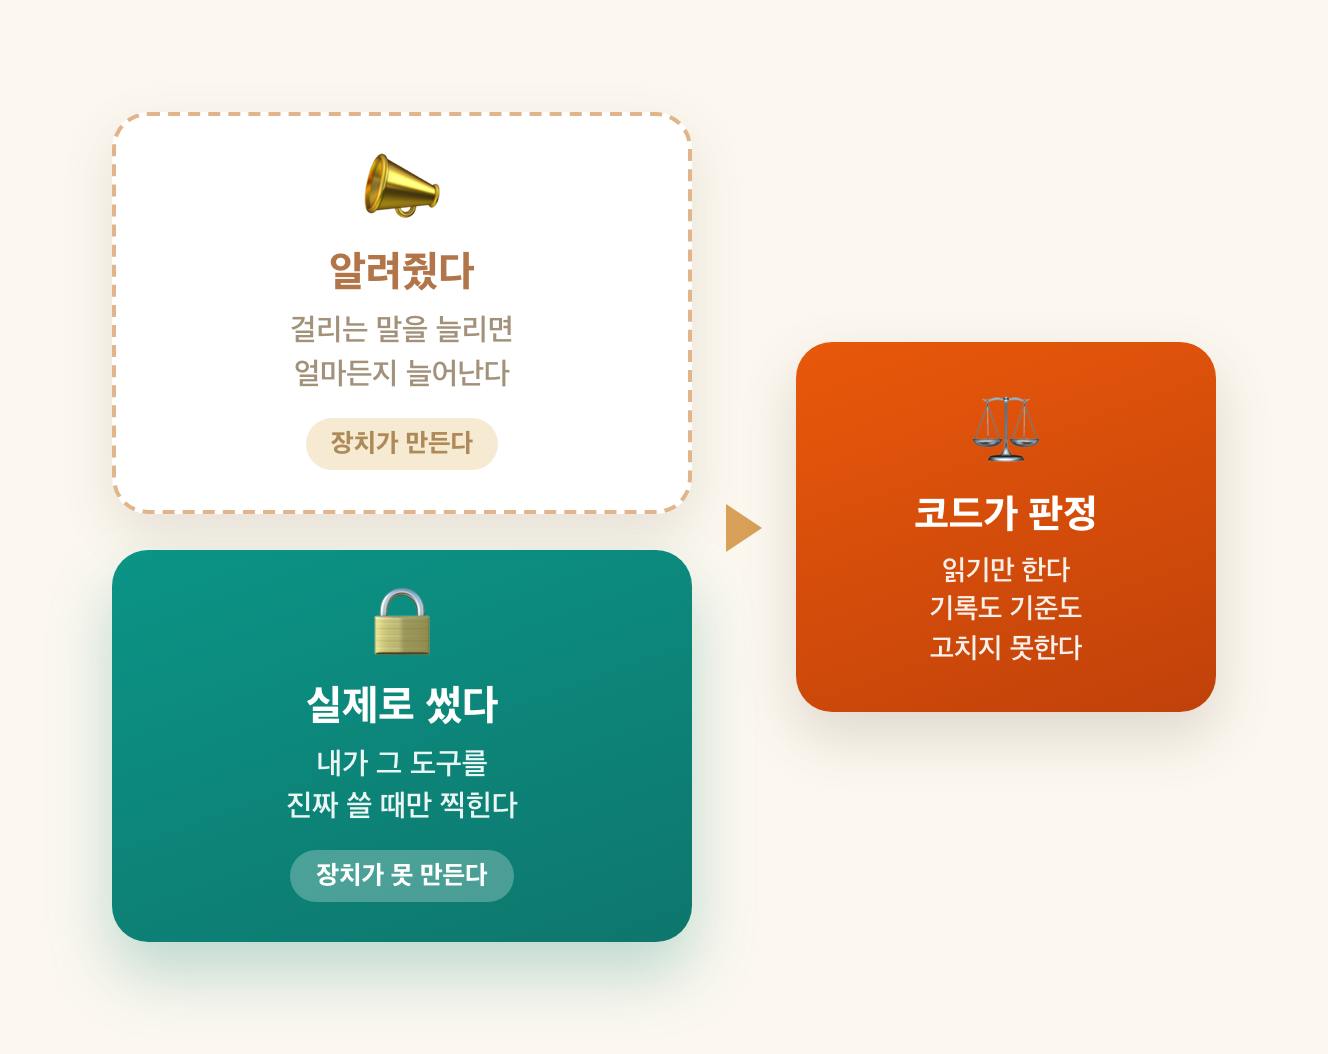
그래서 제가 못 만드는 숫자를 하나 뒀어요. 기록을 두 종류로 나눴어요.
알려줬다 — 장치가 만들어요. 걸리는 말을 늘리면 얼마든지 늘어나요
실제로 썼다 — 제가 그 도구를 진짜로 쓸 때만 찍혀요. 장치가 만들 수 없어요
남이 낸 문제에 해당하는 게 이 두 번째예요. 그리고 점검 스크립트가 기록 파일을 고치지 못하게 막았어요. 읽기만 해요.
🔧 2. 숫자가 하나뿐이면 그 하나만 잘 만들면 돼요
처음엔 숫자를 하나만 보려고 했어요. 알려준 것 중에 내가 실제로 쓴 비율.
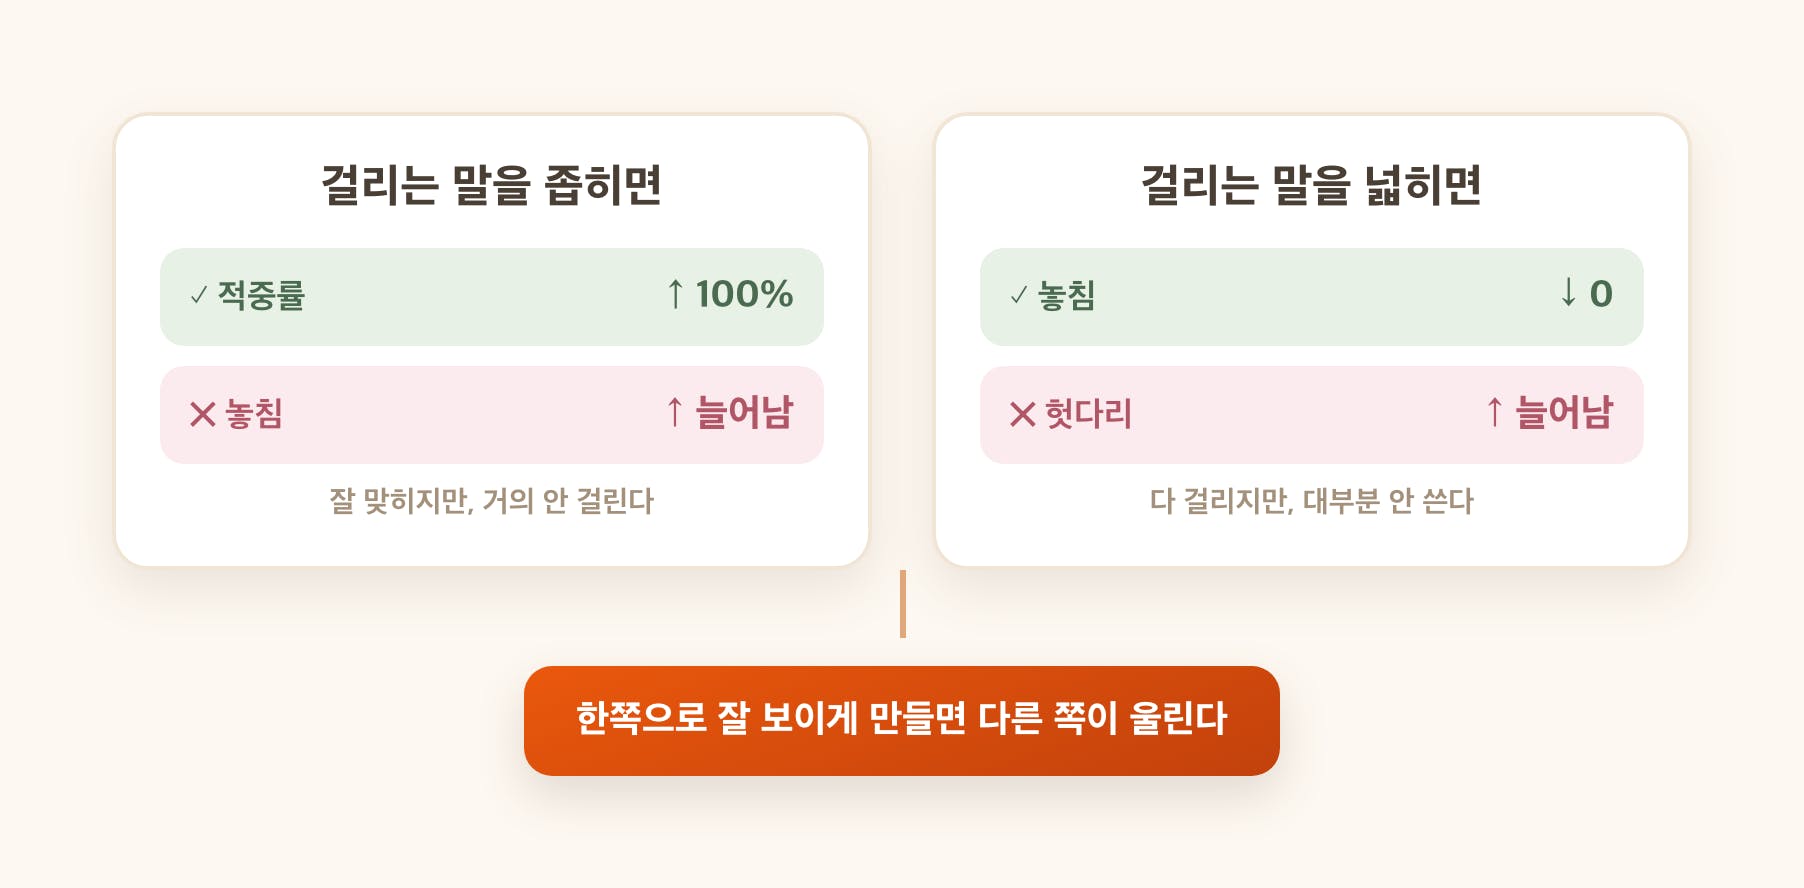
그런데 이 숫자도 제가 올릴 수 있더라고요. 확실한 경우에만 알려주게 만들면 되거든요. 열 번 알려주고 다섯 번 쓰이면 50%지만, 확실한 한 번만 알려주면 100%예요. 숫자는 완벽한데, 정작 도움이 필요한 아홉 번은 아무 말도 안 해준 거죠.
그래서 반대쪽을 재는 숫자를 하나 더 뒀어요. 내가 도구를 썼는데 아무 말도 없었던 횟수요.
3번 알려줬는데 한 번도 안 씀: 헛다리를 짚고 있다 → 좁히기
안 알려줬는데 내가 2번 씀: 놓치고 있다 → 넓히기
이 두 숫자는 같이 좋아지기 어려워요. 조심스럽게 만들면 헛다리는 줄지만 놓치는 게 늘고, 적극적으로 만들면 놓침은 줄지만 헛다리가 늘거든요. 하나를 예쁘게 만들면 다른 하나가 나빠져요. 그래서 둘을 같이 봐요.
양쪽으로 속여보는 상황을 만들어 시험도 해봤어요. 둘 다 걸립니다.
🔧 3. 첫 점검 결과가 틀렸어요
장치를 다 만들고 첫 점검을 돌렸어요.
아침 업무 정리 도구 알려줌 5번 실제 사용 0번 → 헛다리
그런데 이 도구는 제가 매일 아침 쓰는 것이에요. "헛다리"는 정반대 진단이죠.
기록을 열어봤어요.
15:04:16  알려줌
15:04:43  알려줌
15:04:43  알려줌
27초 안에 세 번. 사람이 이렇게 입력할 리가 없죠. 장치가 잘 도는지 제가 시험해보던 기록이었어요. 그게 그대로 점수에 들어간 거예요. 연습 삼아 푼 답안지가 진짜 답안지 더미에 섞여 같이 채점된 셈이에요.
쓴 기록은 그렇게 애써 잠갔는데, 알려준 기록은 잠글 생각을 못 했거든요. 코드는 잘못이 없어요. 받은 숫자대로 성실하게 계산했을 뿐이에요.
💡 잣대를 잠그는 것과 채점 더미가 깨끗한 것은 다른 문제예요. 둘 다 해야 해요.
🔧 4. 그래서 두 가지를 바꿨어요
하나, 연습 기록은 빼요. 진짜 대화에서 온 기록에는 표시가 하나 붙어 있어요. 제가 손으로 시험해본 건 그게 없고요. 표시 있는 것만 세게 했어요.
둘, 뺐다고 적어요. 보고서 아래에 이런 줄이 남아요.
뺀 것: 손으로 돌린 기록 1건
그냥 빼고 말면 깨끗한 데이터로 판단한 것처럼 보이거든요. 몇 건을 뺐는지 같이 봐야, 이 결과를 얼마나 믿을지 제가 정할 수 있어요.
고친 다음 같은 기록으로 다시 돌렸어요. 이번엔 아무 진단도 안 나왔어요. 셀 기록이 하나도 안 남았거든요.
싱겁지만 이게 맞는 결과예요. "고칠 게 없다"와 "판단할 게 없다"는 다른 말이잖아요. 하루 전이었다면 여기서 틀린 처방을 자신 있게 내놨을 거예요.
✅ 결과 (After)
알려준 게 맞았나: 알 수 없음 → 숫자 두 개로 코드가 판단
점수의 주인: 장치가 자기 성과를 자기가 보고 → 사용 기록은 장치가 못 만듦
고칠 것 고르기: 감으로 → 자동으로 목록 뽑힘
점검 주기: 손으로 → 매주 월요일 자동
데이터가 이상할 때: 그대로 계산 → 빼고, 뺐다고 보고
정직하게 덜어낼 것
지금 말할 수 있는 건 장치가 섰다까지예요. "알려주는 게 실제로 도움이 됐다"는 아직 못 해요. 진짜 사용 기록이 아직 0건이거든요. 최소 한 주는 굴려야 나와요.
이 문단을 쓰는 것 자체가 이번 글의 주제이기도 해요. 만들어놓고 나면 효과까지 말하고 싶어지거든요.
💬 이 과정에서 배운 팁
효과적이었던 것
내가 못 만드는 숫자를 하나 두기 — 이게 없으면 나머지는 장식이에요.
숫자는 두 개로 — 하나만 있으면 그 하나는 조절할 수 있게 돼요.
뺀 데이터를 적어두기 — 얼마나 믿을지는 사람이 정해요.
숫자가 이상하면 계산식보다 원본을 먼저 — 이번엔 시각만 봐도 알 수 있었어요.
이렇게 하면 안 돼요
안 걸린다고 걸리는 말부터 늘리기 — 숫자는 오르고 실제는 그대로예요.
시험 삼아 돌린 걸 진짜 기록에 쌓기 — 측정 장치를 만들면서 그 장치를 더럽혀요.
숫자가 올랐다고 좋아졌다고 보고하기 — 무엇을 세는 숫자인지 먼저 봐야 해요.
🌍 다른 업무에 적용한다면?
숫자로 성과를 재는 일이면 다 통해요. 캠페인 반응률, 응대 만족도, 콘텐츠 조회수.
물어볼 건 하나예요. 이 숫자를 만드는 사람과 이 숫자로 평가받는 사람이 같은가? 같다면 그 숫자는 조절돼요. 떼어놓을 수 없다면, 최소한 그 사람이 못 만드는 숫자 하나를 옆에 두세요.
❓ 자주 묻는 질문
Q. 그냥 제가 눈으로 보면 되지 않나요?
매주 기록을 열어 세는 일을 계속하기는 어려워요. 그리고 눈으로 보면 "괜찮아 보이는데" 하고 넘어가요. 조건을 코드에 박아두면 기준이 안 흔들려요.
Q. 점검도 AI에게 시키면 더 똑똑하지 않나요?
그럼 채점하는 쪽도 AI가 돼요. 이 글이 말하는 문제가 한 겹 더 생기는 거예요. 숫자 세는 일이면 코드가 낫고, 비용도 0원이에요.
Q. 기준(3번, 2번)은 어떻게 정했나요?
제가 정했어요. 근거는 약해요 — 굴려보고 이상하면 바꿀 생각이에요. 중요한 건 장치가 이 숫자를 못 바꾼다는 거예요.
🚀 앞으로의 계획
한 주 굴려서 진짜 데이터로 첫 점검을 받아보려고요. 그다음은 새 도구를 자동으로 찾아오게 하는 쪽인데, 거기도 같은 함정이 있어요 — 많이 찾아올수록 잘한 것처럼 보이거든요. 이번에 만든 두 숫자를 그대로 대볼 생각이에요.
📋 재사용 가능한 점검 설계 템플릿
자동화에 "잘 되고 있나"를 붙일 때 이 순서로 채워보세요.
1. 무엇이 좋은 결과인가 — 사람이 한 줄로 정해요. AI에게 맡기지 않아요
2. 내가(또는 봇이) 못 만드는 숫자 찾기 — 없으면 만들어요. 이게 잠긴 잣대예요
3. 숫자는 두 개 — 서로 반대로 움직이는 짝으로 골라요 (하나를 잘 만들면 다른 하나가 나빠지는 짝)
4. 판단은 코드가 — 조건을 숫자로 박고, 봇이 그 숫자를 못 바꾸게 해요
5. 뺀 것을 적어요 — 몇 건을 왜 뺐는지 보고서에 남겨요
6. 이상하면 원본부터 — 계산식보다 재료가 틀렸을 때가 많아요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



이 글은 숫자가 좋아진 순간보다 그 숫자를 믿지 않은 두 번의 멈춤이 더 또렷해요. 걸리는 말을 늘려 추천 0회를 2회로 만들었지만 실제 사용은 0회였고, 정밀도를 높이려 추천을 줄이면 놓침이 늘어난다는 반대쪽까지 보면서 ‘알려줌’과 ‘실제 사용’을 서로 다른 주체가 만드는 기록으로 나눴죠.
첫 주간 점검의 5회 추천·0회 사용을 그대로 헛다리로 판정하지 않고, 27초 안에 쌓인 세 기록을 다시 본 장면도 중요합니다. 손으로 시험한 로그가 실제 채점 더미에 섞였다는 원인을 찾은 뒤, 진짜 대화 표시가 있는 기록만 세고 제외 1건을 보고서에 남겼으니까요. 잣대를 잠그는 일과 측정 재료를 깨끗하게 하는 일이 별개라는 교훈이 실제 수정으로 이어졌습니다.
고친 뒤 진짜 사용 기록이 0건이라 아무 진단도 내지 않은 결과가 오히려 이 장치의 첫 성공으로 보여요. 한 주간의 실제 기록이 쌓인 뒤에는 추천했지만 안 쓴 수와 추천 없이 실제 쓴 수가 함께 나오고, 제외 건수까지 붙는지가 첫 유효 readback이 되겠네요.
지표를 늘린 것보다 판단할 데이터가 없을 때 결과를 비워 둔 태도가 단단했습니다. 측정 장치가 자기 성적을 만들지 못하게 한 그 경계가 이 자동화의 가장 믿을 만한 성과예요.