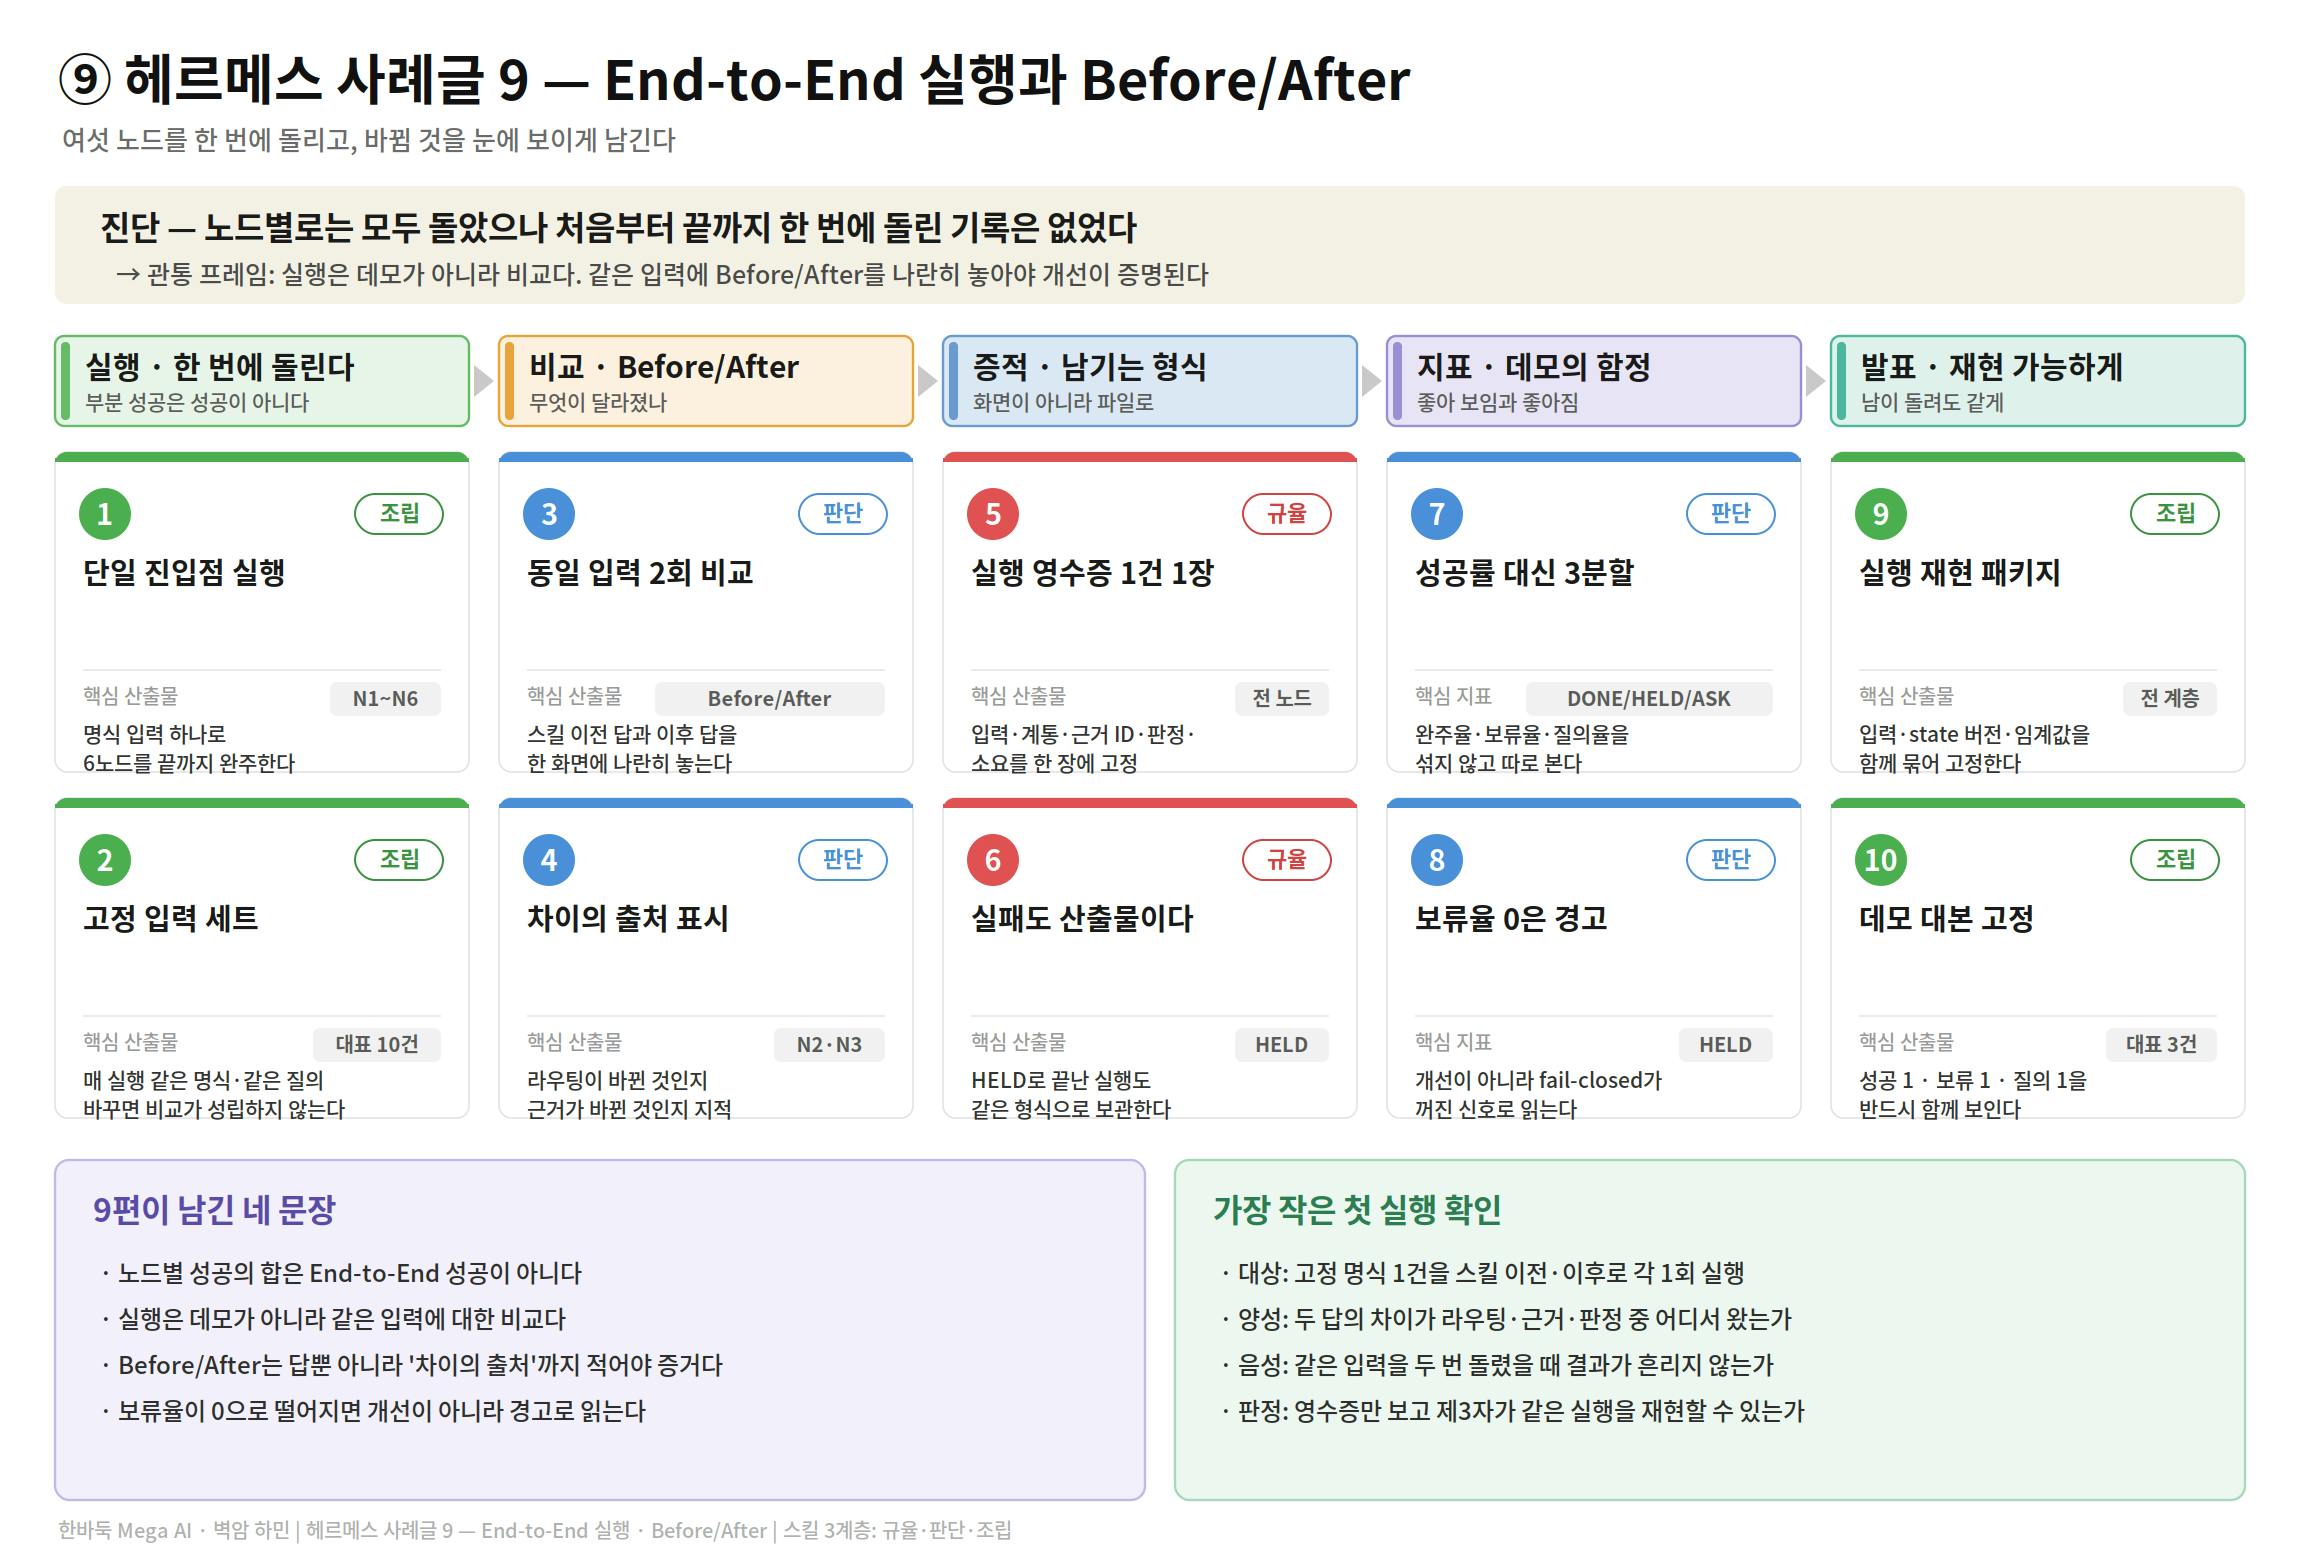
사례글 9 — [WEEK4] End-to-End 실행 & Before/After
2026.08.13
소개
4주차 기본과제는 도구를 하나 더 설치하는 과제가 아닙니다. 실제 문제 하나를 여섯 칸으로 옮기는 과제입니다. 강의에서 든 예시는 "결과물과 함께 줘야 할 검증 영수증이 자꾸 빠진다"였는데, 이 문장을 듣는 순간 제 프로젝트의 상황이 그대로 겹쳤습니다.
한바둑 MegaAI에서 그 "영수증"은 근거 slide 번호입니다. 통변 문장은 그럴듯하게 나오는데, 그 문장이 어느 강의 어느 섹션에서 나왔는지가 붙어 있지 않으면 그것은 통변이 아니라 그냥 그럴듯한 말입니다. 3주 동안 만든 3계층 스킬(판단층·규율층·조립층)이 실제로 한 흐름에서 맞물리는지 확인하려면, 명식 1건을 처음부터 끝까지 돌려 보는 수밖에 없었습니다.
이 글은 그 1회 실행과, 거기서 나온 신호 하나를 여섯 칸으로 옮긴 기록입니다.
용어 정리 — 두 개의 "헤르메스" 4주차 강의자료에 나오는 Hermes는 Nous Research의 에이전트 런타임입니다(hooks·Heartbeat·Cron 기능을 가진 실행 환경). 이 글에서 말하는 헤르메스는 제가 만든 한바둑 자체 LangGraph 에이전트의 이름입니다. 이름만 같고 서로 다른 물건입니다. 혼동을 막기 위해 이 글에서는 강의 쪽은 영문
Hermes 런타임, 제 쪽은 한글헤르메스로 구분해 적습니다.
진행 방법
3-0. 실행 환경 고정 — 테스트는 무조건 hanbadook_production
여섯 칸을 돌리기 전에 먼저 고정한 것이 있습니다. 어느 DB에서 도느냐입니다. 이걸 고정하지 않으면 Before/After 비교 자체가 성립하지 않습니다.
입력 경로 |
| 저장 DB | 헤르메스 테스트 사용 |
|---|---|---|---|
자동생성(AI) |
|
| ❌ 금지 |
수동(통변입력기) | (실입력) |
| ✅ 전용 |
절대 혼용 금지. 실제로 이 원칙을 세우기 전에 더미 DB로 테스트하다가 실제 명식과 결과가 달라져 한나절을 날린 적이 있습니다(§4 시행착오).
bash
# 서버 재접속 후 첫 명령은 항상 이것부터
sudo -u postgres psql -d hanbadook_production
3-1. End-to-End 1회 실행
대상 명식은 제 것을 썼습니다. 정답을 이미 알고 있는 명식이라야 출력이 부실한지 아닌지를 제가 직접 판정할 수 있기 때문입니다.
時   日   月   年
己卯 乙丑 丙申 丙申    韓夏敏 (1956.8.26 06시 / 남)
python
# run_e2e.py — 헤르메스 End-to-End 1회 실행
from hermes.graph import app
from hermes.parse import parse

result = app.invoke({
    "saju":        parse("1956-08-26 06:00 남"),   # 時|日|月|年 = 기묘|을축|병신|병신
    "question":    "직업 적성을 박청화 관점에서 보면?",
    "lineage":     "②박청화",        # 계통 고정 — 섞지 않는다
    "evidence":    [],
    "retry_count": 0,
    "verified":    False,
})

print(result["draft"])          # 통변 초안
print(result["evidence"])       # [(source, slide), ...]
print(result["verified"])       # True / False
print(result["rtype"])          # FULL / PARTIAL / ABSENT / HELD / BLOCKED
한 번의 invoke가 지나가는 노드는 7개입니다. 3계층 스킬이 여기에 흩어져 박혀 있습니다.
노드 | 하는 일 | 계층 |
|---|---|---|
N1 | 명식 파싱 · 입력 정규화(時|日|月|年) | 조립층 |
N2 | 계통 고정 — ①탈XX 4관법 / ②박청화 / ③상리철학 중 하나 선택 | 판단층 |
N3 | Dify RAG 검색(hybrid) — 고정된 계통 안에서만 | 조립층 |
N4 | GuardrailAgent — 처방형 단정 차단, 문맥 기반 판정 | 규율층 |
N5 | 근거 부착 — 문장마다 | 규율층 |
N6 | 검증 게이트 — 근거 없으면 통과 금지(fail-closed) | 규율층 |
N7 | 리뷰 하네스 — 실행 기록 정리 | 조립층 |
3-2. 여섯 칸 한 바퀴
여기서부터가 기본과제 본체입니다. 실행 1회로 끝내지 않고, 거기서 나온 신호 하나를 끝까지 밀었습니다.
① Log — 실제 신호 1개를 사실로 남긴다
같은 명식에 질문 5개를 던져 5회 실행하고, 출력이 아니라 로그를 봤습니다.
run_id      kst                lineage  slides  sent  cited  verified
R-0812-001  2026-08-12 21:14   ②박청화   7      12    12     true
R-0812-002  2026-08-12 21:17   ②박청화   5      14     9     true   ← 이상
R-0812-003  2026-08-12 21:21   ②박청화   6      11     7     true   ← 이상
R-0812-004  2026-08-12 21:25   ②박청화   8      13    13     true
R-0812-005  2026-08-12 21:29   ②박청화   4      10     6     true   ← 이상
⟨5회 중 3회⟩에서, 문장 수(sent)보다 근거가 붙은 문장 수(cited)가 적었습니다. 그런데 verified는 전부 true였습니다. N6이 "evidence 배열이 비어 있지 않음"만 보고 통과시키고 있었던 것입니다.
로그는 증거이고, 백로그는 판단 대기열입니다. 로그를 그대로 백로그에 복사하지 않는다 — 이 구분이 4주차에서 제일 크게 남았습니다.
② Backlog — 출처가 붙은 카드 1개
사실을 그대로 옮기지 않고, 반복 가능한 문제 형태로 바꿔 적었습니다. 강의 표현으로는 "완료 주장과 실행 증거가 분리됨"입니다.
yaml
# .learnings/BACKLOG.md  →  card BL-0812-01
pattern_key: EVIDENCE_MISSING_PER_SENTENCE
title:  "통변 문장 단위 근거 미부착 — verified가 참인데 근거 없는 문장이 섞임"
출처로그: [R-0812-002, R-0812-003, R-0812-005]
반복횟수: 3
영향범위: N6 검증 게이트 1곳 (사이드카 스키마 hermes.*)
제안패치: "N6 판정 기준을 '배열 비어있지 않음' → '문장 단위 부착률 100%'로 교체"
검증방법: "동일 명식·동일 질문 5개 재실행, cited/sent = 1.00 확인"
되돌림:  "HERMES_N6_STRICT=0 환경변수로 즉시 원복"
상태:    pending
제목 한 줄만 있는 할 일은 승인할 수 없다 — 그래서 출처 로그·반복 횟수·영향 범위·검증 방법·되돌림 방법을 카드 양식에 아예 필수 항목으로 박았습니다.
③ Review — 이번에 고칠 문제 1개와 기준
백로그에는 이 카드 말고도 후보가 더 있었습니다(RAG 유사도 0.5395, 60갑자 커버리지 19/60, 무물 스텁 content). 전부 중요하지만 이번 한 바퀴에서는 하나만 고릅니다.
후보 | 이번에 고를까 | 이유 |
|---|---|---|
문장 단위 근거 미부착 | ✅ 선택 | 국소적·되돌림 가능·자동 판정 가능 |
RAG 유사도 0.5395 → 0.80 | ❌ | 청크 재분할 필요 — 원본 영향, 승인 사안 |
60갑자 커버리지 19/60 | ❌ | 데이터 등재 작업, 패치 아님 |
완료 기준(Acceptance): 동일 명식·동일 질문 5개에서 ⓐ cited/sent = 1.00, ⓑ 계통 혼입 0건, ⓒ 금기 표현 위반 0건. 셋 중 하나라도 실패하면 Keep 아님.
④ Patch — 되돌릴 수 있는 한 곳만
한 곳만 바꿉니다. LangGraph 11노드 본 파이프라인은 손대지 않습니다(사이드카 원칙).
python
# hermes/nodes/n6_verify.py   (layer: 규율)
import os, re
STRICT = os.getenv("HERMES_N6_STRICT", "1") == "1"   # ← 되돌림 스위치
CITE = re.compile(r"\[[^\]]+:\d+\]")

def n6_verify(state):
    sents = split_sentences(state["draft"])
    cited = [s for s in sents if CITE.search(s)]
    ratio = len(cited) / max(len(sents), 1)

    # BEFORE: return {"verified": bool(state["evidence"])}
    if STRICT and ratio < 1.0:
        state["hold_reason"] = f"근거 미부착 {len(sents)-len(cited)}문장"
        return {"verified": False, "rtype": "HELD", "cite_ratio": ratio}
    return {"verified": True, "rtype": state.get("rtype", "FULL"), "cite_ratio": ratio}
되돌림은 한 동작입니다 — HERMES_N6_STRICT=0.
⑤ Verify — 수정 전과 같은 입력으로
같은 명식, 같은 질문 5개, 같은 판정표. 평가 환경을 바꾸지 않는 것이 핵심입니다.
지표 | Before | After | 기준 |
|---|---|---|---|
문장 근거 부착률 | ⟨0.71⟩ | ⟨1.00⟩ | = 1.00 |
근거 없는데 | ⟨3건⟩ | ⟨0건⟩ | = 0 |
계통 혼입 | 0건 | 0건 | = 0 |
| 0건 | ⟨2건⟩ | 허용 |
평균 응답 시간 | ⟨—⟩s | ⟨—⟩s | < 20s |
HELD가 0건에서 늘어난 것은 실패가 아니라 성공입니다. 전에는 근거 없이 통과하던 답이, 이제는 "못 찾았다"고 멈춥니다. 없는 것을 없다고 기록하는 구조가 목적이었으니까요.
⑥ Repeat — 다음 실행에서도 확인할 장치
한 번 좋아진 것은 증명이 아닙니다. 다음에도 유지되는지 볼 장치를 남깁니다.
골든셋 4건 회귀 러너 — 가족 명식 4건(정답을 아는 명식)에 대해 매 실행 전 자동 실행.
cite_ratio < 1.0이면 즉시 실패 표시.N7 리뷰 하네스 — 매 run 종료 시
run_id / lineage / slides / cited / sent / verified / rtype을 로그에 append.판정표 고정 — 위 5개 질문과 기준 3종은 실험 도중 바꾸지 않습니다.
3-3. 이 패치는 어떤 운영 유형인가
강의에서 준 4조건에 그대로 대 봤습니다.
즉시 적용형 조건 | 이번 패치 | 판정 |
|---|---|---|
국소적 — 한 곳으로 좁혀지나 | N6 함수 1개 | ✅ |
되돌릴 수 있나 | 환경변수 1개 | ✅ |
외부 영향 없나 | 사이드카 스키마 내부, 발송 없음 | ✅ |
같은 기준으로 자동 판정되나 |
| ✅ |
→ 즉시 적용형. 반대로 GuardrailAgent 금기어 규칙 변경(격국·용신·기신·희신의 문맥 기반 허용 범위 조정)은 네 번째 조건을 만족하지 못합니다. 자동 판정이 불가능하고, 잘못 열면 4관법 정체성이 흔들립니다. 이건 승인형으로 두었습니다.
3-4. Before / After — 하네스 도입 전후 전체 비교
BEFORE (일반 LLM 질의)
  계통     ①4관법·②박청화·③상리철학이 한 문단에 섞임
  근거     출처 불명 단정 — "명리학에서는 보통…"
  검증     없음. 오답을 사후에 발견
  부재     "없다"를 말하지 않음 — 없는 것도 있는 것처럼 서술
  재현     같은 명식·같은 질문에도 매번 다른 답

AFTER (헤르메스 Harness)
  계통     N2에서 단일 계통 고정 (판단층). 단계 내 혼용 금지
  근거     N5가 문장마다 [source:slide] 부착 (규율층)
  검증     N6 fail-closed — 부착률 1.00 미만이면 HELD (규율층)
  부재     ABSENT 유형으로 "없음"을 근거와 함께 확정
  가드     N4가 처방형 단정 차단 / 희기동소·격청격탁·재정립 맥락은 허용
  재현     동일 입력 → 동일 근거 slide 집합
(이미지 자리 ①: 실제 통변 출력 화면 — 문장마다 [박청화_정진반_下:9712] 형태의 근거가 붙은 상태) (이미지 자리 ②: Before/After 로그 대조 — cited/sent 열이 0.71 → 1.00으로 바뀐 표) (이미지 자리 ③: HELD 발생 화면 — 근거를 못 찾아 답변이 차단된 모습)
결과와 배운 점
꿀팁
실제 명식 1건을 끝까지 돌려 보는 것이, 설계도를 열 번 그리는 것보다 많은 걸 알려줍니다. 설계 단계에서 저는 "N6이 검증한다"고 적어 두고 안심하고 있었습니다. 그런데 N6이 실제로 검사하던 것은 "evidence 배열이 비었는가"뿐이었습니다. 문서에는 "검증"이라고 적혀 있고 코드는 다른 일을 하고 있었던 것 — 이게 제 프로젝트의 「문서 ≠ 사실」 원칙이 왜 필요한지 보여주는 살아있는 사례가 됐습니다.
두 번째 꿀팁은 판정표를 먼저 고정하는 것입니다. 질문 5개와 기준 3종을 먼저 못 박고 나서 패치를 만졌더니, "좋아진 것 같다"가 아니라 "0.71 → 1.00"이라고 말할 수 있게 됐습니다. 기준을 나중에 정하면 자기가 만든 패치에 유리한 기준을 고르게 됩니다.
세 번째는 되돌림 스위치를 패치와 동시에 만드는 것입니다. HERMES_N6_STRICT 환경변수를 먼저 넣고 로직을 바꿨습니다. 되돌릴 방법이 있으니 과감하게 적용할 수 있었습니다.
시행착오
더미 DB로 테스트하다 실제와 달라 혼란. 자동생성 10,000건이 들어 있는 hanbadook_dummy로 돌리면 검색이 잘 되는 것처럼 보였습니다. 실제 명식으로 바꾸는 순간 결과가 달라졌고, 원인을 찾는 데 반나절이 갔습니다. → 헤르메스 테스트는 hanbadook_production 고정. 자동생성(source='test_dummy')은 더미 DB에만, 수동 입력은 production에만. 혼용 금지를 원칙 문서에 올렸습니다.
두 번째 실수는 "검증했다"는 말을 제가 믿은 것입니다. 반성문 원칙 5번 — "결과 제공 전 필수 3종 검증"이 있는데도, 코드가 그 검증을 실제로 수행하는지는 확인하지 않았습니다. 강의에서 말한 검증 영수증이 정확히 이 문제였습니다. 완료 주장과 실행 증거를 분리해서 보관해야 합니다.
세 번째는 HELD를 실패로 오해한 것입니다. 패치 직후 HELD가 늘어난 걸 보고 "패치가 잘못됐나" 했는데, 그게 정상 동작이었습니다. 지표 방향을 미리 정의해 두지 않으면 좋아진 것을 나빠진 것으로 읽습니다.
도움 필요
통변 품질의 정량 평가 지표. 근거 부착률 1.00은 "형식"이 지켜졌다는 뜻이지 "내용"이 좋다는 뜻이 아닙니다. 근거 slide 7건을 붙였지만 그 7건이 질문과 상관없는 섹션일 수도 있습니다. 현재는 회수 충분도(RS)와 활용도(EU) 2지표를 나눠 설계 중인데, "명리 통변이 잘된 것"을 기계가 판정할 수 있는 형태로 어디까지 내려 쓸 수 있을지 조언을 구합니다.
한 가지 더 — 정답 일치를 합격 기준에 넣지 않기로 한 판단이 맞는지. 제 통변과 헤르메스 출력이 같은지를 기준으로 삼으면 편하지만, 그러면 헤르메스는 저를 흉내 내는 기계가 됩니다. 목표는 같은 답이 아니라 근거를 남기는 답이라고 정리했는데, 이 판단에 대한 다른 시각이 궁금합니다.
< 앞으로의 계획 >
한 번 쓰고 끝내지 않습니다. 이번 한 바퀴는 손으로 돌렸습니다. 다음 글에서는 이 여섯 칸 중 어느 칸을 시스템에 넘길지, 그 칸에 어떤 권한까지 줄지를 계약으로 적습니다 — 상시 Growth Loop 설계(사례글 10).
당장의 후속 작업은 세 가지입니다.
백로그에 남은 카드 정리 — 유사도 0.5395, 60갑자 19/60, 무물 108강 스텁 content
골든셋을 4건에서 50건으로 확장 (qtype 10종 × 5건)
N7 리뷰 하네스 출력을
hermes.tongbyun_quality테이블에 적재
도움 받은 글 (옵션)
23기 에이전트 하네스 4주차 강의자료 — Growth Loop 여섯 질문, 기본과제 6단계, 운영 유형 3종(즉시 적용형·승인형·크론형)
韓바둑 통변 고급화 전략 v2.0 — 5계층 구조, rtype 5종(FULL/PARTIAL/ABSENT/HELD/BLOCKED), 골든셋 4건
Claude 반성문 총괄표 v3.7 — 원칙 5 "결과 제공 전 필수 3종 검증", 원칙 3 "기능 추가 시 기존 기능 전체 유지"
데이터 분리 원칙(자동생성 vs 수동) 내부 메모
로그인하고 댓글을 남겨 주세요

이 글에서 가장 크게 남은 건 cited/sent가 0.71에서 1.00이 된 숫자보다, HELD 2건을 실패가 아니라 정상 차단으로 다시 읽은 대목이었어요. production과 dummy를 먼저 갈라 같은 입력·같은 질문·같은 판정표를 고정했고, 그 위에서 ‘evidence 배열이 비었는가’를 보던 N6을 문장 단위 부착률로 바꿨기 때문에 개선 원인이 선명합니다.
통변 품질 지표는 RS와 EU를 나눈 방향이 타당해 보여요. 여기에 문장 단위로 ① 인용 slide가 그 문장을 실제로 지지하는지(근거 충실도), ② 그 문장이 질문의 핵심 축을 다루는지(질문 관련성), ③ 중요한 축을 빠뜨리지 않았는지(핵심 범위)를 따로 채점하면, 형식 1.00과 내용 품질을 섞지 않을 수 있습니다. 골든셋도 하나의 모범답안 일치보다 복수 허용 답안, 금지 오류, 근거 없는 단정, 정당한 HELD를 함께 두는 편이 맞습니다.
그래서 정답 일치를 단일 합격 기준에서 빼신 판단에는 저도 동의해요. 다만 일치도를 완전히 버리기보다, ‘작성자와 같은 결론인가’가 아니라 ‘같은 근거 제약 안에서 허용 가능한 결론인가’를 전문가 블라인드 쌍대 비교로 점검하면 모방과 품질 평가를 분리할 수 있겠습니다.
무엇보다 ‘검증’이라는 이름을 믿지 않고 코드가 실제로 검사한 대상을 로그로 다시 확인한 태도가 인상 깊었습니다. 좋아진 답만 세지 않고 올바르게 멈춘 HELD까지 성과로 인정한 기록이, 이 하네스를 믿을 수 있게 만드는 가장 단단한 부분이에요.
읽어주신 각도가 제가 쓰면서 가장 조심스러웠던 지점을 정확히 짚어주셔서 고맙습니다. 남겨주신 세 가지 제안에 대해 하나씩 답을 드립니다.
1. 문장 단위 3종 채점 — 채택합니다.
지금 지표는 cite_ratio(형식) 위에 RS(회수 충분도)·EU(활용도)를 얹은 3층인데, 말씀하신 ①근거 충실도 ②질문 관련성 ③핵심 범위는 정확히 그 사이의 빈칸입니다. RS는 "요구 단계마다 근거가 1건 이상 잡혔는가"만 보고, EU는 "회수한 slide를 실제로 썼는가"만 봅니다. 둘 다 문서 단위라 "인용은 붙었는데 그 문장을 지지하지 않는다"를 잡지 못합니다. 그래서 cite_ratio 1.00 옆에 "이 값은 형식이 지켜졌다는 뜻이지 내용이 좋다는 뜻이 아니다"라는 문장을 문서에 못 박아 두었는데, 그 경고문을 지표로 바꿀 방법이 없었던 게 사실입니다.
구현은 사이드카 원칙을 지켜 별도 테이블로 가려 합니다. 기존 run 단위 기록은 손대지 않고, 문장 단위 채점만 새 테이블에 append하는 방식입니다. ①은 인용 slide 원문과 대조라 근거가 명확하고, ②③은 판정자가 필요하니 초기에는 사람이 채점하고 규칙이 안정된 뒤에 자동화하는 순서가 맞겠습니다. 특히 ③(핵심 범위)은 이미 qtype→요구 TS 고정표가 있어 분모를 흔들지 않고 셀 수 있습니다.
2. 골든셋 구성 — 지적하신 방향으로 다시 짭니다.
현재 골든셋 4건은 부재 판정 회귀 탐지용이라 성격이 좁습니다. 50건 확장분에 (a) 복수 허용 답안 (b) 금지 오류 — 4관법 금기어 처방형 단정 (c) 근거 없는 단정 (d) 정당한 HELD를 기대값으로 고정한 케이스를 나눠 담겠습니다. (d)가 특히 필요합니다. 지금 러너는 통과 케이스만 세고 있어서, "멈춰야 할 때 멈췄는가"는 아직 테스트가 아니라 로그 해석에 머물러 있습니다. 통과만 하는 테스트는 안전망이 아니라 장식이라고 적어놓고 정작 HELD 쪽은 비워둔 셈이었습니다.
3. 블라인드 쌍대 비교 — 동의하되, 평가자 분리가 선결 조건입니다.
"같은 결론인가"가 아니라 "같은 근거 제약 안에서 허용 가능한 결론인가"로 질문을 바꾸자는 정식화가 제가 찾던 표현입니다. 다만 파일럿을 가족 명식으로 잡은 이유가 제가 정답을 이미 안다는 점이었는데, 바로 그 이유로 제가 채점하면 블라인드가 성립하지 않습니다. 명식·출처를 가린 상태로 외부 평가자에게 쌍대 비교를 맡기는 설계를 먼저 만들고, 그 다음에 붙이겠습니다.
한 가지는 정직하게 덧붙입니다. 0.71→1.00은 명식 1건 End-to-End 기준이라 표본이 작습니다. 판정식과 되돌림 스위치를 패치와 동시에 넣은 것, production/dummy를 먼저 가른 것은 재현 조건을 고정하려는 조치였지 일반화 근거는 아닙니다. 이번 건에서 제가 얻은 건 숫자보다 반성문 한 줄이었습니다 — "문서에 적힌 검증을 코드가 실제로 수행하는지 확인하지 않았다." 기능명이 '검증'이라는 이유로 구현을 안 본 것이 원인이었고, 그래서 이제는 판정식 자체를 문서에 그대로 적어두기로 했습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



테스트 대상을 본인 명식으로 고정한 이유 — "정답을 이미 알고 있어야 출력이 부실한지 직접 판정할 수 있다" — 이 설명이 End-to-End 테스트의 핵심을 정확히 짚고 있어요.
hanbadook_production과 test_dummy를 절대 혼용하지 않는 원칙도, 처음에는 당연해 보이지만 글에서 밝히셨듯이 이걸 지키지 않았을 때 한나절을 날린 경험이 있어야 이만큼 단호하게 적을 수 있거든요. Before/After 비교 자체가 성립하려면 먼저 환경을 고정해야 한다는 게 실제 실패에서 나온 결론이라 더 설득력 있었어요.
7개 노드를 한 번의 invoke로 통과시키고, 그 결과로 나온 통변 문장에 근거 slide 번호가 붙어 있는지를 직접 눈으로 확인하는 과정 — 이걸 손으로 한 번 돌린 뒤에야 어디가 약한지 보인다는 흐름이 명확해서 사례글 10까지 자연스럽게 이어졌어요. 잘 읽었어요!