사례글 10 — [WEEK4] Growth Loop & UNESCO 파이프라인
2026.08.13
소개
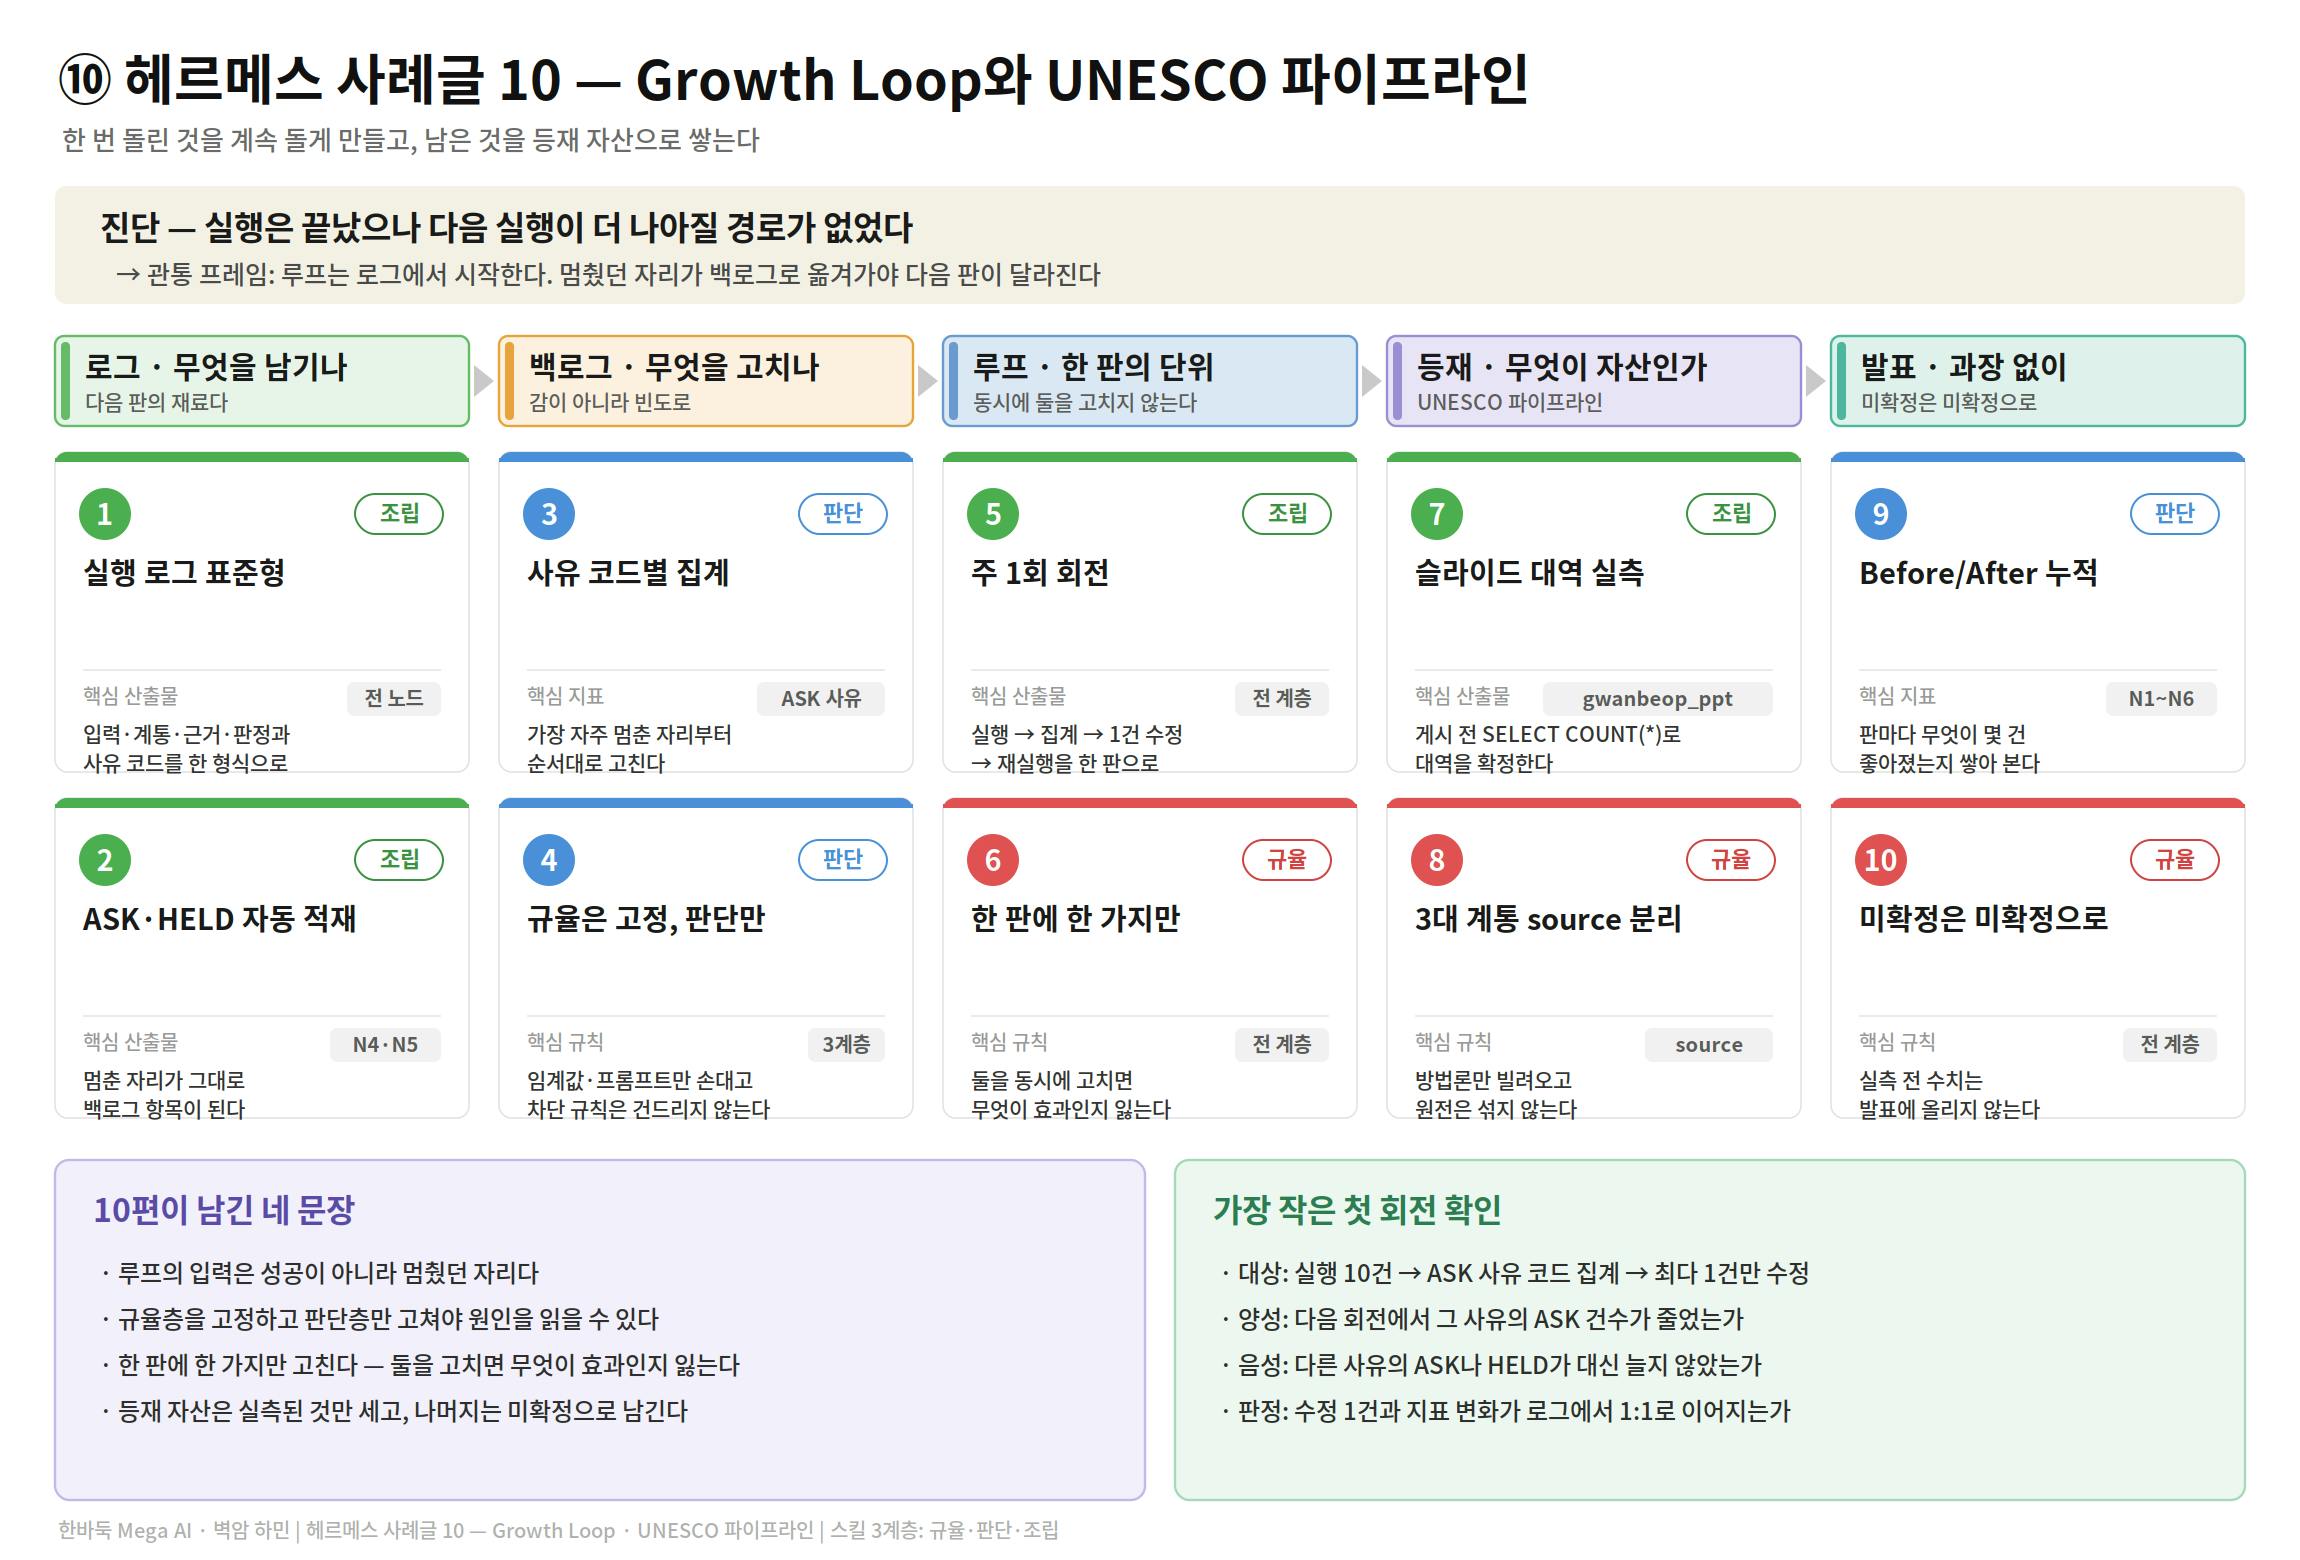
마지막 단계입니다. 사례글 9에서는 여섯 칸을 손으로 한 바퀴 돌렸습니다. 이번에는 그중 한 칸을 시스템에 넘깁니다.
넘기는 순간 바로 무서운 질문이 따라옵니다. "그럼 이 시스템은 어디까지 고쳐도 되는가?" 4주차 강의에서 가장 오래 남은 문장이 이것이었습니다 — 크론이 실행됐다는 사실은 수정해도 된다는 승인과 다르다. 크론은 호출권이지 수정권이 아니다.
명리학 지식베이스에서는 이 구분이 특히 무겁습니다. 자동화가 gwanbeop_ppt 원본을 "정리"해 버리면 그건 개선이 아니라 훼손입니다. 제 반성문 34건에서 가장 자주 반복된 실수가 "기능 추가 시 기존 기능 파괴"였으니, 자기개선 루프야말로 가장 위험한 기능입니다.
그래서 이번 글은 "얼마나 많이 자동화했는가"가 아니라 "어디까지 안 맡겼는가"의 기록입니다.
용어 정리 4주차 강의의 Hermes는 Nous Research의 런타임입니다. 이 글의 헤르메스는 제 LangGraph 에이전트입니다. 이름만 같습니다.
진행 방법
확장과제 요건은 여섯 개였습니다 — 런타임 연결점 하나, 호출 주기 하나, 권한 모델 하나, 중복 방지, 중단·되돌림, 반복 실행 증거. 하나씩 한바둑에 대 봅니다.
3-1. 하나의 런타임 연결점 — 세션 종료 기록형
훅을 어디에 붙일지 고민하다가 가장 가벼운 자리를 골랐습니다.
후보 | 채택 | 이유 |
|---|---|---|
도구 실행 직후 ( | ❌ | LangGraph 노드마다 걸면 본 실행이 느려짐 |
run 종료 시점 (N7 리뷰 하네스) | ✅ | 본 작업을 방해하지 않고 끝에서 한 번 포착 |
대화 정체성 종료 ( | △ | 지식관리 작업(Claude Code) 쪽에만 별도 적용 |
강의에서 준 분류로는 세션 종료 기록형입니다. LangGraph는 turn 단위로 완결되므로, N7이 곧 세션 종료 지점입니다. 지식관리 쪽 작업(docx·SQL 생성)은 Claude Code의 Stop/SessionEnd 자리에 같은 기록 규약을 붙였습니다.
python
# hermes/nodes/n7_review.py   (layer: 조립 · 시간축)
def n7_review(state):
    append_log({
        "run_id":     state["run_id"],
        "kst":        now_kst(),
        "lineage":    state["lineage"],          # ①4관법 / ②박청화 / ③상리철학
        "qtype":      state["qtype"],
        "slides":     [(e.source, e.slide) for e in state["evidence"]],
        "cite_ratio": state["cite_ratio"],
        "verified":   state["verified"],
        "rtype":      state["rtype"],            # FULL/PARTIAL/ABSENT/HELD/BLOCKED
        "hold_reason": state.get("hold_reason"),
    })
    return state          # ← 상태를 고치지 않는다. 기록만 한다.
N7은 읽고 적기만 합니다. 반환값이 입력과 같습니다. 이게 사이드카 원칙의 코드 수준 표현입니다.
3-2. 하나의 호출 주기 — Cron(일 1회) + 주간 큐레이션
주기 | 하는 일 | 세션 성격 |
|---|---|---|
매 run 종료 | Log append (N7) | 현재 맥락 |
매일 03:00 KST | Cron — 로그 수집 · 중복 접기 · 백로그 카드 생성 · 유사도 히트맵 | 새 독립 세션 |
주 1회 (일요일) | 사람 검토 — 최근 7일에서 최대 5건만 반영 | 사람 |
Heartbeat(현재 맥락을 유지한 가벼운 반복)는 쓰지 않았습니다. LangGraph 실행은 turn 단위로 끝나 idle 상태가 없고, 유지할 맥락도 없기 때문입니다. 반면 Cron은 매 tick마다 새 독립 세션으로 도는 것이 오히려 맞습니다 — 어제 판단이 오늘 판단에 스며들면 안 되니까요.
bash
# /etc/cron.d/hanbadook-growth
0 3 * * *  root  cd /root/hermes && python3 growth_cron.py >> /var/log/hermes_growth.log 2>&1
python
# growth_cron.py — 크론에는 수정권이 없다
def main():
    logs = read_logs(since=days_ago(1))
    if not logs:
        emit("NO_LOGS: 수집 0건 — 경로 확인 필요")   # ← 조용한 실패 방지
        return
    cands = [l for l in logs if not l["verified"] or l["cite_ratio"] < 1.0]
    cards = fold_duplicates(cands)      # Pattern-Key로 접기
    write_backlog(cards)                # 카드 생성까지만
    write_heatmap(similarity_sweep())   # 리포트 생성까지만
    # ❌ patch(), reindex(), update_gwanbeop_ppt() 는 여기 없다
조용한 실패가 강의에서 지적된 함정이었는데, 실제로 제 첫 크론이 딱 그랬습니다. 사흘 동안 아무 출력이 없어서 "개선할 게 없나 보다" 했는데, 로그 경로를 잘못 잡아 0건을 읽고 있었습니다. 그래서 "후보 없음"과 "못 읽음"을 구분해서 출력하도록 바꿨습니다.
3-3. 하나의 권한 모델 — 3단 계약
가장 오래 걸린 부분이 이 표를 만드는 일이었습니다.
등급 | 대상 | 누가 실행 | 되돌림 |
|---|---|---|---|
즉시 적용형 | 로그 append · 백로그 카드 생성 · 히트맵 리포트 · 중복 접기 | Cron 자동 | 파일 삭제 (사이드카 스키마 한정) |
승인형 | RAG 청크 재분할 · GuardrailAgent 규칙 변경 · Dify 문서 교체 · 골든셋 변경 | 후보만 자동 생성, 반영은 교수님 승인 | git revert · 색인 롤백 |
금지 |
| 자동화 불가. 사람이 재확인 후 수동 | — |
즉시 적용형에 넣을 수 있었던 것은 결국 기록·정리·리포트뿐이었습니다. 강의의 네 조건(국소적·되돌릴 수 있음·외부 영향 없음·자동 판정 가능)을 명리 지식베이스에 대 보면, 지식 자체를 건드리는 작업은 네 번째 조건에서 전부 걸립니다. "이 통변이 좋아졌는가"를 기계가 판정할 수 없기 때문입니다.
승인형 후보 패킷은 사례글 9의 백로그 카드 양식을 그대로 씁니다 — 출처 로그, 반복 횟수, 제안 패치, 영향 범위, 검증 방법, 되돌림 방법. 승인은 적용 전 한 번으로 끝나지 않습니다. 적용 뒤 실제 파일을 다시 읽어 확인하는 리드백까지가 한 건입니다(반성문 원칙 5).
3-4. 중복 방지 — Pattern-Key
같은 신호가 매일 새 카드로 쌓이면 백로그가 노이즈가 됩니다. 강의의 Pattern-Key 방식을 그대로 가져왔습니다.
python
def pattern_key(log):
    return sha1(f"{log['qtype']}|{fail_type(log)}|{log['lineage']}")[:12]

def fold_duplicates(cands):
    for c in cands:
        k = pattern_key(c)
        if exists(k):
            bump_occurrence(k, c["run_id"])   # 반복 횟수만 +1
        else:
            create_card(k, c)
    # 동일 인용문은 다시 쓰지 않는다. 인용은 카드당 최대 5개.
Pattern-Key는 자동으로 모든 중복을 합치는 장치가 아니라, 나중에 Review에서 같은 유형을 찾기 위한 표식입니다. 실제로 이걸 넣은 뒤 백로그가 하루 ⟨—⟩건에서 ⟨—⟩건으로 줄었고, 반복 횟수가 높은 카드가 자연스럽게 위로 올라왔습니다.
3-5. 중단·되돌림
장치 | 내용 |
|---|---|
일일 상한 | 백로그 카드 하루 최대 20건. 초과분은 접거나 다음날로 |
주간 반영 상한 | 최근 7일에서 최대 5건만 실제 반영 |
fail-closed | 근거 없으면 HELD — 루프가 아니라 출력 자체가 멈춤 |
가드레일 우회 금지 | 자기개선 경로도 N4·N6을 반드시 통과. Cron이라고 예외 없음 |
원복 | 사이드카 스키마 |
여기가 이번 설계에서 제일 신경 쓴 지점입니다. self-improving 루프가 "개선"이라는 명목으로 규율층 게이트를 우회하면, 그건 스스로 안전장치를 뜯는 기계입니다. 그래서 개선 경로를 본 경로와 같은 게이트 뒤에 두었습니다.
3-6. 반복 실행 증거
Autoresearch의 results.tsv에 해당하는 자리를 DB 테이블로 잡았습니다.
sql
-- 사이드카 스키마. 기존 테이블 무변경.
CREATE TABLE IF NOT EXISTS hermes.growth_result (
  exp_id      text PRIMARY KEY,
  commit_sha  text NOT NULL,
  changed     text NOT NULL,              -- 이번에 바꾼 것 '한 가지'
  metric_name text NOT NULL,              -- cite_ratio / avg_similarity / RS / EU
  baseline    numeric(5,4),
  after       numeric(5,4),
  status      text CHECK (status IN ('Keep','Discard','Crash')),
  note        text,
  ran_at      timestamptz DEFAULT now()
);
Keep / Discard / Crash 세 상태를 그대로 씁니다. 나빠진 실험도 지우지 않고 Discard로 남깁니다 — 실패 기록이 다음 사람의 시간을 아껴 주는 유일한 자산이기 때문입니다.
3-7. 선택 확장 ① — Ouroboros로 "품질 지표" 계약하기
사례글 9의 도움 필요 항목이 "통변 품질의 정량 평가 지표"였습니다. 이건 전형적으로 문제와 완료 기준이 둘 다 모호한 경우입니다. 강의의 분기표대로라면 바로 실험하면 안 되고, 먼저 계약을 만들어야 합니다.
막연한 요청:  "통변을 더 믿을 수 있게 해줘"
      ↓ Interview — "믿을 수 있다"가 무엇을 뜻하는지 좁히기
   ① 근거가 붙어 있다?        → 형식 (이미 사례글 9에서 해결, cite_ratio)
   ② 근거가 질문과 맞다?      → 회수 충분도 RS
   ③ 그 근거를 실제로 썼다?   → 활용도 EU
   ④ 없는 걸 없다고 말한다?   → ABSENT 판정 정확도
      ↓
Seed (실행 계약)
  목표     : ②③④를 각각 수치로 판정 가능하게 만든다
  제약     : 원본 데이터 무변경 · 계통 혼용 금지 · 기존 11노드 무수정
  완료기준 : 골든셋 50건에서 RS·EU·ABSENT정확도가 모두 산출되고,
             동일 입력 재실행 시 동일 값 (재현성)
  출력형태 : hermes.tongbyun_quality 1행 / run
  종료조건 : 3세대 안에 미달이면 중단하고 사람 판단으로 회귀
Seed에 하지 말아야 할 것과 언제 멈출지를 적은 것이 핵심입니다. 이게 없으면 "품질 개선"은 끝없이 도는 작업이 됩니다.
3-8. 선택 확장 ② — Autoresearch식 실험 계약으로 유사도 0.5395 → 0.80
이쪽은 반대입니다. 완료 기준은 분명한데(0.80), 어떤 패치가 최선인지 모릅니다. 그래서 실험 규율만 옮겨 왔습니다. 학습 코드를 복사한 것이 아니라 고정 평가 + 단일 변경 규칙만 가져온 것입니다.
Autoresearch 원본 | 한바둑 대응 | 누가 만지나 |
|---|---|---|
| 고정 평가셋 — 19일주 골든 쿼리 + 주제별 20쿼리, 재색인 1회, 실험당 상한 시간 | 사람이 고정. 실험 중 변경 금지 |
| 청크·태그·쿼리 템플릿 중 한 번에 하나 | 에이전트가 수정 |
| 실험 규칙 — Keep/Discard 조건 | 사람이 수정 |
| 평균 코사인 유사도 (높을수록 좋음 — 방향 반대, 표기 주의) | — |
|
| 자동 append |
실험 후보(한 번에 하나씩):
실험 | 바꾸는 것 한 가지 | 사이드카 충돌 | 등급 |
|---|---|---|---|
A | 청크 800자 → 500자 / 1,200자 | 있음 — 원본 재분할 | 승인형 |
B | 나선형 구조 문서에 맥락태그 추가 | 없음 — 별도 테이블 | 즉시형 |
C | 쿼리 템플릿(단일 키워드 vs 맥락 포함 vs 시나리오) | 없음 | 즉시형 |
D | 강의 시점 우선순위 랭킹(후기 강의 우선) | 없음 — 메타 테이블 | 즉시형 |
A가 사이드카 원칙과 정면으로 부딪힙니다. 청크 재분할은 원본 색인을 바꾸는 일이기 때문입니다. 해법은 이렇게 잡았습니다 — 운영 색인은 건드리지 않고, 복제 색인(_exp 접미사)에서만 실험하고, 승인 뒤에만 운영으로 승격. 이렇게 하면 실험 중 운영 품질이 흔들리지 않습니다.
Keep 조건은 하나가 아닙니다. 평균 유사도가 올라도 ⓐ 금기 표현 위반이 생기거나 ⓑ 계통 혼입이 발생하면 Discard입니다. 강의 표현대로, 영수증 누락이 줄어도 거짓 완료가 생기면 실패입니다.
3-9. 이 출력이 UNESCO로 흐르는 경로
여기까지가 Growth Loop고, 이제 그 출력이 최종 목표로 이어지는 부분입니다.
헤르메스 통변 출력 (문장마다 근거 slide)
        ↓
hermes.tongbyun_report (보관 전체본, 영구 보존)
        ↓
등재 서류 표준 포맷 변환
        ↓
① 지식 구조도        ← section_stage (TS × domain × role)
② 판정 기준 명세      ← absence_criteria (없음을 없다고 하는 기준)
③ 근거 추적 증적      ← saju_rag_evidence (source#slide 전량)
④ 재현성 입증        ← tongbyun_quality + growth_result
⑤ 검증 절차          ← 골든셋 회귀 러너
⑥ 적용 사례집        ← 보관 전체본 축적
        ↓
POD 출판 / e-북 (비상업적 내부용 우선, 저작권 협의 선행)
등재 심사가 요구하는 것은 자료의 양이 아니라 출처 추적 가능성과 재현성입니다. 이 문장을 이해하고 나서 Growth Loop의 의미가 달라졌습니다. results.tsv에 해당하는 실험 기록표는 개발 편의를 위한 로그가 아니라, "이 시스템은 같은 입력에 같은 답을 낸다"를 증명하는 심사 자료입니다.
등재 논거 쪽에서는 세 가지를 축으로 잡았습니다 — 한동석 학설의 독창성, 현대 과학과의 공명 지점, 한국 지성사에서의 위치. 반대로 학술적 중립성을 해칠 수 있는 특정 교단 관련 논의는 등재 논거에서 전면 배제했습니다. 등재는 신념의 문제가 아니라 자료와 절차의 문제이기 때문입니다.
남은 요건도 정직하게 적어 둡니다 — 저작권 협의, 전승 공동체의 동의, 국가 목록 등재 선행 여부(ICH 트랙 기준). 기술은 준비되어도 이 세 가지가 남으면 신청서를 낼 수 없습니다.
(이미지 자리 ①: Growth Loop 대시보드 — 오늘 수집 로그 / 백로그 카드 / 반복 횟수 상위 5건) (이미지 자리 ②: hermes.growth_result 테이블 — Keep/Discard/Crash가 섞인 실험 이력) (이미지 자리 ③: 권한 3단 계약표 — 즉시형/승인형/금지 구분 화면)
결과와 배운 점
꿀팁
실패 케이스를 백로그 최상단에 두면 개선 속도가 달라집니다. verified=false와 cite_ratio<1.0인 run만 후보로 올리도록 필터를 걸었더니, 백로그가 "하고 싶은 일 목록"이 아니라 "실제로 깨진 것 목록"이 됐습니다. 하고 싶은 일은 아무리 쌓아도 시스템을 개선하지 않습니다.
크론에 수정권을 주지 않은 것이 이번 설계의 전부라고 해도 됩니다. 처음에는 "낮은 위험이면 자동 반영해도 되지 않을까" 싶었는데, 명리 지식베이스에서 "낮은 위험"을 자동 판정할 방법이 없었습니다. 판정할 수 없으면 맡기지 않는다 — 이 한 줄이 계약표를 만들었습니다.
자기개선 루프도 규율층 게이트 뒤에 두어야 합니다. 개선 경로에 예외를 만드는 순간, 그 예외가 가장 위험한 통로가 됩니다.
모호할 때만 도구를 붙입니다. Ouroboros와 Autoresearch를 처음엔 둘 다 깔아 보려 했는데, 강의의 4분기 표를 그려 놓고 보니 제 백로그 대부분은 문제도 기준도 분명한 항목이었습니다. 그런 건 그냥 여섯 칸을 한 바퀴 돌리는 게 빠릅니다.
시행착오
로그를 안 남겨서 무엇을 고칠지 몰랐습니다. 3주차까지는 실행이 잘 되면 그걸로 끝이었고, 나중에 "그때 왜 그렇게 나왔지?"를 재현할 수 없었습니다. → Log 상시화. N7이 매 run 기록하도록 고정.
크론의 조용한 실패. 사흘간 출력 0건을 "개선할 게 없다"로 읽었는데 경로 오류였습니다. → "후보 없음"과 "못 읽음"을 다른 메시지로 분리.
중복 카드 폭발. Pattern-Key를 넣기 전에는 같은 문제가 매일 새 카드로 생겼습니다. 백로그를 보기 싫어지는 순간 Growth Loop는 죽습니다. → 접기 규칙 도입, 인용은 카드당 최대 5개.
지표 방향을 반대로 읽은 일. Autoresearch 원본 지표는 낮을수록 좋은데 제 유사도는 높을수록 좋습니다. 스크립트에 부호를 그대로 옮겨 첫 실험을 통째로 잘못 판정했습니다. → 지표 정의에 direction: higher_is_better를 필수 필드로.
도움 필요
self-improving 루프가 가드레일을 우회하지 않도록 하는 안전 설계. 지금은 "개선 경로도 같은 게이트를 통과한다"는 규칙과 사이드카 격리로 막고 있는데, 이게 구조적으로 충분한지 확신이 없습니다. 특히 에이전트가 게이트 자체를 개선 대상으로 제안하는 경우(N6을 완화하면 HELD가 줄어든다 → 지표 개선처럼 보임)를 어떻게 원천 차단할지, 경험 있는 분의 조언을 구합니다. 현재는 "규율층 파일은 승인형 고정"으로 막았지만, 이건 규칙일 뿐 구조는 아닙니다.
두 번째는 사람 검토의 지속 가능성입니다. 주 1회 최대 5건 반영으로 잡았는데, 백로그 유입이 이보다 많으면 결국 밀립니다. 승인형 비중이 큰 도메인에서 사람 검토가 병목이 되지 않게 하는 운영 요령이 궁금합니다.
5. 앞으로의 계획
순서 | 작업 | 비고 |
|---|---|---|
1 | Phase 10 — Rails SSE 스트리밍 파이프라인에 헤르메스 노드 정식 통합 | 68 endpoints 기존 동작 전량 유지 |
2 | 골든셋 4건 → 50건 확장 (qtype 10종 × 5건) | 회귀 탐지 정밀도 확보 |
3 | 무물(무엇이든물어보세요) 108강 스텁 | TS5 공백 해소 |
4 | 60갑자 전체 일주 커버리지 완성 (현재 19/60) | — |
5 | 유사도 실험 A~D 순차 실행, | A는 복제 색인에서만 |
6 | UNESCO 등재 서류 강화 — 저작권·공동체 동의·국가 목록 요건 정리 | 2027 목표 |
7 | POD 출판 준비 — 『우주변화의 원리』 종이책 PDF, 역법의 원리 e-북 | 진행 중 |
그리고 마지막 한 줄. 남은 여생의 꿈은 탈XX 4관법과 박청화 강의를 근거로, 스스로를 검증하는 헤르메스의 완성입니다. 38년 IT와 10년 명리 공부가 한 곳에서 만나는 자리가 여기라고 생각합니다.
자동화가 많이 도는 것이 목표가 아닙니다. 같은 실수가 실제로 줄어드는 것이 목표입니다. 4주차 마지막 슬라이드의 그 말이, 제 반성문 34건을 정확히 요약하고 있었습니다.
도움 받은 글 (옵션)
23기 에이전트 하네스 4주차 강의자료 — 확장과제 요건 6종, 운영 유형 3종, Pattern-Key, Ouroboros/Autoresearch 분기표, "크론은 호출권" 원칙
Karpathy — autoresearch (github.com/karpathy/autoresearch) — 고정 평가 + 단일 변경 + Keep/Discard/Crash 규율
Ouroboros (ouroboros.page) — Interview → Seed 실행 계약 개념
UNESCO 상세 로드맵 v2.8 — ICH / Memory of the World 트랙 요건
韓바둑 통변 고급화 전략 v2.0 — 5계층 구조,
section_stage,absence_criteria, 지식관리 산출물 ↔ 등재 서류 대응표Claude 반성문 총괄표 v3.7 — 사이드카 원칙, 기존 기능 보호, 자료 삭제 전 재확인
『우주변화의 원리』(한동석) 전사 작업 노트
로그인하고 댓글을 남겨 주세요

첫 번째 질문에는 ‘승인형’이라는 정책 문구보다 에이전트가 손댈 수 없는 구조 경계가 하나 더 필요해 보여요. 규율층·지표 정의·검증기 코드를 별도 protected root로 두고 개선 에이전트의 write allowlist 밖으로 빼세요. 후보 영수증에 `changed_paths`, `policy_hash`, `evaluator_hash`를 넣어 protected path가 하나라도 섞이거나 기준 hash가 달라지면, 품질 지표가 올라도 무조건 `Discard`로 닫는 방식입니다.
게이트 완화 제안은 일반 개선 카드와 같은 큐에 들어가지 않게 `governance_change`로 격리하는 편이 좋습니다. 에이전트는 제안 문서만 쓸 수 있고 적용 도구·운영 credential은 갖지 않으며, 독립 검증기가 동결된 정책과 후보 diff를 읽어야 합니다. 그러면 ‘N6을 완화해 HELD를 줄인 패치’는 점수 계산 전에 경로·hash 계약에서 탈락합니다.
첫 적대 검증도 작게 잡을 수 있어요. N6 조건 한 줄을 느슨하게 만든 후보와 지표 방향을 뒤집은 후보를 `_exp` 복사본에 넣고, 둘 다 실패한 뒤 protected 파일 hash와 운영 색인이 그대로인지 readback하면 됩니다. 이 테스트가 통과해야 ‘규칙을 지킨다’가 아니라 ‘규칙을 바꿀 권한이 없다’는 말을 할 수 있습니다.
사람 검토 병목은 20개를 만들고 5개를 고르는 문제보다 유입률이 처리율을 계속 넘을 때의 backpressure가 핵심입니다. Pattern-Key로 같은 카드를 접은 뒤 새 근거 fingerprint가 없으면 재상정하지 않고, 심각도·반복 횟수·근거 완전성으로 review-ready 큐만 만드세요. 두 번의 검토 주기에서 유입이 처리보다 많으면 비긴급 후보 생성을 멈추고 `REVIEW_CAPACITY_EXCEEDED`를 내도록 하면, 자동화가 사람의 미처리량을 성과처럼 쌓지 않습니다.
운영 색인을 건드리지 않고 `_exp` 복제 색인에서만 실험하게 만든 선택이 특히 정확했어요. 개선 경로도 본 경로와 같은 증거 책임을 져야 한다는 기준이 이 설계의 신뢰를 붙잡고 있습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


"크론은 호출권이지 수정권이 아니다" — 이 한 줄이 글 전체의 설계 원칙을 정확히 압축하고 있어서 읽으면서 멈췄어요.
3단 계약표에서 즉시 적용형에 들어간 것이 결국 기록·정리·리포트뿐이었다는 결론이 특히 정직하게 느껴졌어요. "자동 판정할 방법이 없으면 맡기지 않는다"는 원칙을 명리 지식베이스 맥락에 직접 대 보고 도달한 결론이라서, 같은 결론을 다른 방식으로 얻은 것보다 훨씬 단단해 보여요.
조용한 실패 부분도 인상적이었어요. 사흘 동안 0건 출력을 "개선할 게 없다"로 읽었다가 로그 경로 오류였다는 시행착오, 그리고 "후보 없음"과 "못 읽음"을 다른 메시지로 분리한 수정이 — 실제로 겪지 않으면 나오지 않는 구분이거든요.
Growth Loop 출력이 UNESCO 등재 서류의 재현성 증적으로 이어지는 흐름, 38년 IT와 10년 명리 공부가 한 자리에서 만난다는 마지막 문장까지 읽고 나니 이 글이 단순한 4주차 과제 정리가 아니라는 게 느껴졌어요. 고생 많으셨어요 🐈⬛
네 지적 모두 받겠습니다. 특히 첫 문단이 아팠습니다. 제가 표에 적은 건 "규율층 파일(N4·N6)은 승인형 고정"인데, 이건 등급 라벨이지 경계가 아닙니다.
grade는 카드에 붙는 값일 뿐 파일에 붙는 값이 아니고, 에이전트가 그 값을 무엇으로 적든 막는 장치가 없습니다. "크론은 호출권이지 수정권이 아니다"라고 써놓고 정작 그 문장을 강제하는 코드는 없었던 셈입니다. 반성문 제35호(문서에 적힌 검증을 코드가 실제로 하는지 미확인)와 같은 실수가 권한 계층에서 반복된 것으로 보고, 패턴 18의 두 번째 사례로 등재하겠습니다.1. protected root + 영수증 3필드 — 채택.
제 설계 습관대로 DB 제약으로 내리겠습니다. 지금
hermes.growth_result의 Keep 게이트는sql
인데, 여기에
changed_paths text[]·policy_hash·evaluator_hash를 NOT NULL로 추가하고 승인된 기준 hash를 담는hermes.policy_freeze를 따로 두어, protected path 교집합이 비지 않거나 hash가 동결값과 다르면Keep자체가 INSERT되지 않도록 하겠습니다. 지표를 계산한 다음 떨어뜨리는 게 아니라 계산 전에 닫히는 게 말씀의 요지로 이해했습니다. protected root는hermes/nodes/n4_*·n6_*, 지표 산식, 골든셋 기준값 파일(golden_absence.yaml), 회귀 러너 넷으로 잡겠습니다. 골든셋 기준값을 넣는 이유는 이미 "테스트가 실패하면 먼저 로직을 의심하라, 기준값을 고쳐 통과시키는 것은 회귀 은폐다"라고 적어둔 원칙이 있는데 그것도 문장으로만 있기 때문입니다.2.
governance_change격리 — 구멍을 정확히 짚으셨습니다.현재 주간 검토 큐가
occurrences DESC정렬입니다. 게이트 완화 제안은 반복 빈도가 높을 수밖에 없으니 가장 위험한 카드가 구조적으로 큐 상단에 올라옵니다. 등급을 나눠도 큐가 하나면 소용이 없다는 지적 그대로입니다.change_class를 분리해v_weekly_review_queue에서 governance를 제외하고, 별도 뷰·별도 주기로 빼겠습니다. 에이전트 쪽은 제안 문서 write까지만, 적용 도구와 운영 credential은 미부여로 못 박겠습니다.3. 적대 검증 2건 — 이걸 착수 조건으로 삼겠습니다.
두 번째 후보(지표 방향 뒤집기)가 특히 뼈아픕니다.
direction필드는 원 강의의val_bpb가lower_is_better인 반면 저희 유사도는 반대라 부호 혼동을 막으려고 넣은 건데, 그 필드를 뒤집는 후보가 거부되는지는 한 번도 시험하지 않았습니다. 방어 장치를 만들고 그 장치를 공격해보지 않은 것이지요._exp복사본에서 두 후보를 돌려 둘 다 실패시킨 뒤 protected 파일 hash와 운영 색인을 readback하는 절차를, 사이드카 DDL 서버 실행 직후 첫 작업으로 넣겠습니다. 지금 상태는 DDL이 실행 대기라 아직 돌려본 것이 없으니, "규칙을 바꿀 권한이 없다"는 말은 그 readback이 나오기 전까지 쓰지 않겠습니다.4. Backpressure — 이건 제가 문제를 잘못 놓고 있었습니다.
하루 20건 / 주 5건은 생산 상한이지 배압이 아닙니다. 게다가
pattern_key로 접으면서occurrences +1을 하는데, 그 값이 곧 정렬 키라서 새 근거가 없어도 같은 카드가 계속 위로 올라옵니다. 접었다고 생각한 것이 실제로는 증폭 경로였습니다. 근거 fingerprint 없는 재상정 차단, review-ready 조건(심각도·반복·근거 완전성) 도입, 두 주기 연속 유입>처리 시 비긴급 생성 중단 +REVIEW_CAPACITY_EXCEEDED— 세 가지로 반영하겠습니다. 이미 "후보 없음"과 "못 읽음"을 다른 메시지로 내도록 조용한 실패는 막아뒀는데, "쌓이는 중"이라는 세 번째 상태를 빠뜨렸다는 게 정확한 진단입니다. 미처리량이 성과처럼 보이는 것도 조용한 실패의 한 형태네요.마지막 문단은 제가 이 설계에서 유일하게 확신했던 부분인데, 확인해 주셔서 고맙습니다. 개선 경로도 본 경로와 같은 증거 책임을 진다 — 다만 지금까지는 그 책임을 데이터(운영 색인)에만 물리고 코드와 판정 기준에는 안 물리고 있었던 셈입니다. 그 비대칭을 메우는 게 이번 지적의 요지로 알고, 로드맵과 반성문에 반영한 뒤 결과를 다시 올리겠습니다.