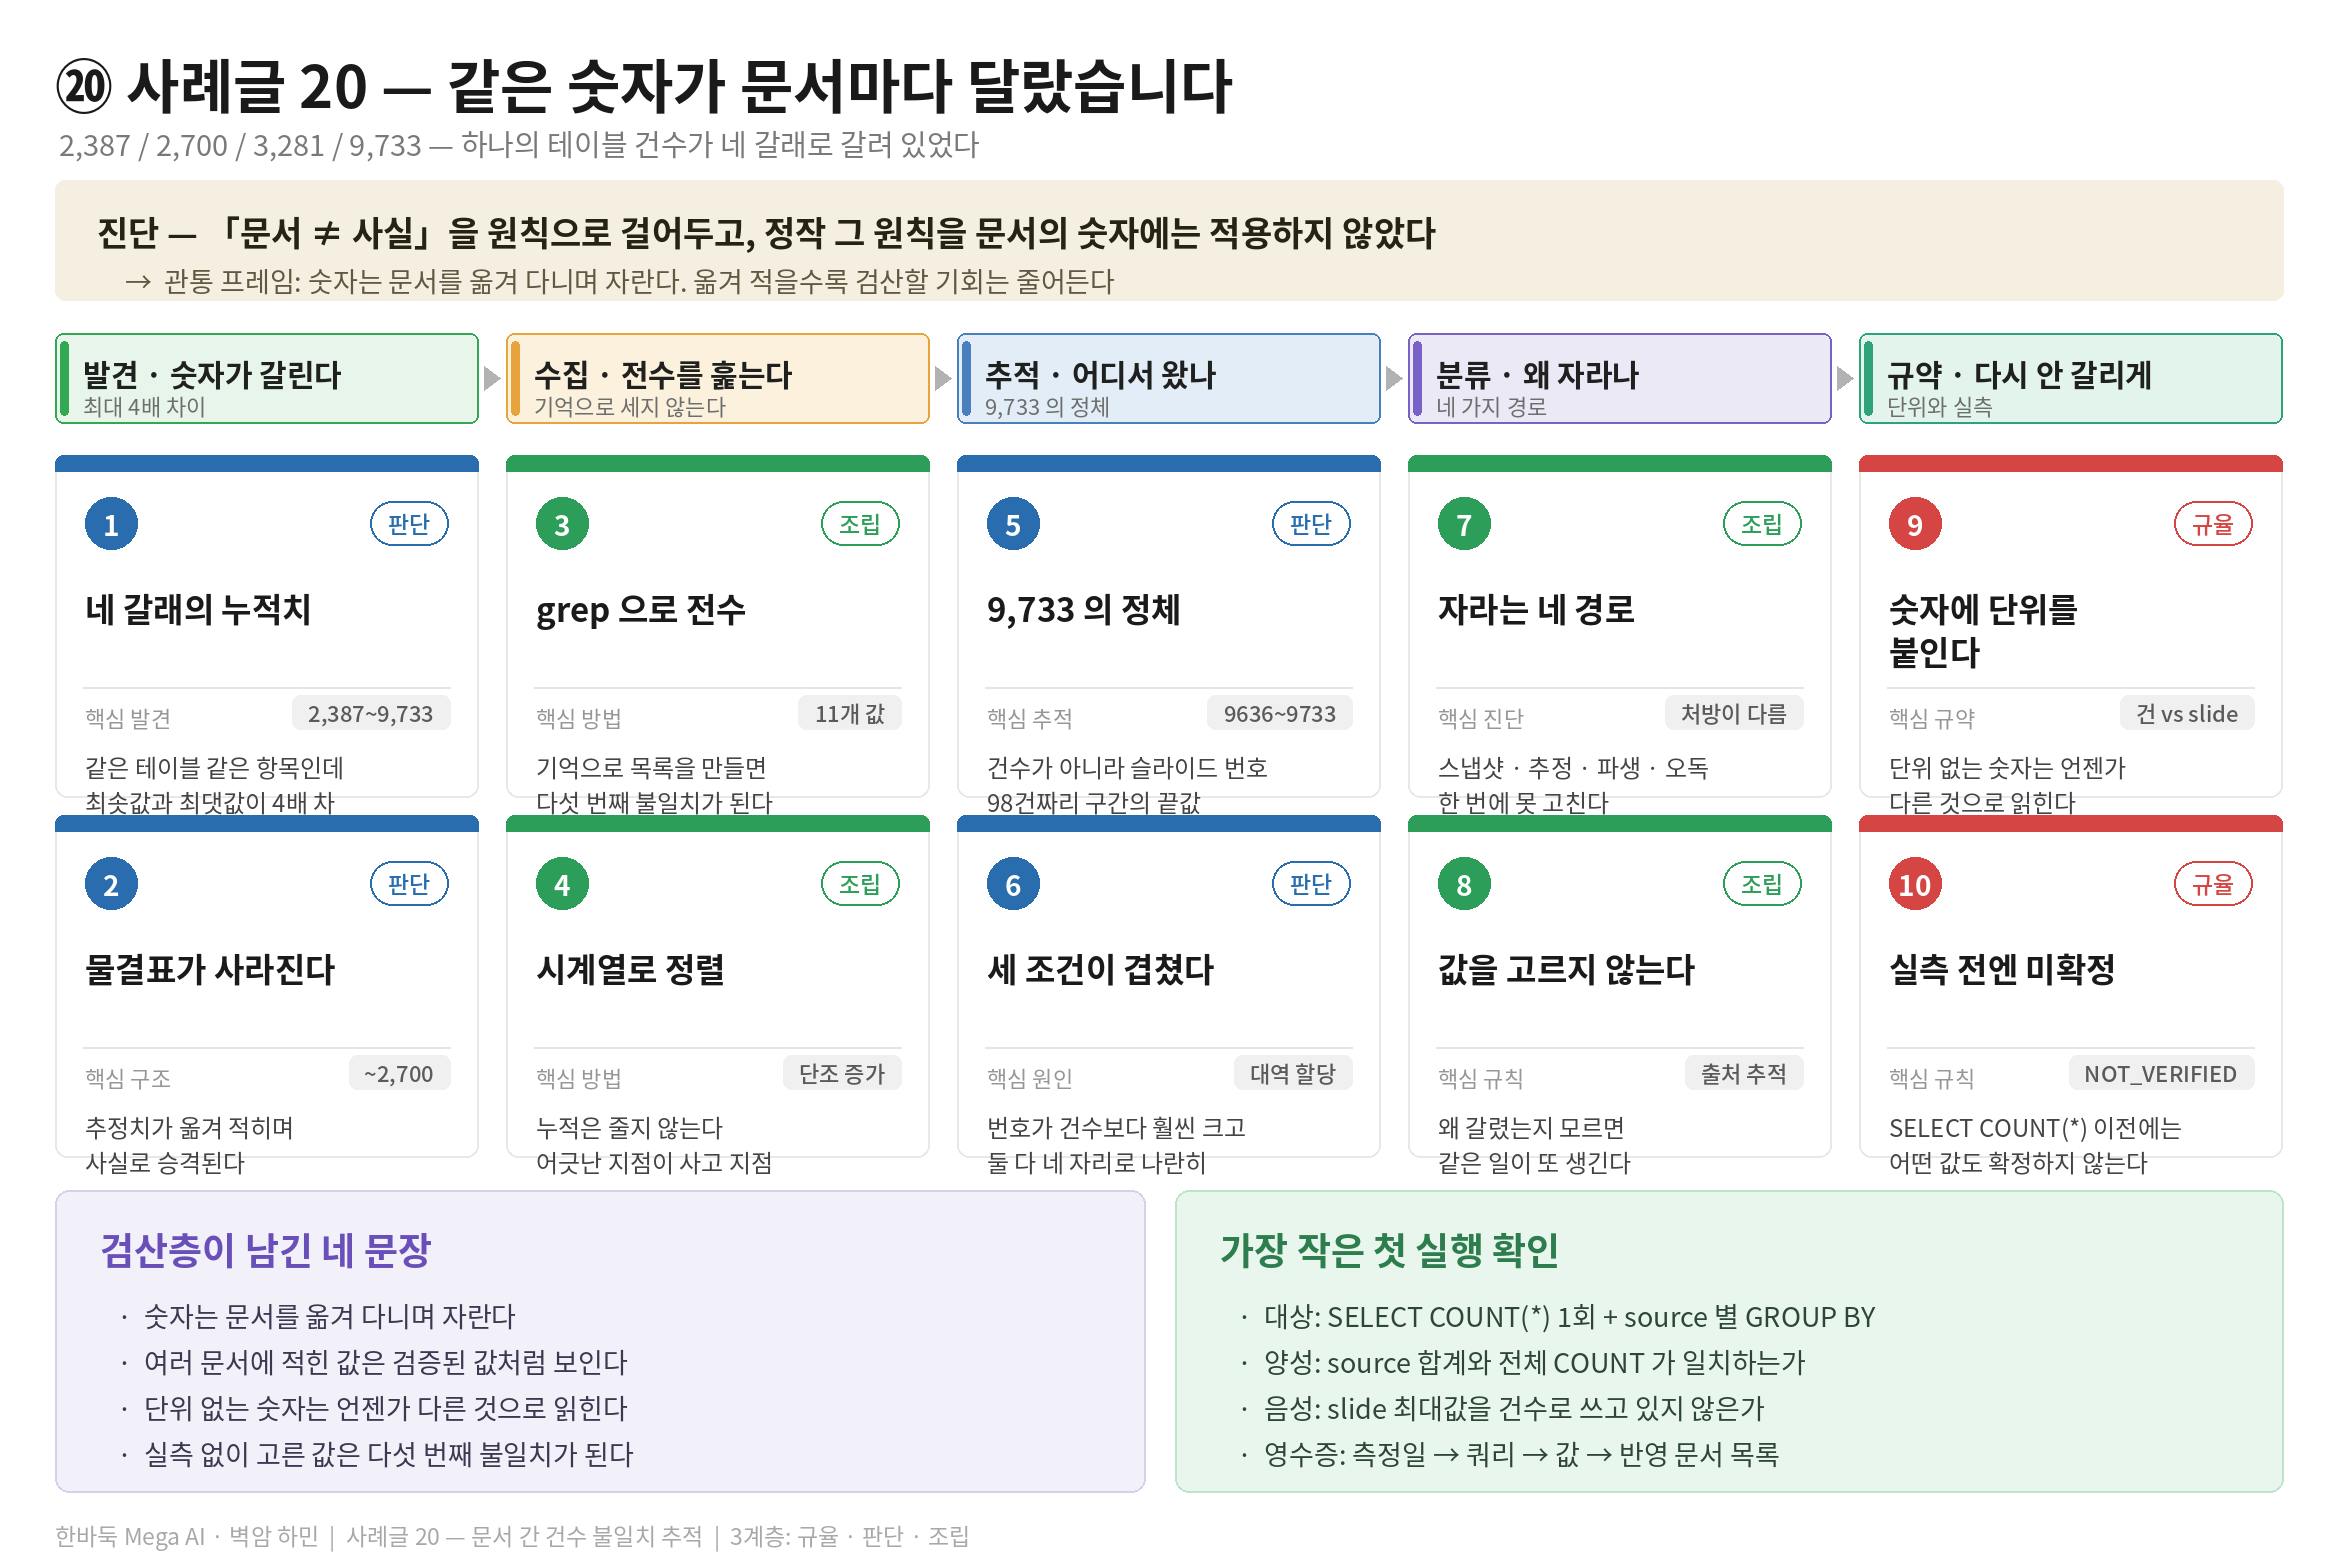
사례글 20 — 같은 숫자가 문서마다 달랐습니다2,387 / 2,700 / 3,281 / 9,733, 하나의 테이블 건수가 네 갈래로 갈린 이유를 추적한 기록
2026.08.14
소개
원칙은 이미 있었습니다
제 프로젝트에는 「문서 ≠ 사실」이라는 원칙이 있습니다. 반성문 34건을 쌓다가 나온 것으로, 문장은 이렇습니다.
수치는 서버
SELECT COUNT(*)확인 전까지NOT_VERIFIED로 취급한다.
문서에 적힌 숫자를 사실로 믿지 말라는 뜻입니다. 여러 번 데인 끝에 세운 원칙이라 꽤 신뢰하고 있었습니다.
그런데 정작 문서들이 서로 다른 숫자를 말하고 있었습니다
헤르메스 관련 지식관리 문서를 정리하다가 미해결 목록에 이 한 줄을 적게 됐습니다.
gwanbeop_ppt 누적 실측 — 문서마다 2,387 / 2,700 / 9,733으로 불일치. 실측 후 전 문서 일괄 동기화
gwanbeop_ppt는 명리 강의 자료를 담은 핵심 테이블입니다. 슬라이드 한 장이 한 행입니다. 그 누적 건수가 문서마다 다릅니다.
최소 2,387, 최대 9,733. 4배 넘게 차이 납니다.
왜 그냥 넘길 수 없었나
세 가지 때문입니다.
① 2027년 UNESCO 등재를 준비 중입니다. 심사가 요구하는 건 자료의 양이 아니라 출처 추적 가능성과 재현성입니다. 신청서에 적을 숫자가 내부 문서에서 네 갈래로 갈려 있으면, 그 자체가 결격 사유입니다.
② 이 숫자가 판단의 근거로 쓰이고 있었습니다. "Row(원천 데이터)는 이미 충분하다, 문제는 검색 품질이다"라는 결론을 내린 근거가 이 건수였습니다. 근거 숫자가 틀렸으면 결론도 다시 봐야 합니다.
③ 앞선 사례글에서 같은 종류의 실수를 두 번 썼습니다. 「금기어 위반 0건」이 성능이 아니었던 것, 「유사도 0.38 → 0.5395」가 서로 다른 자로 잰 값이었던 것. 이번이 세 번째입니다. 한 번은 사고이고 세 번은 구조입니다.
그리고 추적하다가 하나를 찾았습니다
9,733은 건수가 아니라 슬라이드 번호였을 가능성이 높습니다.
정진반 下편의 slide 범위가 9636~9733입니다. 98건짜리 구간의 끝 번호입니다. 그 값이 어느 시점에 "9,733건"으로 읽혔고, 그대로 굳었습니다.
진행 방법
3-1. 기억으로 세지 않고 파일을 훑었습니다
"어느 문서에 뭐라고 적혀 있더라"를 기억으로 재구성하면 또 다른 오류가 생깁니다. 전수 검색부터 했습니다.
bash
# ① 누적 건수 표현 전수 수집
grep -rnoE "(누적|합계|총계|전체|grand_total|예상)[^0-9]{0,25}[0-9],[0-9]{3}[0-9]*\s*건" *.md

# ② gwanbeop_ppt 근처의 네 자리 숫자
grep -rno "gwanbeop_ppt[^|]\{0,60\}" *.md | grep -E "[0-9],?[0-9]{3}"

# ③ 문제의 세 값이 어디서 나왔는지 역추적
grep -rn "9,733\|9733" *.md
grep -rn "2,387\|2387" *.md
grep -rn "3,281" *.md
③번이 결정적이었습니다. 값을 하나씩 역추적하니 출처가 드러났습니다.
3-2. 시계열로 정렬했습니다
누적 건수는 단조 증가해야 합니다. 자료를 등재만 하고 지우지 않았으니까요. 그러니 시간순으로 늘어놓고 어긋나는 지점을 찾으면 사고 지점이 나옵니다.
bash
# 문서별 최종 수정일과 누적 표기를 함께 뽑는다
for f in *.md; do
  d=$(grep -oE "20[0-9]{2}-[0-9]{2}-[0-9]{2}" "$f" | sort | tail -1)
  n=$(grep -oE "누적[^0-9]{0,20}~?[0-9],[0-9]{3}건" "$f" | tail -1)
  [ -n "$n" ] && echo "$d | $f | $n"
done | sort
3-3. AI에게 준 추적 프롬프트
프로젝트 문서 전체에서 gwanbeop_ppt 누적 건수 표기를 전수 수집하고,
불일치의 원인을 추적해 주십시오.

[수집 규칙]
1. 값을 기억으로 재구성하지 마십시오. 반드시 파일을 grep 하십시오.
2. 각 값마다 [파일명 : 줄번호 : 원문] 을 함께 적으십시오.
3. 문서의 최종 수정일을 함께 뽑아 시계열로 정렬하십시오.

[판별 규칙]
4. 다음 넷을 구분하십시오. 처방이 각각 다릅니다.
   (a) 스냅샷  — 특정 시점의 정확한 값
   (b) 추정치  — '~' 나 '예상' 이 붙은 값
   (c) 파생치  — 다른 값에서 계산해 낸 값
   (d) 오독치  — 다른 항목의 숫자를 잘못 옮긴 값
5. ★ (d) 를 의심하십시오.
   특히 slide_number · id · 페이지 번호처럼 '건수가 아닌 숫자' 가
   건수 자리에 들어갔는지 확인하십시오.
   같은 문서 안에 그 숫자가 다른 의미로 등장하는지 보면 됩니다.

[금지]
6. 어느 값이 맞는지 고르지 마십시오.
   서버 SELECT COUNT(*) 없이 확정하면 다섯 번째 불일치를 만드는 것입니다.
7. 추정을 사실처럼 쓰지 마십시오.
   근거가 정황뿐이면 '추정' 이라고 명시하십시오.
5번이 이번 추적의 핵심입니다. 불일치를 볼 때 보통 "누가 덜 더했나"를 찾는데, 아예 다른 항목의 숫자가 섞여 들어왔을 가능성을 먼저 봐야 했습니다.
6번을 넣은 이유도 중요합니다. 네 값 중 하나를 고르고 싶은 유혹이 큽니다. 그런데 실측 없이 고르면 그건 다섯 번째 값이 될 뿐입니다.
3-4. 수집 결과 — 문서에 적힌 값들
값 | 출처 문서 | 성격 | 비고 |
|---|---|---|---|
1,593 | 4관법 비교 소감 | 스냅샷 | ①탈XX 계통만의 건수. 전체 아님 |
1,762 | 상리철학 상 로드맵 | 파생 |
|
~1,912 | 운의해석 로드맵 | 추정 |
|
~2,040 | 춘하추동 春 로드맵 | 추정 |
|
~2,252 | 춘하추동 冬 로드맵 | 추정 |
|
2,387 | 로드맵 통합 v2.5 | 스냅샷 | 2026-05-14 시점 |
~2,450 | 제트엔진 上 로드맵 | 추정 |
|
~2,700 | 제트엔진 下 로드맵 | 추정 |
|
1,682 | 제트엔진 下 로드맵 | 파생 | 표에 나열된 시리즈 합계. 전체와 별개라고 각주에 명시 |
3,281 | 옴니버스 소감 v3.0 | 미상 | 2026-05-29. 근거 미기재 |
9,733+ | 메모리 / 헤르메스 체크리스트 | 오독 의심 | 3-5 참조 |
같은 문서 안에 2,700(전체 추정)과 1,682(표 내 합계)가 나란히 있는 경우도 있었습니다. 각주로 구분해두긴 했지만, 표만 보는 사람은 헷갈립니다.
3-5. ★ 9,733의 정체 추적
가장 큰 값이자 가장 이상한 값입니다. 2,700에서 9,733으로 뛰려면 7,000건이 한 번에 들어와야 하는데, 그런 등재 기록이 없습니다.
역추적했더니 같은 문서 같은 절 안에 이렇게 나란히 있었습니다.
정진반_지식관리_수정대상_체크리스트_v1_0.md

  line 6  : source `박청화_정진반_下` slide 9636~9733 신규
  line 64 :   - 메모리 기준: **9,733건+**
  line 95 : | slide 범위 | 9636~9733 |
그리고 정진반 下편의 실제 등재 건수는 98건입니다.
9636 ~ 9733 → 9733 - 9636 + 1 = 989733은 98건짜리 구간의 마지막 슬라이드 번호입니다.
정리하면 이렇습니다.
실제 의미 | 잘못 읽힌 의미 | |
|---|---|---|
9733 |
|
|
⚠️ 다만 이것은 정황 근거에 의한 추정입니다. ① 같은 문서 같은 절에 두 값이 나란히 있고, ② 다른 경로로 9,733에 도달할 등재 기록이 없다는 두 가지가 근거입니다. 서버 실측 전까지는 확정하지 않습니다. 3-3 프롬프트의 7번 조항을 저 자신에게도 적용합니다.
3-6. 왜 자라는가 — 네 가지 경로
수집한 값들을 성격별로 나누니 각각 다른 병이었습니다.
경로 | 무슨 일이 일어나나 | 처방 |
|---|---|---|
① 스냅샷 방치 | 과거 시점 값이 최신값처럼 인용된다 | 날짜 병기 + 동결 선언 |
② 추정치 승격 |
| 추정 기호 보존 규칙 |
③ 파생치 혼동 | 부분 합계(1,682)가 전체로 읽힌다 | 표 제목에 범위 명시 |
④ 단위 오독 | slide 번호(9733)가 건수로 읽힌다 | 숫자에 단위 병기 |
②가 가장 흔합니다. 원문은 ~2,700건인데, 다음 문서에서 2,700건이 되고, 그다음엔 2,700건 달성이 됩니다. 물결표 하나가 사라지면서 추정이 사실이 됩니다.
④가 가장 위험합니다. 다른 항목의 숫자가 들어오면 자릿수 자체가 달라져서 오차가 아니라 완전히 다른 값이 됩니다.
3-7. 실측 SQL — 한 번에 다 뜨도록
서버 접속 횟수를 줄이려고 종합 쿼리 하나로 묶었습니다.
sql
-- ① 접속 확인 ★ dummy 면 즉시 중단
SELECT current_database(), now() AT TIME ZONE 'Asia/Seoul' AS kst;

-- ② 전체 누적 (이 값이 진실의 원천)
SELECT COUNT(*) AS grand_total FROM gwanbeop_ppt;

-- ③ source 별 분포 + 각 source 의 slide 범위
SELECT source,
       COUNT(*)            AS cnt,
       MIN(slide_number)   AS slide_min,
       MAX(slide_number)   AS slide_max,
       MAX(slide_number) - MIN(slide_number) + 1 AS slide_span,
       COUNT(*) = MAX(slide_number) - MIN(slide_number) + 1 AS is_contiguous
  FROM gwanbeop_ppt
 GROUP BY source
 ORDER BY cnt DESC;

-- ④ ★ source 합계와 전체가 일치하는가 (일치해야 정상)
SELECT (SELECT COUNT(*) FROM gwanbeop_ppt) AS grand_total,
       (SELECT SUM(c) FROM (SELECT COUNT(*) c FROM gwanbeop_ppt
                             GROUP BY source) s) AS sum_by_source;

-- ⑤ slide_number 중복 — 시리즈 간 범위 충돌 탐지
SELECT slide_number, COUNT(*) AS dup, string_agg(DISTINCT source, ' / ')
  FROM gwanbeop_ppt
 GROUP BY slide_number HAVING COUNT(*) > 1
 ORDER BY dup DESC LIMIT 20;

-- ⑥ ★ slide 최대값과 전체 건수의 격차 — 오독 원인 확인용
SELECT COUNT(*)          AS total_rows,
       MAX(slide_number) AS max_slide,
       MAX(slide_number) - COUNT(*) AS gap
  FROM gwanbeop_ppt;
⑥번이 이 글의 목적입니다. max_slide가 total_rows보다 훨씬 크다면, 슬라이드 번호를 건수로 오독할 조건이 실재했다는 증거가 됩니다.
③번의 is_contiguous 도 유용합니다. 건수와 slide 구간 폭이 다르면 결번이 있다는 뜻인데, 그 자체가 또 다른 불일치의 씨앗입니다.
3-8. 재발 방지 — 표기 규약
숫자를 적는 규칙을 정했습니다.
[수치 표기 4원칙]

1. 단위를 반드시 붙인다
   ✕ 9,733            → 무엇의 9,733인지 알 수 없다
   ○ 9,733 (slide_number 상한)
   ○ 2,387 건 (gwanbeop_ppt 행 수)

2. 성격을 표시한다
   ○ 2,387 건  [실측 2026-05-14]
   ○ ~2,700 건 [추정 · 미실측]
   ○ 1,682 건  [부분합계 · 표 내 시리즈 한정]

3. 실측값에는 쿼리를 함께 남긴다
   ○ 2,387 건  [SELECT COUNT(*) FROM gwanbeop_ppt · 2026-05-14]

4. 과거 스냅샷은 갱신하지 않고 동결한다
   ○ "본 표는 2026-05-14 시점 스냅샷. 최신 누적은 별도 관리"
4번이 중요합니다. 과거 문서의 숫자를 최신값으로 덮어쓰면 그 시점의 기록이 사라집니다. 스냅샷은 스냅샷으로 두고, 시점을 명시하는 게 맞습니다.
결과와 배운 점
4-1. ⚠️ 진행 상태 — 서버 실측 전입니다
항목 | 상태 |
|---|---|
문서 전수 수집 (11개 값) | ✅ 완료 |
성격 4분류 | ✅ 완료 |
9,733 출처 추적 | ✅ 정황 확인 (확정 아님) |
실측 SQL 세트 작성 | ✅ 완료 |
서버 | 📋 대기 |
전 문서 일괄 동기화 | 📋 대기 |
이 글은 "숫자를 바로잡았습니다"가 아니라 "왜 갈렸는지 추적했습니다"입니다. 실측값은 확인 후 별도 공유하겠습니다.
그리고 어느 값이 맞는지 여기서 고르지 않겠습니다. 3-3 프롬프트 6번 조항 그대로입니다. 실측 없이 고르면 다섯 번째 값이 됩니다.
4-2. 배운 것 ① — 숫자는 문서를 옮겨 다니며 자랍니다
~1,912 → ~2,040 → ~2,252 → 2,387 → ~2,450 → ~2,700.
여기까지는 자연스러운 증가입니다. 자료를 등재했으니까요. 문제는 각 단계에서 물결표가 붙었다 떨어졌다 하고, 어떤 값은 실측이고 어떤 값은 추정인데 표에서는 구분이 안 된다는 점입니다.
여러 문서에 적힌 숫자는 검증된 숫자처럼 보입니다. 실제로는 한 번 잰 값을 복사한 것뿐인데요.
이건 유사도 0.5395에서 겪은 것과 똑같은 구조입니다. 그 숫자도 한 번 측정한 값이 보고서·로드맵·학습 문서로 퍼지면서 상수처럼 굳었습니다.
4-3. 배운 것 ② — 단위 없는 숫자는 언젠가 다른 것으로 읽힙니다
9,733 건입니다.
9733이라고만 적혀 있으면, 그게 행 수인지 슬라이드 번호인지 ID인지 페이지인지 문맥에서만 알 수 있습니다. 그리고 문맥은 옮겨 적힐 때 함께 안 옮겨집니다.
특히 위험한 조합이 있습니다.
조건 | 왜 위험한가 |
|---|---|
slide_number를 1부터 안 쓰고 시리즈별 대역으로 할당 | 번호가 건수보다 훨씬 커진다 |
같은 문서에 두 숫자가 나란히 등장 | 옮겨 적을 때 뒤바뀐다 |
둘 다 네 자리 | 자릿수로 이상을 감지할 수 없다 |
제 시스템은 세 조건을 전부 충족하고 있었습니다. 시리즈별로 6001~, 7001~, 9636~ 식으로 대역을 나눠 쓰고 있어서, 번호와 건수가 4배 가까이 벌어져 있습니다.
4-4. 배운 것 ③ — 원칙을 세운 대상에만 적용하고 있었습니다
「문서 ≠ 사실」 원칙을 만든 게 저입니다. 그런데 이 원칙을 서버 작업할 때만 적용하고 있었습니다. DB에 쿼리를 날리기 전에는 문서 숫자를 안 믿었는데, 문서를 쓸 때는 다른 문서의 숫자를 그대로 가져다 썼습니다.
원칙이 적용되는 자리와 적용되지 않는 자리가 갈려 있었던 겁니다.
이번이 같은 종류의 세 번째입니다.
회차 | 사건 | 공통 구조 |
|---|---|---|
1 |
| 이름과 실제 동작의 불일치 |
2 | 「금기어 위반 0건」 — 걸릴 자료가 없었을 뿐 | 숫자의 의미를 다시 묻지 않음 |
3 | 「9,733건」 — 슬라이드 번호였음 | 숫자의 단위를 다시 묻지 않음 |
세 번 반복됐으면 개인의 부주의가 아니라 작업 방식의 구멍입니다.
4-5. 꿀팁 — 문서에 숫자를 적으시는 분께
① 숫자 옆에 단위를 붙이십시오
9,733이 아니라 9,733건(행 수) 또는 9733(slide_number). 두 글자가 4배 오차를 막습니다.
② 추정치의 물결표를 지키십시오
~2,700을 인용할 때 ~를 떼지 마십시오. 뗀 사람은 편해지고 다음 사람이 사실로 믿습니다.
③ 실측값에는 쿼리와 날짜를 함께 적으십시오
2,387건 [SELECT COUNT(*) · 2026-05-14]. 이렇게 적어두면 재검증이 30초입니다.
④ 부분 합계에는 반드시 범위를 명시하십시오
합계 1,682건이 아니라 표 내 시리즈 합계 1,682건 (전체 누적과 별개). 저는 각주로 적어뒀는데, 표만 보는 사람에게는 각주가 안 보입니다. 표 안에 넣으십시오.
⑤ 불일치를 발견하면 값을 고르지 말고 출처를 추적하십시오
가장 그럴듯한 값을 고르고 싶은 유혹이 큽니다. 그런데 왜 갈렸는지 모르면 같은 일이 또 생깁니다. 9,733의 정체를 찾은 게 값 하나 고치는 것보다 훨씬 값진 결과였습니다.
⑥ 과거 스냅샷은 덮어쓰지 말고 동결하십시오
시점을 적어 보존하는 게 맞습니다. 갱신하면 그 시점의 기록이 사라지고, 나중에 언제 무엇이 늘었는지 추적할 수 없게 됩니다.
⑦ MAX(id)와 COUNT(*)의 격차를 한 번 재보십시오
이 둘이 크게 벌어져 있으면 오독 조건이 갖춰진 시스템입니다. 3-7의 ⑥번 쿼리 한 줄이면 확인됩니다.
4-6. 시행착오
① 처음엔 "누가 덜 더했나"만 찾았습니다
불일치를 보면 반사적으로 계산 오류를 의심합니다. 등재 이력을 하나씩 더해가며 어디서 빠졌는지 찾았는데, 2,700에서 9,733으로 가는 경로가 도무지 안 나왔습니다. 계산이 아니라 다른 항목의 숫자일 가능성을 떠올리는 데 시간이 걸렸습니다.
② 기억으로 목록을 만들려 했습니다
"제트엔진 로드맵에 2,700, 옴니버스 소감에 3,000쯤…" 이렇게 재구성하다가 멈췄습니다. 불일치를 조사하면서 기억에 의존하면 다섯 번째 불일치를 만드는 것입니다. grep으로 다시 시작했습니다.
③ 가장 큰 값을 채택할 뻔했습니다
"자료를 계속 넣었으니 제일 큰 9,733이 최신이겠지"라고 생각했습니다. 가장 큰 값이 가장 최신값이라는 보장이 없습니다. 오히려 그 값이 오독이었습니다.
④ 3,281의 출처를 아직 못 찾았습니다
2026-05-29 옴니버스 소감 문서에 세 번 등장하는데, 근거가 적혀 있지 않습니다. 2,700과 9,733 사이 값이라 어느 쪽 계열인지도 불분명합니다. 미해결로 남깁니다.
4-7. 도움이 필요한 부분
① 문서-DB 수치 동기화 방법 — 지금은 사람이 문서를 고칩니다. 문서 40여 건에 흩어진 숫자를 매번 손으로 맞추는 건 지속 가능하지 않습니다. 문서에 {{gwanbeop_ppt_count}} 같은 자리표시자를 두고 빌드 때 채우는 방식을 검토 중인데, 마크다운 기반 지식베이스에서 이런 걸 하시는 분의 사례를 듣고 싶습니다.
② 스냅샷 보존과 최신값 제공의 양립 — 과거 문서를 동결하면 정확한데, 그 문서를 읽는 사람은 옛날 숫자를 봅니다. "이 값은 옛날 값이고 최신은 여기"를 어떻게 표시하는 게 좋을지 조언 구합니다.
③ AI에게 숫자를 인용시킬 때의 안전장치 — AI가 문서를 읽고 답할 때, 문서의 숫자를 그대로 옮깁니다. "이 숫자가 실측인지 추정인지 확인하고 인용하라" 를 프롬프트로 강제해봤는데 완전하지 않습니다. 더 나은 방법이 있을지 궁금합니다.
5. 앞으로의 계획
5-1. 즉시 — 서버 실측
3-7의 종합 쿼리를 한 번에 실행합니다. 기록할 값은 넷입니다.
# | 값 | 용도 |
|---|---|---|
1 |
| 진실의 원천. 이후 모든 문서가 이 값을 참조 |
2 | source별 분포 | 어느 시리즈가 몇 건인지 확정 |
3 |
| 9,733 오독 가설 검증 |
4 | slide 중복 건수 | 범위 충돌 여부 |
3번이 이 글의 결말이 됩니다. 격차가 크면 오독 가설이 지지되고, 격차가 작으면 다른 경로를 다시 찾아야 합니다.
5-2. 실측 후 — 전 문서 동기화
원칙을 이렇게 잡았습니다.
문서 유형 | 처리 |
|---|---|
현재 상태 문서 (로드맵, 통합 가이드) | 실측값으로 갱신 + |
과거 스냅샷 (시점별 로드맵 업데이트) | 갱신하지 않음. 시점 명시 주석만 추가 |
소감·분석 문서 | 근거 없는 값은 삭제하거나 |
메모리 | 실측값으로 교체. 단위 병기 필수 |
과거 문서를 안 고치는 게 핵심입니다. 그 시점에 그렇게 알고 있었다는 것도 기록입니다.
5-3. 자동화 — 사람이 세지 않게
수동 동기화는 다음 불일치를 예약하는 일입니다. 사이드카 원칙에 따라 별도 스키마에 관측 뷰를 하나 두려 합니다.
sql
CREATE OR REPLACE VIEW hermes.v_corpus_snapshot AS
SELECT now() AT TIME ZONE 'Asia/Seoul' AS measured_at,
       COUNT(*)                        AS total_rows,
       COUNT(DISTINCT source)          AS source_cnt,
       MAX(slide_number)               AS max_slide,
       MAX(slide_number) - COUNT(*)    AS slide_gap   -- ★ 오독 위험 지표
FROM gwanbeop_ppt;slide_gap을 상시 노출하는 게 의도입니다. 오독의 조건이 얼마나 벌어져 있는지 계속 보이게 해두면, 다음에 누군가 슬라이드 번호를 건수로 읽을 확률이 줄어듭니다.
5-4. 반성문 등재
이번 건을 반성문으로 남깁니다. 신설할 패턴은 이것입니다.
패턴 — "숫자의 단위를 확인하지 않고 인용"
재발 방지: ① 문서에 숫자를 적을 때 단위 병기 ② 인용 시 원문 성격(실측/추정/부분합계) 확인 ③
MAX(id)와COUNT(*)가 크게 벌어진 테이블은 표기에 특히 주의
다만 반성문 총괄표 자체에 패턴 번호 충돌과 결번이 이미 있어서(앞선 사례글에서 발견), 그 정리가 선행되어야 합니다. 기록 체계를 고치는 일이 밀리면 기록이 또 틀립니다.
5-5. UNESCO 신청서 대응
등재 서류에 들어갈 숫자는 실측값 + 측정일 + 쿼리를 세트로 첨부할 예정입니다. 심사에서 요구하는 건 큰 숫자가 아니라 그 숫자를 재현할 수 있는가이기 때문입니다.
이번 일로 오히려 근거가 하나 생겼다고 봅니다. 불일치를 발견하고 추적해 공개한 기록 자체가 자료 관리 체계의 작동을 보여주는 증거입니다.
도움 받은 글 (옵션)
지피터스 23기 에이전트 하네스 과정 — "검증 영수증" 개념. 숫자에 측정일과 쿼리를 붙이는 3-8의 표기 규약이 여기서 나왔습니다. "문서에 적혀 있다"와 "확인했다"를 구분하라는 지적이 이 글 전체의 출발점입니다.
단일 진실 공급원(Single Source of Truth) — 같은 사실을 여러 곳에 복사해두면 반드시 갈린다는 원칙. 알고 있었는데 코드에만 적용하고 문서에는 적용하지 않고 있었습니다.
PostgreSQL
information_schema· 집계 쿼리 — 3-7의is_contiguous판정과 중복 탐지 쿼리.앞선 사례글 「유사도 0.5395, 넉 달째 목표 미달」 — 한 번 잰 값이 여러 문서로 퍼지며 상수처럼 굳는 현상. 완전히 같은 병입니다. 그쪽은 지표, 이쪽은 건수라는 차이만 있습니다.
앞선 사례글 「AI 협업 반성문 34건」 — 「문서 ≠ 사실」 원칙의 출처. 그 글에서도 총괄표 자신의 오류 3건을 발견했는데, 기록하는 문서가 기록을 틀리는 패턴이 여기서 또 반복됐습니다.
로그인하고 댓글을 남겨 주세요

이 글은 네 숫자 중 정답을 고르는 글이 아니라, 숫자가 어떤 자격으로 문서에 들어오는지를 다시 설계한 글이었어요. 스냅샷·추정·파생·오독을 분리하고 서버 실측 전에는 9,733 가설조차 확정하지 않은 덕분에 값보다 provenance가 중심에 남았습니다.
문서-DB 동기화는 40개 파일의 숫자를 직접 치환하기보다, 최신 상태 문서만 `metric_id`를 참조하고 빌드가 측정 아티팩트를 렌더링하게 하는 편이 안전합니다. 측정 아티팩트는 value, unit, measured_at, query_hash, status를 한 레코드로 묶고, 과거 스냅샷 문서는 그 시점의 리터럴 값을 그대로 둬야 합니다. 이렇게 하면 빌드 실패가 역사 기록을 다시 쓰는 사고로 번지지 않습니다.
옛 문서에는 숫자 옆에 `스냅샷: 2026-05-14`와 `최신값 보기` 링크만 추가하고, 최신값은 별도 current metrics 페이지 한 곳에서 제공하는 구조가 두 요구를 함께 만족시킵니다. 독자는 당시 판단과 현재 상태를 구분하고, 시스템은 옛 문서를 일괄 갱신하지 않아도 됩니다.
AI 인용은 프롬프트보다 도구 계약으로 닫는 편이 낫습니다. 숫자를 직접 검색해 복사하지 못하게 하고, `metric_id` 조회가 value·unit·status·measured_at·evidence를 모두 반환할 때만 문장을 만들게 하며 status가 NOT_VERIFIED면 숫자 대신 미확인으로 답하게 하는 방식입니다. 가장 작은 성공 신호는 같은 질문에서 실측 레코드는 단위와 날짜까지 인용되고, 추정 레코드는 물결표와 상태가 보존되며, 근거 없는 3,281은 인용이 차단되는 것입니다.
가장 큰 숫자를 고르는 유혹을 버리고 불일치 자체를 조사 대상으로 남긴 태도가 훌륭했습니다. 확정 전에는 확정하지 않는 절제가 숫자보다 오래가는 재현 기준을 세웠어요.
이 글은 네 숫자 중 정답을 고르는 글이 아니라, 숫자가 어떤 자격으로 문서에 들어오는지를 다시 설계한 글이었어요. 스냅샷·추정·파생·오독을 분리하고 서버 실측 전에는 9,733 가설조차 확정하지 않은 덕분에 값보다 provenance가 중심에 남았습니다.
문서-DB 동기화는 40개 파일의 숫자를 직접 치환하기보다, 최신 상태 문서만 metric_id를 참조하고 빌드가 측정 아티팩트를 렌더링하게 하는 편이 안전합니다. 측정 아티팩트는 value, unit, measured_at, query_hash, status를 한 레코드로 묶고, 과거 스냅샷 문서는 그 시점의 리터럴 값을 그대로 둬야 합니다. 이렇게 하면 빌드 실패가 역사 기록을 다시 쓰는 사고로 번지지 않습니다.
옛 문서에는 숫자 옆에 스냅샷: 2026-05-14와 최신값 보기 링크만 추가하고, 최신값은 별도 current metrics 페이지 한 곳에서 제공하는 구조가 두 요구를 함께 만족시킵니다. 독자는 당시 판단과 현재 상태를 구분하고, 시스템은 옛 문서를 일괄 갱신하지 않아도 됩니다.
AI 인용은 프롬프트보다 도구 계약으로 닫는 편이 낫습니다. 숫자를 직접 검색해 복사하지 못하게 하고, metric_id 조회가 value·unit·status·measured_at·evidence를 모두 반환할 때만 문장을 만들게 하며 status가 NOT_VERIFIED면 숫자 대신 미확인으로 답하게 하는 방식입니다. 가장 작은 성공 신호는 같은 질문에서 실측 레코드는 단위와 날짜까지 인용되고, 추정 레코드는 물결표와 상태가 보존되며, 근거 없는 3,281은 인용이 차단되는 것입니다.
가장 큰 숫자를 고르는 유혹을 버리고 불일치 자체를 조사 대상으로 남긴 태도가 훌륭했습니다. 확정 전에는 확정하지 않는 절제가 숫자보다 오래가는 재현 기준을 세웠어요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



「문서 ≠ 사실」 원칙을 이미 갖고 있었는데, 정작 문서들끼리 서로 다른 숫자를 말하고 있었다는 설정이 인상적이에요. 원칙이 있어도 그 원칙이 닿지 못하는 맹점이 생기는군요.
9,733 추적 과정이 특히 흥미로웠어요. slide_number 상한값(9636~9733)이 건수로 오독된 경로를 재구성하신 부분 — 같은 문서 같은 절에 두 값이 나란히 있다는 게 정황 근거라는 점도 솔직하게 명시하셨고요. "서버 실측 전까지는 확정하지 않는다"는 원칙을 글 쓰는 본인에게도 적용하신 게 좋았습니다.
4가지 오염 경로(스냅샷 방치·추정치 승격·파생치 혼동·단위 오독) 중 ②가 가장 흔하다는 설명이 실감 나요. ~2,700건 → 2,700건 → 2,700건 달성으로 물결표 하나가 사라지면서 추정이 사실이 되는 과정, 저도 비슷한 걸 종종 봅니다.
source별 분포·slide 범위·연속성 체크를 한 번에 뽑도록 설계한 종합 SQL도 실용적이었어요. 고롱고롱… 이런 추적 기록 좋아해요 🐈⬛