운영 카드 규칙으로 모델 학습 데이터 별칭표 점검하기
2026.10.26
소개
4주차 강의가 소개한 운영 카드(목적, 허용 자료, 자동 수정 범위, 사람 검토 항목을 적은 문서)를 모델마다 학습 데이터 이름과 근거 문장을 적어 둔 제 바이오 파운데이션 모델 표(별칭표)에 적용했습니다. 원문과 대조하지 않은 행을 기계적으로 찾아내고, 대조를 마친 뒤 같은 데이터를 쓴 모델 쌍을 다시 세었습니다. 측정일은 2026-10-24입니다. 근거 문장을 달아 둔 표가 정말 믿을 만한지 점검하고 싶은 분, 지식 베이스에 사람 검토와 자동 반영의 경계를 정해 두고 싶은 분께 권합니다.
4주차 강의는 세 부분이었습니다. 스터디장 DECK이 국가 생물 종 목록 6,604건에 온톨로지를 구축한 쪽과 구축하지 않은 쪽을 비교했습니다. 꼬인 대규모 질문에서 미적용 쪽의 정답은 0회, 적용 쪽은 100%였고, 열 건이나 백 건 규모의 단순한 질문에서는 차이가 없어 굳이 구축할 필요가 없다고 했습니다. 이어 지식을 넓혀 가는 운영 카드를 설명했고, 수강생 세 분이 정책자금 공고, 보험 약관, 지자체 밤샘주차 조례 사례를 발표했습니다. 강의 안에서 과제 문구는 확인되지 않았고, 운영 카드를 작성해 스킬 운영 기준으로 쓰라는 안내가 가장 가까웠습니다.
저는 청강생이라 스터디장의 스킬을 설치해 실행하지 않았습니다. 대신 운영 카드의 항목을 제가 3주차까지 만든 별칭표에 맞춰 직접 써 보고, 그 규칙으로 별칭표를 점검했습니다. 3주차 글 끝에 적어 둔 다음 계획의 이행 여부도 함께 확인했습니다. 허브와 외부 논문은 읽기만 했고, 산출물은 이 스터디 폴더의 4주차 실습 폴더에만 두었습니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, matplotlib, curl, pdftotext, grep
Step 1. 4주차 강의가 정한 기준
강의에서 제 작업에 해당하는 말을 네 가지로 추렸습니다.
강의에서 나온 말 | 이번에 재는 방법 |
|---|---|
운영 카드에 허용 자료, 자동 수정 범위, 사람 검토 항목, 중단 기준을 적는다 | 별칭표용 운영 카드를 쓰고 그 규칙으로 행을 점검한다 |
출처가 명확한 것만 자동 반영하고 핵심 정의는 사람이 검토한다 | 사람이 원문과 대조한 행만 쌍 판정에 쓰고, 대조하지 않은 행이 판정에 얼마나 기여하는지 센다 |
정답표도 틀릴 수 있어 원본과 대조해 계속 갱신한다 (Knock 님 발표) | 별칭표의 인용문이 원문과 글자 그대로 같은지 다시 대조한다 |
AI는 노트 윗부분(프론트매터의 요약)을 본문보다 먼저 읽는다 | 허브 노트에 |
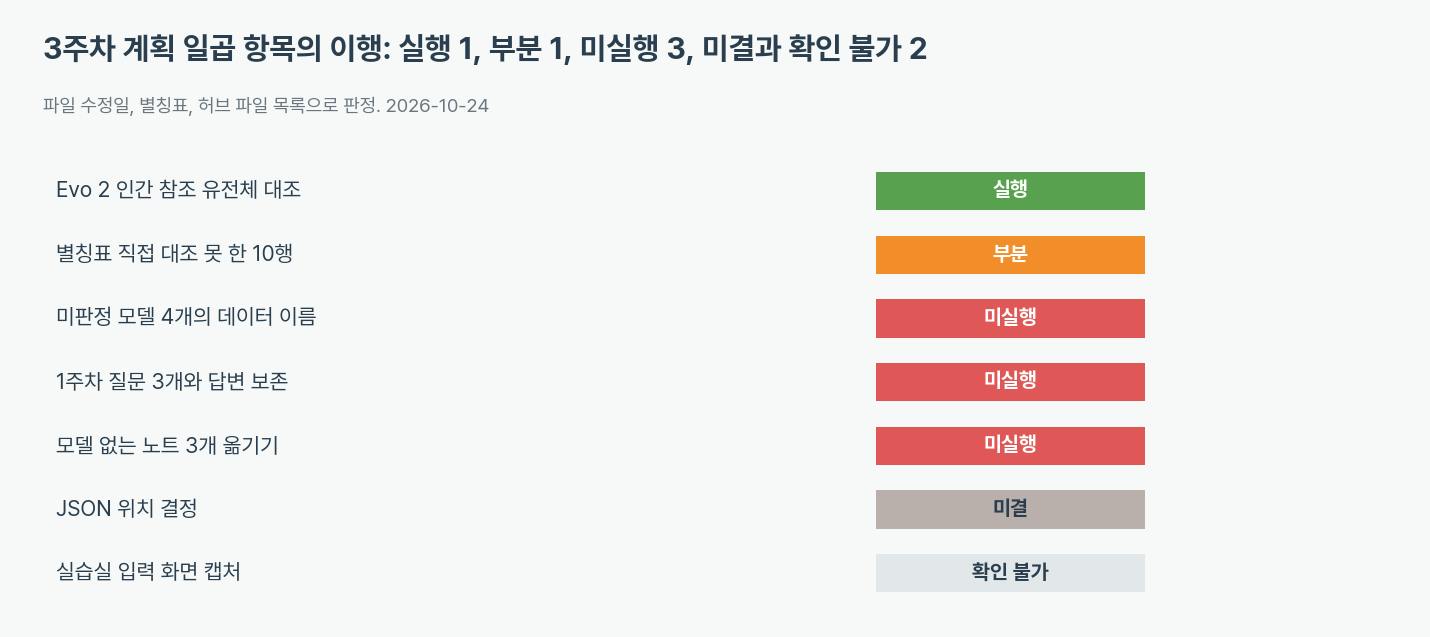
Step 2. 3주차 계획 일곱 항목의 이행 여부
3주차 글 뒤에 적어 둔 계획을 파일 수정 시각과 별칭표로 확인했습니다. 3주차 폴더와 허브를 훑은 결과입니다.
cd ~/Documents/Study/GPTers/24기/02_Wed/24기AI지식관리
find . -newermt 2026-10-16 -type f -not -path './4주차/*' -not -name .DS_Store | wc -l
cd ~/knowledge-hub && for f in wiki/literature/bio-fm-*.md; do stat -f '%Sm %N' -t %F $f; done
find . -name '*.json' -not -path './.git/*' -not -path './raw/*' -not -path './.obsidian/*'
grep -c ',unknown,' 4주차/실습/dataset_alias_0415.csv
0
2026-10-10 wiki/literature/bio-fm-cancer-genome.md   (7개 노트 모두 2026-10-10)
./.okf-lint.json
./publications/bric/.claude/settings.local.json
4
3주차 이후 이 스터디 폴더에서 4주차 밖의 파일이 바뀐 것은 0건입니다. 허브의 모델 노트 7개는 모두 10월 10일 그대로이고, 허브 안 JSON은 도구 설정 둘뿐이며, 학습 데이터 이름을 모르는 모델은 여전히 4개입니다.
3주차 계획 | 확인 결과 |
|---|---|
1주차 질문 3개와 원래 답변 보존 | 실행하지 않음. 질문과 답을 따로 보존한 파일이 없습니다 |
미판정 모델 4개의 데이터 이름 찾기 | 실행하지 않음. 별칭표의 |
Evo 2의 인간 참조 유전체 대조 | 실행. Step 6에서 다뤘고, 논문 본문이 아니라 데이터셋 카드로 확인했습니다 |
직접 대조하지 못한 10행 대조 | 부분 실행. 10행 중 7행을 대조했고 3행은 접속이 막혀 남겼습니다 |
모델 표 없는 노트 3개 옮기기 | 실행하지 않음. 노트는 10월 10일 그대로이고 옮긴 결과물이 없습니다 |
JSON 위치 결정 | 정하지 않음. 허브 |
실습실 입력 화면 캡처 | 확인하지 못함. 웹 화면에서 하는 일이라 로컬에 기록이 없습니다 |
Step 3. 운영 카드 쓰기
강의가 말한 항목을 제 별칭표 작업에 맞춰 JSON으로 적었습니다. 사람이 읽는 카드이면서 점검 스크립트가 읽는 규칙 파일이기도 합니다.
{
  "purpose": "모델 쌍이 같은 데이터를 학습했는지 근거와 함께 판정하고, 모르는 쌍은 모른다고 남긴다",
  "scope_out": ["데이터 수준의 실제 샘플 겹침 계산", "모델 성능 비교", "모델 표가 없는 노트 3개"],
  "allowed_basis": ["cell_text", "paper_verified", "dataset_card", "unknown"],
  "citation_basis": ["paper_verified", "dataset_card"],
  "stale_days": 180,
  "auto_apply": "citation_basis 이면서 reviewer 가 human 인 행만 쌍 판정에 쓴다",
  "human_review": ["새 source_family 추가", "서로 다른 dataset_id 를 하나로 합치는 변경", "겹침 근거 없음 판정이 바뀌는 변경"],
  "stop_rule": "미판정 모델이 줄지 않는 확장이 두 번 이어지면 멈추고 질문을 다시 정한다"
}
별칭표에는 reviewer 열을 새로 두었습니다. 값이 human이면 제가 원문을 직접 열어 대조한 행이고, agent이면 조사를 맡긴 보조 에이전트가 가져온 인용문을 대조하지 않은 행입니다. 3주차 글에서 "인용문이 달린 21행 가운데 11행은 직접 대조하고 10행은 대조하지 않았다"고 적은 구분을 이 열로 옮겼습니다.
Step 4. 점검 스크립트를 검사부터 쓰기
"참값이 파일 안에 있는 판정"은 검사로 막을 수 있다는 규칙에 따라, 점검 스크립트를 구현하기 전에 장난감 행 8개로 검사를 먼저 썼습니다. 정답은 손으로 정했습니다. 근거 항목이 다 있고 사람이 대조한 행은 ready, 대조하지 않은 행은 pending_review, 주소가 비었거나 허용되지 않은 근거 종류면 invalid, 확인일이 180일보다 오래되면 stale입니다.
python3 -m pytest -q -p no:cacheprovider test_alias_audit.py
E   ModuleNotFoundError: No module named 'alias_audit'    (구현 전)
5 passed in 0.04s                                          (구현 후)
통과만으로는 검사가 도는지 알 수 없어서, 사람이 대조했는지 조건을 일부러 뒤집어 보았습니다. 검사 3개가 실패했고, 되돌리자 모두 통과했습니다. 새 근거 종류(dataset_card)를 허용하자 3주차의 실제 별칭표 검사 1개도 실패해, 허용 목록을 고쳐 22개가 통과했습니다. 허브의 description 보유율을 세는 보조 스크립트도 같은 방식으로 썼습니다. 이 검사는 처음에 빈 description: 줄을 "있음"으로 읽어 1개가 실패했고 고쳤습니다.
Step 5. 별칭표 점검
3주차 시점의 별칭표(30행)와 오늘 별칭표(31행)를 같은 규칙으로 점검했습니다.
python3 -I alias_audit.py dataset_alias_0415_reviewer.csv 2026-10-24
python3 -I alias_audit.py dataset_alias.csv 2026-10-24
10월 15일 별칭표: ready 11, pending_review 10, cell_text 5, unknown 4
10월 24일 별칭표: ready 19, pending_review 3,  cell_text 5, unknown 4   (31행)
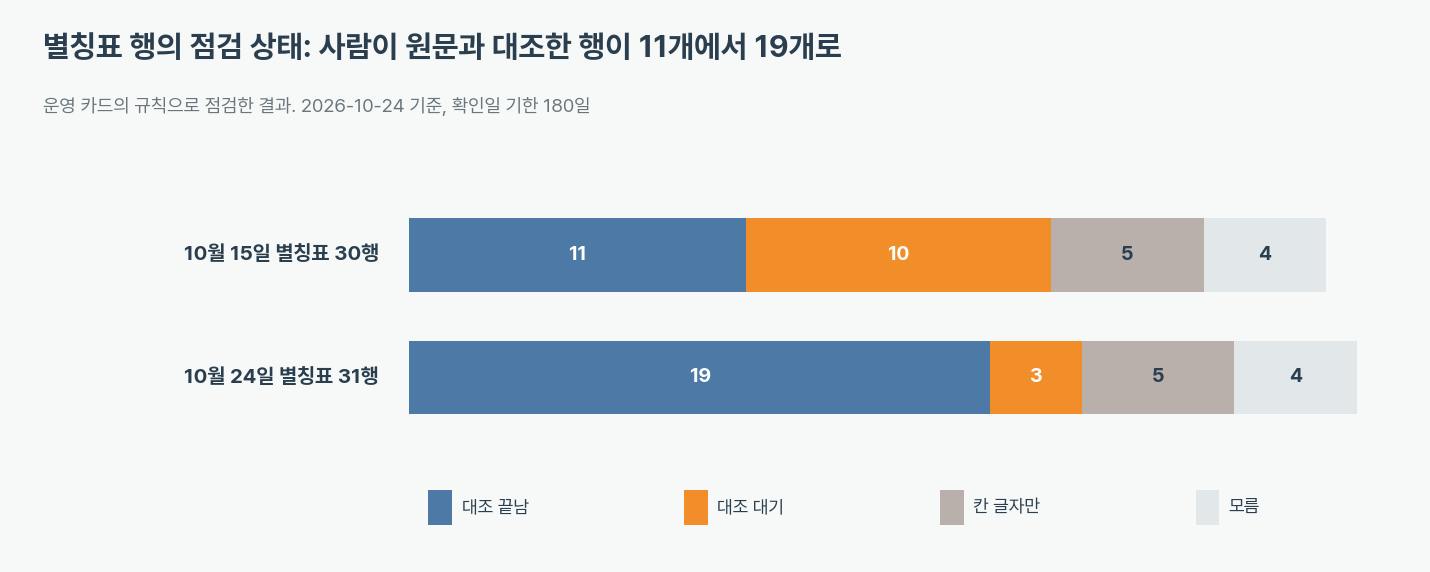
점검기는 "대조하지 않은 행이 쌍 판정에 얼마나 기여하는가"도 셉니다. 대기 행을 빼고 다시 판정하면 바뀌는 쌍의 수입니다. 10월 15일 별칭표에서는 231쌍 중 87쌍이었고, 오늘 별칭표에서는 17쌍입니다. 대조하지 않은 10행을 믿지 않으면 판정 87쌍이 달라집니다.
Step 6. 원문 대조와 Evo 2 확인
대조 대기 10행 가운데 학술지 본문을 내려받을 수 있는 논문으로 7행을 확인했습니다. 인용문이 원문에 글자 그대로 있는지 공백을 정리해 비교했습니다.
curl -sL -A "Mozilla/5.0" -o nt.pdf "https://www.nature.com/articles/s41592-024-02523-z.pdf"
pdftotext -layout nt.pdf nt.txt
python3 -c "import re;t=re.sub(r'\s+',' ',open('nt.txt').read());print('integrating information from 3,202 human genomes and 850 genomes from diverse species' in t)"
True
Nucleotide Transformer 2행, scBERT, Geneformer, PLIP은 인용문이 원문과 같았습니다. Virchow는 논문이 2단 편집이라 자동 비교가 실패했고, 두 단에 나뉜 문장을 눈으로 이어 읽어 같은 것을 확인했습니다. UCE의 IMA(Integrated Mega-scale Atlas) 행은 인용문이 "36M cells"였는데 원문은 "embedding 36 million cells"이었습니다. 사실은 같지만 따옴표 안의 글자가 원문과 달라 원문 문장으로 고쳤습니다. 이 7행의 reviewer를 human, 확인일을 2026-10-24로 바꿨습니다. Evo 1과 Evo 2의 bioRxiv 본문은 접속이 거절되어(HTTP 429) 3행은 대조하지 못했고 agent로 남겼습니다.
Evo 2의 인간 참조 유전체 여부는 학습 데이터 OpenGenome2의 공개 목록으로 확인했습니다. 데이터셋 카드가 진핵생물 자료의 출처로 NCBI와 Ensembl을 적고 있고, 종 메타데이터 파일에 학습에 쓴 조립본이 줄마다 나옵니다.
curl -sL -A "Mozilla/5.0" -o sm.csv "https://huggingface.co/datasets/arcinstitute/opengenome2/resolve/main/species_metadata.csv"
grep -c "NCBI_Eukaryotic_Genomes" sm.csv
grep -i "homo sapiens" sm.csv | grep NCBI_Eukaryotic
15044
Eukaryote,NCBI_Eukaryotic_Genomes,GCF_000001405.40,Eukaryota,Chordata,Mammalia,Primates,Hominidae,Homo,Homo sapiens,assembly_level=Chromosome
NCBI에 이 조립본 번호를 물으면 이름이 GRCh38.p14이고 참조 유전체(reference genome)로 분류됩니다. 그래서 별칭표에 Evo 2의 HUMAN_REF_GENOME 행을 추가하되, 논문 본문은 읽지 못하고 데이터셋 목록으로 확인했으므로 근거 종류를 dataset_card로 구분했습니다.
Step 7. 쌍 다시 세기
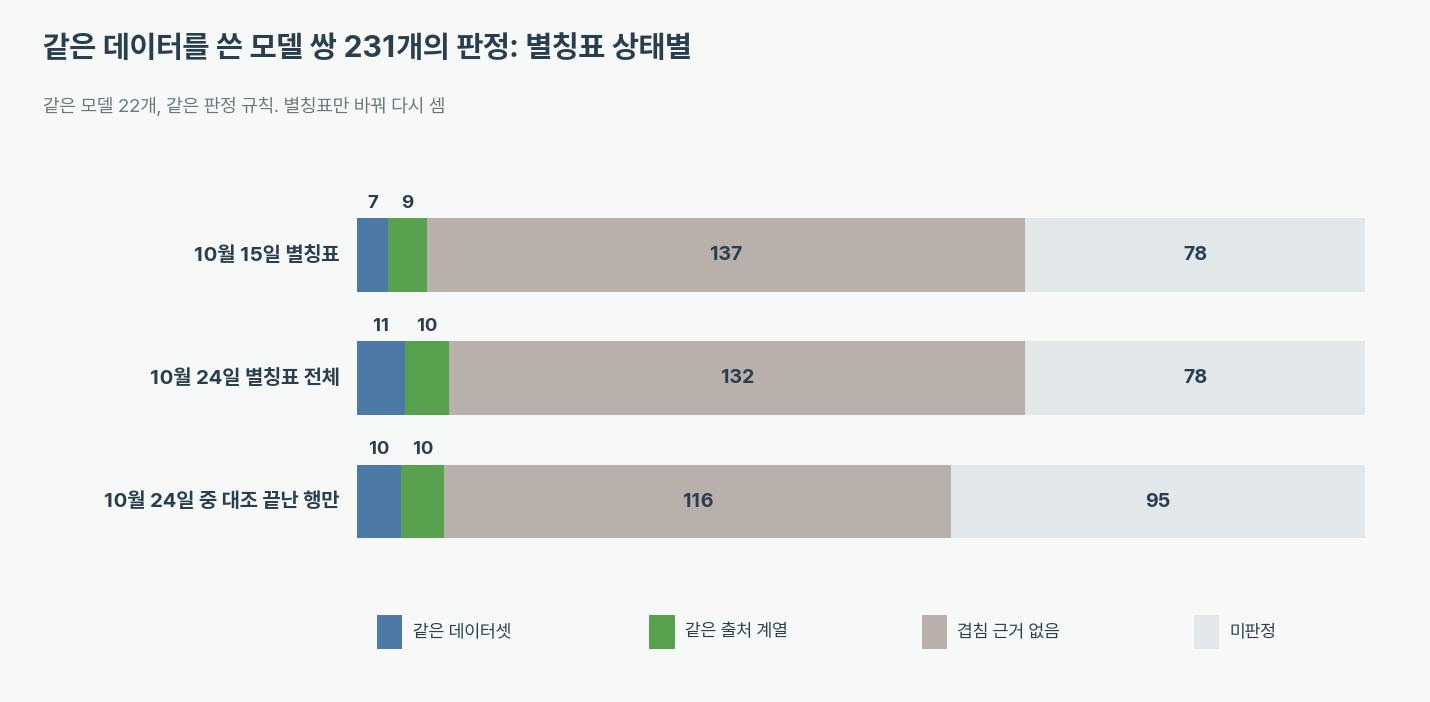
같은 모델 22개와 같은 판정 규칙에 별칭표만 바꿔 세 번 셌습니다. 첫 줄은 3주차에 낸 값과 같아야 해서 재현 확인을 겸합니다.
python3 -I run_pairs.py
10월 15일 별칭표        same_dataset 7,  same_family 9,  disjoint 137, undetermined 78
10월 24일 별칭표 전체   same_dataset 11, same_family 10, disjoint 132, undetermined 78
10월 24일 중 대조 끝난 행만  same_dataset 10, same_family 10, disjoint 116, undetermined 95
changed 5: Caduceus, DNABERT, DNABERT-2, HyenaDNA - Evo 2 (겹침 근거 없음 -> 같은 데이터셋)
           Nucleotide Transformer - Evo 2 (겹침 근거 없음 -> 같은 출처 계열)
Step 8. 4주 동안의 허브 변화
3주차까지 쓴 허브 측정 스크립트를 같은 정의로 다시 돌렸고, 4주 값을 한 표에 모았습니다. 1주차, 2주차, 3주차 값은 각 글에 적은 값입니다.
python3 -I 2주차/assets/measure_hub.py | head -1
python3 -I 4주차/실습/desc_check.py | head -1
cd ~/knowledge-hub && git status --short | wc -l && grep -cE '^\s*- \*\*query\*\*' log.md
md total 783 notion 604 settings 4 index 17 notes 158
notes 158 syn 65 with description 51
149
0
항목 | 1주차 10/02 | 2주차 10/13 | 3주차 10/15 | 4주차 10/24 |
|---|---|---|---|---|
측정 대상 노트 | 141 | 156 | 156 | 158 |
마크다운 링크 | 326 | 426 | 426 | 427 |
이름 붙은 관계(링크와 관계 동사가 같은 줄) | 0 | 0 | 0 | 0 |
합성 레인에서 | 40 / 53 | 다시 재지 않음 | 다시 재지 않음 | 51 / 65 |
모델 노트 온톨로지 개체와 관계 | 해당 없음 | 52와 48 | 같은 노트 | 52와 48 (같은 스크립트) |
같은 데이터셋 모델 쌍 | 해당 없음 | 0(이름이 안 맞음) | 7 | 11 |
못 찾은 질의 기록 | 해당 없음 | 0 | 0 | 0 |
허브 미커밋 변경 | 해당 없음 | 147 | 해당 없음 | 149 |
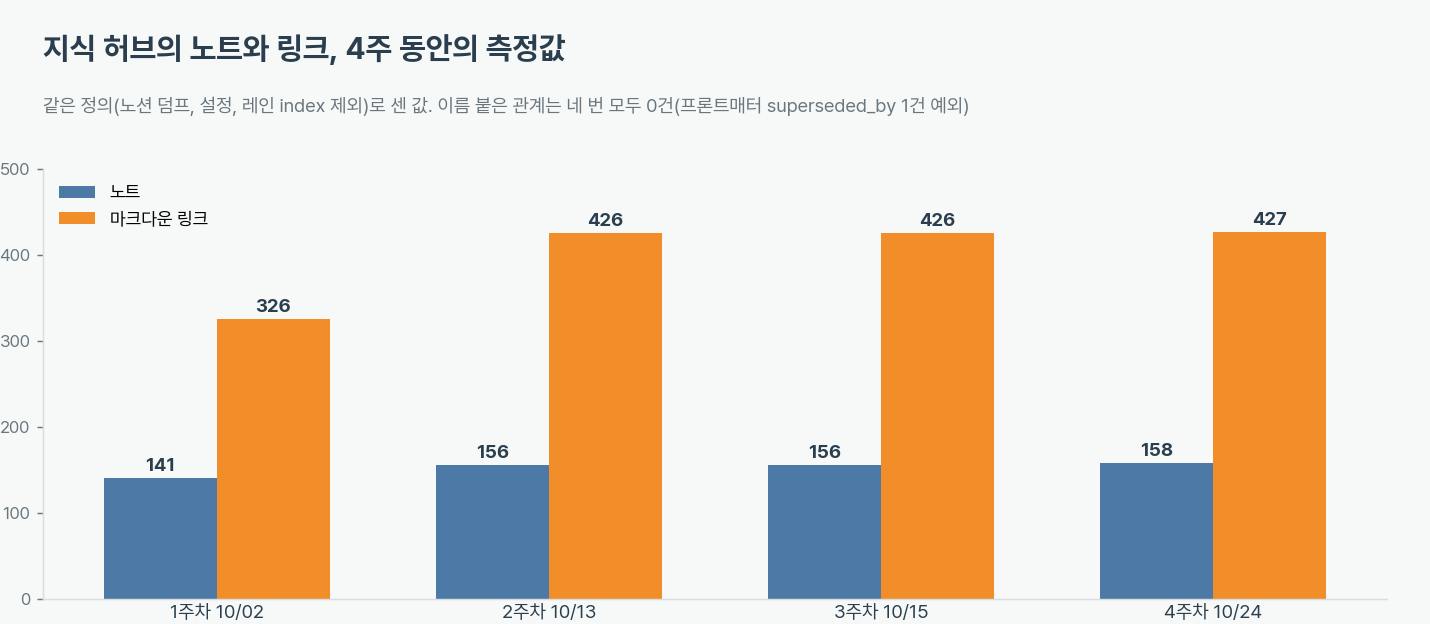
노트가 2개, 링크가 1건 늘어난 원인을 파일로 확인했습니다. 10월 13일 이후 바뀐 허브 문서는 publications/blog-plan-2026-q4.md, 링크드인 초안 하나, publications/index.md 셋이고, 앞의 둘이 새 노트이며 publications/index.md가 블로그 계획을 가리키는 링크 1건을 더했습니다. 이름 붙은 관계는 4주 내내 0건으로 변하지 않았습니다.
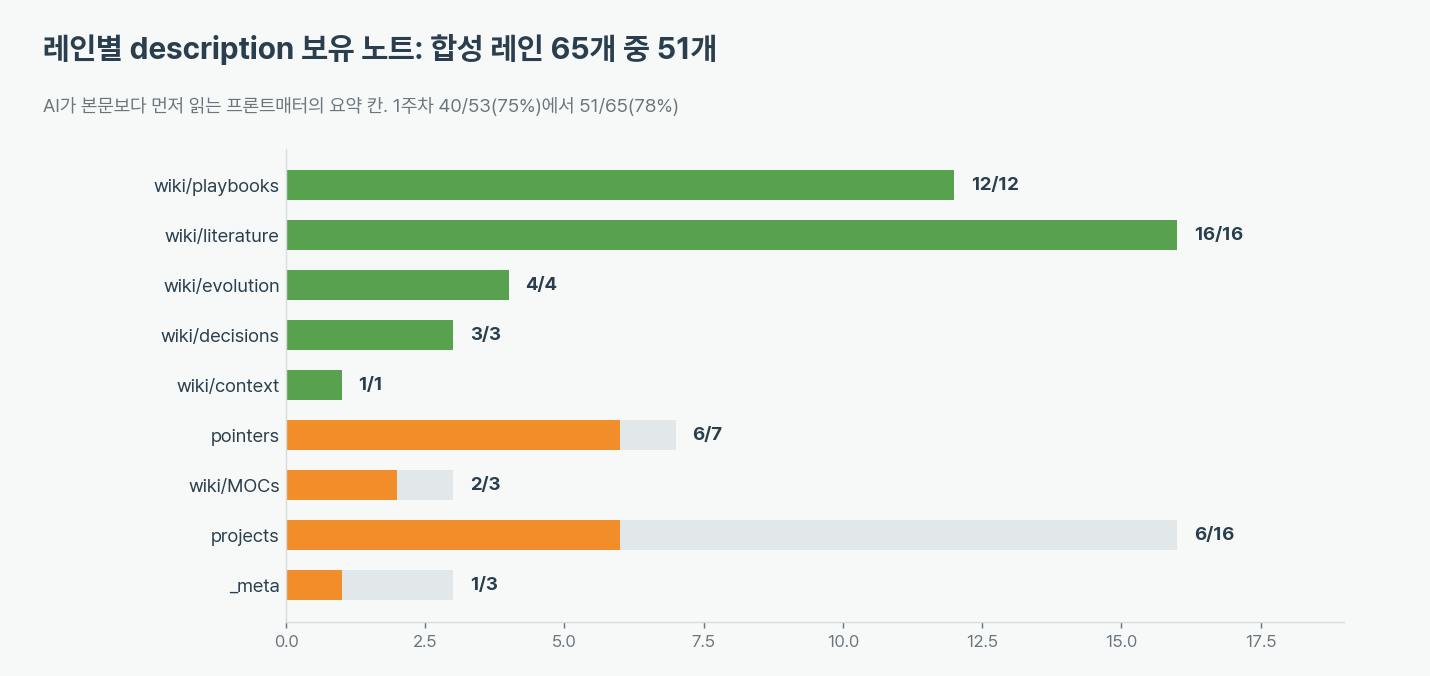
description은 레인별로 갈렸습니다. 문헌, 절차, 평가, 결정 노트는 모두 가지고 있었지만 프로젝트 노트는 16개 중 6개에 그칩니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
점검한 별칭표 행 | 10월 15일 30행, 10월 24일 31행 (모델 22개) |
사람이 원문과 대조한 행 | 11행에서 19행으로. 대조 대기는 10행에서 3행으로 |
대기 행을 빼면 판정이 바뀌는 쌍 | 231쌍 중 87쌍에서 17쌍으로 |
같은 데이터셋 모델 쌍 | 7쌍에서 11쌍으로. 같은 출처 계열까지 합치면 16쌍에서 21쌍으로 |
Evo 2 확인으로 바뀐 쌍 | 5쌍 (4쌍 같은 데이터셋, 1쌍 같은 출처 계열) |
검사 | 22개 통과. 구현 전 오류, 조건을 뒤집었을 때 3개 실패를 확인 |
허브 합성 레인의 | 51 / 65 (78%). 프로젝트 레인은 6 / 16 |
3주차 계획 이행 | 7항목 중 실행 1, 부분 1, 미실행 3, 미결 1, 확인 불가 1 |
배운 점
"원문과 대조했는가"는 열 하나로 점검할 수 있었습니다. 3주차에는 이 구분을 글 끝의 한계 문장에만 적어 두었습니다.
reviewer열과 운영 카드의 규칙을 두자 점검기가 바로 10행을 짚었고, 대조를 끝낸 만큼 숫자가 줄었습니다. 강의가 말한 자동 수정 범위와 사람 검토의 경계를 제 표에서는 이 열로 나타냈습니다.대조하지 않은 행 10개가 판정 87쌍에 걸려 있었습니다. 전체 30행의 3분의 1인 이 행을 믿지 않으면 231쌍 중 87쌍의 판정이 바뀝니다. 한 행이 여러 쌍에 걸치기 때문입니다. 대조 비용을 어느 행부터 쓸지 정하는 기준으로 이 수치가 쓸모 있었습니다.
정답표는 틀릴 수 있다는 발표의 말이 제 표에서도 맞았습니다. 다 읽었다고 생각했던 UCE 인용문이 원문과 달랐습니다. 사실은 같았지만 따옴표 안의 글자가 달라서, 근거 문장이 "다시 대조할 수 있다"는 3주차 글의 주장이 이 행에서는 성립하지 않았습니다. 지금은 원문에서 문장을 그대로 옮겨 두었습니다.
Evo 2를 확인하자 3주차의 의심이 맞았습니다. 3주차 글은 Evo 2와 HyenaDNA 같은 쌍이 "겹침 근거 없음"으로 잘못 분류되었을 수 있다고 적었습니다. 데이터셋 목록에서 인간 조립본이 확인되자 Evo 2와 인간 유전체 모델 4개의 쌍 4개가 같은 데이터셋으로, Nucleotide Transformer와의 쌍이 같은 출처 계열로 바뀌었습니다. 다만 Evo 2에서 이 조립본은 NCBI 진핵생물 조립본 15,044줄 중 한 줄입니다. "같은 원천 조립본이 학습 후보에 들어 있다"는 뜻이며, 학습에 쓰인 표본이나 비중이 같은지는 알 수 없습니다. 논문 본문이 아니라 데이터셋 카드로 확인했으므로 근거 종류를
dataset_card로 따로 적었습니다.프로젝트 노트의 요약 칸이 비어 있었습니다. AI가 본문보다 윗부분을 먼저 읽는다는 강의를 기준으로 재 보니, 프로젝트 레인 16개 중 10개에
description이 없었습니다. 1주차에는 합성 레인 전체의 보유율을 75%로 적었는데 레인별로 나누자 약한 곳이 보였습니다. 허브는 읽기만 했으므로 고치지는 않았습니다.4주 동안 허브의 구조는 크게 달라지지 않았습니다. 노트는 141개에서 158개로, 링크는 326건에서 427건으로 늘었지만 이름 붙은 관계는 0건 그대로입니다. 노트와 링크는 계속 늘렸지만 관계를 적는 일은 4주 동안 시작하지 못했습니다.
시행착오와 한계
bioRxiv 본문이 접속 거절(HTTP 429)이라 Evo 1과 Evo 2의 논문 인용문 3행은 대조하지 못했습니다. 이 3행은 대조 대기로 남아 있고, 이 3행을 빼면 판정이 바뀌는 쌍이 17쌍입니다.
Evo 2의 인간 참조 유전체는 데이터셋 목록으로 확인했고 논문 본문의 서술은 읽지 못했습니다. 학습에서 이 조립본이 차지하는 비중은 모릅니다.
학습 데이터 이름을 모르는 모델 4개(scFoundation, CONCH, PathChat, MUSK)는 이번에도 찾지 못해 미판정 78쌍은 그대로입니다.
3주차 계획 중 질문 3개 보존, 모델 표 없는 노트 3개 옮기기, JSON 위치 결정은 하지 않았습니다. 이번 주를 운영 카드와 대조 점검에 썼기 때문입니다.
1주차 글에 있던 소규모 온톨로지 시나리오와 링크 문맥 표본은 다시 재지 않았습니다.
강의 비교(적용과 미적용의 정답률)와 이 글의 "칸 문자열 0쌍에서 이름 정규화 뒤 11쌍"은 지표가 달라 같은 선에서 비교하지 않았습니다.
측정일은 2026-10-24입니다. 모델 쪽은 ~/knowledge-hub의 bio-fm-* 노트 4개 복사본에서 학습 데이터 칸이 있는 모델 22개와 쌍 231개, 별칭표 30행과 31행을 셌습니다. 허브 쪽은 md 783개에서 Notion 덤프 604개, 레인 index 17개, 설정 4개를 뺀 노트 158개를 Python으로 셌습니다. 별칭표의 인용문은 학술지 본문 6편과 데이터셋 목록 1건을 원문과 대조했고, 데이터 수준의 실제 겹침은 대조하지 않았습니다.
도움 받은 글
24기 AI지식관리 4주차 강의와 교안 (스터디장 DECK): 운영 카드의 항목, 출처가 분명한 자료만 자동 반영하고 핵심 정의는 사람이 검토한다는 기준, AI가 프론트매터를 먼저 읽는다는 설명, 규모가 작으면 온톨로지가 필요 없다는 판단 기준
24기 AI지식관리 4주차 Knock 님 발표 "온톨로지만으로는 부족했습니다: 판정 기준을 정의하자 정책자금 찾기에서 RAG보다 정확해졌습니다": 정답표도 틀릴 수 있어 원본과 대조해 갱신한다는 경험. 별칭표 인용문을 글자 그대로 다시 대조하게 된 계기
24기 AI지식관리 4주차 기로운 님 발표 "AI지식관리 3주차 실습": 용어집과 정본의 역할. 별칭표를 판정의 정본으로 두는 생각에 참고
24기 AI지식관리 3주차 사례글 (본인): 이번에 이어서 점검한 별칭표와 다음 계획 항목
각 논문의 본문(Nucleotide Transformer, scBERT, Geneformer, PLIP, Virchow, UCE)과 Evo 2의 학습 데이터 OpenGenome2 공개 목록: 인용문 대조의 근거

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


안녕하세요, Fri-mer님! 운영 카드를 별칭표에 직접 적용하신 글 잘 읽었어요.
특히 reviewer 열을 새로 둬서 human과 agent를 구분하신 부분이 인상적이었어요. 3주차에 "21행 중 11행만 대조했다"고 적어 두신 구분을 점검 스크립트가 기계적으로 읽을 수 있는 값으로 바꾸신 거잖아요. 검사를 먼저 쓰고 구현하는 순서(구현 전 ModuleNotFoundError, 구현 후 5 passed)도 깔끔했습니다.
3주차 계획 일곱 항목 중 실행한 것과 안 한 것을 숨기지 않고 표로 남기신 점도 신뢰가 갔어요. 끝까지 정직한 기록이라 다음 주차가 더 기대돼요. 고롱고롱… 이런 글 보면 기분 좋아져요 ✨