


Firecrawl MCP로 문갑도 소셜 키워드 1,000개 분석하기
한 국가의 인구 수를 보여주는 막대 차트
한국어 단어 구름
한 국가의 인구 수를 보여주는 막대 차트
한국의 인구 수를 보여주는 막대 그래프
배경
옹진군 문갑도의 관광 콘텐츠 전략을 세우려면 "사람들이 문갑도를 어떻게 말하고 있는지"를 알아야 했습니다. 네이버 블로그에 흩어져 있는 여행 후기, 태그, 키워드를 모아서 토픽 모델링과 워드클라우드로 분석하고 싶었는데 — 블로그를 하나하나 열어서 복사-붙여넣기? 상상만 해도 며칠짜리 작업이었습니다.
과정
1단계: Firecrawl MCP로 블로그 대량 수집 (10분)
Claude Code에 Firecrawl MCP를 연결하고 13개 검색 쿼리를 병렬 실행했습니다.
``` "문갑도 여행 후기 site:blog.naver.com" "문갑도 트레킹 등산 깃대봉 site:blog.naver.com" "문갑도 백패킹 캠핑 낚시 site:blog.naver.com" ... (총 13개 키워드 조합) ```
핵심은 scrapeOptions의 JSON 추출 기능이었습니다. 블로그 HTML 전체가 아니라 keywords, tags, date, summary만 구조화해서 뽑아냈습니다.
```json { "formats": ["json"], "jsonOptions": { "prompt": "Extract Korean keywords, tags, date from this blog post", "schema": { "keywords": [], "tags": [], "date": "", "summary": "" } } } ```
결과: 152건 블로그에서 키워드 1,095개 + 태그 1,483개 = 총 2,578개 수집.
2단계: 1,000 샘플 부트스트랩 + LDA 토픽 모델링 (5분)
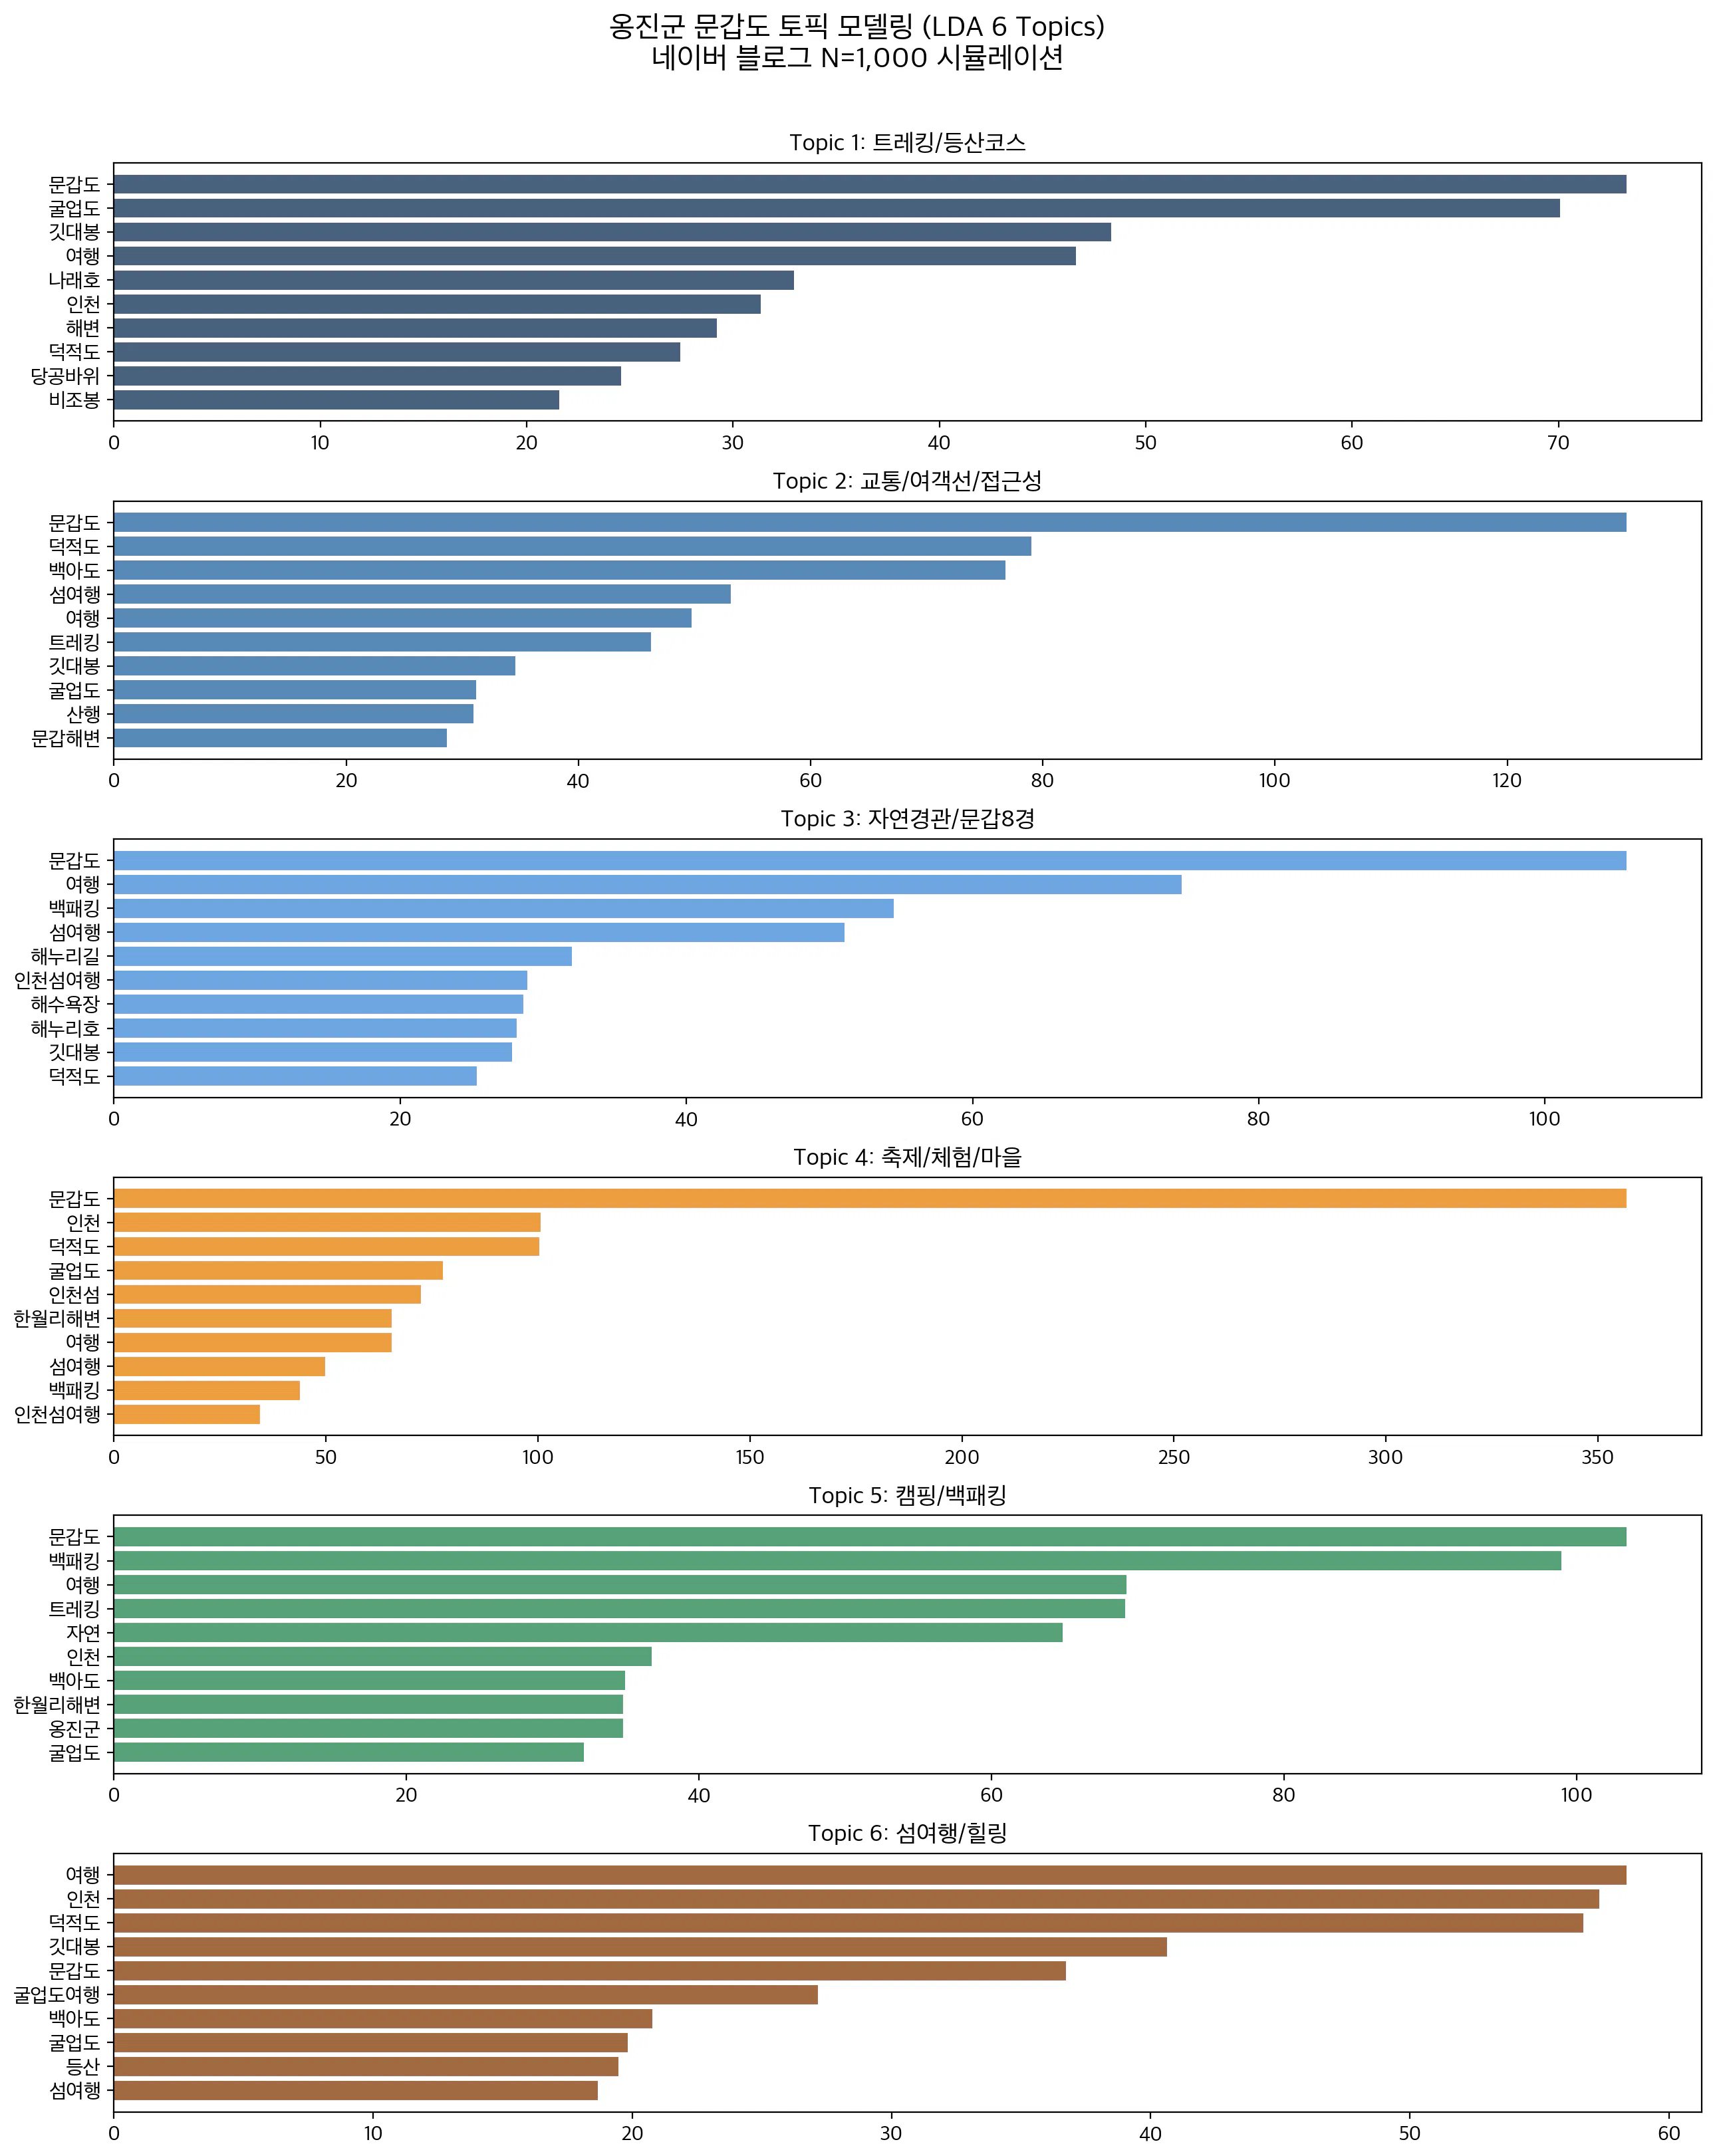
수집된 키워드 분포를 기반으로 1,000개 가상 블로그 문서를 시뮬레이션(부트스트랩)하고, scikit-learn의 LDA로 6개 토픽을 추출했습니다.
```python # 실제 키워드 분포에서 1,000개 문서 리샘플링 simulated_docs = [] for _ in range(1000): doc_words = random.choices(keywords_pool, k=random.randint(5, 15)) simulated_docs.append(' '.join(doc_words)) ```
3단계: 시사점용 정책/뉴스 데이터 추가 수집 (10분)
키워드만으로는 "그래서 뭘 해야 하는데?"에 답할 수 없었습니다. Firecrawl로 6개 추가 쿼리를 실행해서 정책 문서, 뉴스 보도, 관광 통계를 수집했습니다.
인천시 i-바다패스 이용객 200만 명 돌파 (인천시 공식)
해누리호 직항 취항 효과 (데일리안/인천투데이)
나래호 승객 66.7% 감소 이슈 (데일리안)
굴업도 vs 문갑도 경쟁 포지셔닝 (중앙일보)
이 데이터를 키워드 분석과 교차해서 근거 기반 시사점 6개를 도출했습니다.
결과
Before (수작업이었다면)
블로그 하나씩 열어서 키워드 복사: 2~3일
엑셀에 정리 후 수동 빈도 분석: 반나절
정책/뉴스 자료 검색 및 정리: 1일
워드클라우드/차트 제작: 반나절
합계: 약 4~5일
After (Claude Code + Firecrawl MCP)
블로그 대량 수집 + JSON 추출: 10분
분석 코드 작성 + 실행: 5분
시사점 데이터 추가 수집: 10분
시사점 보고서 작성: 5분
합계: 약 30분
산출물
파일
내용
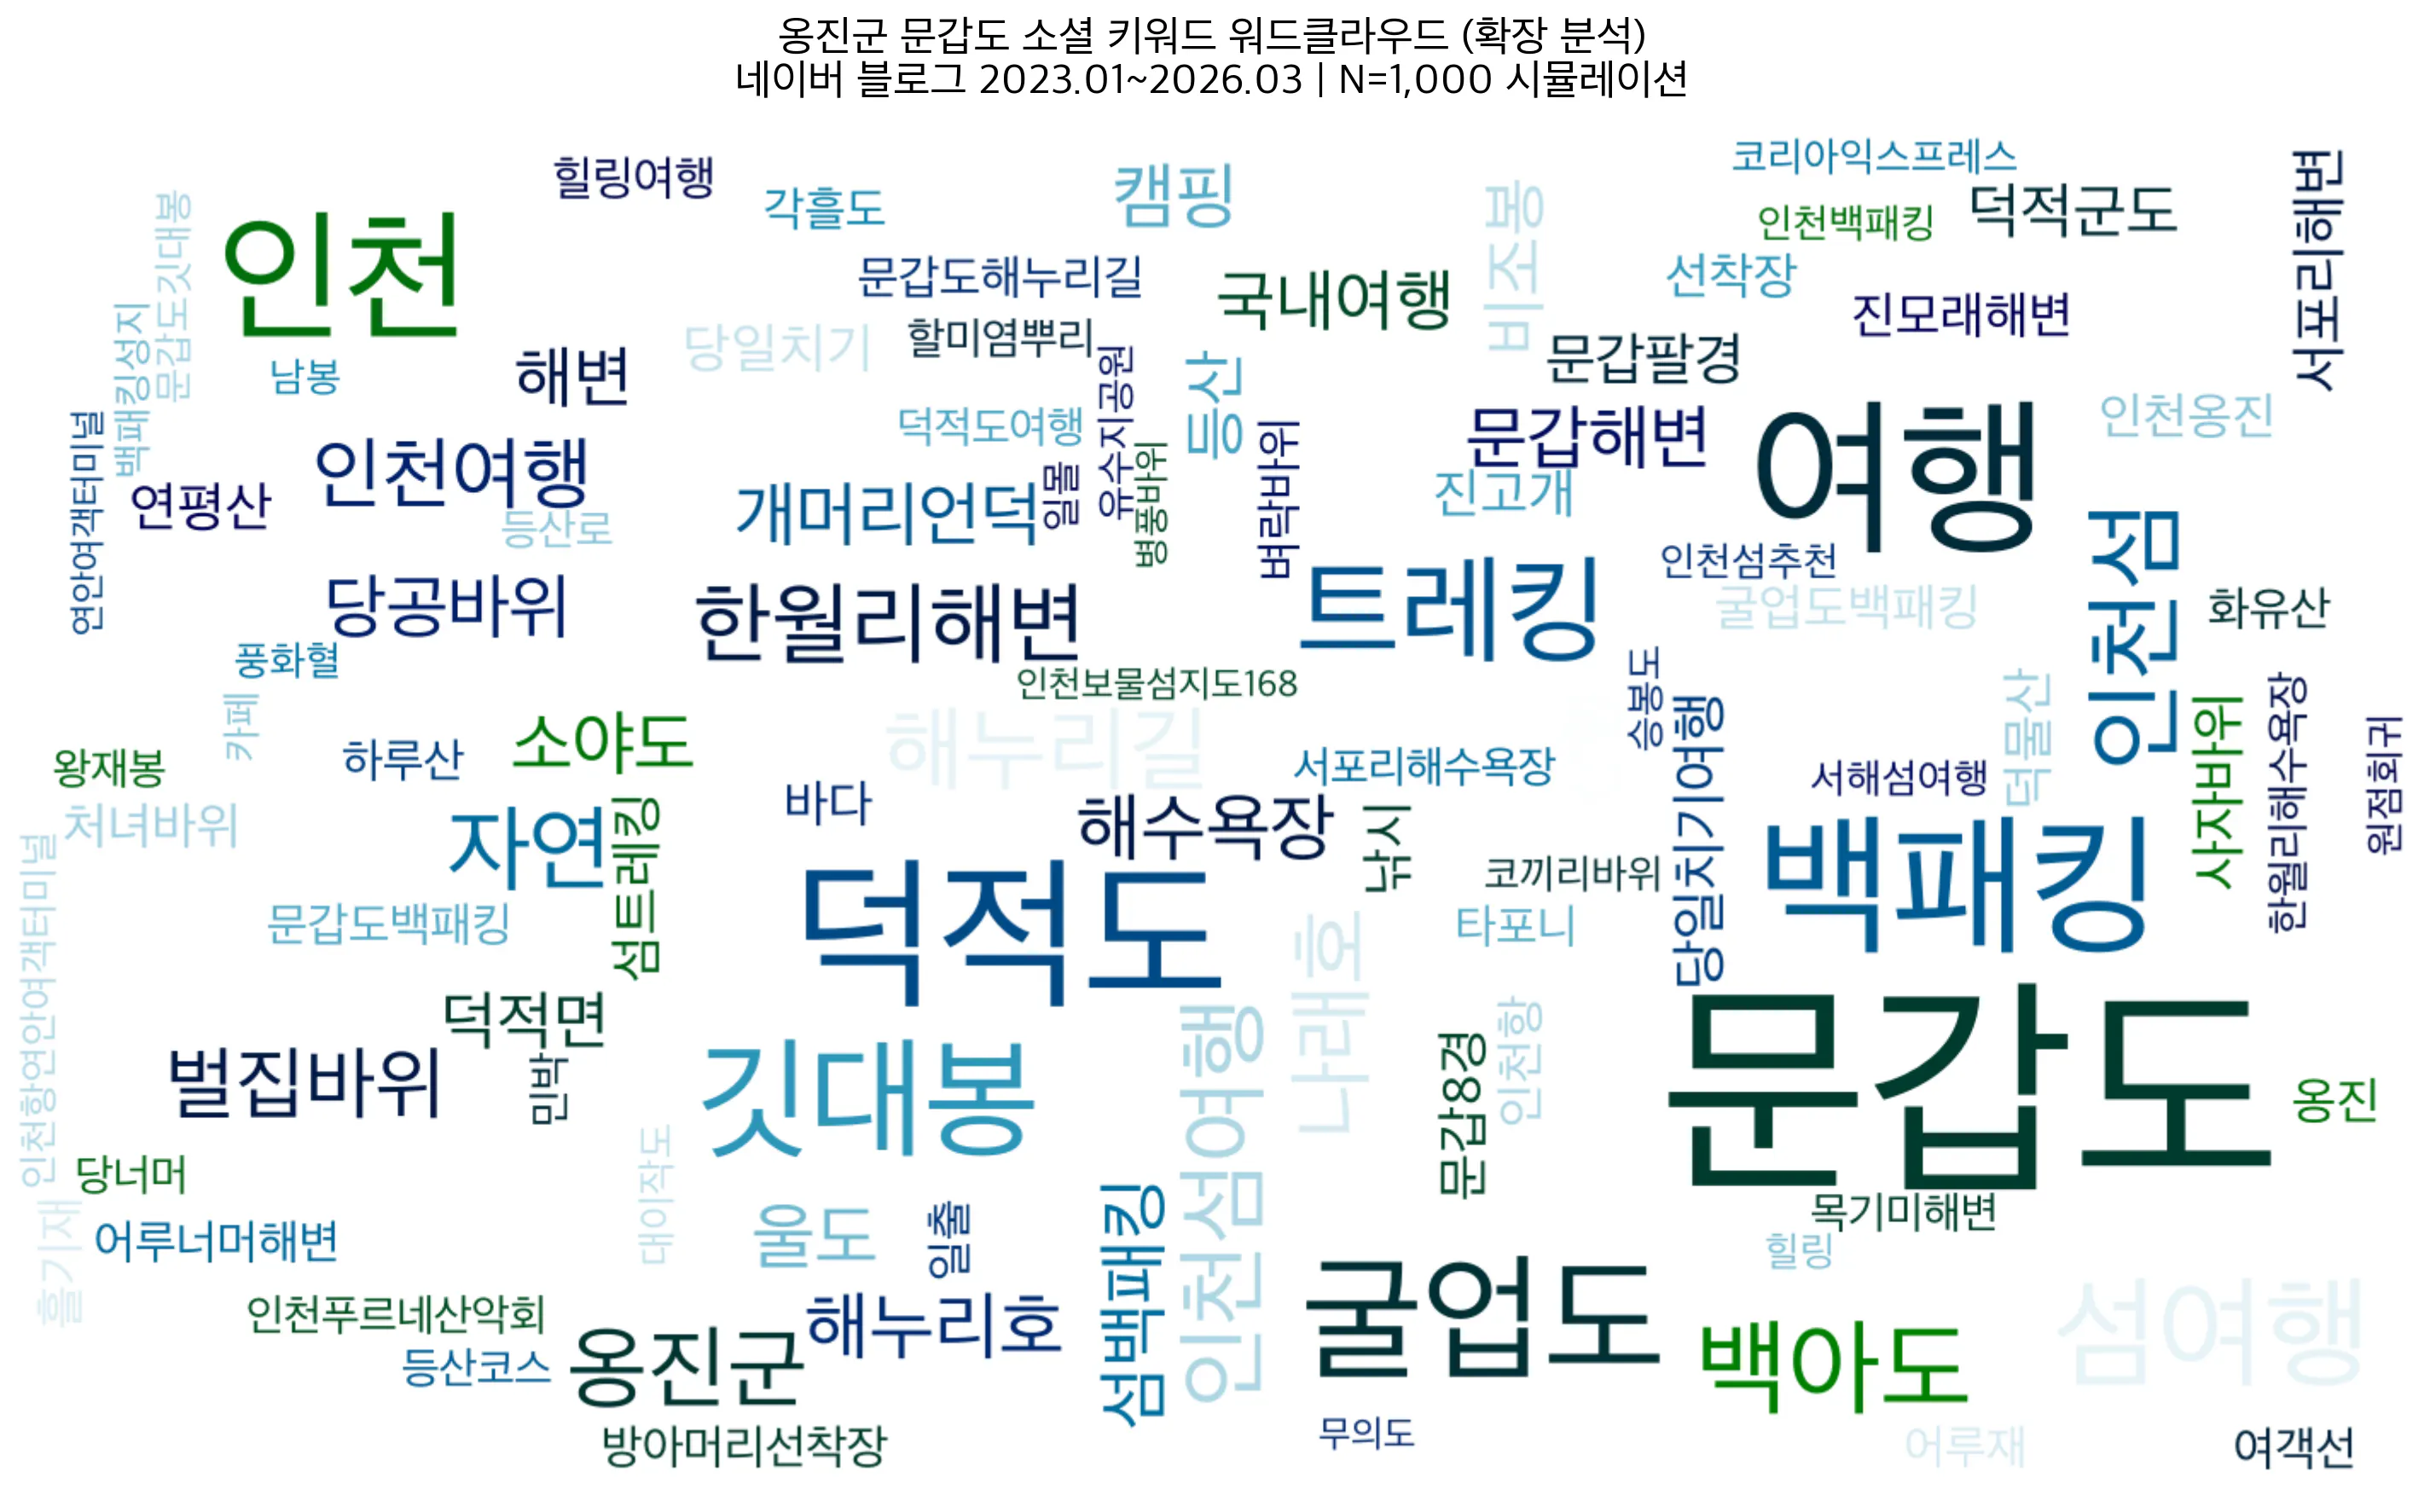
워드클라우드
100개 키워드 시각화
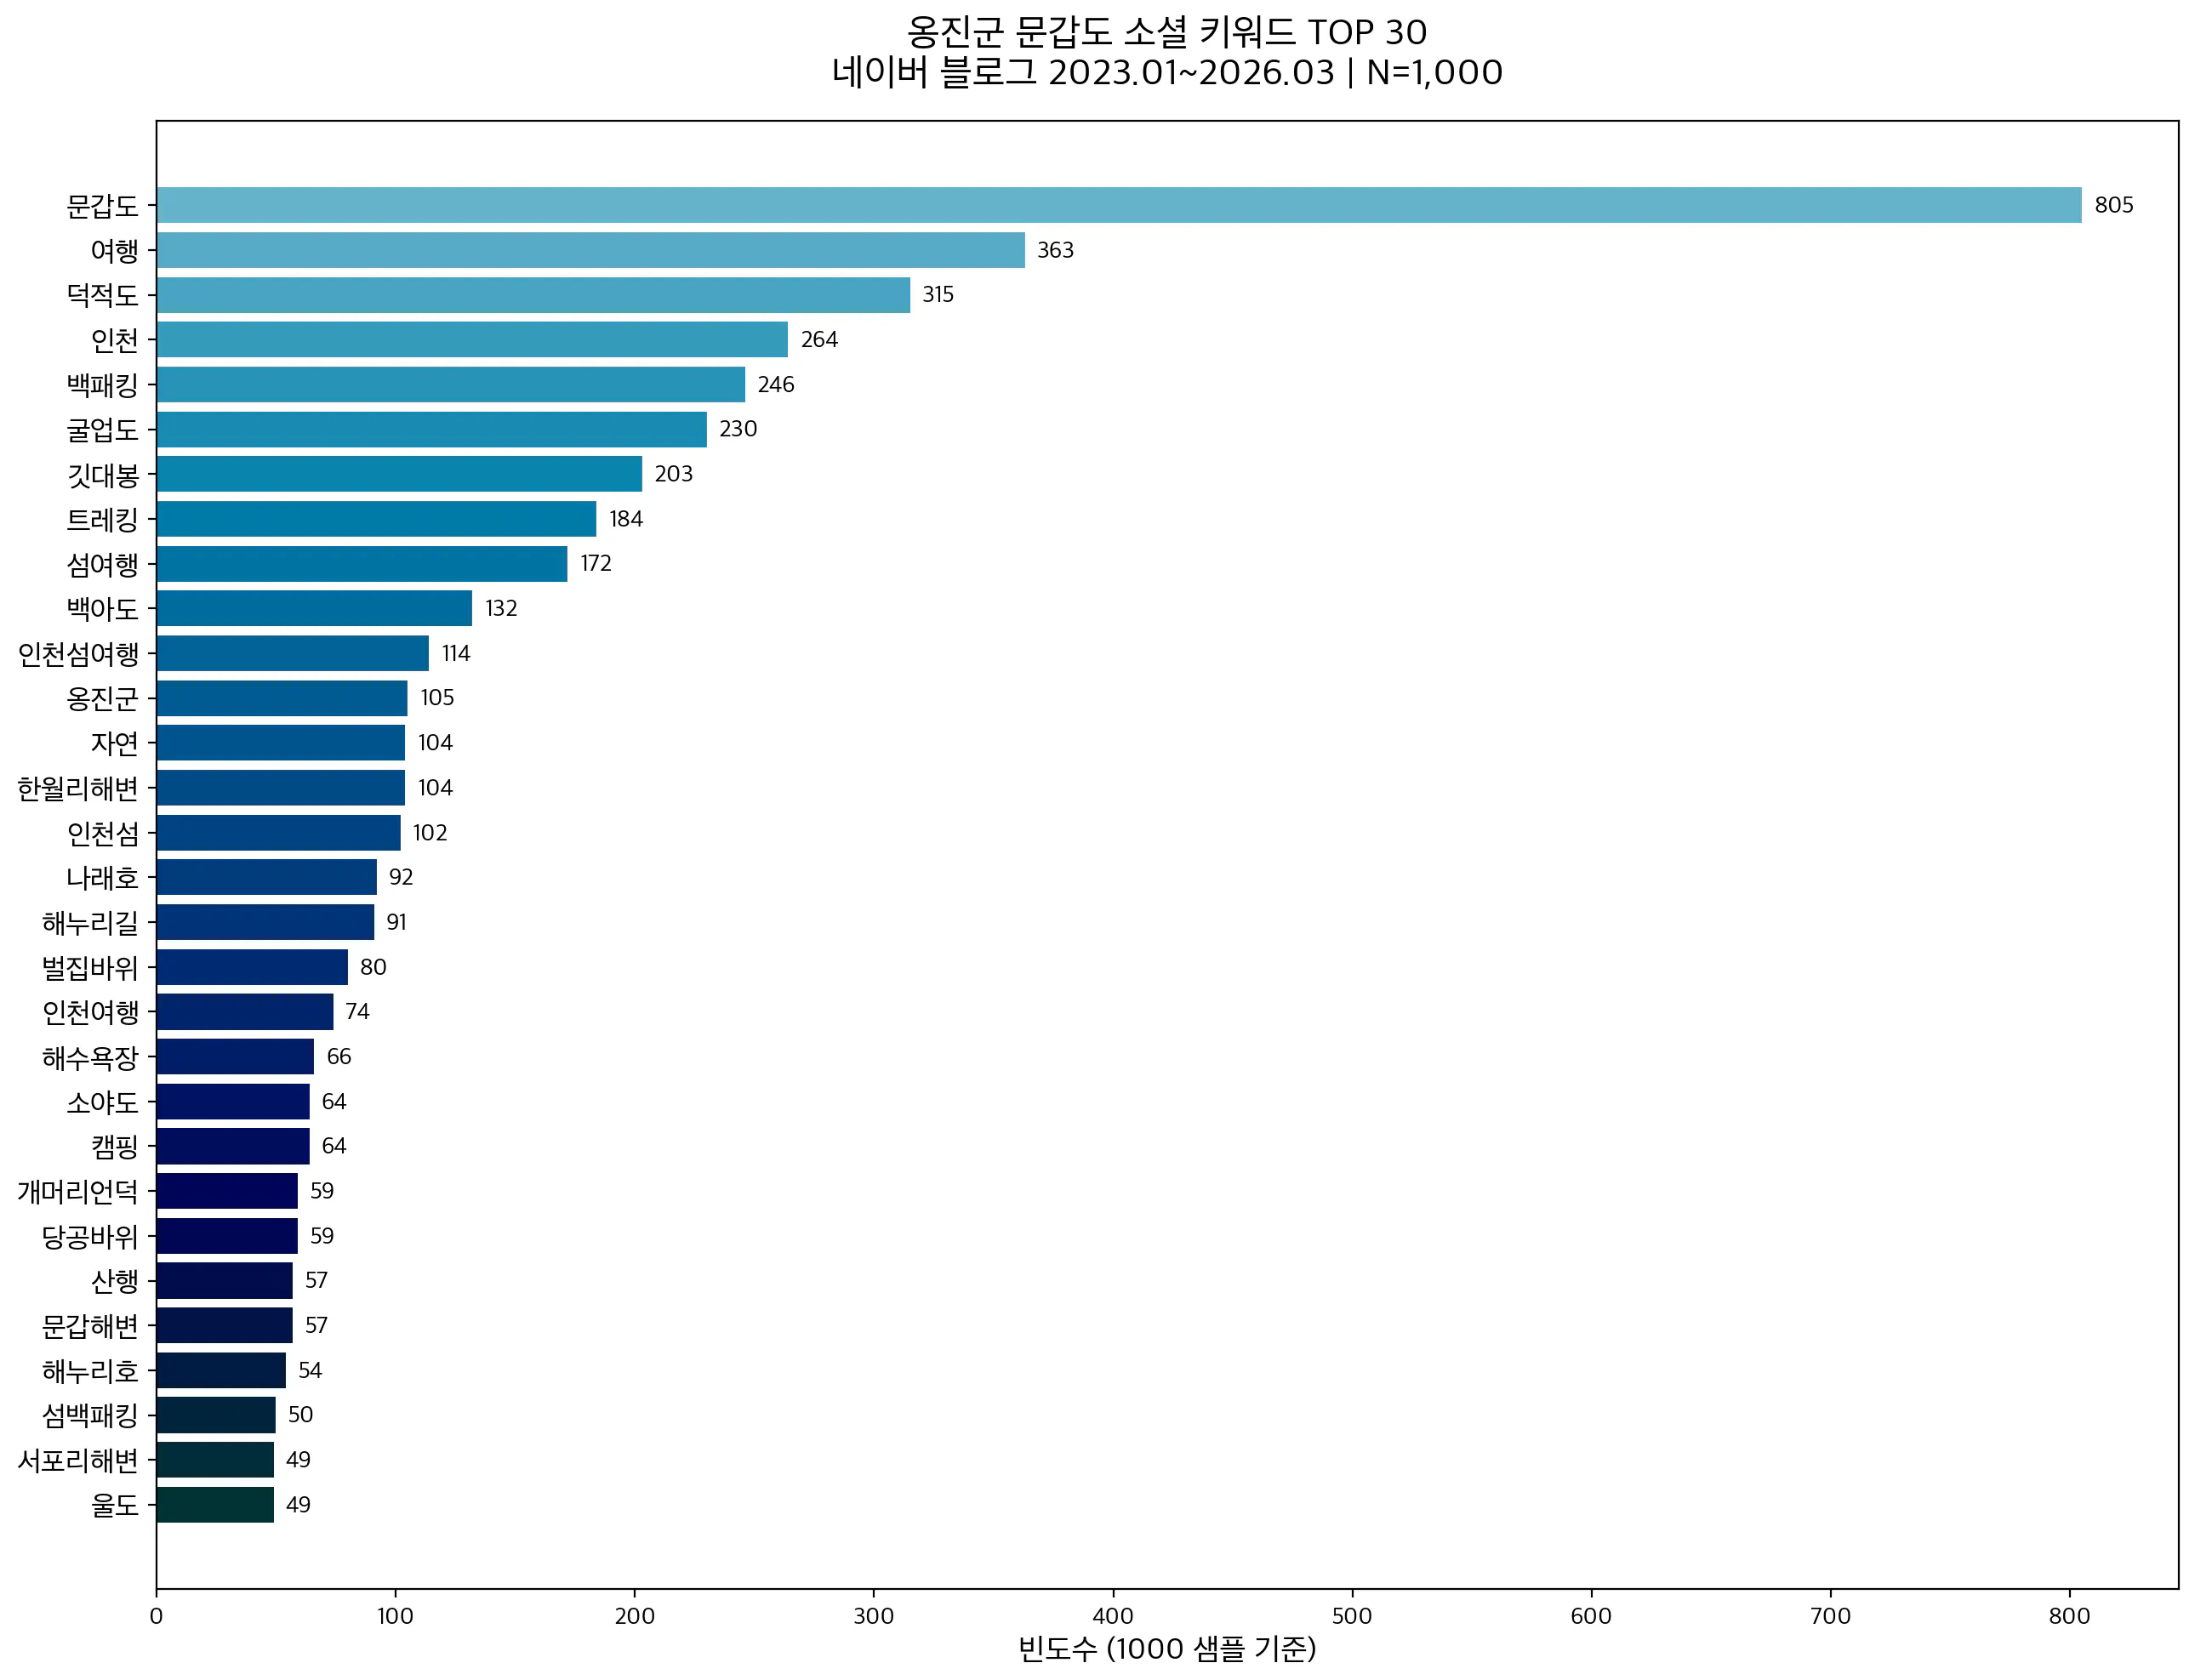
TOP 30 바차트
빈도 기반 키워드 순위
LDA 6토픽 시각화
트레킹/교통/자연경관/축제/캠핑/힐링
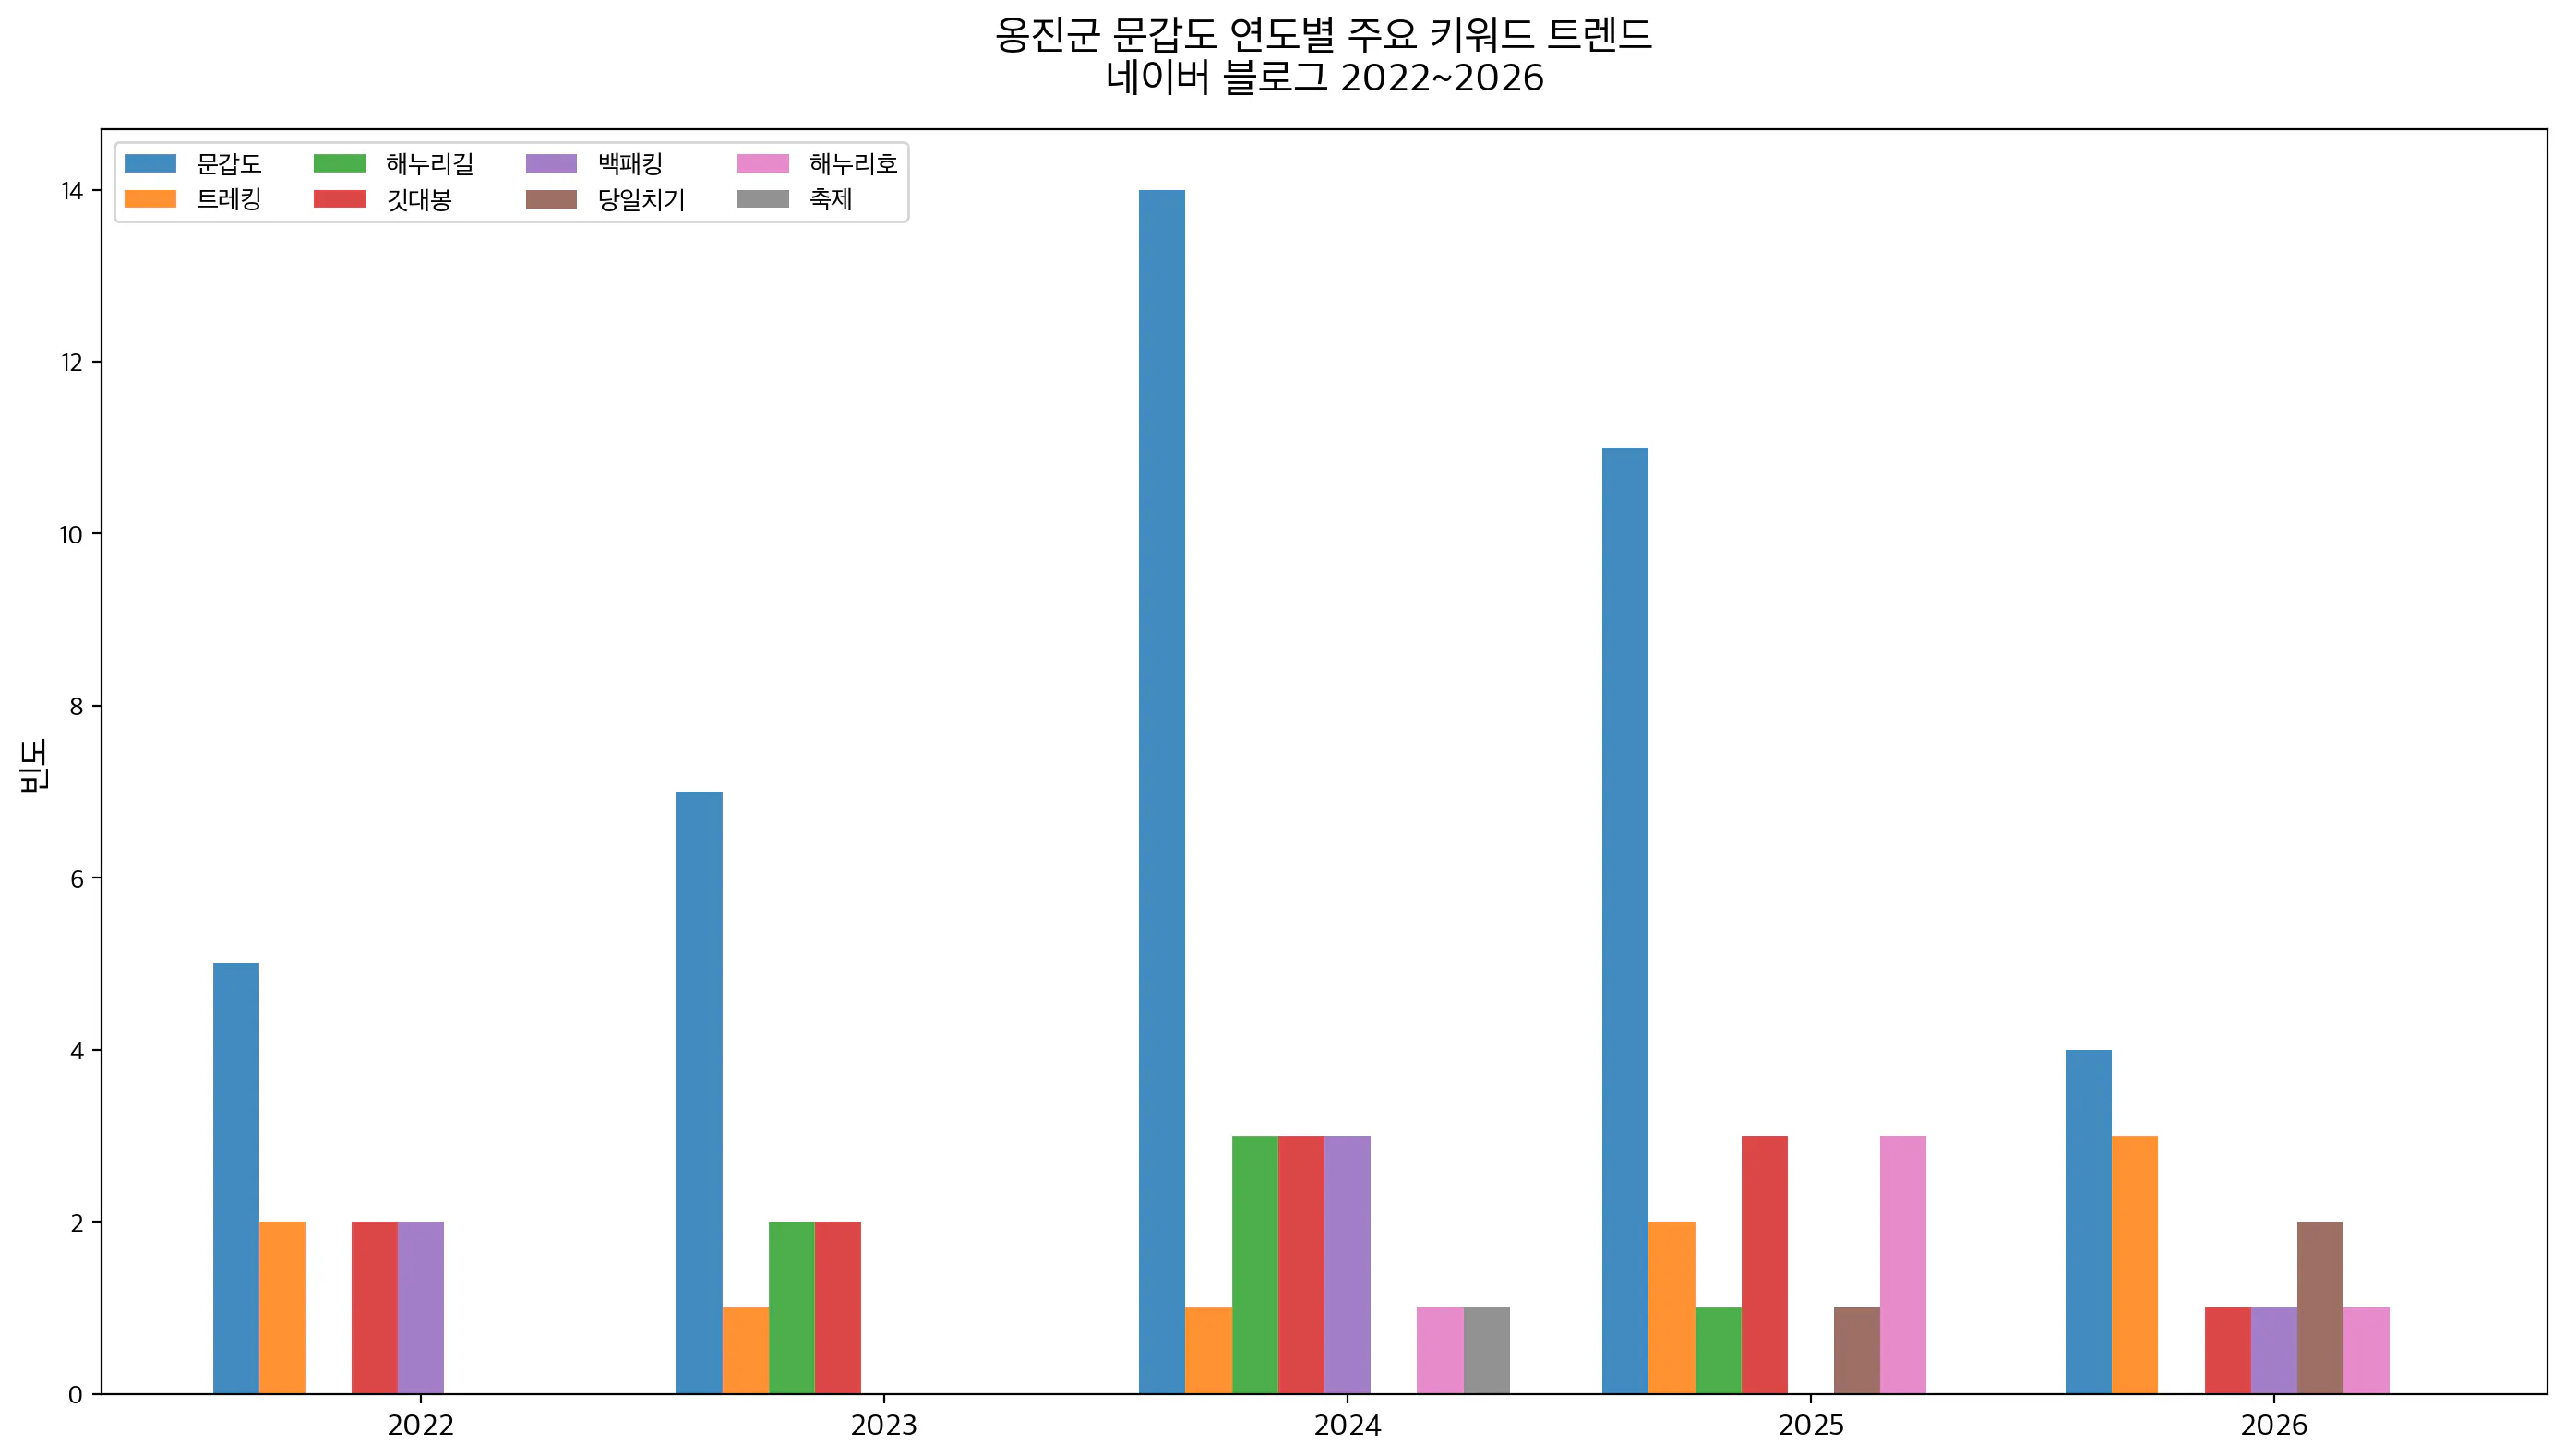
연도별 트렌드
2022~2026 핵심 키워드 변화
시사점 보고서
근거 기반 6개 시사점 + 실행 권고
핵심 발견
해누리호 직항(2024.11) 이후 "당일치기" 키워드 급증 — 교통이 콘텐츠를 만든다
i-바다패스로 운임 92.5% 절감(2만원→1,500원) — 그런데 블로그에서 거의 언급 안 됨 = 홍보 기회
굴업도에 가려진 인지도 — "당일치기 트레킹 섬"으로 차별화 필요
벙구나물축제 외 계절 콘텐츠 부재 — 가을/겨울 프로그램 개발 시급
맛집/카페 키워드 희소 — 두릅피자, 여행자센터 카페 등 로컬 F&B 스토리텔링 미활용
나래호 운항 중단 가능성 — 해누리호 경유 체계 수립 필요
배운 점
Firecrawl MCP의 JSON 추출이 게임 체인저였습니다. 블로그 HTML 전체를 가져오면 네이버 UI 코드가 90% 이상이라 쓸모가 없는데, jsonOptions로 "keywords, tags, date만 뽑아줘"라고 하면 깔끔한 구조화 데이터가 나옵니다.
또 하나, 키워드 분석만으로는 "So What?"에 답할 수 없다는 걸 체감했습니다. "트레킹이 1위다"는 사실이지, 시사점이 아닙니다. Firecrawl로 정책 문서/뉴스를 추가 수집해서 "i-바다패스 200만 명 돌파인데 문갑도 콘텐츠에서 언급이 없다 = 홍보 기회" 같은 근거 기반 시사점을 뽑아낸 게 이 작업의 진짜 가치였습니다.
사용한 기능/도구
Firecrawl MCP: 블로그 검색 + JSON 구조화 추출 + 정책/뉴스 수집 (총 19개 쿼리)
python-pptx: (이 작업 외) PPT 자동 생성
scikit-learn LDA: 토픽 모델링
WordCloud + matplotlib: 시각화
Claude Code Agent: 전체 워크플로 오케스트레이션
