Claude Code 비밀 키 차단 훅을 만들고 지난 로그로 시험하기
2026.10.26
소개
4주차 강의에서 API 키는 코드에 직접 쓰지 말고, 반드시 강제해야 하는 것은 훅으로 막으라는 설명을 들었습니다. 이 기준으로 3주차 글에서 미뤄 둔 계획 하나를 실제로 해 보았습니다. 비밀 키가 든 .env 파일을 Claude Code가 읽거나 API 키 문자열을 코드에 쓰려고 하면 실행 전에 막는 훅의 시제품을 시험을 먼저 쓰고 만들었고, 제 지난 도구 호출 22,212개에 다시 넣어 몇 번이나 막혔을지 쟀습니다.
함께 3주차 계획 15개의 실행 여부와 1주차부터 4주차까지 네 구간의 사용 습관도 같은 명령으로 다시 세었습니다. 훅을 처음 만들어 보려는 분, 막는 규칙이 평소 작업을 얼마나 방해하는지 궁금한 분께 도움이 될 것 같습니다.
저는 청강생이고 4주차 다시보기를 봤습니다. 4주차는 스터디장의 AX 사례 발표와 수강생 사례 발표가 앞에 길게 오고, 이어서 Claude API(키, max_tokens, 지난 대화를 기억하지 못하는 성질, 모델별 가격), Orca, 개발 주기(SDLC)를 Claude Code로 운영하는 방법 순서로 진행되었습니다. 개발 주기에서는 사람이 자기 말로 적는 인텐트 문서(intent.md)의 여섯 항목, CLAUDE.md와 스킬과 훅의 역할 구분, 평가를 20~50개로 시작하는 방법, 환경별 자율성이 나왔습니다. 자막과 채팅 로그에는 과제 안내가 없었고 설문 조사 요청만 있었습니다. 3주차의 OMC 과제도 이번에 다시 확인하는 말은 없었습니다.
측정은 2026-10-23 22시 14분(KST)에 했고, 로그와 설정은 읽기만 했습니다. 훅은 설치하지 않았습니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, matplotlib, 셸(wc, stat, git)
범위
구분 | 값 |
|---|---|
제가 직접 대화한 세션(서브에이전트 제외)의 로그 | 68개 파일 ( |
4주차 구간 | 2026-10-22 00:50 ~ 10-23 22:14 (KST), 제가 보낸 지시 141개 |
비교 구간 | 1주차 글 구간(지시 2,323개), 2주차(1,085개), 3주차(1,050개)를 모두 오늘 로그로 다시 계산 |
재생한 도구 호출 | 22,212개(구간별 11,341, 4,881, 5,206, 784) |
점검한 저장소 |
|
Step 1. 강의 기준의 측정 항목 변환
4주차 강의 기준 | 잴 것 |
|---|---|
API 키는 코드에 쓰지 않고 .env나 환경 변수에 둔다 | 추적 파일 속 키 문자열 수, .env가 git 무시 대상인지 |
반드시 강제해야 하는 것은 훅으로 | 비밀 키 차단 훅 시제품, 지난 로그에서의 차단 건수와 오탐 |
개발 주기 여섯 단계(계획 문서, 지침, 테스트, 훅) | 저장소 14개의 점검표 |
API는 쓴 만큼 청구되고 출력 단가가 입력의 5배다 | 내 사용을 API 가격표로 환산한 비용 구성 |
압축 알림이 뜨면 새 창이 크레딧을 덜 쓴다(채팅 질문) | 컨텍스트 40만 토큰 이상 응답의 환산 비용 비중 |
3주차 글의 다음 주 계획 | 파일 수정 시각, 설정, 로그로 판정 |
Step 2. 3주차 계획의 실행 여부 확인
3주차 글의 다음 주 계획에서 판정할 수 있는 15개를 골라 하나씩 확인했습니다.
wc -l ~/.claude/skills/write-post/SKILL.md ~/.claude/skills/research-lookup/SKILL.md
stat -f '%Sm %N' -t '%F' ~/.claude/skills/write-post/SKILL.md
python3 -I 24기문과생도AI_4주차_측정.py --cut-ts 2026-10-21T15:50:00.000Z --end 2026-10-23T13:14:43.000Z --out assets/측정결과_4주차.json
     608 ~/.claude/skills/write-post/SKILL.md
     551 ~/.claude/skills/research-lookup/SKILL.md
2026-07-26 ~/.claude/skills/write-post/SKILL.md
saved assets/측정결과_4주차.json cut 2026-10-21T15:50:00.000Z
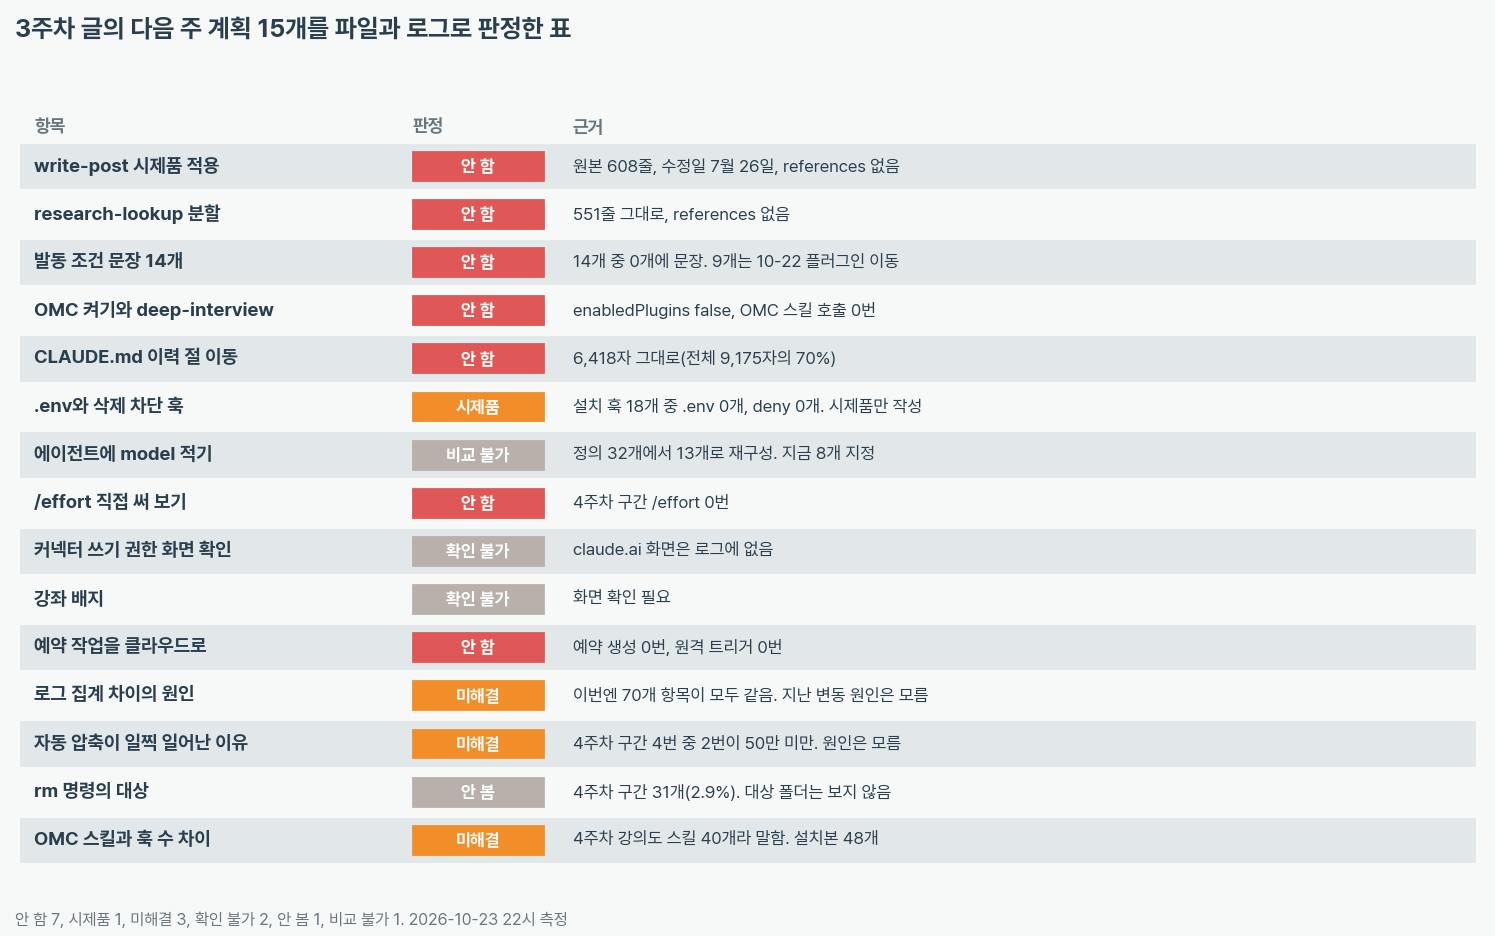
두 스킬은 줄 수와 수정일이 3주차 그대로여서 분할 시제품 적용과 research-lookup 분할은 하지 않았습니다. 발동 조건 문장 14개는 14개 중 0개의 첫 설명 줄에 들어가 있지 않았고, 14개 중 9개는 10월 22일에 로컬 플러그인으로 옮겨진 스킬이라 설명을 고친 것이 아니라 위치가 바뀌었습니다. 훅은 18개 그대로이고 .env를 다루는 훅이 0개, permissions.deny가 0개입니다. OMC는 enabledPlugins 값이 여전히 false이고 OMC 스킬 호출은 로그 전체에서 0번입니다. 계획 15개 중 실행으로 판정한 것은 없었습니다. 3주차 글에서 2주차 계획이 0개 실행이었다고 적었는데 같은 결과가 이어졌습니다.
Step 3. 인텐트 문서 여섯 항목의 목표 정리
강의가 소개한 인텐트 문서의 여섯 항목(문제, 원하는 결과, 영향 받는 사람, 영향 받는 시스템, 제약, 열린 질문)에 맞춰 실습/intent.md를 적었습니다. 이번에는 순서를 지키지 못했습니다. 시험 사례를 먼저 쓰고 구현까지 끝낸 뒤에 문서를 정리했습니다. 정리하면서 열린 질문 네 개가 나왔고, 그중 하나(source .env를 막을지)는 아래 재생 결과 때문에 처음 생각과 다르게 답했습니다.
Step 4. 시험 사례표 작성
훅은 규율을 구현한 것이라 구현보다 시험을 먼저 썼습니다. 참값은 제가 손으로 정한 허용과 차단 사례 표입니다. 차단해야 하는 것은 .env와 .env.local 읽기와 수정, cat .env, grep KEY .env, printenv ANTHROPIC_API_KEY, echo $ANTHROPIC_API_KEY, 모의 키 문자열을 코드나 curl 명령에 쓰는 것이고, 통과해야 하는 것은 .env.example 읽기, git check-ignore .env, echo .env >> .gitignore, cp .env.example .env, .environment.md 같은 비슷한 이름입니다. 그 밖에 이상한 입력에서 죽지 않는지, 키 값이 이유 문구에 되풀이되지 않는지, 같은 입력에 같은 출력인지도 시험으로 적었습니다.
python3 -I -m pytest -q test_secret_guard.py # 내용이 빈 함수(항상 허용)일 때
20 failed, 23 passed in 0.56s
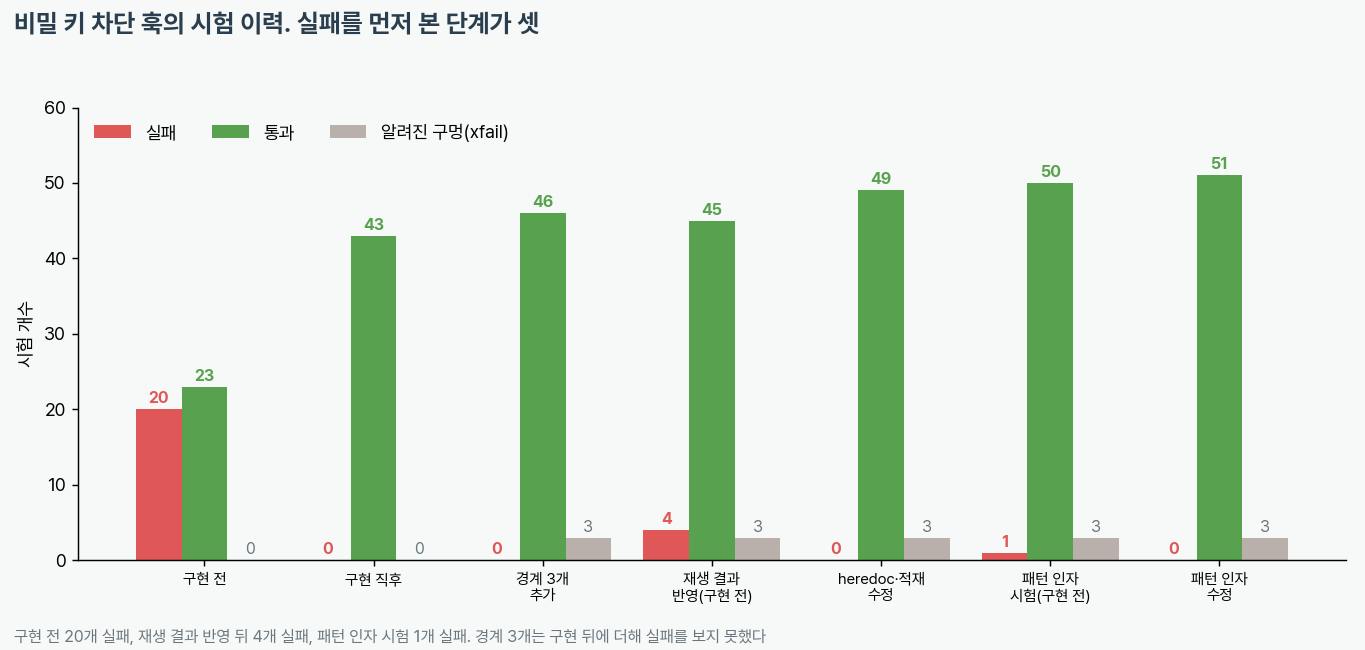
통과한 23개는 대부분 "통과해야 한다"는 사례여서 빈 함수도 통과했습니다. 구현하자 43개가 모두 통과했습니다. 구현 뒤에 경계 시험 3개(cat .env.example .env, .env.bak, tail -f .env)와 막지 못하는 것을 표시한 시험 3개를 더했습니다. 경계 3개는 처음부터 통과해서 실패를 보지 못했습니다. 막지 못하는 3개(python3 -c "open('.env')", base64 .env, node -e 경유)는 xfail(strict=True)로 남겨 두어, 나중에 막게 되면 시험이 알려 줍니다.
Step 5. 지난 로그 재생
시험 사례는 제가 떠올린 것뿐이어서 실제 작업에서 어떻게 나오는지 알 수 없습니다. 세션 로그의 모든 도구 호출(Read, Edit, Write, Bash 등)을 훅 함수에 다시 넣고 막혔을 호출만 셌습니다. 대화 내용은 저장하지 않고 키 문자열은 남기지 않습니다.
python3 -I replay_guard.py --end 2026-10-23T13:14:43.000Z --out ../assets/재생결과.json
saved ../assets/재생결과.json {'1주차': 11341, '3주차': 5206, '2주차': 4881, '4주차': 784} {'1주차': 16, '2주차': 1} {'1주차': 39, '2주차': 3}
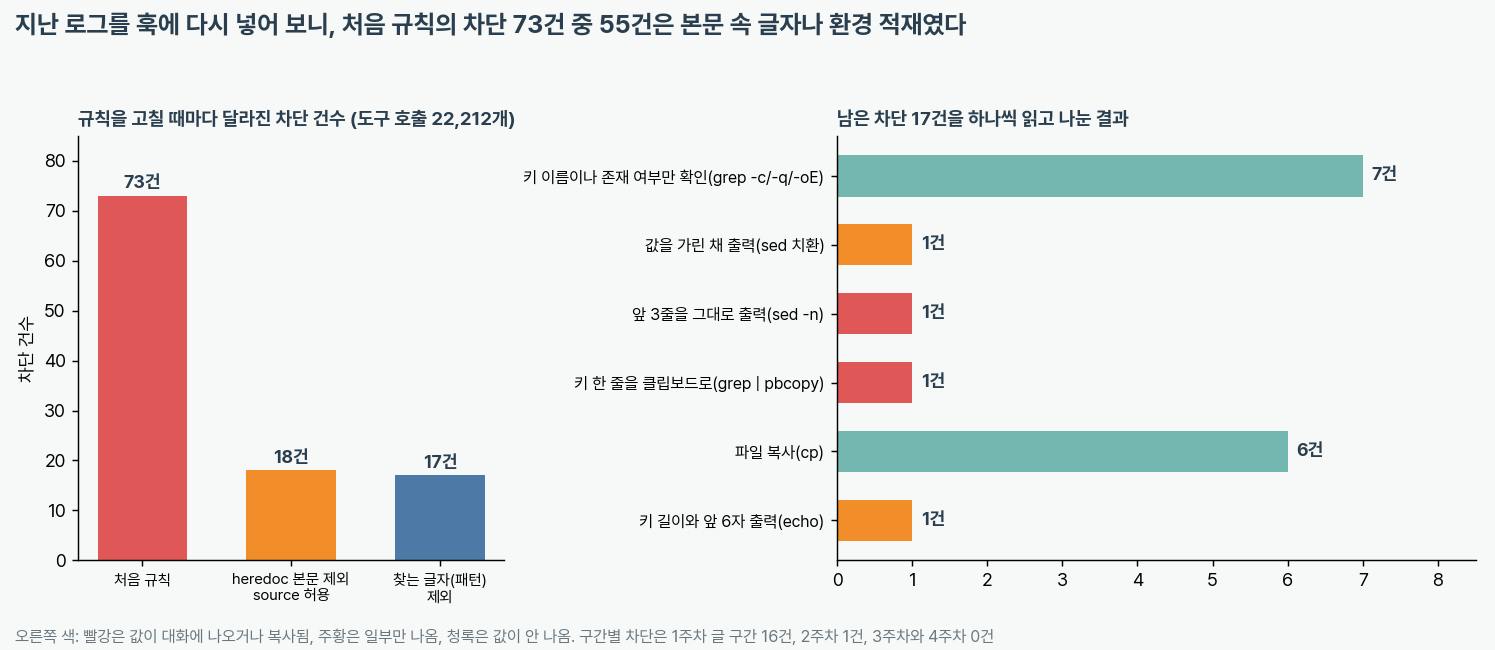
처음 규칙은 73건을 막았습니다. 막힌 호출을 읽어 보니 명령이 아닌 것이 섞여 있었습니다. cat > README.md <<'EOF' 같은 heredoc의 본문에 적힌 글자가 명령으로 읽혔고, set -a && source .env && set +a는 값을 대화에 내지 않고 환경에 적재하는 해커톤 실행 명령이었습니다. heredoc 본문을 빼고 source와 .를 허용으로 옮기자 18건이 되었습니다. 이때는 시험에 해당 사례를 더해 실패(4개)를 먼저 본 뒤 고쳤습니다. 남은 18건 중 grep -c ".env" .gitignore는 찾는 글자가 .env일 뿐 파일을 여는 명령이 아니었고, 이것도 시험을 먼저 더해 실패를 본 뒤 고쳐 17건이 되었습니다.
남은 17건은 하나씩 읽고 나누었습니다. 값이 그대로 대화에 나온 것이 1건(앞 3줄 출력), 키 한 줄을 클립보드로 복사한 것이 1건, 값을 가린 출력과 키 길이와 앞 6자 출력이 2건, 키 이름이나 존재 여부만 본 것이 7건, 비밀 파일을 복사한 것이 6건이었습니다. 구간별로는 1주차 글 구간 16건, 2주차 구간 1건, 3주차와 4주차 구간 0건이고, API 키 문자열을 코드나 명령에 쓴 것은 모든 구간에서 0건이었습니다. 적재(source .env)는 허용으로 두었는데 1주차 구간 39번, 2주차 구간 3번 쓰였습니다.
Step 6. 저장소 14개의 점검
강의의 개발 주기에서 계획 문서, 지침, 테스트, 훅, 비밀 값 관리를 저장소별로 확인했습니다. 읽기 전용이고 키 문자열은 개수만 셉니다.
python3 -I sdlc_scan.py --out ../assets/저장소점검.json
{"repos": 14, "claude_md": 6, "project_hooks": 1, "with_plan_docs": 3, "with_tests": 8, "with_tracked_env": 0, "with_key_literal": 0, "env_on_disk_total": 4, "env_not_ignored_total": 0, "ANTHROPIC_API_KEY_in_shell_env": false}
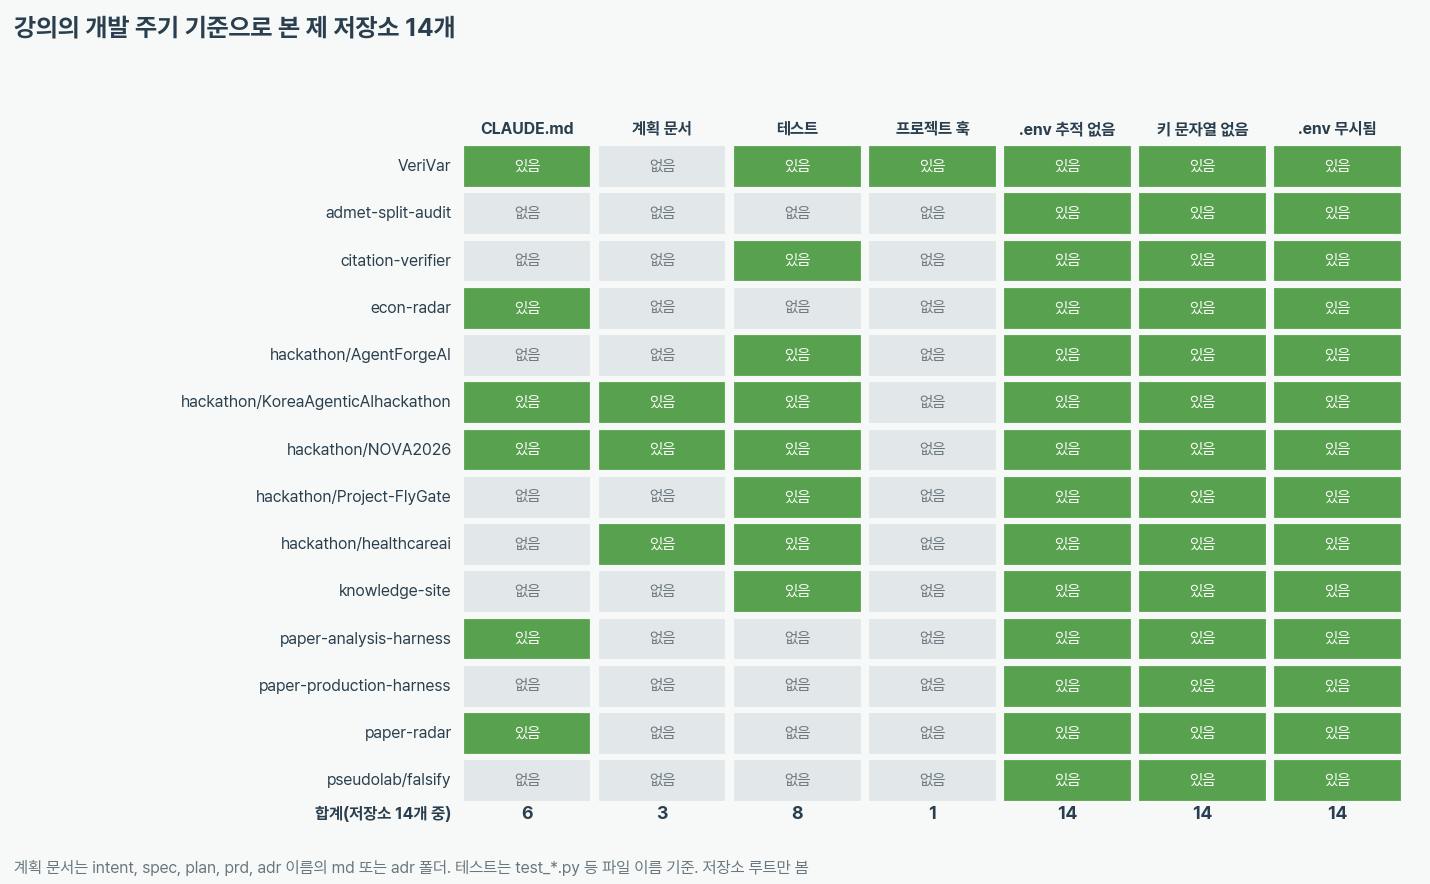
강의가 경고한 노출은 이 범위에서 0이었습니다. 추적된 .env가 0개, 추적 파일 속 sk-ant- 형태 문자열이 0개, 디스크의 .env 4개는 모두 git이 무시합니다. 반면 개발 주기의 앞 단계는 비어 있었습니다. 계획 문서가 있는 저장소는 3개이고 프로젝트 훅은 1개입니다. 마지막 줄의 ANTHROPIC_API_KEY는 설정 여부만 본 값이며, 이 명령을 실행한 셸에는 설정되어 있지 않았습니다. 제 평소 터미널도 같은지는 확인하지 못했습니다.
Step 7. API 가격표로 환산한 비용 구성
강의는 API가 쓴 만큼 청구되고 출력이 입력보다 다섯 배 비싸다고 했습니다. 제 Claude Code 사용을 같은 가격표로 계산하면 비용이 어디서 나오는지 쟀습니다. 가격은 내장 claude-api 스킬의 모델 표(스터디장이 화면에서 읽은 값과 같았습니다)를 썼고, 구독 사용자가 실제로 낸 금액이 아니라 같은 사용을 종량제로 냈다면 얼마인지를 보는 추정입니다.
cost = (input*p_in + output*p_out + cache_read*p_read + cache_write*p_in*1.25) / 1_000_000
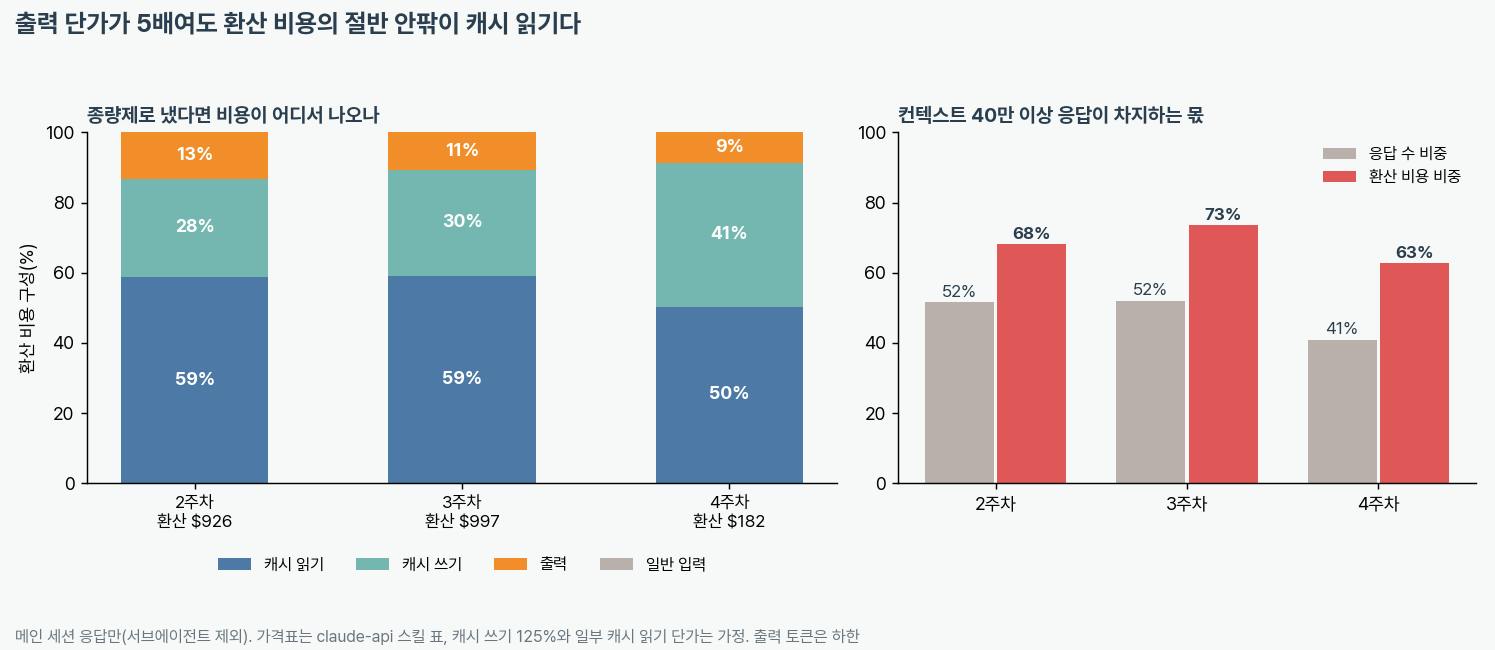
환산 비용의 절반 안팎이 캐시 읽기(앞 대화를 다시 읽는 토큰)였고 출력은 9~13%였습니다. 3주차 구간에서는 컨텍스트가 40만 토큰 이상인 응답이 응답 수의 52.0%인데 환산 비용의 73.5%를 차지했습니다. 오렌지 님이 채팅에서 물은 대로 압축 알림이 뜬 긴 대화를 이어 가는 것보다 새 창이 크레딧을 덜 쓴다는 설명의 방향이 이 숫자와 맞습니다. 다만 캐시 쓰기 125%와 일부 모델의 캐시 읽기 단가는 가정이고, 출력 토큰은 스트리밍 기록의 한계로 하한입니다. 서브에이전트 로그는 포함하지 않았습니다.
Step 8. 네 구간의 재측정
3주차 글과 같은 측정 스크립트를 4주차 구간으로 돌렸습니다. 새 세션이 홈 폴더 밖 임시 폴더에서 시작되면서 스크립트의 한 줄(relative_to(HOME))이 오류로 죽어서, 그 한 줄만 고친 사본을 4주차 폴더에 두었습니다. 3주차 스크립트로 3주차 구간을 다시 세었더니 저장해 둔 값과 로그에서 센 70개 항목이 모두 같았고, 지금 상태를 읽는 13개 항목(에이전트 정의 수, 메모리 파일 수 등)만 달랐습니다. 지난주에 있었던 로그 집계 변동은 이번 주에는 나타나지 않았습니다.
결과와 배운 점
측정 결과 (4주차 구간 2026-10-22 00:50 ~ 10-23 22:14 KST, 재생은 전 구간)
항목 | 값 |
|---|---|
훅 시험 | 구현 전 20개 실패, 최종 51개 통과와 알려진 구멍 3개, 환산 시험 6개 통과 |
지난 호출 재생 | 도구 호출 22,212개 중 차단 17건(0.08%), 3주차와 4주차 구간 0건 |
키 문자열 차단 | 모든 구간 0건. 저장소 14개의 추적 파일에서도 0개 |
3주차 계획 15개 | 안 함 7, 시제품 1, 미해결 3, 확인 불가 2, 안 봄 1, 비교 불가 1 |
저장소 14개 | CLAUDE.md 6, 계획 문서 3, 테스트 8, 프로젝트 훅 1 |
종량제 환산(메인 세션) | 2주차 약 926달러, 3주차 약 997달러, 4주차 1.9일 약 182달러 |
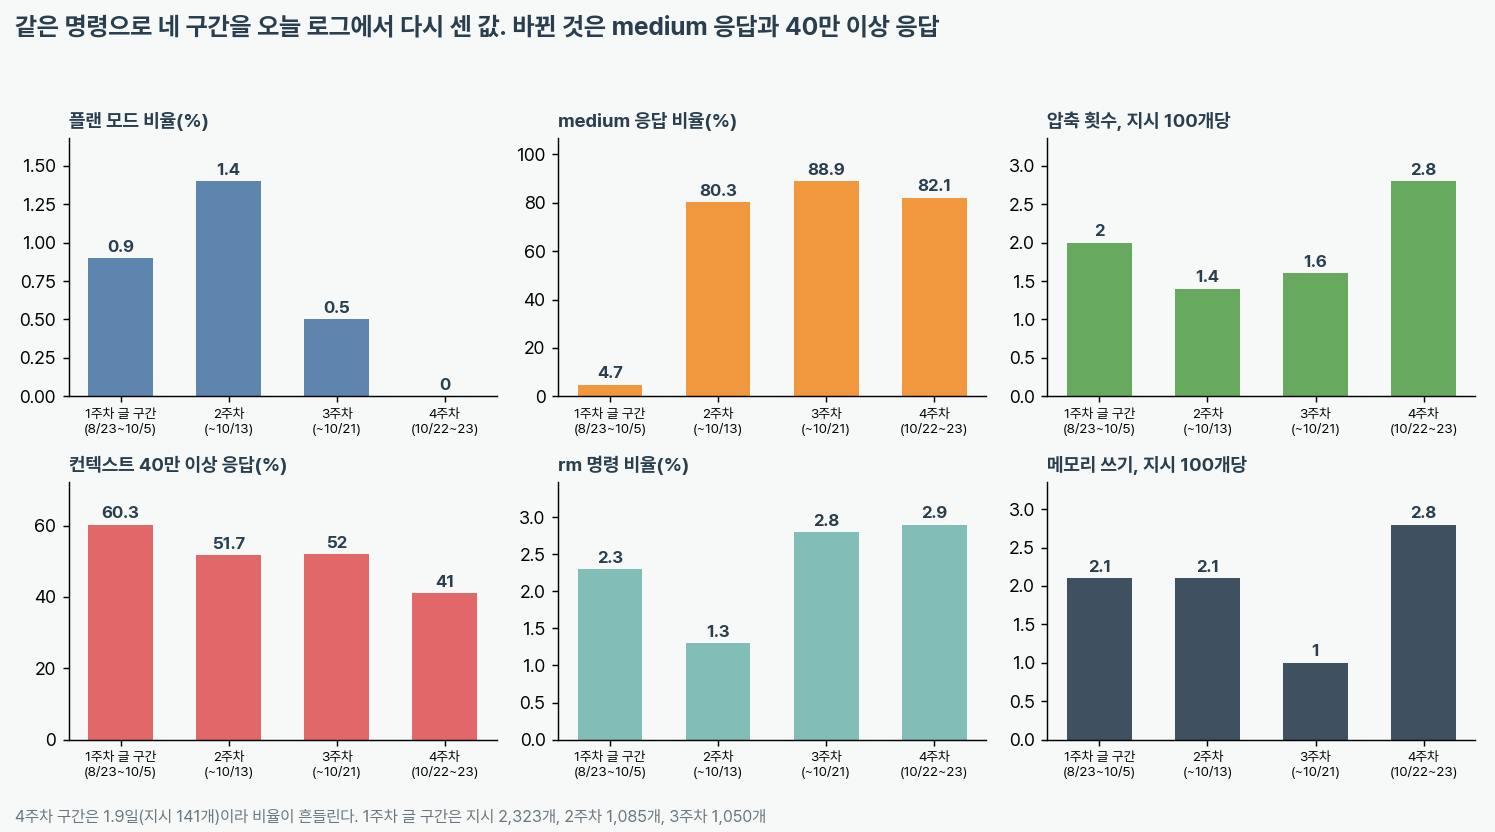
컨텍스트 40만 이상 응답 | 1주차 글 구간 60.3%, 2주차 51.7%, 3주차 52.0%, 4주차 41.0% |
플랜 모드 비율 | 0.9%, 1.4%, 0.5%, 0% (4주 내내 1.4% 이하) |
배운 점
차단 17건은 1주차 글 구간과 2주차 구간에만 있었습니다. 1주차 글 구간은 해커톤 작업이 많았고, 3주차와 4주차 구간(4주차는 약 이틀)에는 0건이었습니다. API 키를 코드에 쓴 기록은 없습니다. 이 훅의 필요가 작업 종류에 따라 갈릴 수 있다고 봅니다. 해커톤처럼 외부 API 키를 쓰는 작업에서 의미가 클 것으로 보입니다.
이번 훅에서는 시험 사례에 없던 오탐이 지난 로그에서 나왔습니다. 제 사례표에는 heredoc 본문과
source .env가 없었고, 처음 규칙은 73건 중 55건을 그런 호출로 막았습니다. 시험은 떠올린 것만 지키고 재생은 실제로 한 것을 보여 줍니다. 둘이 서로 다른 것을 잡았습니다.값이 대화에 나오는 호출은 17건 중 일부였습니다. 값 전체가 나온 것은 1건이고 일부만 나온 것이 2건, 복사가 1건입니다. 이름이나 존재 확인(7건)과 파일 복사(6건)를 막을지는 규칙을 어디까지 엄격하게 할지에 달려 있어서
intent.md의 열린 질문으로 남겼습니다.출력 단가가 입력의 5배라는 가격 설명은 맞지만, 제 사용에서는 환산 비용의 출력 비중이 9~13%였고 캐시 읽기가 절반 안팎이었습니다. 앞 대화를 다시 읽는 비용이 큰 구조라, 강의가 말한 "관계없는 일은 새 세션에서"가 단가 낮추기보다 직접적인 절약 수단으로 보입니다. 이 값은 가정이 섞인 추정입니다.
개발 주기의 앞 단계(계획 문서, 훅)는 비어 있었습니다. 저장소 14개 중 계획 문서가 있는 곳은 3개, 프로젝트 훅은 1개입니다. 계획 문서와 훅이 있는 저장소가 점검한 항목 중 가장 적었습니다. 강의의 "시키기 전에 파일로 정한다" 단계가 제 저장소에서는 가장 비어 있었습니다.
계획은 파일에 적어도 실행되지 않았습니다. 3주차 계획 중 실행한 것은 0개입니다. 이번에 하나를 시제품까지 만든 것이 처음으로 움직인 항목입니다. 4주 동안 매번 기억해야 하는 계획은 그대로였습니다.
시행착오
인텐트 문서를 코드 뒤에 적었습니다. 강의 순서(문서, 시험, 구현)와 반대여서 열린 질문 네 개가 구현 뒤에야 나왔습니다.
경계 시험 3개는 구현 뒤에 더해서 실패를 보지 못했습니다. 시험이 제대로 도는지는 확인하지 못했습니다.
막지 못하는 방법(인터프리터와
base64)이 남아 있습니다. 목록 기반 규칙이라 근본적으로 막을 수 없어서, 시험에는 알려진 구멍으로 표시했습니다.차단 17건의 분류는 제가 하나씩 읽고 나눈 값입니다. 다른 사람이 나누면 경계가 달라질 수 있습니다.
3주차 측정 스크립트가 새 세션의 임시 폴더에서 죽어 한 줄을 고친 사본을 썼습니다.
4주차 구간은 1.9일이라 비율이 흔들립니다. 압축 4번, 메모리 쓰기 4번 같은 값은 비교에 쓰지 않았습니다.
이 글을 쓰는 세션도 4주차 구간 로그에 들어 있습니다. 끝 시각을 2026-10-23T13:14:43Z로 고정하고 모든 측정에 같은 값을 썼습니다.
이 측정은 2026년 10월 23일 22시 14분(KST) 기준 ~/.claude/projects의 메인 세션 로그 68개, ~/.claude/settings.json, skills, agents, local-plugins, ~/projects 아래 git 저장소 14개의 추적 파일을 Python과 셸과 git으로 읽은 결과입니다. 서브에이전트 로그, 대화 내용, claude.ai 쪽 설정과 강좌 배지, 훅의 실제 설치와 호출 결과, 응답의 질은 보지 않았습니다. 비용 환산은 가정이 섞인 추정입니다.
도움 받은 글
24기 문과생도AI 4주차 강의 (박정기): API 키와 max_tokens와 지난 대화를 기억하지 못하는 성질, 모델별 가격, 인텐트 문서 여섯 항목, CLAUDE.md와 스킬과 훅의 역할, 평가와 환경별 자율성
4주차 줌 채팅의 오렌지 님 질문: 압축 알림이 뜨면 새 창이 크레딧을 덜 쓰는지에 대한 질문이 Step 7의 출발점이었습니다
24기 문과생도AI 3주차 글 (본인): 측정 스크립트, 다음 주 계획 항목, 훅 18개와
.env0개의 값. 3주차 글에는 달린 댓글이 없었습니다

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

안녕하세요, 뽀짝이예요. 시험을 먼저 쓰고 훅 시제품을 만든 뒤, 지난 도구 호출 22,212개에 다시 넣어 본다는 접근이 단단했어요.
3주차 계획 15개 중 실행으로 판정된 게 없었다는 것, 훅은 18개 그대로인데 .env를 다루는 훅과 permissions.deny는 0개라는 것을 그대로 적으신 점이 좋았어요. 인텐트 문서도 순서를 못 지키고 구현 뒤에 정리했는데, 그 과정에서 열린 질문 네 개가 나왔다고 솔직하게 남기셔서 읽는 사람이 비슷한 함정을 미리 알 수 있어요. 훅을 설치하지 않고 로그와 설정을 읽기만 했다고 범위를 밝혀 둔 점도 믿음이 갔어요.
고롱고롱… 이런 꼼꼼한 기록 보면 기분 좋아져요 ✨