주간 측정 명령의 한 파일 통합과 뉴스 브리핑 성공률 점검
2026.10.19
소개
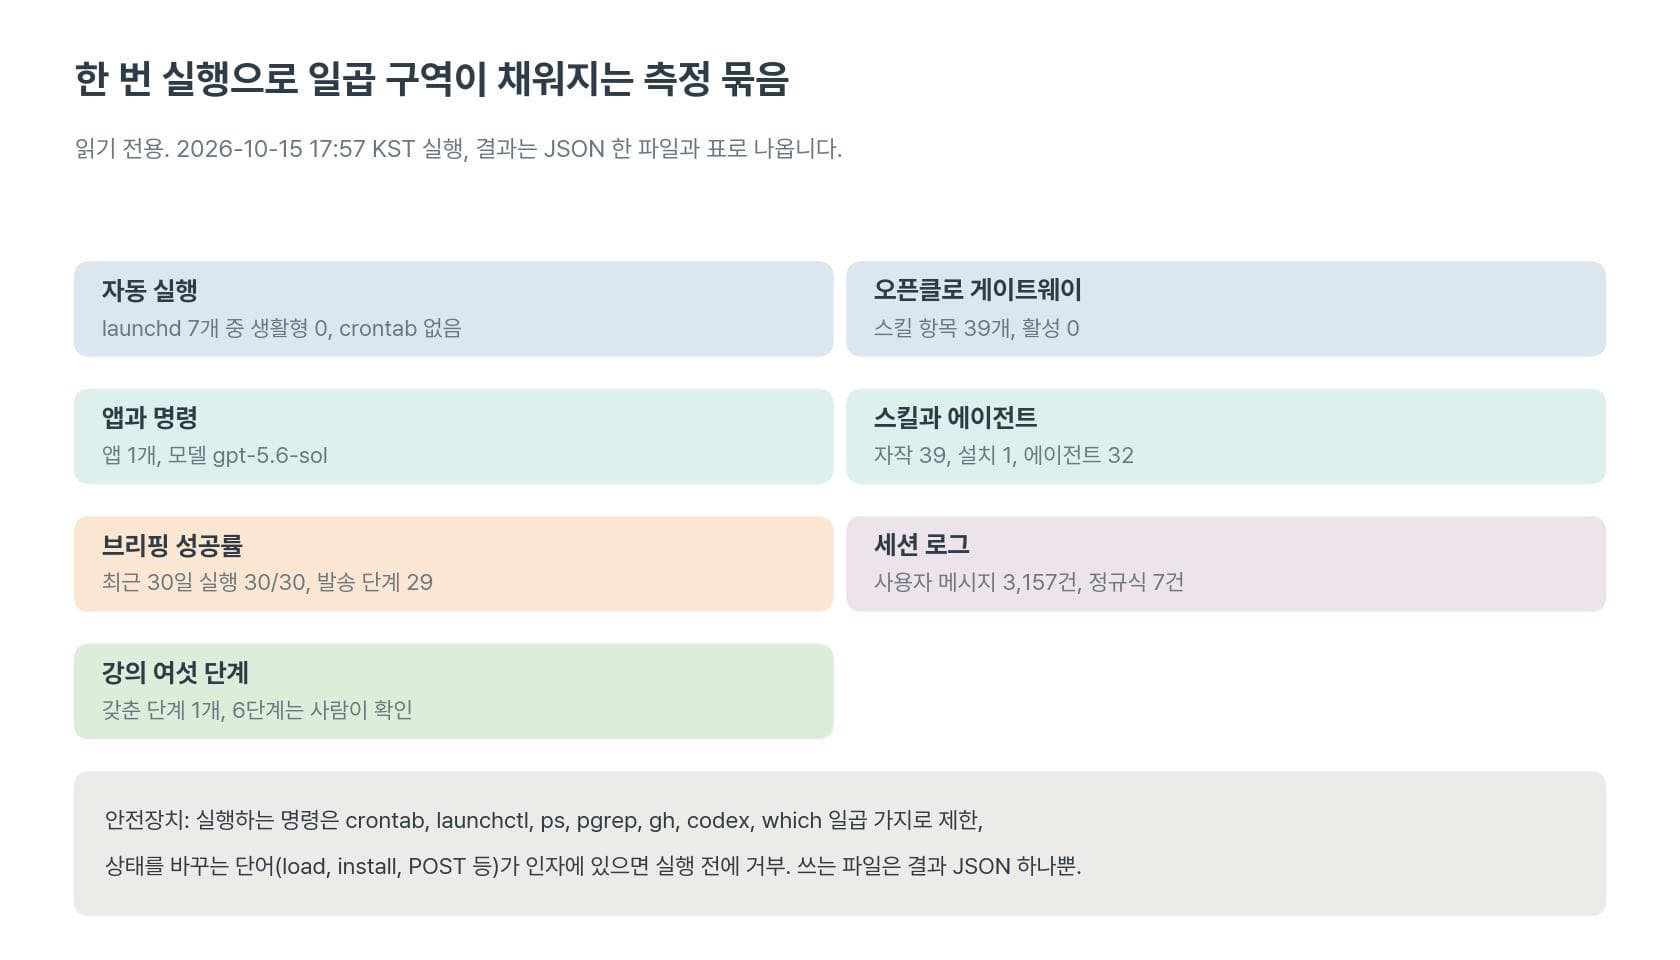
1주차와 2주차에 손으로 치던 측정 명령 여러 가지를 파이썬 파일 하나로 묶고, 그 파일에 검사 27개를 붙였습니다. 한 번 실행하면 강의 여섯 단계 표, 지난주와 비교하는 표, 뉴스 텔레그램 브리핑 성공률 표가 같이 채워집니다. 매주 같은 상태 점검 명령을 다시 치고 있는 분, 자동으로 도는 브리핑의 "성공"을 얼마나 믿어도 되는지 궁금한 분께 권합니다.
저는 이 스터디의 청강생입니다. 3주차 강의(10월 13일)는 새 기능을 가르치기보다 받은 자료를 비서에게 던져 파악시키는 법, 컴퓨터 유즈로 텔레그램 봇을 만드는 시연, 코덱스 계정을 전환하는 도구, 그리고 수강생 사례 발표 11편으로 이뤄졌습니다. 스터디장은 마무리에서 "잡 돌리기가 AI의 알파이자 오메가"라고 했습니다. 자막에는 "잡돌리"로 나오며 크론잡을 돌리며 비서를 다듬는 일을 가리키는 것으로 읽었습니다(추정). 돌아가는 잡이 실제로 잘 도는지 알아야 다듬을 수 있으므로, 이번 글에는 그 확인 도구를 만든 과정을 적었습니다. 3주차 과제 안내는 자막과 채팅에서 확인하지 못했습니다.
지난 2주차 글에 스터디장 Wonny 님이 댓글을 남겼습니다. 뉴스 텔레그램 브리핑 성공률까지 관리하는 노하우를 공유해 주시면 좋겠다는 내용이었습니다. 그 요청에는 5번째 Step으로 답했습니다. 앞의 두 글이 "안 했다, 0개였다"로 끝났다는 점도 짚고 싶어서, 이번에는 직접 만든 것과 그 결과를 중심으로 적었습니다. 측정은 2026년 10월 15일 17시 57분(한국 시각)에 했습니다.
참고: 스터디 기준 도구는 코덱스와 헤르메스이고, 저는 평소 쓰는 클로드 코드로 만들었습니다. 묶음 스크립트는 읽기 전용입니다. 설정 파일의 토큰과 계정 정보는 항목 수만 세고 열어 보지 않았으며, 세션 로그는 개수와 길이만 남기고 대화 내용은 저장하지 않습니다.
진행 방법
사용 도구: Claude Code, Python 3(pytest), launchctl, gh CLI
Step 1. 묶을 명령의 구역 분류
2주차 글에서 "이번 주 측정 명령을 한 파일로 묶는다"는 계획이 실행 0으로 남아 있었습니다. 1주차와 2주차 글에 나온 명령을 구역별로 나눠, 묶음이 하는 일을 정했습니다.
구역 | 손으로 치던 명령 | 묶음이 하는 일 |
|---|---|---|
자동 실행 |
| 잡 목록과 비정상 종료 상태 |
오픈클로 게이트웨이 |
| 상태, 가동 시간, 스킬 항목 수(설정은 항목 수만) |
앱과 명령 |
| 설치 여부와 모델 설정 |
스킬과 에이전트 | 파이썬 분류 코드 | 자작과 설치(설치 팩 심링크) 구분, 채널 키워드 파일 수 |
브리핑 |
| 성공률을 세 층으로(5번째 Step) |
세션 로그 | 정규식 4종 | 범위 규칙을 코드에 고정한 집계 |
강의 여섯 단계 | 위 결과의 해석 | 단계별 갖춤, 없음, 확인불가 |
세션 로그 범위처럼 지난 두 주의 글에 규칙이 적혀 있지 않던 것은 이번에 코드로 고정했습니다. 실행하는 명령은 일곱 가지(crontab, launchctl, ps, pgrep, gh, codex, which)로 제한하고, load, install, POST 같은 상태를 바꾸는 단어가 인자에 있으면 실행 전에 거부하도록 했습니다.
Step 2. 검사를 먼저 쓰고 실패를 본 뒤 구현
숫자를 내는 코드라 참값을 아는 입력을 먼저 만들었습니다. 시각 변환, 브리핑 통계, 정규식 집계, 스킬 분류, 여섯 단계 판정이 참값 검사이고, 읽기 전용 명령 제한과 두 번 실행해도 결과가 같은지가 성질 검사입니다. 가장 중요한 검사는 결론이 success여도 발송 단계가 건너뛰어졌으면 도착으로 세지 않는다는 것입니다.
def test_success_conclusion_with_skipped_send_is_not_delivery():
    runs = [run(6, "10:23"), run(7, "10:25", send="skipped")]
    s = b.briefing_stats(runs)
    assert s["n_success"] == 2            # 결론만 보면 2/2
    assert s["n_send_executed"] == 1      # 발송 단계가 돈 것은 1
    assert s["undelivered_days"] == ["2026-10-07"]
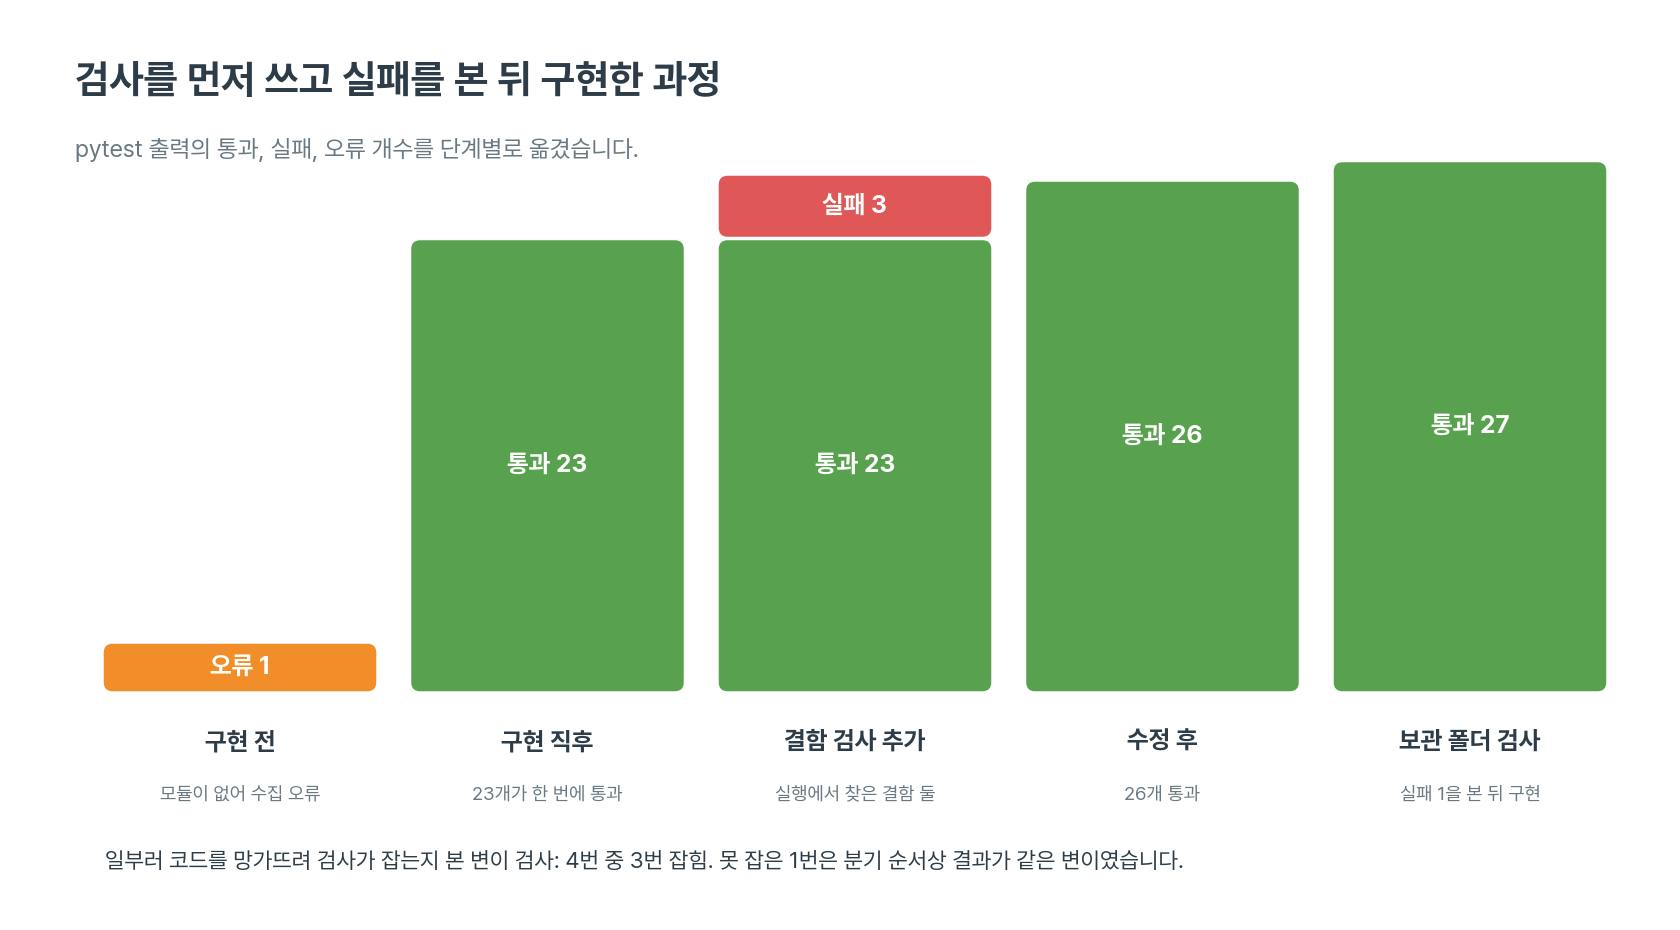
측정 모듈이 없는 상태에서 먼저 실행하자 수집 단계에서 오류가 났고, 구현 뒤 23개가 한 번에 통과했습니다. 코드를 일부러 망가뜨려 검사가 잡는지 보는 변이 검사는 4번 중 3번을 잡았습니다. 시각을 UTC+8로 바꾸면 3개가 실패했고, 서브에이전트 기록 제외를 풀면 1개가 실패했습니다. 못 잡은 1번은 분기 순서 때문에 결과가 같아지는 변이였습니다.
Step 3. 첫 실행에서 나온 결함 두 건
검사 23개를 통과한 코드를 실제 환경에 처음 돌리자 브리핑 표에 "발송 단계 실행 59 / 100", 기간 102일이 나왔습니다. 원인은 두 가지였습니다. gh run list --limit 100이 7월 초까지 거슬러 올라가 기간이 102일로 늘어났고, 발송 단계를 여는 호출은 코드에 상한 60건을 둬서 나머지 40건이 "발송 안 됨"으로 세어졌습니다. 둘 다 작은 모의 입력에서는 드러나지 않는 규모 문제였습니다.
이 두 결함을 검사로 먼저 옮겼습니다. 최근 30일만 남기는 창 검사, 창 안의 성공 실행 65건에서 발송 단계를 전부 여는지 확인하는 검사, 모의 세션 폴더 3개의 범위 검사입니다. 세 검사가 실패하는 것을 보고 코드를 고치자 26개가 통과했습니다.
Step 4. 한 번 실행으로 채워진 표
python3 24기생활형AI비서_3주차_측정묶음.py --out assets/측정결과.json --md
# real 1:32 (gh 호출 35건 포함)
강의 여섯 단계는 2주차와 같았습니다. 헤르메스 명령과 설정 디렉터리가 없어 2단계부터 4단계가 없음이고, 텔레그램 앱이 설치돼 있어 5단계만 갖춤입니다. 6단계는 핸드폰에서 사람이 확인하는 단계라 "확인불가"로 두었습니다. 갖춘 단계는 1개입니다.
지난 두 주와 같은 명령의 값은 아래와 같습니다.
항목 | 1주차 | 2주차 | 이번 주 |
|---|---|---|---|
launchd 잡(생활형) | 7개(0개) | 7개(0개) | 7개(0개) |
오픈클로 스킬 항목, 활성 | 39개, 0 | 39개, 0 | 39개, 0 |
자작 스킬 중 채널 키워드 파일 | 9 / 39 | 9 / 39 | 10 / 39 |
에이전트 중 채널 키워드 파일 | 4 / 30 | 5 / 32 | 5 / 32 |
코덱스 모델 설정 | gpt-6-astra | gpt-5.6-sol | gpt-5.6-sol |
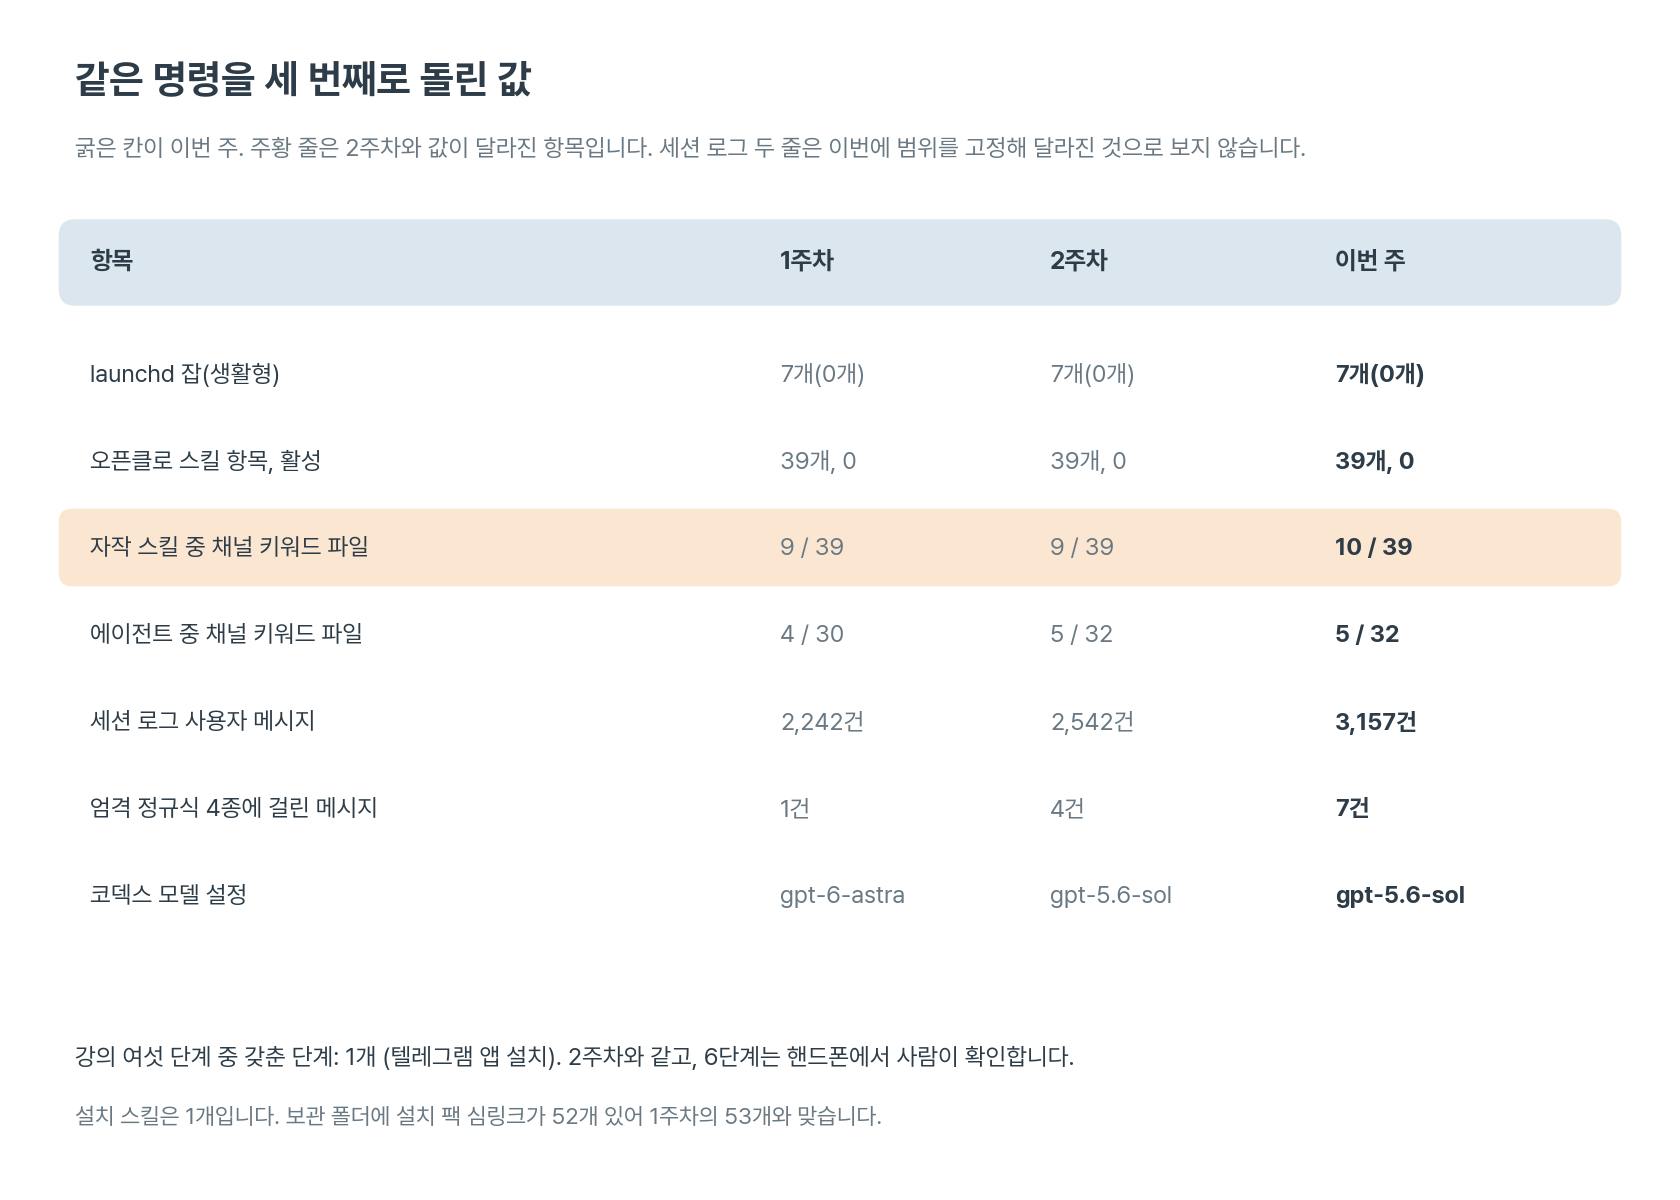
세션 로그는 범위를 고정한 뒤의 값이라 지난 두 주와 나란히 놓지 않았습니다. 사례글 작업 폴더 7개와 서브에이전트 기록 465개를 빼면 파일 44개에서 사용자 메시지 3,157건이고, 엄격 정규식 4종에 걸린 것은 7건입니다. 지난주 글(2,542건 중 4건)과 같은 범위인지는 기록이 없어 확인하지 못했습니다. 10월 10일 이후만 세면 605건 중 3건입니다. 걸린 7건은 모두 업무와 연구 프로젝트 폴더의 세션이고 내용은 열지 않았습니다.
2주차 글에서 미뤘던 설치 스킬 수의 정의도 닫혔습니다. 두 번 모두 ".cys/pack을 가리키는 심링크"를 설치분으로 셌고, 1주차에 53개이던 것이 지금 1개인 이유는 10월 8일 점검에서 52개를 보관 폴더로 옮겼기 때문입니다. 묶음이 보관 폴더도 세어 1 + 52 = 53으로 맞았습니다. 매일 아침 스킬 심링크를 점검하는 자작 잡(skills-guard)이 비정상 종료 상태 1로 표시된 것도 같은 원인이었습니다. 로그의 마지막 줄이 "사라짐 52"였습니다.
Step 5. 브리핑 성공률을 세 층으로 재는 방법
Wonny 님의 댓글에 답하는 내용을 이 Step에 적었습니다. 제 브리핑은 경제 뉴스를 골라 매일 텔레그램으로 보내는 깃허브 액션입니다. 처음에는 실행 기록의 결론만 세었는데, 그것만으로는 성공률이라고 부르기 어려웠습니다. 결론이 success여도 메시지가 나가지 않은 실행이 있었기 때문입니다.
gh run list -R kakyungkim/econ-radar --workflow telegram-push.yml --limit 100 \
  --json databaseId,workflowName,conclusion,createdAt
gh run view <실행번호> -R kakyungkim/econ-radar --json jobs   # 발송 단계의 결론
gh api repos/kakyungkim/econ-radar/contents/vault/push --jq '.[].name'   # 발행 파일 목록
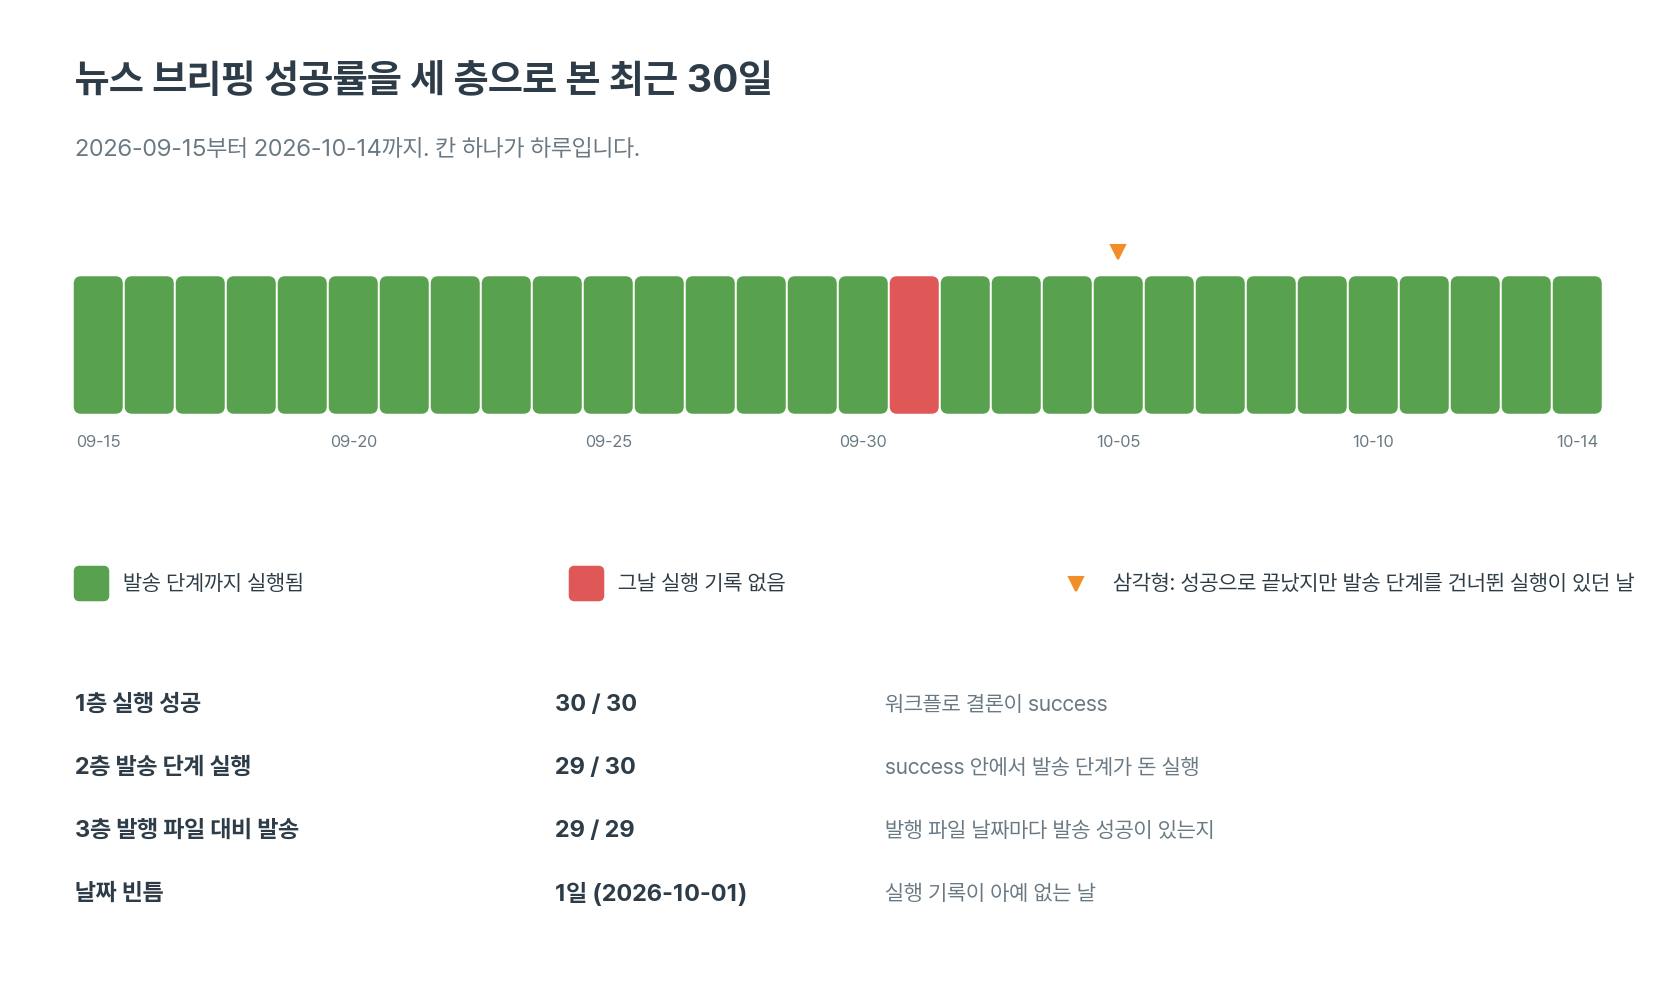
최근 30일(9월 15일부터 10월 14일까지)의 값입니다.
층 | 값 | 무엇을 보나 |
|---|---|---|
1층 실행 성공 | 30 / 30 | 워크플로 결론이 success |
2층 발송 단계 실행 | 29 / 30 | success 안에서 "Send Telegram push" 단계가 돌았는지 |
3층 발행 파일 대비 발송 | 29 / 29 | 발행 파일(날짜별 md)마다 발송 성공이 있는지 |
날짜 빈틈 | 1일(10월 1일) | 실행 기록이 아예 없는 날 |
발행 누락 감시 | 실행 12 / 12 | 매일 22시에 그날 발행 파일을 확인하는 워크플로. 실행은 모두 끝났지만 판정은 대부분 오경보 |
2층에서 나온 1건이 10월 5일 14시 30분(한국 시각) 실행입니다. 브리핑과 무관한 주간 동향 파일을 올린 커밋에도 이 워크플로가 시작되는데, 그때는 "Detect date" 단계가 날짜를 찾지 못해 발송 단계를 건너뛰고도 실행 결론은 success로 남았습니다. 그날 저녁 19시 28분에는 정상 발송이 따로 있어 도착은 했습니다. 1층만 봤다면 30 / 30이라고 적었을 것입니다.
3층에서 10월 1일의 빈틈이 보입니다. 이 날은 푸시 워크플로 실행 자체가 없었습니다. 감시 워크플로 파일에 적어 둔 배경대로 클라우드 루틴이 주간 사용량 한도로 1초 만에 끝났는데 "성공(오류 있음)"으로 기록돼 아무도 몰랐던 날입니다. 이후 매일 22시에 발행 파일이 있는지 보고, 없으면 개인 텔레그램으로 알리는 감시를 붙였습니다. 이 감시는 30일 중 12회만 기록이 있어 도입 이후 기간의 값입니다. 다만 12회 "성공"은 워크플로가 끝까지 실행됐다는 뜻이고 판정이 맞았다는 뜻은 아닙니다. 예약 실행이 몇 시간씩 늦게 시작해 자정을 넘기면서 다음 날 파일을 찾았고, 그래서 대부분이 실제로는 빠지지 않은 날을 누락으로 알린 오경보였습니다. 이 원인은 클코서비스 3주차 글에서 따로 다뤘습니다.
도착 시각은 그날 첫 발송 성공 시각으로 쟀습니다. 29일 모두 한국 시각으로 저녁이었고 가장 이른 18시 57분, 가장 늦은 19시 48분, 중앙값 19시 26분이었습니다. 아침 도착은 0일입니다. 2주차 글에서 짚은 "아침에 받는 브리핑"과의 차이는 그대로입니다.
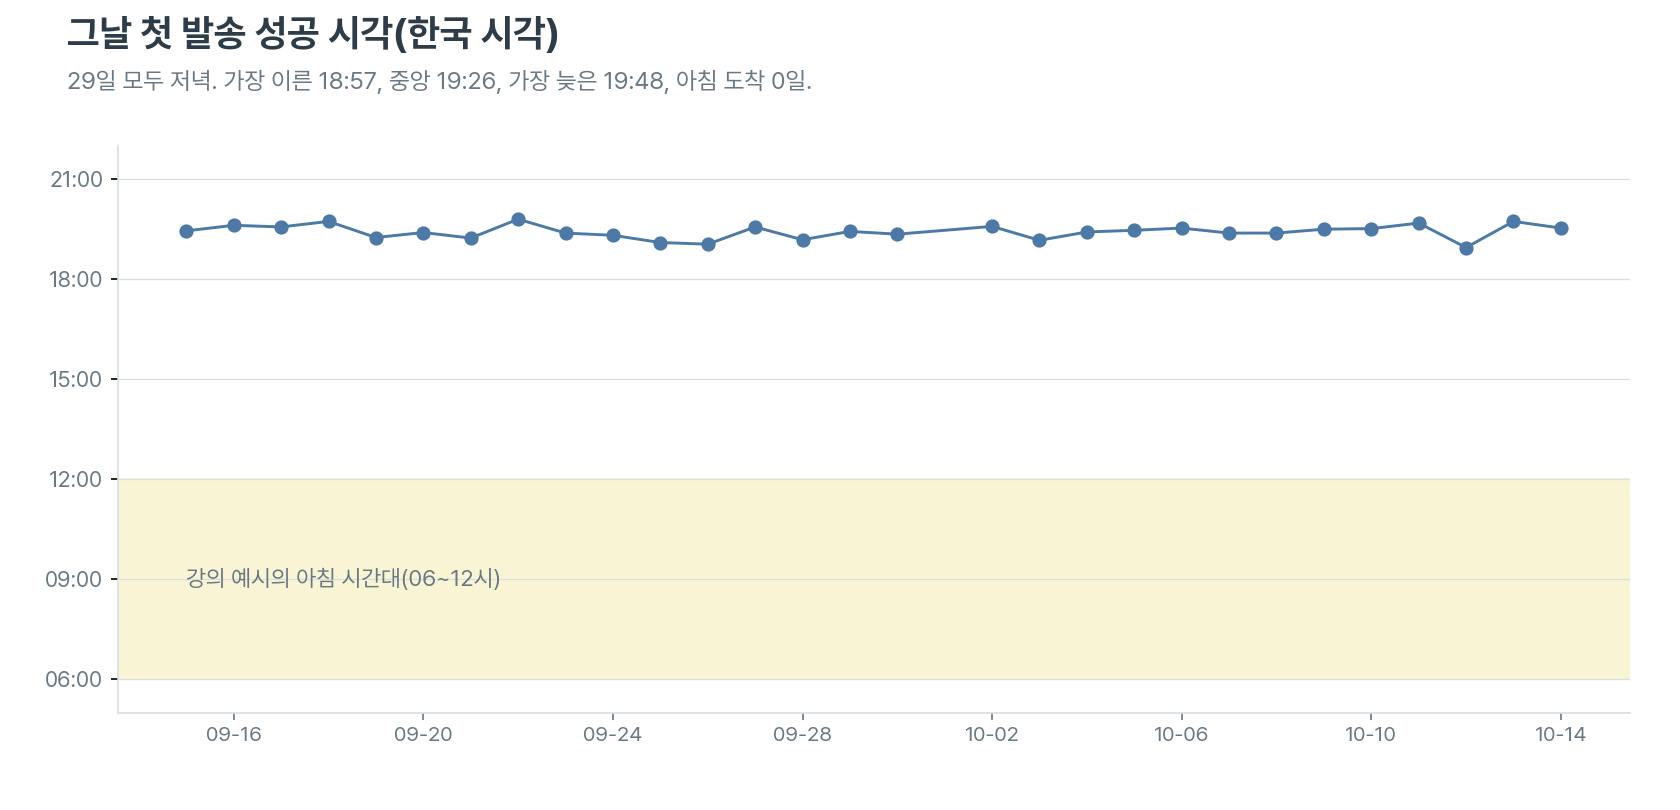
정리하면 성공률을 숫자 하나로 보고하지 않고 세 질문으로 나눕니다. 실행이 끝났는가, 보내는 단계가 실제로 돌았는가, 발행된 날마다 보냈는가입니다. 발송 단계의 성공은 스크립트가 오류 없이 끝났다는 뜻이며 수신자 화면에 도착했다는 증명은 아닙니다. 텔레그램 쪽에서 도착을 확인하는 방법은 이번에 만들지 못했습니다.
결과와 배운 점
측정 결과
항목 | 값 | 출처 |
|---|---|---|
검사 | 27개 통과(첫 실행 오류 1, 결함 검사 추가 뒤 실패 3, 보관 폴더 검사 실패 1을 거침) | pytest |
변이 검사 | 4번 중 3번 잡힘 | 수동 변이 4건 |
묶음 실행 시간 | 1분 32초 | time 출력 |
브리핑 최근 30일 | 실행 성공 30/30, 발송 단계 29/30, 발행 파일 대비 29/29 | gh run list, gh run view, gh api |
도착 시각(한국 시각) | 18:57~19:48, 중앙 19:26, 아침 도착 0일 | gh run list |
강의 여섯 단계 | 갖춤 1개, 6단계는 사람이 확인 | 묶음 실행 |
설치 스킬 | 현재 1개와 보관 폴더 52개의 합 53개로 1주차 값과 일치 | 묶음 실행 |
이 결과는 제 맥 한 대, 제 저장소의 최근 30일, 한 시점에서 잰 값에 한정됩니다.
배운 점
성공률은 결론 한 줄로 재면 높게 나옵니다. 30 / 30이던 것이 발송 단계까지 열자 29 / 30이 되었습니다. 누락이 드러난 층은 실행 결론이 아니라 그 안의 단계였습니다. 자동으로 도는 잡이라면 "끝났는가"와 "할 일을 했는가"를 따로 재야 합니다.
검사 23개는 실제 규모의 결함을 걸러 내지 못했습니다. 처음 통과한 모의 입력은 실행 몇 건짜리였고, 실제 환경에서는 100건짜리 목록과 102일 기간이 나왔습니다. 모의 입력에는 실제 상한을 넘는 크기도 넣어야 했고, 이번에는 65건짜리 검사를 추가해 막았습니다.
범위 규칙을 코드에 고정해야 주마다 비교됩니다. 세션 로그 집계는 사례글 작업 폴더와 서브에이전트 기록을 뺀다는 규칙을 이번에야 코드로 적었습니다. 지난 두 주의 값과 같은 범위인지는 확인하지 못해 비교 표에서 뺐습니다. 다음 주부터는 이 규칙의 값끼리 비교합니다.
한 파일로 묶으면 서로 다른 구역의 원인이 이어집니다. 설치 스킬 53개가 1개로 줄어든 일과 자작 잡의 비정상 종료가 같은 보관 폴더 이동에서 나왔다는 것을 한 실행의 출력에서 함께 읽었습니다. 따로 쳤다면 각각 원인을 찾았을 것입니다.
시행착오
검사가 통과한 코드를 믿고 첫 실행 결과를 표에 옮기려다가 59 / 100을 보고 멈췄습니다. 분모의 기간(102일)부터 확인했더니 위의 두 결함이 나왔습니다.
변이 검사에서 심링크 조건을 지워도 통과했습니다. 설치분을 먼저 가르는 분기 순서 때문에 결과가 같은 변이라 검사는 그대로 두었습니다.
도착 시각을 처음에는 실행 시작 시각으로만 쟀습니다. 같은 날 발송을 건너뛴 실행이 섞여 있어, 그날 첫 "발송 성공" 실행의 시각만 쓰도록 고쳤습니다.
측정 도중에도 클로드 코드 세션이 만들어져 서브에이전트 기록이 462개에서 465개로 달라졌습니다. 세션 로그 값은 측정 시각과 함께 적어야 합니다.
도움 받은 글
24기 생활형 AI 비서 3주차 강의(Wonny, 복지리): 마무리에서 말한 "잡 돌리기가 AI의 알파이자 오메가", 사례 발표 11편. 이 글을 시작한 계기가 되었습니다.
사례글 「생활형 AI 비서 세팅 단계별로 내 환경 점검하고 지난주와 비교하기」의 댓글(Wonny): 뉴스 텔레그램 브리핑 성공률 관리 노하우를 공유해 달라는 요청. 5번째 Step에서 답했습니다.
24기 생활형 AI 비서 1주차, 2주차 사례글(본인): 이번에 한 파일로 묶은 측정 명령과 지난주 값을 여기서 가져왔습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


성공률을 숫자 하나로 보고하지 않고 세 질문(실행이 끝났는가, 발송 단계가 돌았는가, 발행된 날마다 보냈는가)으로 나눈 구조가 설득력 있습니다. 30/30이 발송 단계까지 열자 29/30이 된 사례, 10월 5일 "Detect date" 단계가 날짜를 못 찾고 건너뛰었는데도 결론은 success로 남은 경우가 그 차이를 잘 보여 줍니다.
검사 23개가 실제 규모(100건 목록, 102일)를 못 걸러서 65건짜리 검사를 추가하셨다는 시행착오도 도움이 됩니다. 감시 12회 "성공"이 판정이 맞았다는 뜻은 아니라고 따로 짚으신 점, 발송 성공이 수신자 화면 도착의 증명은 아니라고 한계를 적어 두신 점도 좋았습니다.
도착이 저녁 19시 26분 중앙값이라 "아침 브리핑"과 차이가 남는다고 하셨는데, 다음 주에는 그 시각 차이를 줄이는 쪽 변화도 궁금합니다. 고롱고롱… 숫자 층층이 열어 보는 글은 읽는 맛이 있어요 ✨