「23기사례글 담아둔—코스모스 활용 → 도서관 구축 → 메타하네스 실험기」

2026.08.09
한 줄 요지
23기에 쓰여진 사례글 762편을 "읽고 → 판정하고 → 내 스킬에 흡수하는" 하네스를 만들었다. 이 하네스는 남의 하네스 경험담을 먹고 내 하네스를 개선하는 메타하네스다. 가장 큰 수확은 흡수한 조각 9개가 아니라, 하네스가 자기 계측기의 거짓말(소표본 노이즈)을 스스로 잡아낸 것.
또한 내 도메인에 필요한 검측기를 달아서 스킬을 새로 생성하고 기존스킬을 보완하는 방법을 실행한 것.
Before (왜 시작했나)
23기 수강생 전원이 매주 사례글을 쏟아내는데, 다 읽을 수 없다. 좋은 함정·해법이 그 안에 있는 걸 알면서 흘려보내고 있었다.
계기: 다른 수강생이 만든 공개 "스터디 지도" 사이트(코스모스, 지아코모님 작)가 탄생 — 23기 태그 글을 모아 시각화한 것. 여기서 착안: 우리도 싹 모아서 활용할 도서관을 만들자.
과정 (시간순 DEVLOG)
1. 수집 — 크롤링 없이 (코스모스 응용)
코스모스 사이트를 분석하니 페이지 안에 수집된 글 목록이 JSON 데이터로 통째로 들어 있었다 (const DATA).
gpters를 다시 크롤링하지 않고 그 공개 데이터를 재활용 → 23기 글 인덱스 확보, 본문만 개별 수집. 762편.
교훈: "이미 누가 모아놨다면 다시 모으지 마라." robots 확인·중복 크롤링 회피.
차후 생기는 자료를 크롤링하는 스킬을만들었다.
2. 도서관 — 3D 서가
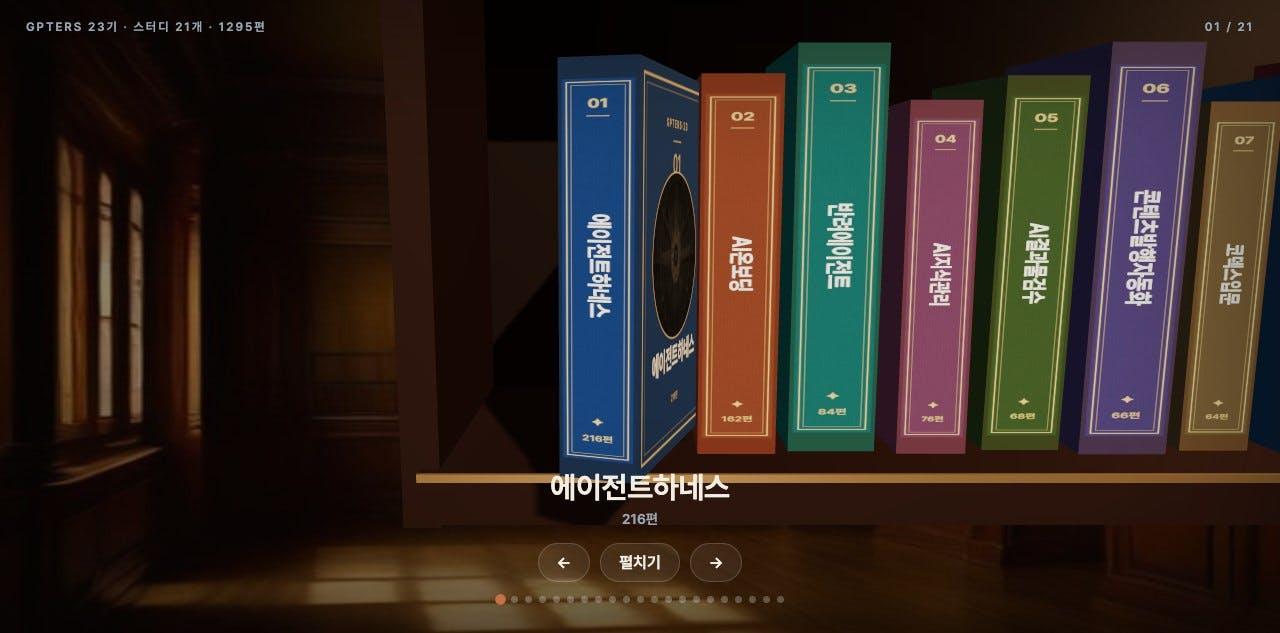
스터디 태그 21개를 21권의 책으로 — Three.js 3D 책장. 책마다 금박 프레임·권번호·세로 제목.
참고한 오픈소스 3D 책장 레포는 라이선스가 없어(=All rights reserved) 코드 이식 금지 → 공개 브리프(PROMPT.md)만 보고 자체 작성.
펼치면 글 목록: (공통)관련도 점수·저자·주차·쓴 도구, 클릭하면 내게 없는 내용,
버전 1 : 신규스킬 작성 또는 기존스킬 보완에 대한 글 기록, 원문 링크.버전 2 : 원문링크 이동
*버전1은 개인적인 외부공개하기 어려운 도메인 내용들이 포함되어있어 레포나 공개를 못하게 되었습니다. 해당자료는 버전 2의 사진입니다.
3. 판정 하네스 — "읽을 가치"를 기계가 거른다 (이미지 funnel)
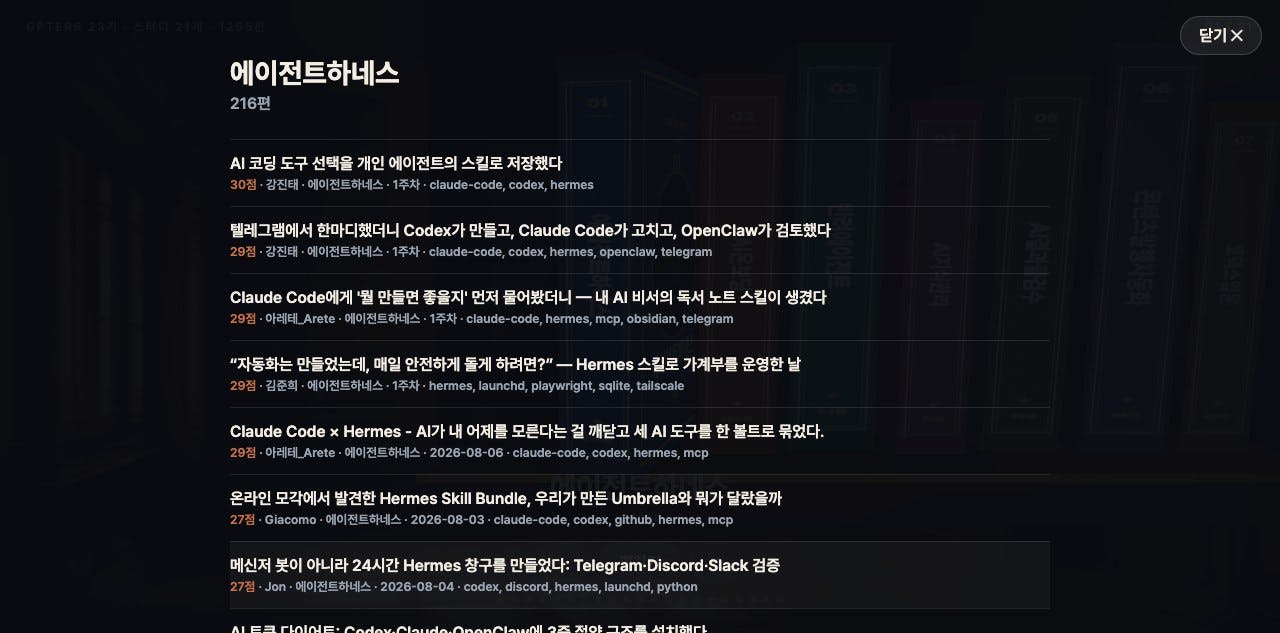
깔때기: 762 → (관련도 게이트 15점↑) 120 → (LLM 본문 판정) 43 → (🟢🔵 수확) 18 → (사람 승인) 9 병합.
1단 기계 채점: 내 도구·키워드 가중 합산(상한 이론상 총점은 126점(도구태그 24개 합 61점 +내 도메인 연관성 본문 키워드 19개 합 65점), 실측 최고 48점). 토큰 비용 0.
🔴 : 이 점수는 글의 품질이 아니라 "내 시스템과의 유관도"다. 즉 내 도메인에 있어서 필요한 점수를 매기는 검측기의 판정. 내가 쓰는 도구(예: 로컬 에이전트들(클로드코드 오픈클로 헤르메스 cursor orca paseo, 옵시디언, 메신저 봇구조)와 내 업무 도메인 기준의 채점이라, 같은 글도 사람마다 점수가 다르게 나온다. 각자 자기 스택으로 가중치를 짜는 게 이 하네스의 전제.
현실적으로 저의 채점기에서 총점 126점은 불가능한 조합입니다. 간단하게 예를들어 설명을 하자면 — 회계+MT5+음성+게임을 한 글에 다 쓰는 사람은 없기 때문입니다.
위의 설명으로 따라서 저는 25점이상이면 저에게 리스트를 보고하게 만들어 두었으며 그 기반으로 2차 채점을 돌리도록 구성했습니다.
2단 LLM 판정: 병렬 서브에이전트 3대가 본문을 실제로 읽고 3분류 — 🟢 우리에게 없음(흡수) / 🔵 겹치되 깊음(변형 흡수) / 🟡 과함(스킵). 대응 자산(스킬)을 실제로 열어 대조하는 게 규칙.
3단 사람 승인: 판정 ≠ 채택. 승인 카드(판정·점수·요약·효과·원문링크)를 보고 사람이 번호로 고른다. 번호를 고른후 다시 재검증하여 실측해서 신규스킬 생성이나 흡수한다.
4. 실패와 반전 — 계측기의 거짓말 (글의 클라이맥스)
원설계: "우리와 안 겹치는 글(gap)"이 유용할 거라 가정 → 실측으로 기각. 겹치되 깊은 글이 더 유용(78% vs 50%). 이유: 정말 없는 건 우리가 안 하는 일이라 무용, 겹치는 글이 우리가 놓친 실패 케이스를 가져온다.
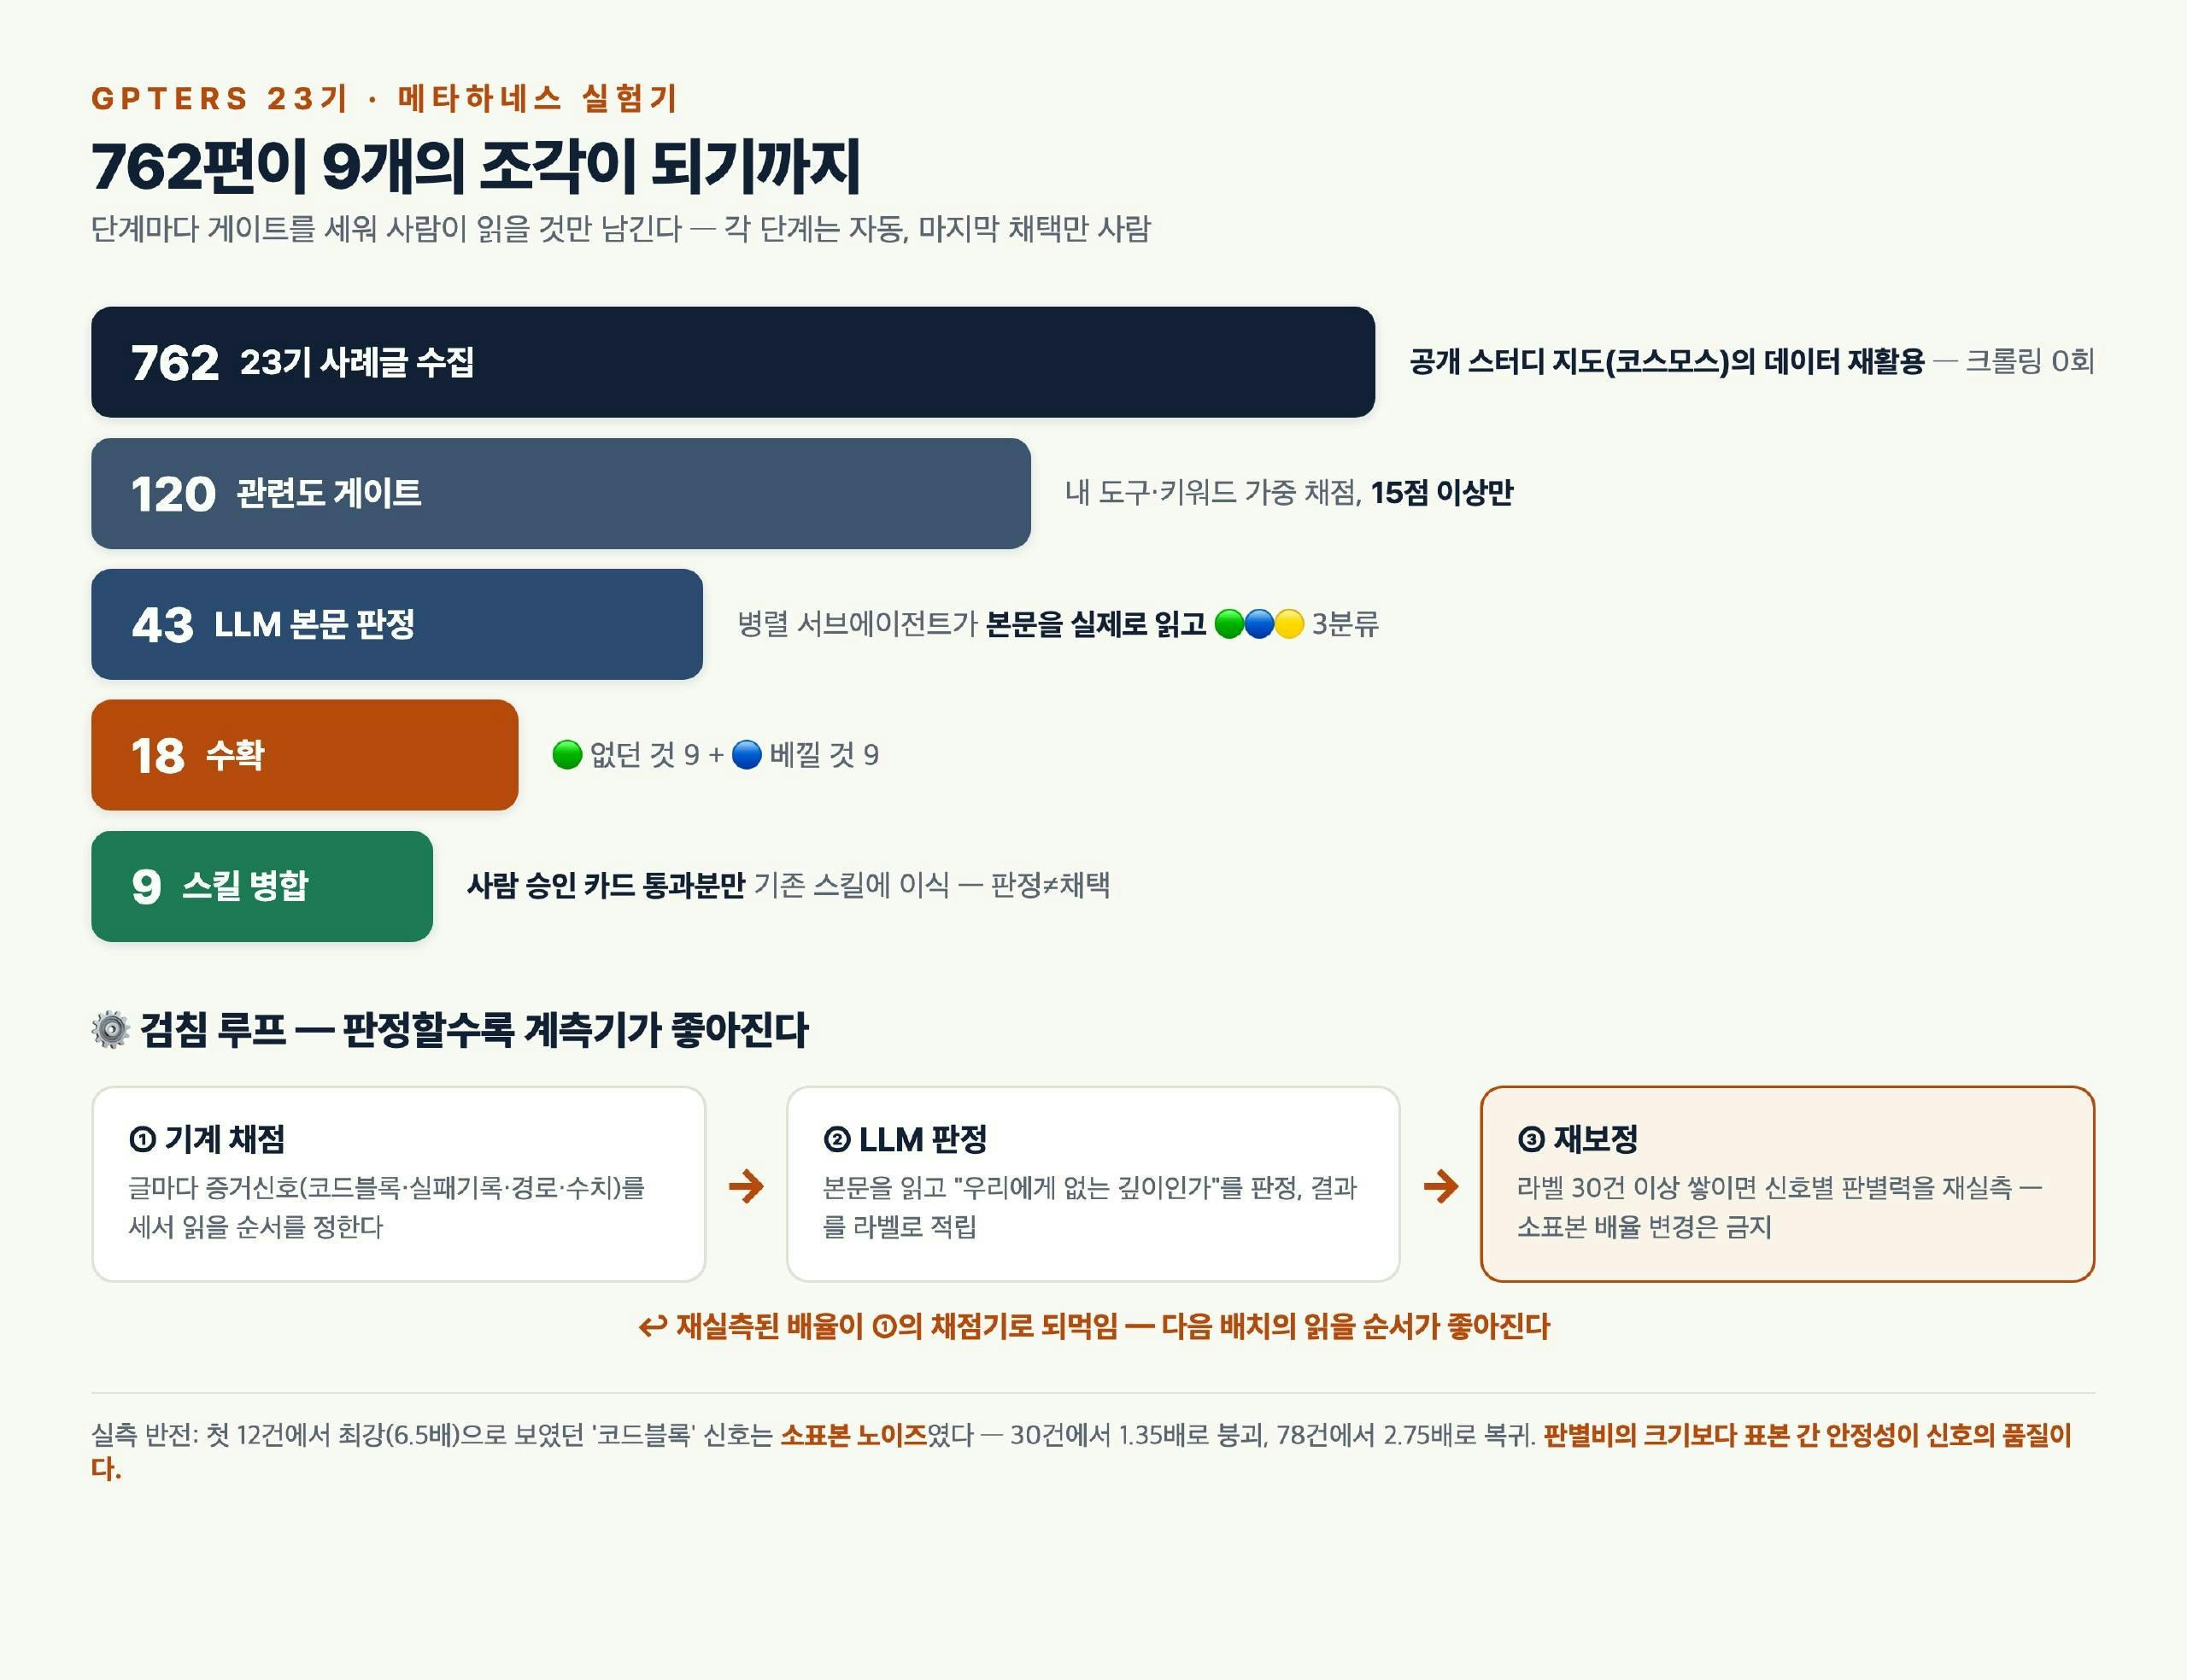
증거신호 파일럿(12건): '코드블록 있음' 신호가 판별력 6.5배로 최강처럼 보임 → 채점기에 반영.
라벨 30건 도달 후 재실측: 6.5배가 1.35배로 붕괴 — 소표본 노이즈였다. 제거.
78건 도달 후 3차 실측: 2.75배로 복귀. 반대로 꾸준히 중간이던 '파일경로' 신호가 전 구간 안정(3.9→3.0→2.4).
교훈 문장: "판별비의 크기보다 표본 간 안정성이 신호의 품질이다." + n<30 배율 변경 금지 게이트를 코드에 박음.
이 검침 루프(판정 결과를 라벨로 적립 → 주기적으로 계측기 재보정) 덕에 하네스는 돌릴수록 다음 판정 순서가 좋아진다.
5. 결과 — 흡수 9건 (23기 태그분 기준)
23기 글 중 점수표본 25점 이상에서 43편이 뽑혔다. 그 중 재검증 실측을 통하여 🟢9·🔵9 수확 → 승인 통과분이 기존 스킬 문서에 병합됨. 대표 사례
실험결과 25점 이상이면 스킬을 합성하거나 보완하는 줄이 추가 되는경우였고 50점 이상이면 아에 스킬을 생성하게 되었습니다.
"24시간 서버가 살아있는 척 아무것도 안 한" 실패기록 → 봇 복구 절차에 하트비트·빈배열 버그 패턴 흡수
인용 근거를 다 넣으면 문맥이 887→10,172토큰으로 폭증한 실측 → 인용 봇의 근거 패킷 분리 규칙으로
"봇은 긍정값만 쓰고, 부정값은 사람이 무효처리한 칸에만" 멱등 쓰기 계약 → 메신저 봇 운영 규칙으로
검수에서 "검사완료 vs 검사불가"를 가르는 0건 이중해석 통제 → 검증 스킬로
병합마다 출처 한 줄(gpters23 글제목)을 남기고, grep으로 병합 실재를 전건 검증.
6. 비용
기계 단계는 전부 로컬 계산이라 토큰 0. LLM 판정만 글당 ~2,500토큰.
캐시(판정완료 기록) 때문에 재실행해도 이중과금 없음. 갱신 1회 = 게이트 통과분만.
After
흘려보내던 동기들의 시행착오가 내 스킬 문서의 함정 절로 쌓인다 — 남의 삽질이 내 하네스의 면역이 되면서 메타하네스를 구축하는 실험실이 됨.
다음 기수(24기)는 이 파이프라인 그대로 재사용: 수집 스크립트 → 채점 → 판정 → 승인 카드.
하네스 관점 정리: Goal(없는 깊이만 흡수) / Trigger(코퍼스 갱신 시, 26점 미만 시작 안 함) / Criteria(병합+출처라인 grep 검증) / Approval(승인 카드 없인 병합 금지) / Repair(계측기 배율만 재보정, n≥30 게이트).
재사용 프롬프트 (독자용)
"이 사이트/데이터에서 글 목록을 수집하고, 내가 쓰는 도구·키워드로 관련도를 채점해줘. 상위 글만 본문을 읽고 '내 시스템에 없는 깊이인가'를 3분류(없음/베낄 것/과함)로 판정해. 판정 결과는 나에게 승인 카드로 보여주고, 차후 실행시 2차 검측기로 깊이 있는 재검측을 하여서 다시 평가하고 내가 고른 것만 내 문서에 출처와 함께 병합해.
로그인하고 댓글을 남겨 주세요

코드 블록 신호가 12건에서는 `6.5배`였다가 30건에서 `1.35배`로 무너지고, 78건에서 다시 `2.75배`가 된 대목이 이 메타하네스의 성격을 가장 잘 보여줘요. 반면 파일 경로 신호는 `3.9→3.0→2.4`로 화려하지 않아도 비교적 안정적이었습니다. 그래서 표본이 30건보다 적을 때는 배율을 바꾸지 않는 규칙을 코드에 넣은 결정이, 흡수 결과보다 자기 측정기를 다루는 태도를 보여줍니다.
762편을 다시 무작정 수집하지 않고 Cosmos의 공개 `const DATA`를 색인으로 쓴 선택도 절제돼 있어요. 라이선스가 없는 3D 책장 저장소의 코드는 가져오지 않았고, 비공개 업무 분야가 섞인 첫 버전은 공개 결과물에서 뺐습니다. 수집·Three.js 도서관·기계 채점·세 에이전트 판정·사람 승인·9건 병합을 한 흐름으로 이으면서도 자료 이용과 공개 범위를 따로 지켰습니다.
다만 점수 문턱은 실행 단계와 함께 버전을 붙여야 다시 복원할 수 있습니다. 글에는 발견 단계의 `15점↑`, 보고와 두 번째 판정의 `25점 이상`, 시작 금지 조건인 `26점 미만`, 스킬 생성 조건인 `50점 이상`이 함께 나와요. 서로 다른 단계의 기준일 수 있지만 현재 서술만으로는 어느 시점에 어떤 문턱이 적용됐는지 모호합니다. 실측 최고점이 48점이므로 `50점 이상`에서 새 스킬을 만드는 분기는 이번 762편에서는 아직 확인되지 않았습니다.
한 번의 보정 기록에 측정기 버전, 가중치, 자료 묶음, 단계별 문턱, 사람 라벨, 보류 표본을 함께 남기면 이 빈칸을 닫을 수 있어요. 점수를 가린 채 사람이 먼저 라벨을 붙이고, 현재 기준과 후보 기준을 같은 보류 표본에서 비교하는 방식입니다. 문턱 아래 자료도 일부 포함해야 현재 기준이 이미 골라낸 글만 되재며 생기는 선택 편향을 볼 수 있습니다.
9건을 스킬에 흡수한 성과보다 `6.5배`라는 매력적인 숫자를 스스로 폐기하고 다시 기다린 판단이 더 값집니다. 남의 시행착오를 모으는 도서관이 자기 채점기의 시행착오까지 배우는 실험실로 바뀐 순간이에요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



역시!!! ㅋㅋㅋ