웹사이트 크롤링 > make 이용해 노션 DB에 자동 요약/수집 과정

2025.02.05
소개
읽고 싶은 해외 뉴스레터를 자동 요약/수집 하고 싶었습니다.
Justin Jackson 웹사이트 (https://justinjackson.ca/articles)
Transistor.fm의 공동 창업자로서의 실전 경험 공유
작은 팀으로 수익성 있는 회사 만들기에 초점
지속 가능한 비즈니스 성장에 대한 현실적인 접근
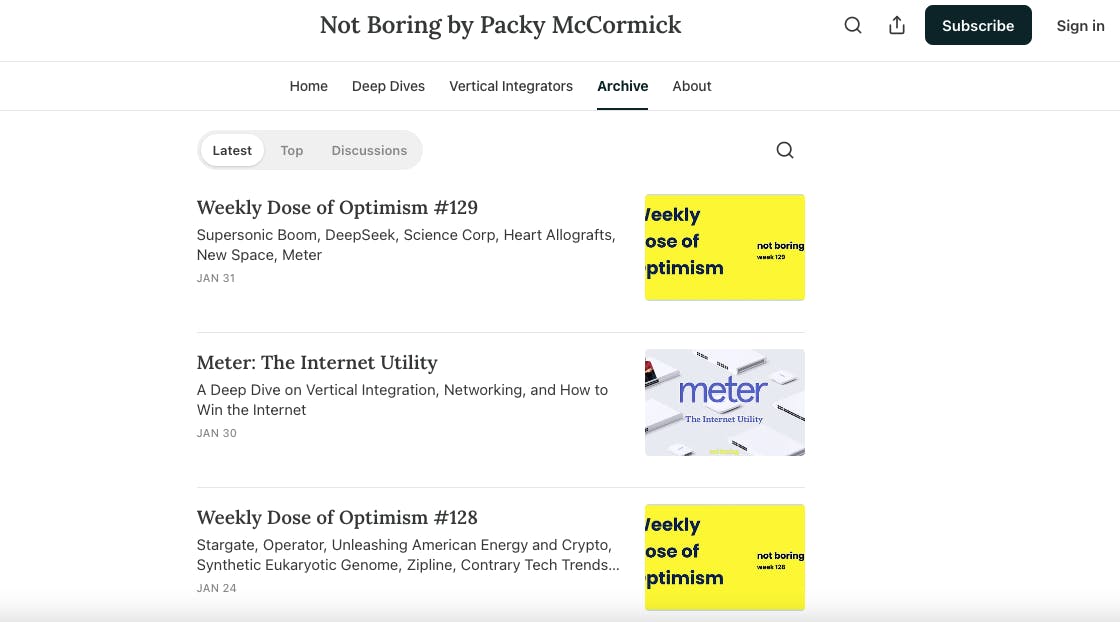
Not Boring 웹사이트 (https://www.notboring.co/archive)
Packy McCormick이라는 개인이 운영
테크/비즈니스 분석 중심이지만 Web3, 이커머스, 스타트업을 연결하는 독특한 시각
재치있는 문체와 깊이있는 분석의 조합
RSS 콘텐츠를 받아오는 형식으로도 make 연결이 가능하나, 모듈을 만들 때 RSS url주소가 있어야 합니다.
주소를 얻으려면 RSS사이트(Feedly, Feeder 등)에서 유료 플랜을 사용해야 하기에-
계획을 변경해서 첫 시작을 웹사이트를 크롤링 하기! 로 했습니다.
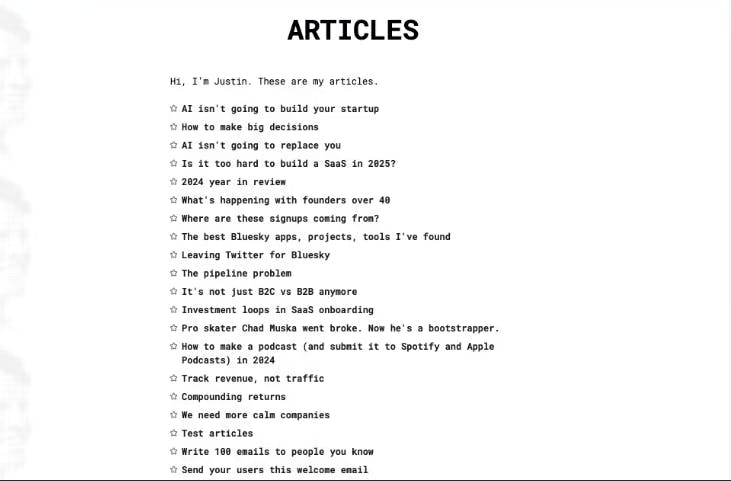
1번 주소의 웹페이지입니다.
각 아티클의 제목이 리스트업 되어있습니다. <리스트 페이지>
2번 주소의 웹페이지 <리스트 페이지>
웹페이지의 특성 분석을 선행했습니다. w. 클로드
Justin Jackson 웹사이트
추천 액터: Article Parser
정적 HTML 구조에 최적화
간단한 블로그 콘텐츠 추출에 적합
메타데이터, 본문 텍스트 쉽게 수집 가능
Not Boring 웹사이트
추천 액터: Web Scraper
Substack 기반 동적 콘텐츠 처리
JavaScript 렌더링 지원
복잡한 웹 구조 대응 가능
무한 스크롤/페이지네이션 처리 용이
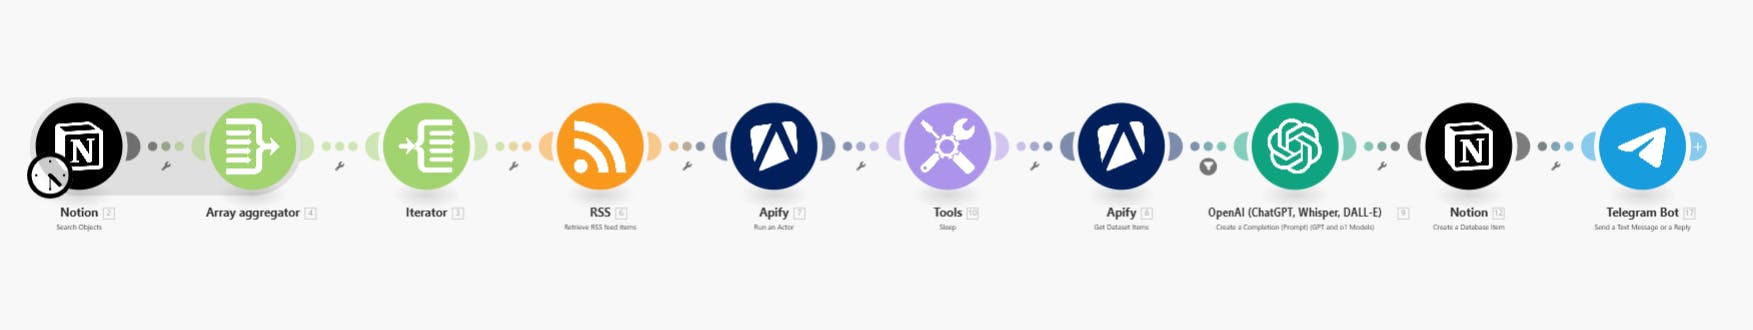
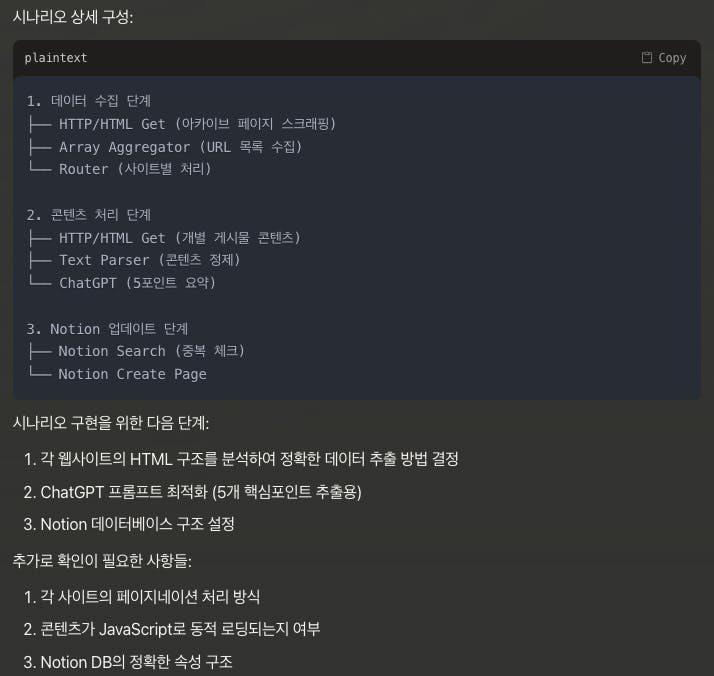
전체 시나리오를 기획
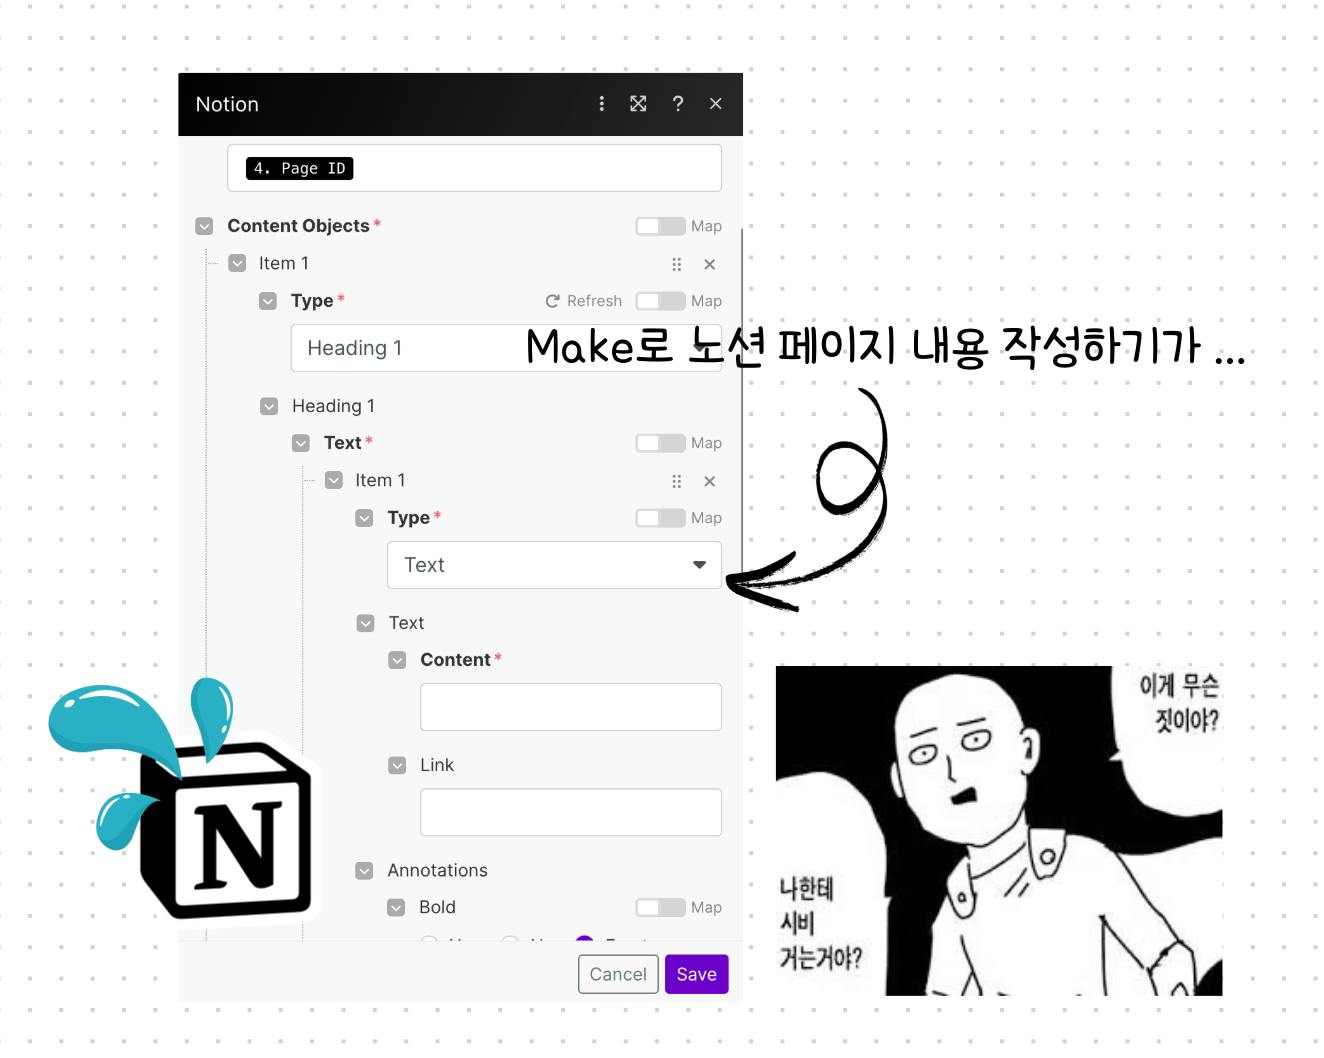
make 화면(시행착오 중)
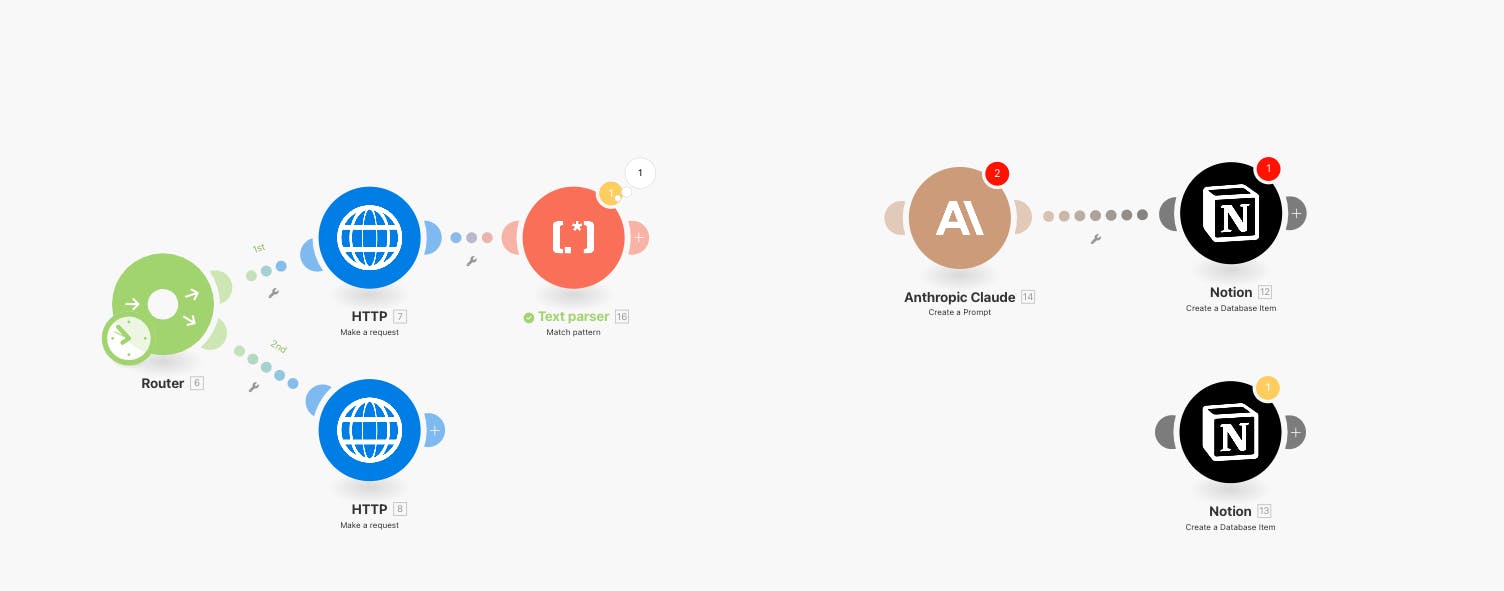
향후 다시 만들 방법은 고민중입니다~ 이 글을 보신 분들께도 도움 부탁드려요!
<리스트 페이지>와 <상세 페이지> 데이터 모두 크롤링하기
Apify로 진행한다
리스트 페이지를 firecrawl 또는 http로 파싱해서 각각의 url을 획득한다.
각각의 url을 firecrawl로 접근하여 상세페이지의 데이터를 수집한다.
도움 받은 글
모카님, 푸르공님, 김혜련님의 도움을 받았습니다 🙌

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요