


소개
투자 에이전트 개발기 3편입니다. 1·2편에서 해외·국내 주식 정보를 수집해 모으는 것까지 성공했고, 이번엔 거기에 뉴스를 붙이려다 예상보다 깊이 들어간 이야기입니다.
원래 하려던 것
뉴스 기사를 수집해 투자 포트폴리오 판단에 도움이 되는 서사를 제공하는 대시보드를 붙이고 싶었습니다. 이걸 헤르메스봇에게 맡기면 GraphRAG를 직접 구현하는 것보다 가볍고 빠르게 될 거라 생각했습니다.
절반은 잘 됐습니다.
시킨 것
결과
정해진 지표 수집·해석 (금리·달러·고용)
✅ 잘했습니다
뉴스 수집 → 도움 되는 서사 제공
❌ 한 번에 안 됐습니다
"이건 과정이 많다"는 걸 작업하면서 알게 됐고, 그래서 이 부분만 따로 떼어내 만든 것이 이번 프로젝트입니다.
한국 검색 엔진의 스크린샷
한국어로 된 Google 검색 페이지의 스크린샷
왜 한 번에 안 됐을까 — 두 일은 겉보기만 비슷하고 성격이 완전히 다릅니다.
금리·달러·물가
뉴스
무엇을 볼지
이미 정해져 있다
매일 새로 골라내야 한다
AI가 할 일
해석
선별 + 해석
하루 입력량
지표 수십 개
후보 2,900개
정형 지표는 "무엇을 볼지"가 이미 답으로 주어져 있어서 한 번에 됩니다. 뉴스는 "무엇을 볼지"부터 골라야 하고, 고르는 일이 곧 판단입니다.
판단이 들어가는 순간 — AI가 「모르겠다」고 말할 줄 알아야 한다는 문제가 생깁니다. 그걸 몰라서 토큰을 엄청 날렸습니다.
사람이 개입하지 않는다 — 재료만 정확히 모아두고 판단은 스코어로 합니다.
확장성이 아니라 — "한 사람이 매일 읽을 분량"으로 설계합니다.
진행 방법
도구
도구
용도
Claude Code (Opus 5)
설계·구현 전 과정
Gemini API
기사 묶음을 서사로 쓰는 마지막 단계에만
Postgres + RSS 26개 + NAVER API
저장 · 수집
파이프라인 7단계
① discover  오늘 무엇이 이슈인가    후보 2,900개 → 40개
② collect   그 대상 기사 모으기
③ extract   기사에서 사실 뽑기 to 기사 제목에서 키워드 뽑기
④ resolve   같은 것끼리 묶기        삼성전자 = 삼성
⑤ 컨텍스트   쓰기 전 사람이 읽어볼 것
⑥ narrate   서사 한 편 쓰기        AI를 부르는 유일한 자리
⑦ render    읽을 수 있게 내놓기
③을 통째로 바꾼 점이 성과 중 하나입니다. 기사마다 AI를 부르느라 하루 500회였는데, 알고 보니 그 일은 ⑥에서 한꺼번에 해도 됐습니다. → 하루 20회. 기능 손실 없음.
핵심 개념의 축
문서수 대신에 신호를 탐지하는 기준을 둠
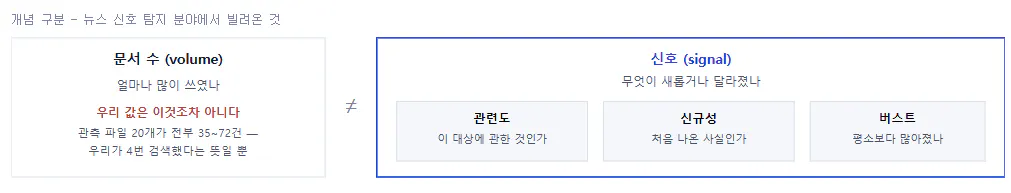
한국어의 다양한 부분을 보여주는 다이어그램
「기권」을 정식 값으로
VERDICT_SIGNAL   = "signal"      # 통과
VERDICT_NOISE    = "noise"       # 노이즈
VERDICT_UNJUDGED = "unjudged"    # 판단할 근거가 없었다
LF_ABSTAIN       = "abstain"     # 이 규칙은 이번 판정에 기권

def aggregate_votes(votes):
    voted = [v for v in votes if v.voted]     # 기권한 규칙은 집계에서 제외
    if not voted:
        # ★ 통과시키되 「통과」와 구분해 기록 — 예전엔 그냥 signal이었다
        return VERDICT_UNJUDGED, "판단할 재료 없음"
    ...
바뀐 건 「버린다」가 아니라 「보인다」입니다. 예전엔 근거 없는 후보가 그냥 signal로 기록돼 아무 흔적이 없었습니다. 40개 중 18개(45%)가 그 상태였고, 지금은 그 비율이 매 실행 숫자로 찍힙니다.
먼저 보이게 만들어야 고칠지 말지 판단할 수 있습니다. 안 보이면 문제가 있는지 조차 모릅니다.
사건 사례
「CNN」은 왜 관찰 대상이 되었나
「모르겠다」와 「괜찮다」가 같은 값이었다
「이강인」은 주제키워드 인가 노이즈 인가
결과와 배운 점
6일간의 결과
항목
Before
After
뉴스 훑기
앱 여러 개 수동, 기록 안 남음
채널 26개 자동, 기사 1,634건
주제 선별
눈으로
규칙 4개 자동 판정 + 근거 기록
AI 호출
하루 500회
하루 20회 (기능 동일)
근거 부족 시
조용히 통과 (45%)
기권으로 분리, 매번 계측
솔직히 아직 안 끝났습니다 — 서사 8편을 생성해 읽어봤지만 화면이 0줄입니다.
배운 점 — 한 문장
문제는 전부 AI가 「모르겠다」고 말하지 않아서 생겼습니다.
무슨 일
실제로 무슨 일이었나
투자 아카이브인데 발굴 주제에 경제·금융 0건
목적이 모호했는데 되묻지 않고 채웠다
같은 문제를 세 번 지적
판단 단계가 없는데 없다고 말 안 하고 손잡이만 돌렸다
AI 호출 하루 500회
물어보기 전까지 말해주지 않았다
"완료했습니다"가 네 번 사실과 달랐다
확인 안 한 걸 확인했다고 했다
그리고 결과물은 언제나 그럴듯해 보였습니다. 그래서 발견이 늦었습니다.
투자 에이전트를 만드신다면 이 문장만 가져가셔도 됩니다. 확신이 없을 때 "모르겠다"를 못 내는 에이전트는, 틀리는 에이전트보다 위험합니다.
꿀팁
① 판단 함수에 「기권」을 넣는다 — 반환값을 긍정/부정/기권 최소 3개로. 그리고 기권율을 로그에 남긴다. → 투자 에이전트라면 "매수/매도" 둘만 내지 마세요. "판단 보류"가 정식 출력이어야 하고, 보류율이 갑자기 떨어지면 개선이 아니라 경고입니다.
② 「하지 마라」를 문장이 아니라 검사로 만든다 — "순위표 금지"를 문서에 적는 대신 자동 검사로. 실제로 AI를 두 번 막았습니다. 한 번은 목록이 개수순 정렬이었는데 그날 1~3위가 AI·지원·공개였습니다. 순서가 중요도가 아니라는 증거가 그 화면 안에 있었죠.
③ 모든 주장에 근거 등급을 붙이게 한다 — 실측/확인/분석/추정. 이걸 강제하니 "대체로 잘 걸러집니다" 같은 문장이 못 들어왔습니다. 제일 값싸고 효과 큰 장치입니다.
④ 원칙을 문서가 아니라 시스템에 심는다 — 이 프로젝트는 한 번 저장된 기록을 못 지웁니다(DB가 거부). 그런데 AI가 사양서에 "끝나면 완료 시각을 채운다"고 적고는 구현 직전 스스로 멈췄습니다 — "이 컬럼은 만들 수 없습니다. 수정이 금지된 표라서요." → 투자 에이전트라면 결정적입니다. 과거 판단 기록을 소급 수정할 수 있으면 백테스트가 거짓말이 됩니다.
시행착오
구간
무슨 일
교훈
초반 목적 정의
모호하게 적어 5개 문서에 오독이 번짐
AI는 문서 보고 다음 문서를 씁니다. 초반 한 줄이 복리로 번집니다
같은 문제 반복
CNN(언론사)이 관측 대상에 오른 걸 3번 지적
증상을 물으면 증상만 고칩니다
필터 튜닝
AI가 감으로 4번 측정, 전부 빗나감
문제의 이름을 먼저 안 찾았습니다. 검색 5분이면 될 일
완료 보고
보고와 실제가 다른 일 4회
그래서 검증을 위임 안 합니다
문서 비대화
기준 문서가 1,472줄까지 부풂
뭐가 현재 상태인지 아무도 몰랐습니다 (595줄로 분리)
도움이 필요한 부분 🙏
제일 근본적인 걸 건너뛰었습니다. 마지막에 이런 의문이 들었습니다 —
"이거 머신러닝에 해당하나? 정답도 없고, 근거도 흔들리고, 스코어링도 견고하지 않은 것 같은데."
확인해보니 정답(라벨) 데이터가 0건이었습니다. 40건 전부 AI가 제안한 것이었고, 규칙의 기준값 4개도 전부 눈으로 보고 정한 숫자였습니다. 정답이 없으니 "이 규칙이 얼마나 맞는가"를 계산할 방법 자체가 없었습니다.
조언 구하고 싶은 것:
평가셋(정답 라벨)을 몇 개나 만들어야 충분한가요? 1인 프로젝트에서 40개면 되는지 감이 안 옵니다.
"목적에 맞는가" 같은 주관적 판단을 라벨링할 때 일관성을 어떻게 유지하시나요?
한국어 뉴스 제목 처리 — 형태소 분석기 없이 어디까지 갈 수 있을까요? 저는 "제목 뒤쪽에 나오는 비율"로 서술어를 잡는 편법을 씁니다.
한 가지 더 알게 된 건 전부 학습으로 풀 수는 없다는 겁니다. 이강인 키워드가 좋은 예인데, 하루 15건 보도되는 명백한 주제입니다. 노이즈인 이유는 통계가 아니라 "이 아카이브는 투자를 본다"는 제 선언 때문이죠.
투자 에이전트로 치면 — "좋은 종목"의 정의는 데이터에서 나오지 않습니다. 그건 본인의 투자 원칙입니다. 라벨로 선언하지 않으면 AI는 데이터에서 가장 흔한 패턴을 좋은 것으로 착각합니다.
앞으로의 계획
화면 만들기 — 서사는 나오는데 볼 데가 없습니다.
매일 자동 실행 — 이게 돼야 "평소 대비 오늘 갑자기 늘어난 주제"를 계산합니다. 지금은 이력이 하루치 뿐이라 비교가 불가능합니다.
