긴 스킬 본문을 references로 나눈 시제품 만들기
2026.10.22
소개
3주차 강의에서 스킬은 필요할 때만 불리고, CLAUDE.md에는 항상 지킬 지침만 두며, 컨텍스트는 100만 토큰이 차면 압축된다는 설명을 들었습니다. 이 기준으로 제 Claude Code 설정을 다시 쟀습니다. 본문이 608줄인 write-post 스킬을 사본으로 나눈 시제품을 만들어 호출할 때 읽는 줄 수를 비교했고, 2주차 글에 적은 다음 주 계획 11개의 실행 여부를 확인했으며, 컨텍스트 크기와 훅, 에이전트 정의, 설치한 OMC를 강의 설명과 대조했습니다. 길어진 스킬을 어디서부터 줄여야 할지 막막한 분, 컨텍스트를 40% 넘게 채우면 AI가 멍청해진다는 이야기가 내 사용에서는 얼마나 해당하는지 궁금한 분께 맞는 글입니다.
저는 청강생이고 3주차 다시보기를 봤습니다. 앞부분은 수강생 네 분의 사례 발표(찬양 178일분의 노래와 영상 자동 제작, 서류 작성 스킬, 코드 진행 제안 도구, 반복 지시의 스킬화)였고, 투표로 베스트 발표자를 뽑은 뒤 스터디장 강의가 이어졌습니다. 강의는 Claude Code로 일하는 순서(탐색, 계획, 구현, 커밋), Oh My Claude Code(OMC) 플러그인의 deep-interview, ralplan, ralph, 컨텍스트 창과 CLAUDE.md, 훅, 서브에이전트, MCP, 완료의 네 가지 렌즈 순서였습니다. 과제는 OMC를 설치해 하고 싶은 것을 해 보고 다음 시간에 사례글로 쓰라는 안내가 영상 01:57쯤 나왔고, 채팅 로그에는 과제 문구가 없었습니다. 제출 방법과 마감은 확인하지 못했습니다.
OMC를 써 보는 과제는 하지 못했습니다. 제 설정에는 OMC가 설치된 기록이 있지만 꺼져 있고 호출한 기록이 없어서, 대신 강의가 말한 기능을 설치본 원문과 대조했습니다. 측정은 2026-10-22에 했고, 로그와 설정은 읽기만 했습니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, 셸(wc, shasum, stat)
범위
구분 | 값 |
|---|---|
메인 세션 로그 | 63개 파일 ( |
3주차 구간 | 2026-10-14 00:30 ~ 10-22 00:50 (KST), 제가 보낸 지시 1,050개 |
비교 구간 | 2주차 글의 구간(10-04 ~ 10-14 00:30) |
측정 스크립트 | 2주차 스크립트를 복사해 구간과 출력 경로를 인자로 바꾸고 3주차 항목을 더함 |
Step 1. 강의 기준의 측정 항목 변환
3주차 강의 기준 | 잴 것 |
|---|---|
스킬은 필요할 때만 불린다. 상세 절차는 따로 둔다 | 본문이 500줄을 넘고 references가 없는 스킬, 사본을 나눈 시제품의 읽는 줄 수 |
컨텍스트는 100만 토큰, 가득 차면 압축된다. 찰수록 떨어질 수 있다 | 응답마다 컨텍스트 토큰 크기, 압축이 일어난 시점 |
CLAUDE.md는 항상 지침, 상세 절차는 스킬로 | 항상 올라오는 지침 파일의 줄 수와 한 절의 비중 |
훅은 말로 안 되는 일을 강제하는 장치 |
|
서브에이전트는 설명, 도구, 모델, 지침으로 정의 | 에이전트 정의 파일의 필드 |
OMC의 deep-interview와 ralplan 규칙 | 설치본 SKILL.md와 강의 수치 대조 |
2주차 다음 주 계획 | 파일 수정 시각, 로그, 설정으로 판정 |
Step 2. 2주차 계획의 실행 여부 확인
2주차 글의 다음 주 계획과 댓글 제안을 항목별로 정리해 11개로 만들고 하나씩 확인했습니다.
stat -f '%Sm %N' ~/.claude/skills/gpters-case-study/SKILL.md ~/.claude/skills/write-post/SKILL.md
python3 -I 24기문과생도AI_3주차_측정.py      # 3주차 구간 집계
Oct  7 22:45:34 2026 ~/.claude/skills/gpters-case-study/SKILL.md
Jul 26 11:16:18 2026 ~/.claude/skills/write-post/SKILL.md
saved 3주차/assets/측정결과_3주차.json cut 2026-10-13T15:30:00.000Z
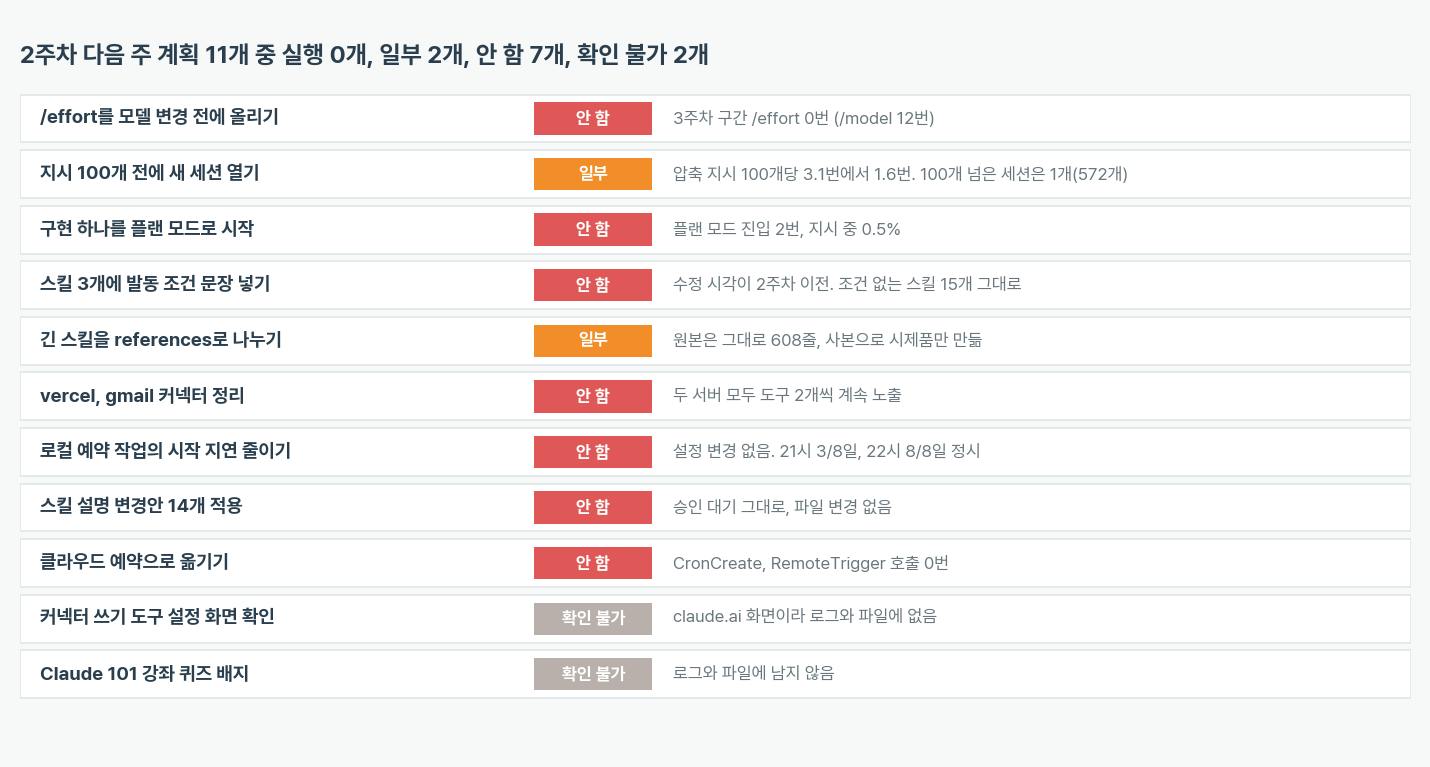
두 스킬의 수정 시각이 2주차 이전이라 발동 조건 문장은 들어가지 않았고, 발동 조건 표현이 없는 스킬은 15개 그대로입니다. 3주차 구간에서 /effort는 0번이고 /model은 12번이며, 응답 12,460개 중 medium이 11,076개(88.9%)입니다. 지시 100개당 압축은 3.1번에서 1.6번(압축 17번, 지시 1,050개)으로 줄었지만, 이 구간에 지시 100개를 넘긴 세션이 하나 있고 572개였습니다. 계획 11개 중 실행으로 판정한 것은 없었습니다. 2주차 글에서 매번 기억해야 하는 계획은 그대로였다고 적었는데 3주차 구간에서도 같았습니다.
Step 3. 분할 스크립트의 시험 작성
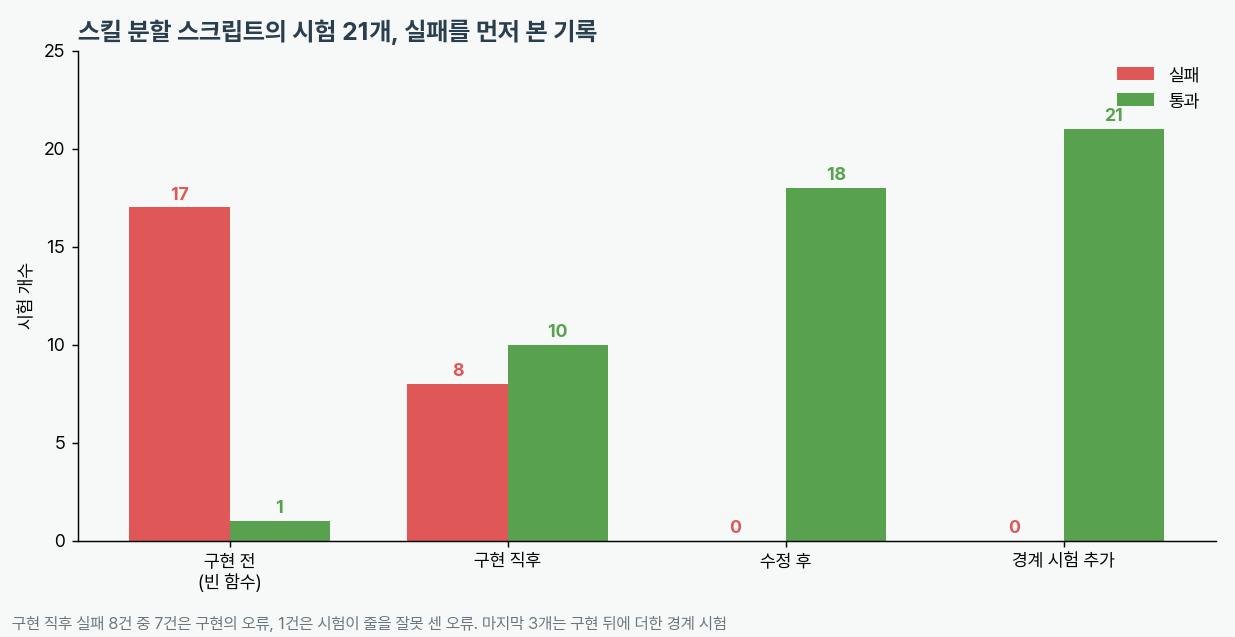
스킬을 나누는 스크립트가 내용을 흘리면 곤란하므로 구현보다 시험을 먼저 썼습니다. 줄 수를 손으로 센 모의 스킬(15줄, B 절 4줄)에서 정답은 참조 파일 4줄, 본문 12줄입니다. 그 밖에 나눴다 합치면 원본과 글자까지 같은지(왕복), 시작 줄이 없거나 둘이면 아무것도 쓰지 않고 오류를 내는지, 원본이 바뀌지 않는지, 두 번 실행해도 같은지, description만 한 줄 바뀌는지, 안내 줄을 뺀 줄의 모음이 원본과 같은지를 시험으로 적었습니다.
python3 -m pytest -q test_split_skill.py # 내용이 빈 함수일 때
17 failed, 1 passed
통과한 1개는 사본이 원본과 같은지 보는 시험이었습니다. 구현하고 나서는 8개가 실패했습니다. 7개는 선택 항목인 안내 문구(when)를 필수로 요구한 구현의 오류였고, 1개는 줄을 split("\n")으로 세어 파일마다 빈 조각을 더한 시험의 오류였습니다. 둘을 고치자 18개가 통과했고, 경계 시험 3개(끝 줄 누락, 절 겹침, 뒤쪽 빈 줄)를 더해 21개가 됐습니다. 이 3개는 구현 뒤에 썼기 때문에 실패를 먼저 보지 못했습니다.
Step 4. write-post 사본 분할과 읽는 줄 수 측정
2주차에 본문이 500줄을 넘고 references가 없다고 찾은 스킬 둘 가운데 write-post를 골랐습니다. ~/.claude의 원본은 읽기만 하고 사본(원본사본/SKILL.md)을 나눴습니다. 사본의 해시가 원본과 같고, 원본의 수정 시각이 7월 26일 그대로라는 것을 시험이 매번 확인합니다.
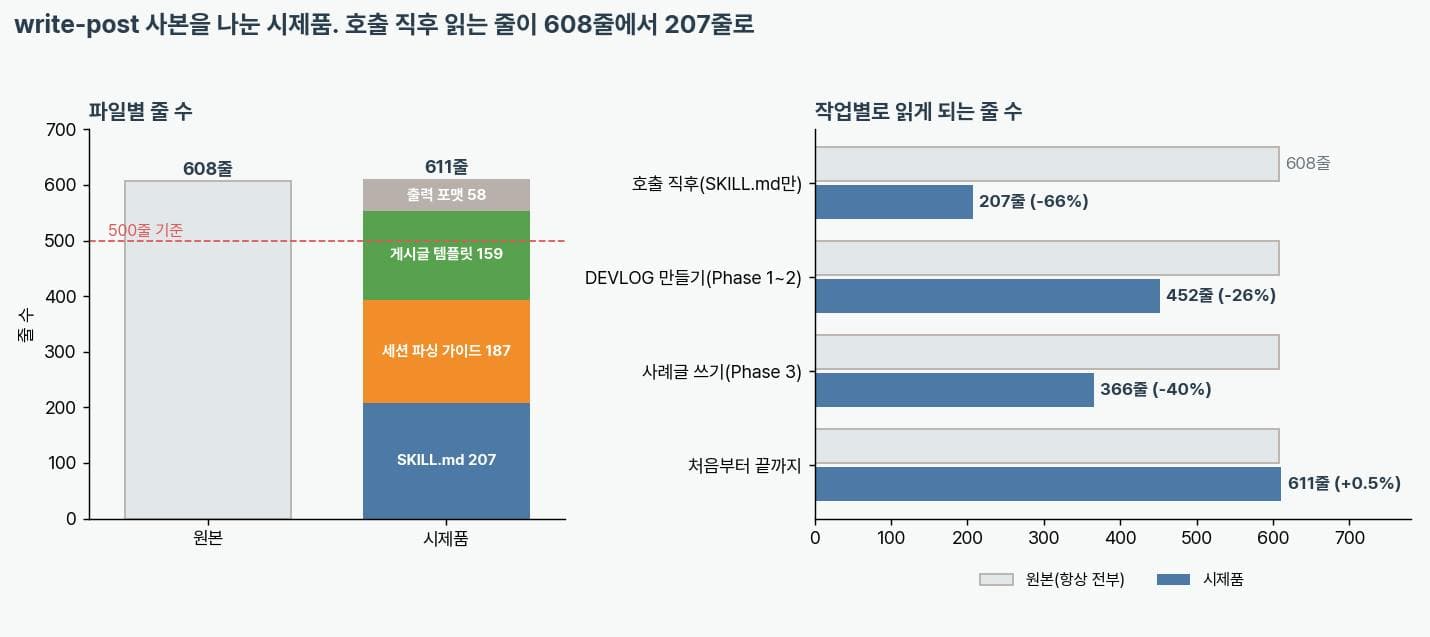
나눈 절은 세 개입니다. 출력 포맷(DEVLOG 파일의 모양)은 devlog-format.md로, 도구별 세션 파싱 가이드(Claude Code, OpenCode, Codex, Gemini, Antigravity 다섯 가지)는 session-parsing-guides.md로, 게시글 템플릿과 작성 가이드는 post-template.md로 옮겼습니다. 세션 스캔, 파싱 사전 검증, 실행 방법, 정리 규칙, Phase 2, Phase 3의 진행 순서는 본문에 남겼습니다. 옮긴 줄은 한 글자도 바꾸지 않고 본문에는 "어떤 때 읽는다"는 안내 한 줄씩만 두었습니다.
python3 -I run_split_write_post.py
wc -l ~/.claude/skills/write-post/SKILL.md 시제품/write-post/SKILL.md 시제품/write-post/references/*.md
     608 ~/.claude/skills/write-post/SKILL.md
     207 시제품/write-post/SKILL.md
      58 시제품/write-post/references/devlog-format.md
     159 시제품/write-post/references/post-template.md
     187 시제품/write-post/references/session-parsing-guides.md
본문은 608줄에서 207줄이 됐습니다. 원본은 어떤 일을 하든 608줄을 읽지만, 시제품은 호출 직후 207줄, DEVLOG를 만들 때 452줄(-26%), 이미 있는 DEVLOG로 사례글만 쓸 때 366줄(-40%)을 읽습니다. 처음부터 끝까지 하면 안내 줄 3개가 늘어 611줄(+0.5%)이라 이득이 없습니다. 글자 수로는 호출 직후 6,129자(원본 16,288자의 38%)입니다.
2주차에 정한 발동 조건 문장 한 줄도 시제품의 description에만 붙여 봤습니다. 101자가 135자가 됩니다. 변경안 14개 문장을 모두 붙이면 스킬 목록이 508자(현재 25,969자의 2.0%) 늘어납니다. 목록 크기에는 부담이 작은 편입니다.
이 시제품을 실제로 설치해 호출하지는 않았습니다. ~/.claude를 바꾸는 일이라 하지 않았고, 따라서 나눈 스킬이 원본과 같게 동작하는지는 확인하지 못했습니다. 확인한 것은 내용이 한 줄도 빠지거나 바뀌지 않았다는 점(왕복 시험)과 읽는 줄 수입니다.
Step 5. 컨텍스트 크기와 압축 시점 측정
채팅에서 컨텍스트가 40%를 넘으면 AI가 멍청해지느냐는 질문이 나왔고, 스터디장은 그렇지는 않고 100만 토큰까지는 잘 동작하지만 찰수록 떨어질 수 있다고 답했습니다. 제 응답이 어느 크기에서 나왔는지 쟀습니다. 응답마다 입력 토큰(입력, 캐시 생성, 캐시 읽기의 합)을 더했고, 같은 메시지 id는 한 번만 셌습니다. 서브에이전트 응답은 뺐습니다.
tot = u["input_tokens"] + u["cache_creation_input_tokens"] + u["cache_read_input_tokens"]
ctx[(file_idx, message_id)] = max(prev, tot)     # 같은 메시지는 한 번만
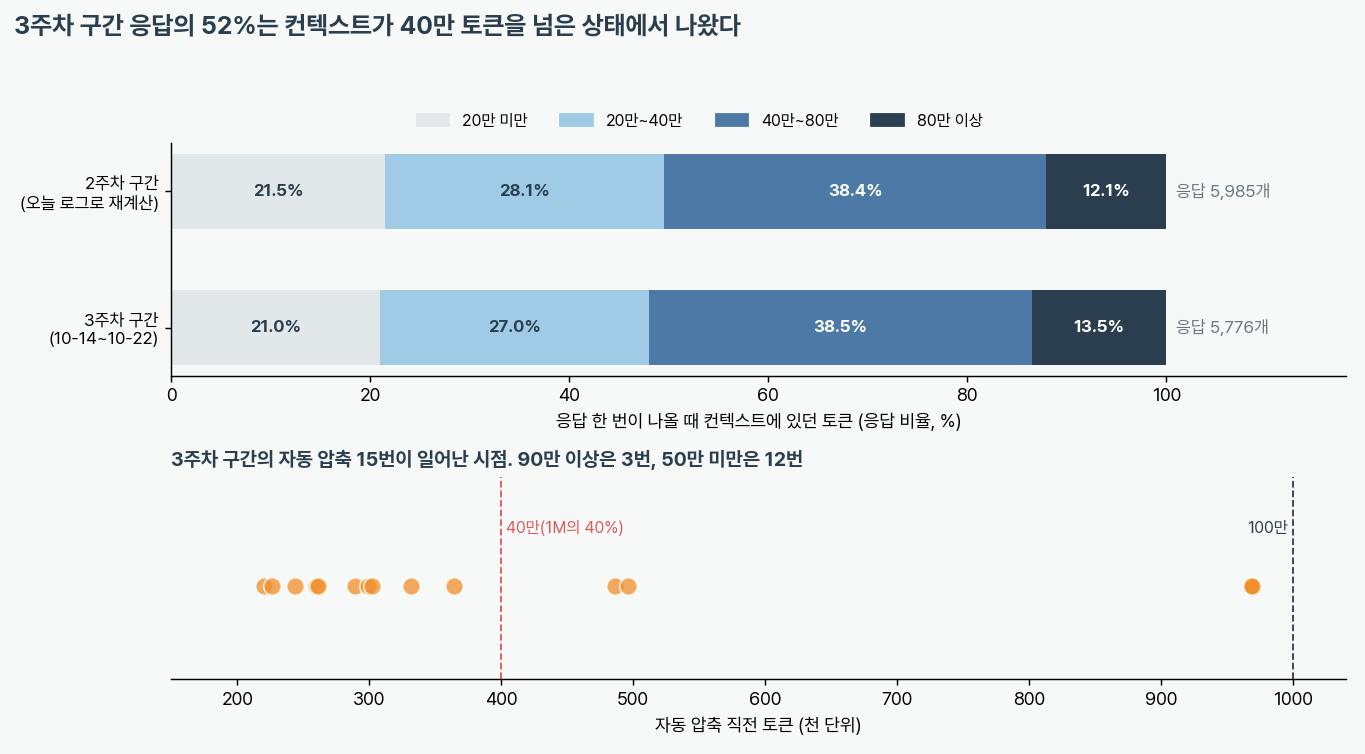
3주차 구간 응답 5,776개 가운데 3,005개(52.0%)가 컨텍스트 40만 토큰 이상에서, 782개(13.5%)가 80만 이상에서 나왔습니다. 중앙값은 41.8만 토큰입니다. 같은 방식으로 오늘 로그로 다시 센 2주차 구간은 50.5%와 12.1%라서 두 구간이 비슷합니다. 세션 28개 중 12개가 40만을, 6개가 90만을 넘겼고, 한 세션이 40만 이상 응답 1,280개(43%)를 냈습니다. 제 작업의 절반은 스터디장이 말한 40% 선을 넘은 상태에서 이뤄지고 있습니다. 창이 100만 토큰이라고 가정한 값이며, 이 글만으로 그 상태의 결과가 나빴는지는 말할 수 없습니다. 응답의 질은 재지 않았습니다.
자동 압축은 15번 일어났는데 90만 이상에서 3번(96.8만에서 96.9만), 50만 미만에서 12번(22만에서 49.6만)이었습니다. 강의는 100만에 가까워지면 압축된다고 했고, 12번은 그보다 훨씬 이른 시점이었습니다. 왜 일찍 압축됐는지는 로그에서 확인하지 못했습니다.
Step 6. 훅과 에이전트 정의의 필드 확인
for ev, lst in settings["hooks"].items():          # settings.json의 hooks를 이벤트별로 센다
    for x in lst:
        for h in x["hooks"]:
            n[ev] += 1
            n_pack[ev] += "<팩 폴더>" in h["command"]    # 설치한 팩의 스크립트를 부르는 훅
훅:
settings.json에 18개가 등록돼 있습니다(PreToolUse 5, PostToolUse 4, Stop 3, SessionStart 2, 나머지 4). 이 중 17개는 설치한 팩의 스크립트를 부르는 것이고, 나머지 1개는 작업 폴더를 스냅샷하는 PreToolUse입니다. 강의가 든 예인.env를 못 고치게 막는 규칙을 찾으면, 훅 명령에.env가 들어간 것이 0개이고permissions.deny도 0개입니다. 팩 스크립트의 내부 규칙은 열어 보지 않았습니다.에이전트 정의:
~/.claude/agents의 정의 파일 32개 중 도구(tools)를 적은 것이 23개(72%), 모델(model)을 적은 것이 11개(34%, sonnet 7개와 opus 4개)입니다. 강의가 정의의 네 요소로 든 설명, 도구, 모델, 지침 가운데 모델을 적지 않은 정의가 21개입니다. description 길이의 중앙값은 194자입니다.항상 올라오는 지침: 전역
CLAUDE.md와rules파일 12개가 798줄, 47,859자입니다. 전역CLAUDE.md(9,019자)의 71%(6,418자)는 하나의 스킬 변경 이력 표가 든 절입니다. 강의가 상세 절차와 워크플로는 CLAUDE.md에 넣지 말고 스킬로 만들라고 한 기준에 비추면 옮길 후보로 보입니다. 옮기는 일은 설정을 바꾸는 일이라 하지 않았습니다.
Step 7. 설치한 OMC와 강의 설명의 대조
installed_plugins.json에 oh-my-claudecode가 2026-10-20 21:24(KST)에 설치된 기록이 있습니다. 하지만 enabledPlugins의 값은 false입니다. 세션 시작 때 올라오는 스킬 목록은 10월 20일 설치 전후 모두 66개 25,969자라서 OMC 스킬은 목록에 없습니다. Skill 도구로 oh-my-claudecode: 스킬을 부른 기록은 0번입니다. 2주차에 정리한 계획 메모는 OMC를 설치하면 스킬 목록이 크게 늘어난다고 예상했는데, 설치만으로는 늘지 않았습니다. 활성화 값이 꺼져 있어 세션에서 쓸 수 없는 상태이고, 누가 언제 껐는지는 확인하지 못했습니다.
설치본(5.7.5)의 SKILL.md를 열어 강의 설명과 맞춰 봤습니다.
강의에서 한 말 | 설치본 원문 | 판정 |
|---|---|---|
deep-interview는 모호함 점수가 0.2 아래면 멈춘다 | 설정이 없으면 기본 임계값 0.2 | 일치 |
질문은 한 번에 하나, 라운드 상한 20번 | "one question at a time", Round 20 hard cap | 일치 |
ralplan은 Planner, Architect, Critic이 합의하고 최대 다섯 번 반복 |
| 일치 |
합의 결과로 ADR(결정 기록)이 나온다 | Decision, Drivers, Alternatives, Why chosen, Consequences, Follow-ups | 일치 |
스킬 40개, 훅 13개, 에이전트 19개 | 스킬 48개, 훅 30개( | 스킬과 훅이 다름 |
스킬과 훅의 수는 강의 화면의 버전이 달랐거나 세는 방식이 달랐을 수 있습니다. 어느 쪽인지는 확인하지 못했습니다.
Step 8. 같은 명령의 재측정과 로그 차이
2주차 글의 값을 3주차 구간과 나란히 두려고 같은 스크립트를 2주차 구간으로 다시 돌렸습니다.
python3 -I 24기문과생도AI_3주차_측정.py --end 2026-10-13T15:30:00.000Z --prompts 2323 --out 재현시도.json
saved 재현시도.json cut 2026-10-05T13:07:32.212Z
2주차 글의 구간 경계는 10월 4일 11:52(KST)였는데 같은 조건에서 10월 5일 22:07로 나왔습니다.
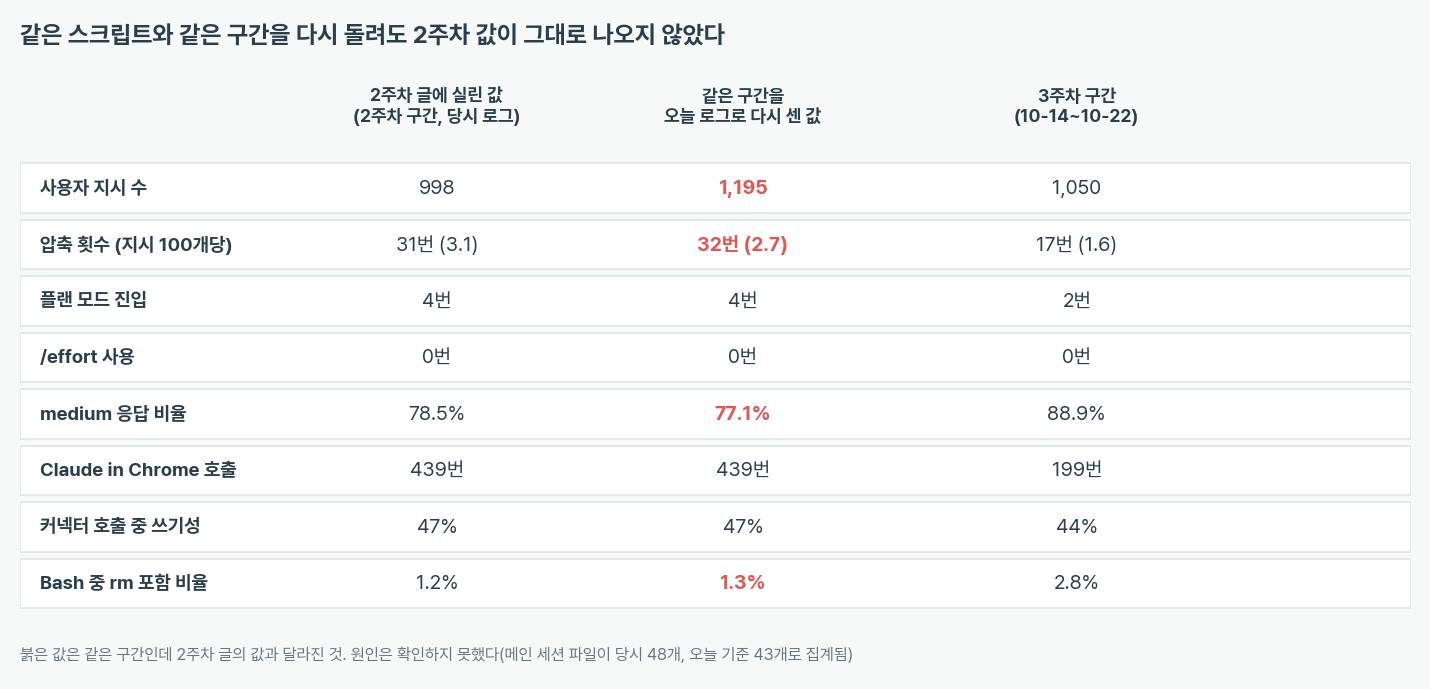
같은 시점까지의 지시가 2,323개에서 2,213개가 됐고 뒤 구간은 998개에서 1,195개가 됐습니다. 메인 세션 파일은 2주차 때 48개였는데 같은 끝 시각으로 세면 43개입니다. 수정 시각이 같은 분(10월 13일 20:24 KST)인 세션 파일이 8개 있습니다. 이 일괄 수정이 원인인지는 확인하지 못했습니다. 그래서 3주차 구간의 값은 2주차 글의 값과 직접 이어 붙이지 않고, 같은 날 같은 로그로 센 열과 비교했습니다.
결과와 배운 점
측정 결과 (3주차 구간 2026-10-14 00:30 ~ 10-22 00:50 KST)
항목 | 값 |
|---|---|
write-post 본문 줄 수 | 608줄에서 207줄 (시제품, 참조 3개 404줄) |
시제품의 읽는 줄 수 | 호출 직후 207, DEVLOG 만들기 452, 사례글 쓰기 366, 전부 611 |
분할 스크립트 시험 | 구현 전 17개 실패, 최종 21개 통과, 원본 해시와 수정 시각 불변 |
2주차 계획 11개 | 실행 0, 일부 2, 안 함 7, 확인 불가 2 |
응답 중 컨텍스트 40만 이상 | 3,005 / 5,776 (52.0%) |
자동 압축 | 15번, 50만 미만에서 12번 |
압축, 지시 100개당 | 1.6번 (2주차 글 3.1번) |
훅, 에이전트 정의 | 훅 18개(팩 경로가 아닌 것 1개), 정의 32개 중 모델 적은 것 11개 |
OMC | 설치 10-20, 비활성, 호출 0번 |
배운 점
스킬의 줄 수를 줄인 효과는 어떤 일을 하느냐에 따라 달랐습니다. 호출 직후에는 66% 줄었지만 처음부터 끝까지 쓰는 일에서는 이득이 없었습니다. 스킬 하나가 여러 단계를 모두 하는 구조라면 나누는 경계를 단계에 맞추는 편이 읽는 줄을 줄이는 데 유리해 보입니다. 시제품은 실제 호출로 확인하지 않았습니다.
나누는 스크립트는 내용이 보존되는지를 시험으로 확인했습니다. 왕복 시험은 옮긴 줄이 한 글자도 안 바뀐다는 것을 보여 줍니다. 구현 직후 실패 8개 중 1개가 시험의 오류였으니, 실패를 먼저 보지 않았다면 틀린 시험을 통과시키는 코드를 썼을 수 있습니다.
컨텍스트 40% 선은 제 사용에서 절반을 이미 넘고 있었습니다. 응답의 52%가 40만 토큰 이상에서 나왔고 압축은 대개 50만 토큰 전에 일어났습니다. 이 상태의 품질은 재지 않았습니다. 압축 전에 중요한 내용을 저장하라는 강의 내용은 메모리 파일에 쓴 횟수로 볼 수 있습니다. 3주차 구간은 11번으로, 2주차 구간(오늘 로그 기준 34번)보다 줄었습니다.
설치와 적용은 다른 설정 값이었습니다. OMC는 설치됐지만 꺼져 있어 스킬 목록이 그대로입니다. 목록 크기를 재서 알았습니다.
같은 명령을 다시 돌려도 지난 값이 그대로 나오지 않았습니다. 로그가 계속 바뀌는 환경에서는 측정한 날과 끝 시각, 파일 수를 값과 함께 적어 두어야 지난 값과 비교할 수 있습니다.
시행착오
같은 파일의 줄 수가 2주차 글에는 609줄, 이번에는 608줄입니다. 2주차 스크립트가
count("\n") + 1로 세어 마지막 빈 조각을 더한 값이었고, 이번에는wc -l과 같은 방식으로 셌습니다.시험 18개가 통과한 뒤에 경계 시험 3개를 더했습니다. 이 3개는 처음부터 통과했고 실패를 본 적이 없어 검사가 제대로 도는지는 확인하지 못했습니다.
OMC 스킬 수와 훅 수를 강의 화면과 맞추지 못했습니다. 설치본의
hooks.json에서 명령 수를 센 것이라 강의의 13개와 같은 기준인지 모릅니다.3주차 구간 로그에는 이 글을 쓰는 세션이 들어 있습니다. 끝 시각을 2026-10-22 00:50(KST)로 고정했고, 처음 실행과 다시 실행한 두 번의 결과가 모든 항목에서 같았습니다.
이 측정은 2026년 10월 22일 00시 50분(KST) 기준 ~/.claude/projects의 메인 세션 로그, ~/.claude/settings.json, skills, agents, plugins, 설치본 OMC 5.7.5의 SKILL.md를 Python과 셸로 읽은 결과입니다. 대화 내용, claude.ai 쪽 커넥터 설정, Claude 101 강좌 배지, 응답의 질, 팩 스크립트의 내부 규칙은 보지 않았습니다. 시제품은 실제 호출로 시험하지 않았습니다.
도움 받은 글
24기 문과생도AI 3주차 강의 (박정기): 컨텍스트 창과 압축, CLAUDE.md에 둘 것과 뺄 것, 훅, 서브에이전트 정의, OMC의 deep-interview와 ralplan
3주차 줌 채팅의 스키우 님 질문: 컨텍스트가 40%를 넘으면 AI가 멍청해지느냐는 질문이 Step 5의 출발점이었습니다
24기 문과생도AI 2주차 글의 댓글 (박정기): 스킬 설명에 "할 때 사용한다" 문장을 넣고 나중에 호출을 비교하자는 제안과
/effort, 예약 작업 점검 제안24기 문과생도AI 2주차 글 (본인): 측정 스크립트와 다음 주 계획 11개

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

Fri-mer님, 안녕하세요! 글 잘 읽었어요.
강의에서 들은 기준을 그대로 믿지 않고 본문이 608줄인 write-post 스킬을 사본으로 나눠 호출할 때 읽는 줄 수를 직접 비교한 접근이 좋았어요. 컨텍스트를 40% 넘게 채우면 AI가 멍청해진다는 이야기가 내 사용에서는 얼마나 맞는지 로그로 확인하려 한 점도 인상적입니다.
OMC 설치 과제를 하지 못했다는 점, 과제 제출 방법과 마감을 확인하지 못했다는 점을 숨기지 않고 적고 대신 설치본 원문과 강의 설명을 대조한 것도 정직해서 좋았습니다. 2주차 글에 적은 다음 주 계획 11개를 실행 여부로 하나씩 점검한 것도 연결이 잘 되어 있네요.
꼬리 탁! 치고 응원하고 갈게요 🐈⬛