블로그 글용 구조화 데이터 시제품과 AI 노출 질문 세트 만들기
2026.10.22
소개
3주차 강의에서 스터디장이 짚은 구조화 데이터와 AI 가시성 측정 기준으로 제 한/영 블로그를 다시 재 보고, 지난주 계획에 있던 일 두 가지를 실제로 끝냈습니다. 하나는 글 페이지에 넣을 BlogPosting JSON-LD(검색엔진과 AI가 읽는 글 정보) 시제품이고, 다른 하나는 AI 노출 질문 20개를 고정한 세트입니다. 블로그나 개인 사이트에 글 스키마가 아직 없는 분, 그리고 AI 노출을 "느낌"이 아니라 같은 질문으로 반복해서 재고 싶은 분께 도움이 될 것 같습니다.
제 블로그는 Jekyll로 만든 한/영 이중언어 사이트입니다. 연구 노트를 한국어와 영어로 한 쌍씩 쓰고, 경제 브리핑(econ-radar)과 논문 다이제스트가 자동으로 올라갑니다. 저는 이 스터디를 청강하며 1주차와 2주차에 사이트 상태를 재기만 했는데, 2주차 글에 달린 댓글들이 대체로 "점검 항목을 늘리기보다 작은 개선 하나를 끝내 보라"는 방향이었습니다. 그래서 이번 주는 측정은 같은 명령으로 다시 하되, 고치는 일 하나를 끝까지 하는 쪽에 시간을 더 썼습니다.
3주차(10월 15일 목요일)는 구조 이야기가 중심이었습니다. 이미지 alt와 H1, H2 구조 같은 시맨틱 HTML, 페이지 안에 데이터 형식으로 넣는 구조화된 데이터와 그것이 AI에게 사이트와 운영자를 하나의 "엔티티"로 알려 준다는 설명, 쇼핑몰 상세 페이지를 이미지에서 텍스트로 바꾸는 사례가 나왔습니다. 후반에는 AI 유입을 재는 도구(빙 웹마스터, 구글 애널리틱스)와 질문 세트로 AI 가시성을 재는 방법이 이어졌습니다. 이 글은 그 기준을 제 사이트에 대 본 기록입니다. 측정은 2026년 10월 22일에 했고, 블로그 저장소는 읽기만 했습니다. 시제품은 블로그가 아니라 임시 복사본에서 빌드해 확인했습니다.
진행 방법
사용 도구: Python 3, pytest, Jekyll(임시 복사본 빌드), git(읽기), curl, 크롬(구글 검색 화면 확인), Claude Code
Step 1. 강의 기준에서 잴 항목 고르기
측정은 공개된 페이지와 저장소에서 확인되는 것만 셉니다. 서치콘솔 작업은 Step 3에 따로 적었고 화면 캡처는 없어 표로만 실었습니다.
3주차 강의 기준 | 이 글에서 재는 것 | 값의 출처 |
|---|---|---|
이미지에는 설명을 담은 alt | 글의 이미지 중 alt가 있는 개수와 같은 문구 반복 | 공개 페이지의 본문 영역 |
H1은 하나, H2와 H3는 목차 | H1이 하나인 글 수 | 공개 페이지 |
글에는 Article 계열 스키마 | 글의 BlogPosting JSON-LD | 공개 페이지와 시제품 빌드 |
어떤 사이트든 브레드크럼 | 글의 BreadcrumbList | 같음 |
엔티티를 연결하는 조직, 프로필 | 홈 Person 스키마와 글의 연결 | 시제품의 author 필드 |
AI 유입은 빙 웹마스터, 애널리틱스로 | 확인 태그와 GA 코드의 존재 | 페이지 head |
AI 가시성은 질문 세트로 | 질문 20개 고정, 브랜드 언급 20% | 질문 세트 파일 |
Step 2. 2주차 계획의 실행 여부 확인
2주차 글에 적은 계획을 같은 명령으로 확인했습니다. 블로그 저장소는 로컬이 원격보다 14커밋 뒤처져 있어, 원격 기준(origin/main)으로만 읽었습니다.
python3 -I measure_wk3.py        # 2주차 측정 스크립트의 복제. fetch를 하지 않고 원격 기준으로만 읽는다
git log origin/main --since=2026-10-14T00:25:00+09:00 --format='%ci %s'   # 7개 모두 econ-radar 발행
2주차 계획 | 실행 여부 | 근거 |
|---|---|---|
서치콘솔 구글, 빙, 네이버 등록 | 구글만 함(3주차에 직접 수행). 빙과 네이버는 안 함 | 측정 시점의 확인 태그 0쪽, 저장소 인증 파일 0개. 구글 확인 파일은 그 뒤에 올림(Step 3) |
한국어 | 안 함 | 한국어 페이지 16개 전부 |
hreflang 추가 | 안 함 | 페이지 0쪽, 저장소 파일 0개 |
econ-radar에 description, canonical, | 안 함 | econ-radar 146쪽 중 description 1, canonical 0, |
글에 Article 스키마를 넣는 방안 정하기 | 시제품까지 함. 블로그에는 반영하지 않음 | 이 글의 Step 6, 7 |
홈의 | 안 함 | 홈의 |
AI 노출 질문 20개 고정, 다섯 번씩 묻기 | 20개 고정만 함 | 이 글의 Step 8. 다섯 번 묻기는 하지 않음 |
서치콘솔 URL 검사로 색인 요청(댓글 제안) | 함 | 4개 주소에 색인 생성 요청(Step 3) |
2주차 이후 커밋은 7개이고 전부 econ-radar 자동 발행입니다. 사람이 한 커밋은 0개입니다. 10월 14일과 15일 날짜의 발행 커밋은 없었는데, 원인은 저장소를 읽기만 해서는 알 수 없었습니다.
Step 3. 서치콘솔 등록과 색인 요청
체크check 님의 제안을 실제로 수행했습니다. 계정에 속성이 하나도 없던 상태에서 시작했습니다.
순서 | 한 일 | 결과 |
|---|---|---|
1 | URL 접두어 속성으로 블로그 등록 | 속성 생성 |
2 | HTML 파일 방식으로 소유권 확인. 확인 파일 하나를 블로그 루트에 올리고 배포 뒤 200 응답을 확인 | 소유권이 확인됨 |
3 | sitemap.xml 제출 | 제출됨 |
4 | URL 검사: 메인, 주제 페이지( | 4개 모두 "URL이 Google에 등록되어 있지 않음", 참조 사이트맵 없음, 참조 페이지 없음 |
5 | 4개 주소 모두 색인 생성 요청 | 색인 생성 요청됨 |
URL 검사 결과도 site: 검색에서 블로그 글이 25편 중 한 편도 보이지 않던 것과 맞았습니다. 요청한 네 주소 모두 구글에 등록된 적이 없었고, 참조된 사이트맵도 없었습니다. 요청이 접수된 것이지 색인이 된 것은 아니므로 며칠 뒤 다시 확인합니다. 확인 파일은 메타 태그 집계에 잡히지 않아, 아래 측정 표의 확인 태그 0은 태그 방식 기준입니다.
Step 4. 2주차 값 다시 재기
curl -s <내 블로그>/sitemap.xml | grep -o "<loc>[^<]*" | wc -l      # 199
# 크롬에서 site:<내 블로그>, site:<내 블로그>/kr/, site:<내 블로그>/en/ 를 직접 검색
curl -s -A "$UA" "https://search.naver.com/search.naver?query=site%3A<내 블로그>" | grep -c "검색결과가 없습니다"   # 1
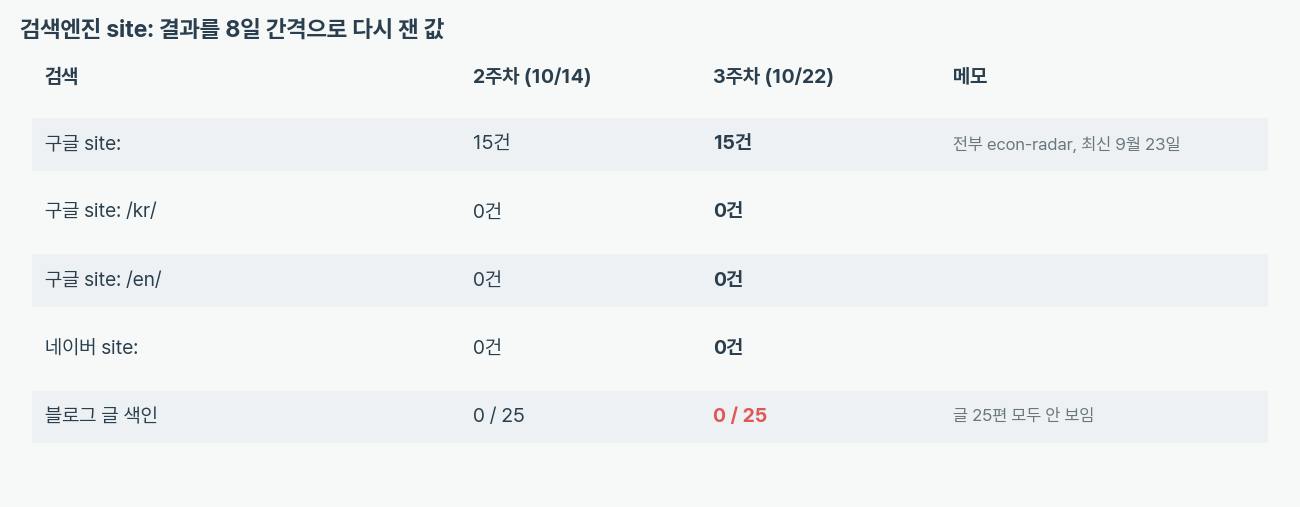
사이트맵 주소는 2주차 192개에서 199개로 7개 늘었고 모두 econ-radar입니다. 구글 site:는 15건으로 2주차와 같았고 전부 econ-radar이며 가장 최근 것이 9월 23일자입니다. 9월 24일 이후 발행분은 이번에도 목록에 없습니다. /kr/와 /en/는 0건이고 네이버도 0건입니다. 빙과 브레이브는 이번에 다시 재지 않았습니다.
Step 5. 강의 기준 일곱 가지 대 보기
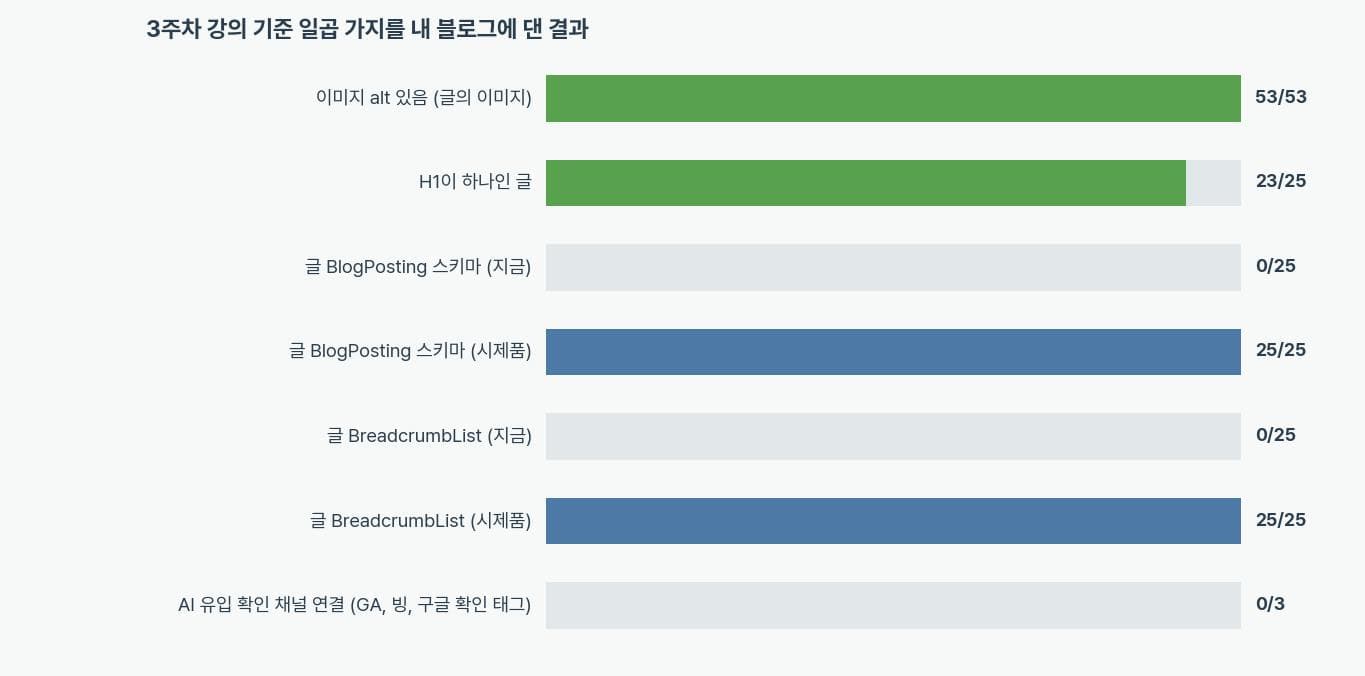
글 25편(한국어 13, 영어 12)의 본문 영역에서 이미지를 셌습니다. 이미지가 있는 글은 5편이고 이미지는 53개입니다. 53개 모두 alt가 있고 같은 문구가 반복된 alt는 0개이며, 8자 미만의 짧은 alt는 1개입니다. 강의에서 "있는지만 보지 말고 무엇이 있는지 보라"고 한 기준으로는 짧은 alt 1개가 점검 후보입니다. H1이 하나인 글은 23편이고 나머지 2편은 2주차에 확인한 2025년 9월 글의 한/영 쌍입니다.
스키마는 1주차부터 그대로입니다. JSON-LD가 있는 페이지는 홈 하나(Person)뿐이고, 글의 BlogPosting과 BreadcrumbList는 0/25입니다. 확인 태그와 GA 코드는 0쪽이어서, 강의가 말한 AI 유입 확인 채널(구글 애널리틱스, 빙 웹마스터)은 지금 사이트에서는 하나도 연결되어 있지 않습니다.
Step 6. BlogPosting 시제품: 검사를 먼저 쓰고 실패를 본 뒤 구현
Minimal Mistakes 테마는 head 끝에서 _includes/head/custom.html을 불러 주므로, 거기에 글 페이지에서만 JSON-LD를 내는 조각을 넣는 방식으로 정했습니다. 구현 전에 "글의 front matter가 참값"이라는 점을 이용해, 빌드된 글 HTML의 JSON-LD를 front matter와 대조하는 감사 스크립트와 시험을 먼저 썼습니다. 시험은 결함을 심은 모의 사이트(정상, 블록 없음, JSON 문법 오류, 제목 불일치, 날짜 누락)로 참값을 미리 정해 둡니다.
python3 -I -m pytest -q test_jsonld_audit.py
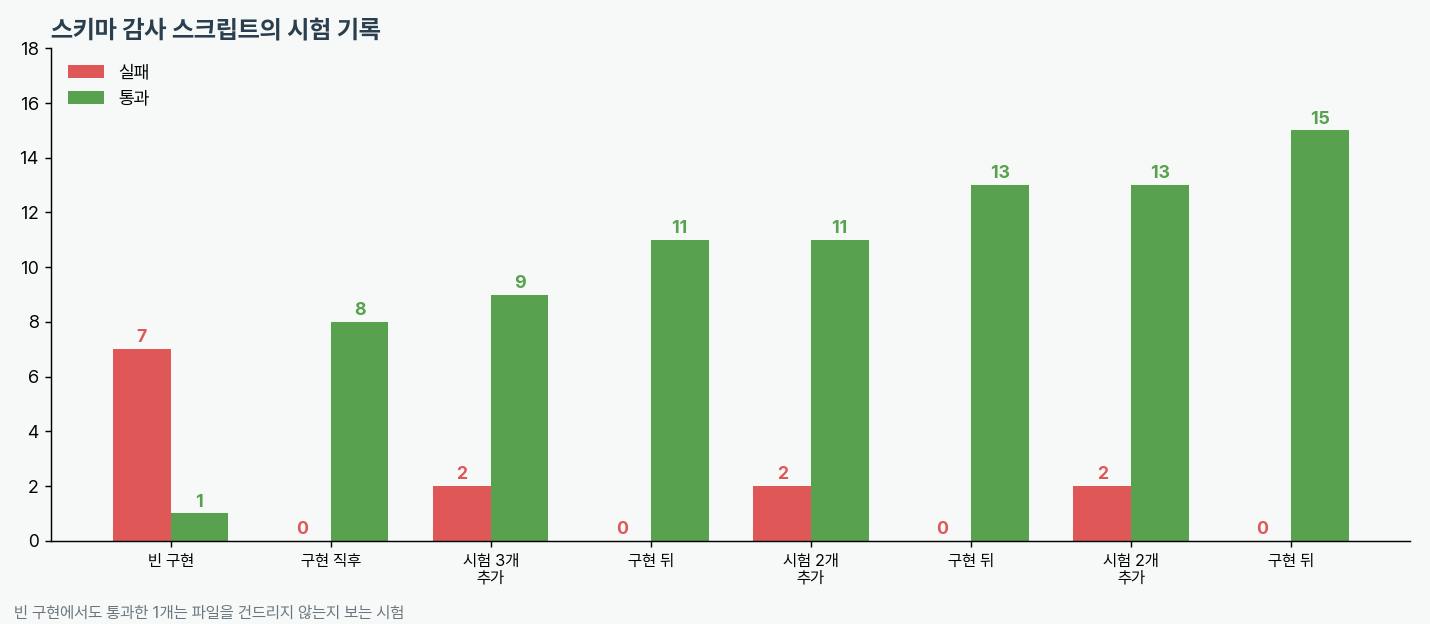
7 failed, 1 passed
빈 구현으로 돌린 결과입니다. 통과한 1개는 파일을 건드리지 않는지 보는 시험이어서 빈 구현도 통과했습니다. 구현 뒤 8개가 통과했고, 번역 쌍이 서로를 가리키는지, 키워드 순서, 브레드크럼 같은 시험을 더하면서 실패를 먼저 본 뒤 구현하는 순서를 되풀이했습니다. 나중에 실제 블로그를 빌드해 보니 게시하지 않은 글(published: false) 2편이 분모에 섞이는 문제와, excerpt가 없는 2025년 글의 설명이 언어 전환 버튼 문구("Read this post in English")로 채워지는 문제가 나왔습니다. 두 가지를 시험으로 먼저 만들어 실패를 확인한 뒤 고쳤고, 시험은 15개가 됐습니다.
시제품은 글 페이지에 BlogPosting과 BreadcrumbList 두 블록을 냅니다. BlogPosting의 필드는 제목(headline), 설명, 게시일과 수정일, 언어 코드(kr은 ko로), 주소, 키워드(글의 태그), 분야(글의 카테고리), 대표 이미지, 저자(홈 주소를 가리킴), 소속 블로그, 한/영 번역 쌍(workTranslation)입니다. 저자의 url을 홈으로 두어, 강의가 말한 "글과 글쓴이와 사이트가 엔티티로 이어지는" 연결을 홈의 Person 스키마와 맞추었습니다. 문자열은 전부 Jekyll의 jsonify로 내보내서 제목에 큰따옴표나 콜론이 들어가도 JSON이 깨지지 않습니다. 시제품이 실제로 낸 출력의 모양은 다음과 같습니다(주소와 이름은 가렸습니다).
{
  "@type": "BlogPosting",
  "headline": "생성형 AI 신약개발의 도달점과 신뢰 범위",
  "datePublished": "2026-09-11T09:00:00+09:00",
  "inLanguage": "ko",
  "url": "https://<내 블로그>/kr/2026/09/11/gen-ai-drug-discovery-evidence/",
  "keywords": ["생성형AI", "신약개발", "단백질설계", "..."],
  "author": {"@type": "Person", "name": "<내 이름>", "url": "https://<내 블로그>/"},
  "workTranslation": {"@type": "BlogPosting", "url": "https://<내 블로그>/en/2026/09/11/...", "inLanguage": "en"}
}
Step 7. 임시 복사본 빌드로 효과 확인
원격 저장소를 임시 폴더로 풀어 두 번 빌드했습니다. 한 번은 그대로, 한 번은 시제품 조각을 넣어서입니다. 두 결과의 HTML을 바이트 단위로 비교했습니다.
python3 -I prototype_build.py
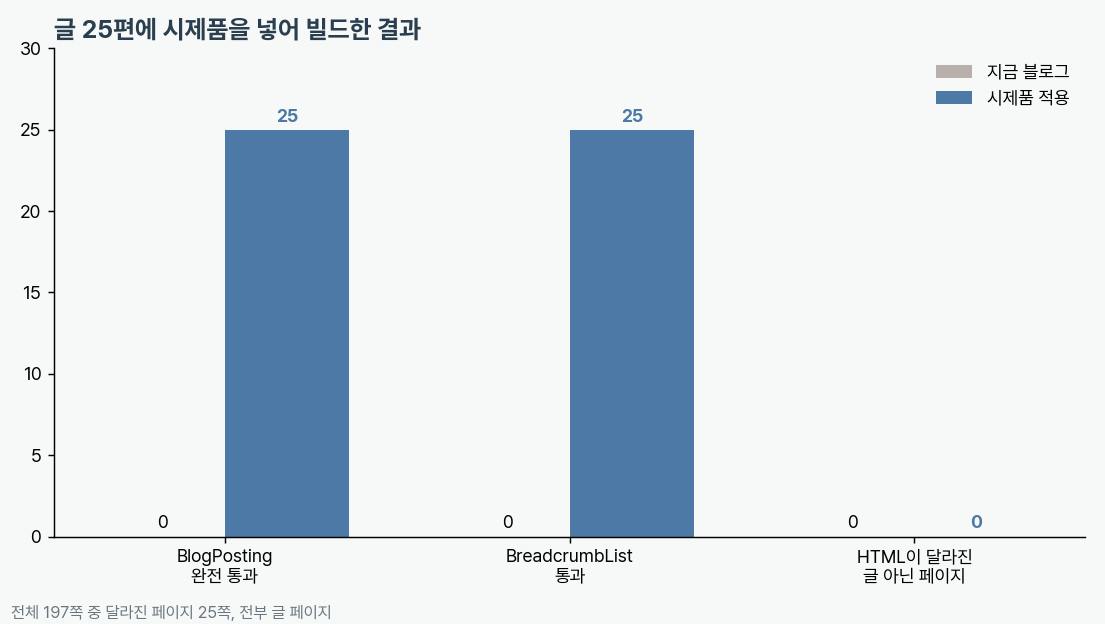
기준 빌드에서는 글 25편 중 BlogPosting이 읽히는 글이 0편이고, 시제품 빌드에서는 25편 전부가 완전 통과(제목, 날짜, 언어, 주소, 저자, 키워드, 설명, 번역 쌍이 front matter와 일치)하고 BreadcrumbList도 25편 전부입니다. 전체 197쪽 중 HTML이 달라진 페이지는 25쪽으로, 글이 아닌 페이지는 하나도 달라지지 않았습니다. Minimal Mistakes가 기본으로 두는 head 주석을 조각 끝에 그대로 남겨 두었기 때문입니다. 처음에는 이 주석을 지워서 홈, 소개, 주제 페이지 6쪽이 달라졌고, 바이트 비교가 그 사실을 알려 주었습니다. 구글의 리치 결과 테스트는 라이브 주소가 필요해 돌리지 못했습니다. 이 글의 "통과"는 front matter와 대조한 결과이고, 검색엔진이 리치 결과로 받아들이는지는 따로 확인해야 합니다.
rStep 8. AI 노출 질문 20개 고정
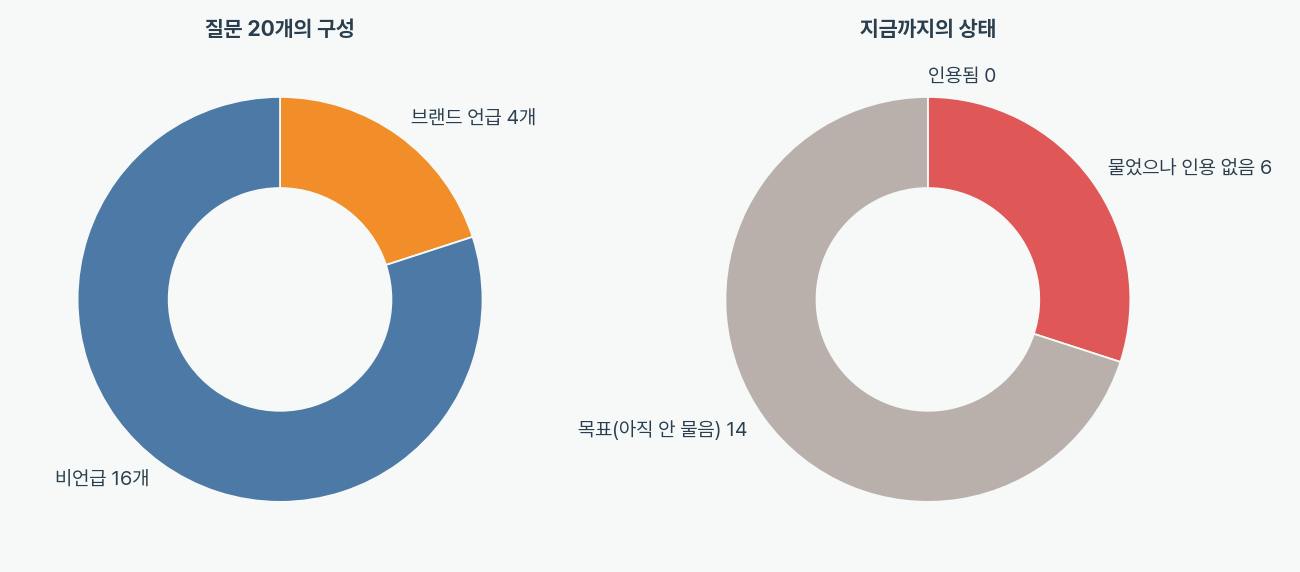
강의에서 스터디장은 질문 세트를 만들어 임시 채팅에서 묻고, 브랜드 언급 질문 20%와 비언급 질문 80%로 구성하라고 했습니다. 2주차에 쓴 질문 6개를 그대로 가져오고 새 14개를 더해 20개를 고정했습니다. 새 질문은 블로그 글의 주제에서 사용자가 물을 법한 문장으로 만들었고, 질문마다 답이 있어야 할 글의 주소를 붙였습니다. 상태는 세 가지로 나눴습니다. 인용됨(근거 주소 필수), 물었으나 인용 없음, 아직 묻지 않은 목표입니다.
python3 -I questions_check.py # 질문 20개, 브랜드 언급 4개, 상태 {'not_cited': 6, 'target': 14}, 문제 없음
검사를 먼저 썼고, 빈 구현에서 5개가 실패하는 것을 본 뒤 구현해 7개가 통과했습니다. 지금 상태는 인용됨 0개, 물었으나 인용 없음 6개, 목표 14개입니다. 14개는 아직 한 번도 묻지 않았으므로 "인용 없음"이라고 쓰지 않았습니다.
결과와 배운 점
측정 결과 (2026-10-22, 사이트맵 199개 주소와 그중 글 25편)
항목 | 2주차 (10/14) | 3주차 |
|---|---|---|
사이트맵 주소 | 192 | 199 (econ-radar 146) |
구글 | 15건, 전부 econ-radar | 15건, 전부 econ-radar |
구글에 뜬 블로그 글 | 0 / 25 | 0 / 25 |
한국어 페이지의 | 16/16이 | 16/16이 |
hreflang | 0 | 0 |
서치콘솔 확인 태그, GA 코드 | 0, 0 | 0, 0 |
글의 BlogPosting | 0 / 25 | 현재 0 / 25, 시제품 25 / 25 |
글의 이미지 alt | (미측정) | 53 / 53, 반복 0 |
AI 노출 질문 | 6개 한 번씩, 인용 0 | 20개 고정, 인용 0 |
블로그 설정을 고치지 않은 상태에서 구글 site:의 15건이 전부 econ-radar이고 글은 25편 중 0편이었으며, 글 25편에 넣을 BlogPosting 시제품은 임시 빌드에서 25편 전부 front matter와 일치했습니다. 이 결과는 2026-10-22의 사이트맵 주소 199개, 구글과 네이버의 site: 검색 한 번씩, 원격 저장소 origin/main의 글 25편과 임시 복사본 빌드를 기준으로 합니다.
배운 점
구조화 데이터는 front matter와 대조하는 검사가 되었습니다. 강의에서는 구조화된 데이터를 코덱스에게 검토시키라고 했는데, 글 스키마는 제목, 날짜, 언어, 주소가 이미 글 파일에 있어서 참값이 저장소 안에 있습니다. 그래서 AI의 판단 없이 스크립트로 25편을 한 번에 판정할 수 있었습니다.
빌드해 보고서야 보이는 결함이 있었습니다. 게시하지 않은 글이 분모에 섞였고, excerpt가 없는 글의 설명이 언어 전환 버튼 문구로 새어 나왔습니다. 설명을 제목으로 대체하는 임시 처리를 넣었지만, 근본 해결은 그 글 2편에 excerpt를 쓰는 일입니다.
스키마를 넣어도 색인은 별개입니다. 구글에는 글이 25편 중 0편이라서, 스키마가 있어도 페이지가 발견되지 않으면 읽힐 기회가 없습니다. 그래서 지난주 댓글에서 제안받은 대로 서치콘솔에 등록하고 4개 주소의 색인을 요청했습니다. URL 검사는 4개 모두 구글에 등록되지 않은 주소라고 알려 주었으므로, 색인이 실제로 생기는지는 며칠 뒤
site:로 다시 재야 압니다.엔티티 연결은 홈에서 시작합니다. 글의 저자 url이 홈을 가리키는데, 홈의 Person 스키마에는
@id가 없어 두 정보가 주소로만 이어집니다. 강의가 말한 엔티티 구축을 더 하려면 홈에@id를 달고 글의 author가 그것을 가리키게 하는 것이 다음 단계입니다.질문 세트는 먼저 고정해야 반복할 수 있습니다. 2주차에는 질문 6개를 한 번씩만 물었는데, 20개를 고정하고 브랜드 언급 질문 비율을 맞추어 두니 다음에 같은 문장으로 다시 물어 볼 수 있습니다. 다만 아직 한 번도 묻지 않은 14개는 결과가 없습니다.
시행착오
시제품 조각이 기본 head 주석을 지우는 바람에 글이 아닌 6쪽의 HTML이 달라졌습니다. 바이트 비교로 알아차리고 주석을 조각 끝에 되살렸습니다.
첫 빌드 검사에서 게시하지 않은 글 2편이 "페이지 없음"으로 잡혔습니다. 글이 25편이라는 분모를 2주차에 이미 확인했기 때문에 감사 스크립트의 분모가 틀렸다는 것을 바로 알았습니다.
질문 20개의 목표 주소 하나가 영어 글로 적혀 있었는데 그 글은 한국어판뿐이었습니다. 사이트맵과 대조해 고쳤습니다.
구글 리치 결과 테스트와 질문 14개의 첫 측정은 이번에 하지 못했습니다.
서치콘솔 작업 결과: 요청 4건을 접수했을 뿐 색인 여부는 아직 모릅니다. 며칠 뒤 site: 결과와 서치콘솔의 색인 상태를 다시 확인합니다.
도움 받은 글
24기 GEO실험실 3주차 강의 (스터디장 체크, 버디 엔지): 시맨틱 HTML, 구조화된 데이터와 엔티티, 질문 세트로 AI 가시성 재기, 브랜드 언급 20% 비율, AI 유입 측정 도구
24기 GEO실험실 2주차 사례글 (본인)과 그 글의 댓글(체크check 님의 서치콘솔 URL 검사 제안, 작은 개선 하나를 끝내라는 의견): 이번 주 비교 기준과 계획의 출처
24기 AI놀이터 3주차 사례글 (본인): 문서와 파일의 불일치를 참값이 있는 검사로 바꾸는 방식을 가져옴

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

구글 site: 15건이 전부 econ-radar이고 글 25편 중 0편이라는 측정에서, "스키마를 넣어도 색인이 안 되면 읽힐 기회가 없다"로 이어진 흐름이 설득력 있어요. 서치콘솔 4개 주소의 색인 요청까지 직접 끝내신 것도 지난주 댓글 제안을 실제로 반영하신 거라 좋았습니다.
BlogPosting 시제품을 원본이 아닌 임시 복사본에서 빌드해 25편 전부 front matter와 대조하신 방식, 그리고 빌드해 보고서야 보인 결함(게시하지 않은 글이 분모에 섞인 것, excerpt 없는 글의 설명이 언어 전환 버튼 문구로 새어 나온 것)까지 기록하신 점이 특히 도움이 됩니다.
며칠 뒤 site: 결과가 어떻게 바뀌는지 같이 기다려 볼게요. 고롱고롱… 이런 글 보면 기분 좋아져요 ✨