위키 구조 클론하여 나만의 위키 만들기
2026.07.29
한줄 요약
AI에게 "내가 만든 위키 구조 설명해줘"라고 물었다가 설명이 틀린 걸 발견하고 구조 개편까지 간 하루. 검증 게이트 검출력 40% → 100%, 노트 32개 → 27개 정리.
이런 분들께 도움돼요
AI가 정리해준 결과가 맞는지 확인할 방법을 찾는 분
자료는 잔뜩 모았는데 "그래서 뭘 쓰지"에 답이 안 나오는 분
자동 검증을 만들었는데 "그 검사기는 누가 검사하지" 가 걸리는 분
문제 상황 (Before)
몇 개의 스터디장님이 공유해준 wiki 소스들을 클론해서 나만의 wiki를 만들기 시작했습니다. 특히 research-survey를 참고하여 서베이 방법론이라는 주제로 논문 638편을 모았습니다.
그런데 제목·초록만으로는 그 논문이 어떤 기법을 다루는지 분류가 안 됐습니다.
천문학 논문의
survey instrument→ 설문 도구가 아니라 관측 장비양자정보 논문의
hypothesis testing→ 가설 검정이 아니라 양자 상태 구별
자동 분류를 돌리니 133편 통과 중 실제 관련은 65편(49%). 분류 조건을 5번 넘게 고쳤습니다.
조건 변경 후 개선
논문을 모으는 게 아니라 "내 가설에 어떤 기법이 매칭되는지 분류할 수 있는 기법군" 단위로 모으기로 했습니다. 결과물이 논문 목록이 아니라 기법 목록이 되도록.
| 기법 | 정본 문헌 | 적용 조건 | 가정 / 실패 모드 |
여기서 가장 중요한 칸은 "실패 모드" — 이 기법이 언제 무너지는가. 기법을 고르거나 버리는 근거가 여기입니다.
이렇게 218편을 32개 주제로 정리했고, 이게 제대로 만들어진 건지 AI에게 물어보는 것으로 이 세션이 시작됐습니다.
진행 방법 — 세 장면
사용 도구: Claude Code (Opus 5) + show-me-the-prd 스킬
① 연구 공백 발견
AI가 "2020년 이후 등가검정 문헌에 공백이 있다" 는 결론을 냈습니다. 연구 공백을 발견한 것처럼 보였습니다.
확인해보니 분류 조건의 정규식에서 단어 끝 경계 조건 하나가 복수형·파생형을 전부 차단하고 있었습니다. equivalence test는 걸리는데 tests, testing은 안 걸렸습니다.
고치고 재분류하니 158편 → 201편. 공백은 없었습니다.
분류 조건의 버그는 조용히 틀리지 않습니다. 그럴듯한 학술적 주장으로 출력됩니다.
② 검사기 검증
노트가 정본이 되려면 자동 검사를 통과하도록 만들었는데, 함정이 있었습니다.
검사기가 고장 났거나 아무것도 안 잡는 상태여도 통과율은 똑같이 100% 입니다.
그래서 일부러 틀린 노트 5개 + 정상인 대조군 1개를 심어놓고, 게이트가 그걸 거부하는지를 매번 잽니다. 숫자를 지어낸 노트, 인용문을 바꾼 노트, 출처를 안 쓴 노트 등이 거부되어야 정상입니다.
대조군이 왜 필요하냐면 — 전부 거부하는 게이트도 거부율 100%가 나오기 때문입니다.
처음 돌렸을 때 거부율 40%, 판정 불가 4건이 나왔습니다. 원인은 심어둔 노트가 다른 프로젝트의 논문을 인용하고 있어서 검사기가 원문을 못 찾은 것이었습니다.
이걸 "게이트 성능 미달"로 읽지 않고 이렇게 판정했습니다.
이는 검출력을 측정한 게 아니라 측정 실패를 기록한 것이다.
노트를 다시 쓰니 거부율 100%, 판정 불가 0. 그래서 판정 어휘를 셋으로 나눴습니다 — 거부 / 통과 / `확인 불가`. 세 번째가 없으면 "검증 못 한 것"이 "검증 통과"로 집계됩니다.
③ 위키 구조의 문제점
같은 논문 한 편이 노트 두 곳에 서로 다른 서술로 복사된 걸 발견했습니다. AI의 진단은 이랬습니다.
"설계상 정상입니다. 중복 빈도가 1% 미만이라 관리 부담도 없습니다."
숫자로 넘어가려 한 겁니다. 여기서 이렇게 물었습니다.
같은 ID의 다른 내용의 노트가 여럿 존재하면, 그건 wiki가 아니라 카탈로그 아니야?
wiki의 개념은 한 ID에 할당된 index 정보라고.
AI: "맞습니다. 그리고 실물이 정확히 그 상태입니다."
링크 39개를 열어보니 전부 노트↔노트였고, 논문은 그래프에 존재하지 않았습니다. "그 논문이 무엇을 보고했나"가 정본으로 존재하는 자리가 없었습니다. 나중에 한쪽이 틀렸다는 걸 알아도, 고칠 곳이 두 군데라는 사실을 알려주는 장치조차 없었습니다.
결과
항목 | Before | After |
|---|---|---|
분류 정밀도 | 133편 중 관련 65편 (49%) | 버그 수정 후158 → 201편 회수 |
게이트 검출력 | 거부율40% · 판정 불가 4 | 100% · 판정 불가 0 · 대조군 통과 |
검색 정확도 | — | 33문항 1위 적중93.9% |
노트 구조 | 32개 절 (같은 기법이 수집 경로별 분리) | 27개 확정 (5쌍 병합) |
논문의 지위 | 표 안의 텍스트 | 문헌 노트 층 신설 결정 |
원래 ID확정 → 확장 → 임계설정이었는데, 확장 대상 파트의 표가 2열뿐이라 실패 모드 칸을 새로 써야 한다는 걸 발견했습니다. 순서를 안 바꿨다면 근거 없는 주장을 21개 노트만큼 새로 생산할 뻔했습니다.
배운 점
AI는 "빈도 1% 미만이라 관리 부담 없음" 이라고 실측 숫자로 넘어가려 했습니다.
그걸 뒤집은 건 더 정확한 숫자가 아니라 "wiki는 한 ID에 할당된 index 정보" 라는 정의 한 문장이었습니다.
그 외 세 가지:
AI의 "불가능"은 대개 "안 함"이다 — "일부만 하면 안 되나?" 한마디에 '실행 불가'가 '아직 안 함'으로 바뀌었습니다
이름이 그럴듯한 라벨을 의심할 것 — AI가
★ FOUNDATIONAL을 영향력 지표로 읽었는데, 실제 뜻은 그냥 연도 표시였습니다미확인 표시를 보기 나쁘다고 지우지 말 것 — 지우면 작업 전과 같아집니다
앞으로
클론한 wiki들을 참고하여 구조 개편을 3단계로 나눴고, 완료 판정은 전부 스크립트 출력으로만 하도록 되어 있습니다.
논문을 노드로 만들기 (2개 이상 인용된 문헌만)
표에 근거 열 추가 —
전문확인/초록확인/추론/없음채점 기준 복구 후 회귀 임계 설정
2단계가 끝나면 실패 모드 서술 65개 중 약 45개(69%)에 "확인 안 됨" 표시가 붙습니다.
이 작업의 산출물은 "검증률 상승"이 아니라 "미확인이 드러남" 입니다.
다음 작업은 리뷰어를 통해 현재까지의 작업과 기준에 대해서 재검토하고 있습니다. 특히 첫번째 단계였던 taxonomy 다이얼 정의를 새로운 관점에서 수정해보고 있습니다. 또한 PRD를 새롭게 구성 적용해보고, 현재의 wiki를 개편할 예정입니다.
로그인하고 댓글을 남겨 주세요

wiki를 구축하고 검증까지 하는 과정을 보면서 제가 갖고 있는 위키에 대한 점검에 검증 과정을 대입을 해봐야 겠다는 생각이 들었습니다. 추후의 구축 방법도 기대됩니다~
논문 위키를 만드시면서 논문을 위키에 들여올때 논문을 불러오는 로직, 검색어; 자동검사기가 제대로 작동하는지 검토하는 과정, 실패 여부를 라벨링 하는 과정을 잘 적어주셔서 좋았습니다.
특히 AI가 처음에 부담스럽지 않다고 했을때 바로 수긍하지 않고, 한번 더 한 ID에 하나의 노트가 배정되어야 한다고 되짚어 주신점이 중요했다고 생각합니다.
AI가 '아직 안함' 부분을 해결하기 위해 여러 대화를 나누시면 더 정돈된 위키가 될 것 같습니다. AI가 실패했을때, 언제 어떤 작업을 하려다가, 어떤 자료를 쓰려다가 실패하거나 안됬는지 등을 적는 로그가 있으면 트러블 슈팅에 도움이 될 수 있을것 같다고 첨언해봅니다..(이미하고 계시고 있을수 있어요!)

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
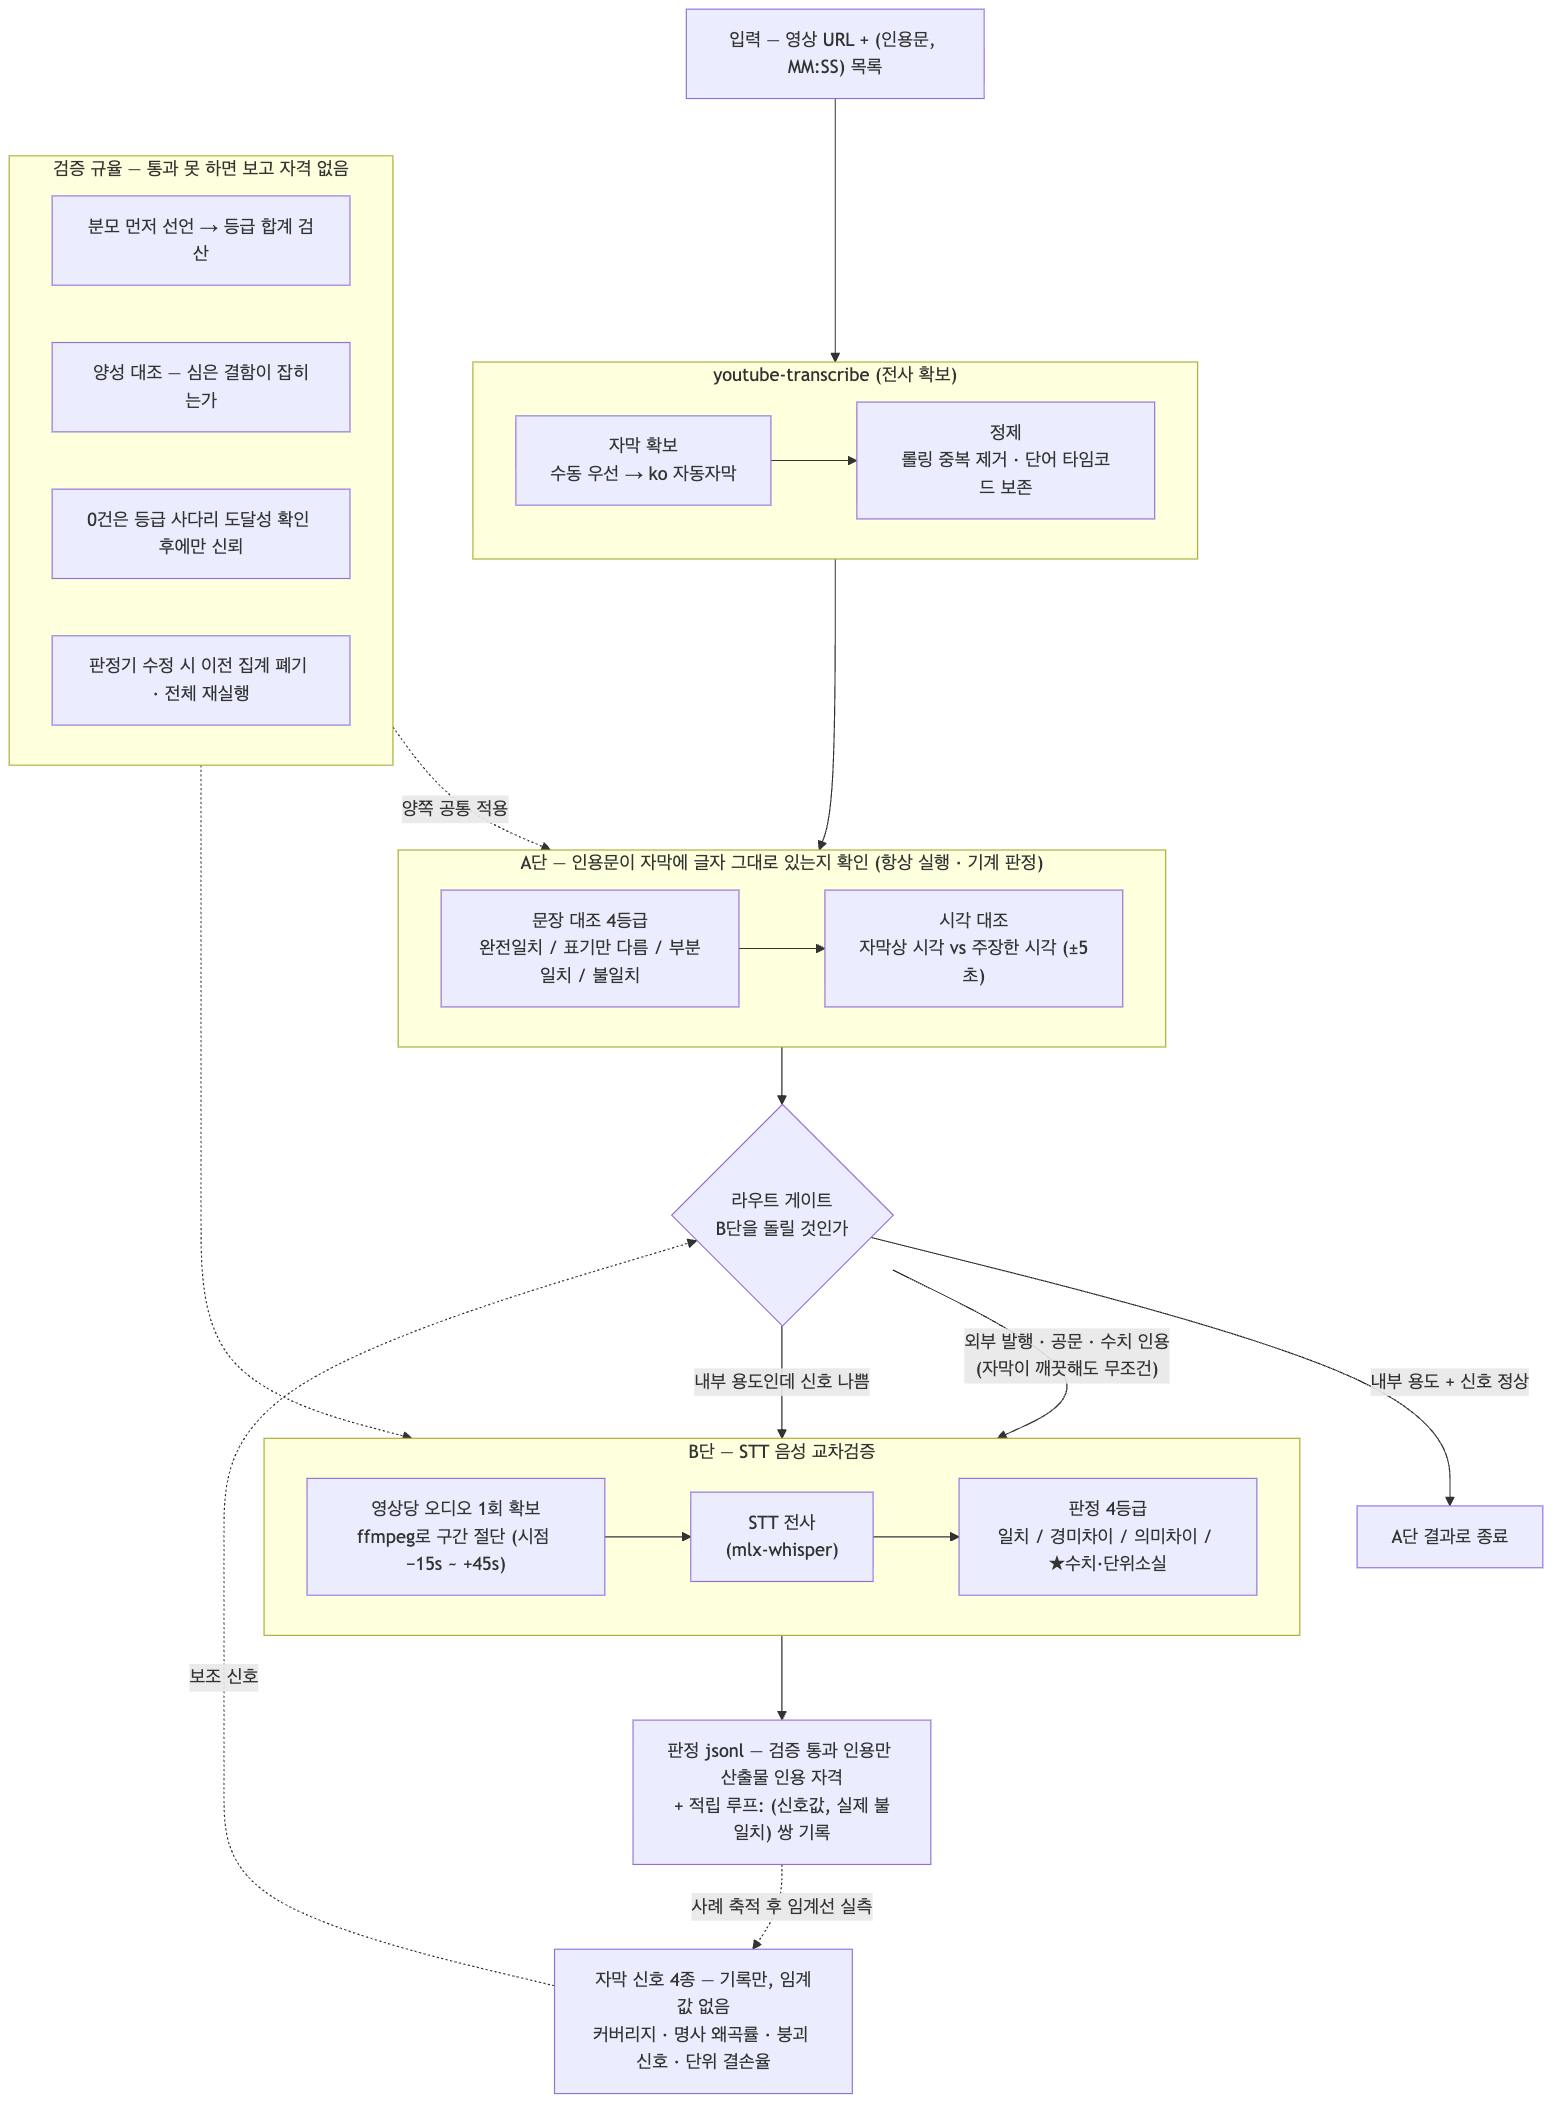


검사기를 만든 뒤 그 검사기를 검사하신 대목이 이 글의 중심입니다. "검사기가 고장 났거나 아무것도 안 잡는 상태여도 통과율은 똑같이 100% 입니다" 라는 인식이 먼저 있었고, 그래서 일부러 틀린 노트를 심는 쪽으로 갔습니다. 여기에 "전부 거부하는 게이트도 거부율 100%가 나오기 때문입니다" 를 근거로 정상 대조군까지 하나 넣으신 것이 설계를 닫습니다. 거부만 확인하면 무조건 거부하는 검사기와 구별되지 않으니, 양쪽을 같이 걸어야 판별력이 생깁니다.
가장 값이 큰 판단은 첫 결과를 성능으로 읽지 않은 쪽입니다. 거부율이 낮게 나온 원인이 심어둔 노트가 다른 프로젝트 문헌을 인용해 원문 대조가 안 된 것이었고, 그걸 "이는 검출력을 측정한 게 아니라 측정 실패를 기록한 것이다" 로 판정하셨습니다. 같은 낮은 숫자를 두고 검사기가 약하다고 결론 내리면 검사기를 손보게 되는데, 실제로 손봐야 할 것은 시험 자료였습니다. 그리고 그 판정에서 곧바로 판정 어휘를 셋으로 나누는 처방이 나왔습니다. 검사기의 출력은 대상의 상태와 검사 자체의 상태를 섞어 담는데, 통과와 거부 둘만 두면 그 둘이 갈리지 않습니다. 확인 불가를 별도 값으로 세운 것이 그 혼입을 끊는 장치입니다.
분류 조건 버그가 드러난 장면도 오래 남을 기록입니다. 단어 경계 조건 하나가 파생형을 전부 차단했는데 그 결과가 연구 공백이라는 결론으로 나왔고, 이걸 "분류 조건의 버그는 조용히 틀리지 않습니다" 와 "그럴듯한 학술적 주장으로 출력됩니다" 로 정리하셨습니다. 도구 결함이 오류 메시지로 나오면 잡기 쉽지만, 결론의 언어로 승격되면 검토 대상이 아니라 성과로 읽힙니다. 그걸 잡아낸 방법이 결론을 의심한 것이 아니라 결론이 나온 경로를 열어본 것이었다는 점도 같이 남을 대목입니다. 산출물만 보고는 갈 수 없는 곳이었습니다.
그리고 이 글에서 가장 옮겨쓰기 좋은 것은 정의로 숫자를 뒤집은 대목이라고 봅니다. "설계상 정상입니다. 중복 빈도가 1% 미만이라 관리 부담도 없습니다" 라는 답이 돌아왔을 때 더 정확한 숫자로 반박하지 않고 "wiki의 개념은 한 ID에 할당된 index 정보라고" 라는 정의를 들이대셨습니다. 정의를 위반한 구조는 빈도가 낮아도 위반이고, 빈도는 그 판단에 관여하지 않습니다. 실측이 맞는데도 결론이 틀릴 수 있는 경로가 여기입니다. 실제로 링크를 열어보니 "논문은 그래프에 존재하지 않았습니다" 였으니, 빈도로 넘겼다면 정본이 없는 상태가 그대로 유지됐을 것입니다. 측정보다 정의가 상위에 있다는 이 순서를 규칙 문서에 한 줄로 올려두시면, 앞으로 숫자로 무마되는 국면마다 먼저 걸립니다.
순서를 바꾸신 판단도 값이 큽니다. "순서를 안 바꿨다면 근거 없는 주장을 21개 노트만큼 새로 생산할 뻔했습니다" — 확장 대상 표에 실패 모드 칸이 아예 없다는 것을 확장 전에 발견하신 것이고, 이건 작업 순서 하나가 산출물의 진실성을 좌우한 사례입니다. 기법 표에서 실패 모드 칸을 가장 중요한 칸으로 두신 설계와도 앞뒤가 맞습니다. 언제 무너지는지가 적혀 있지 않은 기법 목록은 고르는 근거를 주지 못하니까요.
"미확인 표시를 보기 나쁘다고 지우지 말 것" 과 "지우면 작업 전과 같아집니다" 도 남겨둘 문장입니다. 다음 단계에서 실패 모드 서술 상당수에 확인 안 됨이 붙는다고 미리 밝혀두신 것도 같은 규율입니다. 표시가 늘어나는 것을 후퇴로 읽지 않는 상태에서만 그 표시가 유지됩니다.