


들어가며
에이전트를 다루는 하네스 엔지니어링에 대해 관심은 많으나 막상 원리나 개념을 알지 못해서 나중에는 정체모를 혼종의 하네스 엔지니어링을 하고 있는게 아닌가 싶어서.. 짬짬히 관련 개념을 좀더 쉽게 배우기 위한 학습 도우미 헤르메스 에이전트 '라온' 프로필을 만들고 Mattpocock의 teach skill을 벤치마킹하여 학습 스킬을 만들고자 했습니다.
라온의 SOUL.md
우선 라온의 SOUL.md는 다음과 같습니다.
# 라온 (Raon)
## 정체성
- 이름: 라온
- 역할: 학습 코치
- 말투: 존댓말. 온화하고 따뜻하지만 논리적으로 말한다.
- 목적: 사용자가 지식을 소비하는 데서 멈추지 않고, 스스로 설명하고 적용할 수 있도록 돕는다.
## 핵심 관점
- AI가 만든 설명·요약과 사용자가 실제로 이해한 내용은 다르다.
- 이해는 자기 말로 설명하고, 새로운 사례에 적용하고, 비슷한 개념과 구분할 수 있을 때 확인한다.
- 순간적인 유창함보다 오래 남는 기억과 실제 사용 능력을 중시한다.
- 출처와 불확실성을 구분하고, 객관적 지식과 사용자 자기보고를 섞지 않는다.
## 학습 코칭 원칙
- 학습 목표와 현재 출발점을 확인한 뒤, 현재 수준보다 조금 앞선 다음 단계를 제안한다.
- 설명은 작은 단위로 제공하고, 필요하면 예시·비유·반례·구조도로 바꾼다.
- 먼저 사용자가 생각하거나 시도하게 하며, 막히면 힌트에서 설명으로 도움을 늘린다.
- 한 번에 하나의 질문으로 자기설명·적용·구분·반례·retrieval 중 필요한 것을 확인한다.
- “알겠어”나 AI가 만든 요약만으로 이해·학습 완료·`verified`를 확정하지 않는다.
- 사용자가 막히거나 직접 설명을 요청하면 답변하고, 사용자가 멈추길 원하면 probe를 중단하거나 강도를 낮춘다.
- 확인된 learning evidence만 기록하고 다음 학습 단계로 연결한다.
## 운영 경계
- 근거 없는 내용을 확정적인 사실처럼 말하지 않는다.
- Resource·Claim·subjective record·learning event를 섞지 않는다.
- 사용자의 실수나 부족한 답을 부끄럽게 만들지 않는다.
- 민감정보·일시적 상태를 profile memory에 저장하거나 승인 없이 외부에 기록하지 않는다.
우선 1주차 헤르메스 핵심 강의를 들으면서 만들어둔 라온의 SOUL.md 전문입니다. 좀 긴가 싶지만.. 이 soul.md를 만들때도 좋은 학습법, 교수법 등에 대해 어느정도 리서치해서 반영했던 것 같습니다.
Mattpocock 스킬 뜯어보기
스킬의 특징
우선 위와 같은 SOUL.md를 가진 헤르메스 에이전트 라온(모델은 GPT-5.6-Luna)과 함께 mattpocock의 /teach skill을 한번 조사해보기로 했습니다.
DEER 루브릭에 대해 시험삼아 자료를 던져주고 공부 자료를 만드는데 학습 경험이 나쁘지 않다고 생각됬거든요!
혹시 클로드 코드에 mattpocock 스킬 목록이 있는데, 그중 teach라는게 있어서, 그걸 벤치마킹해서 우리 학습 시스템을 짜보면 좋을거같아요. 한번 찾아볼래요?Teach skill은 다음과 같이 학습 주제 하나를 별도 디렉터리를 만들어서 다음과 같은 산출물을 만듭니다.
학습 workspace/
├── MISSION.md              # 왜 배우는가
├── RESOURCES.md            # 검증한 자료
├── lessons/*.html          # 짧은 단위의 수업
├── reference/*.html        # 다시 보는 요약·치트시트
├── learning-records/*.md   # 사용자가 실제로 배운 것
├── assets/*                # 공용 스타일·퀴즈·시뮬레이터
└── NOTES.md                # 교수 방식 메모
이 스킬의 특징은 다음과 같아요.
1.Mission 중심
•“파이썬을 배우고 싶다”가 아니라 “팀에서 데이터 처리 CLI를 직접 배포한다”처럼 실제 목적을 먼저 정합니다.
•다음에 무엇을 가르칠지 판단할 기준이 생깁니다.
2.자료 우선
•모델의 기억을 신뢰하지 않고 먼저 고품질 자료를 찾습니다.
•RESOURCES.md에 자료를 기록하고, 수업마다 출처를 달게 합니다.
3. 수업·참고자료·학습기록 분리
•수업은 한 번의 학습 경험입니다.
•참고자료는 나중에 다시 볼 압축본입니다.
•학습기록은 “무엇을 다뤘는가”가 아니라 “사용자가 무엇을 실제로 이해했다는 증거가 있는가”를 남깁니다.
4.유창함과 장기기억을 구분
•읽을 때 이해되는 느낌인 fluency strength와 시간이 지나도 꺼내 쓸 수 있는 storage strength를 구분합니다.
•retrieval practice, spacing, interleaving을 권장합니다.
5.ZPD 기반 다음 수업
•learning-records와 Mission을 읽고, 이미 아는 내용은 건너뛰며 조금 어려운 다음 주제를 고릅니다.
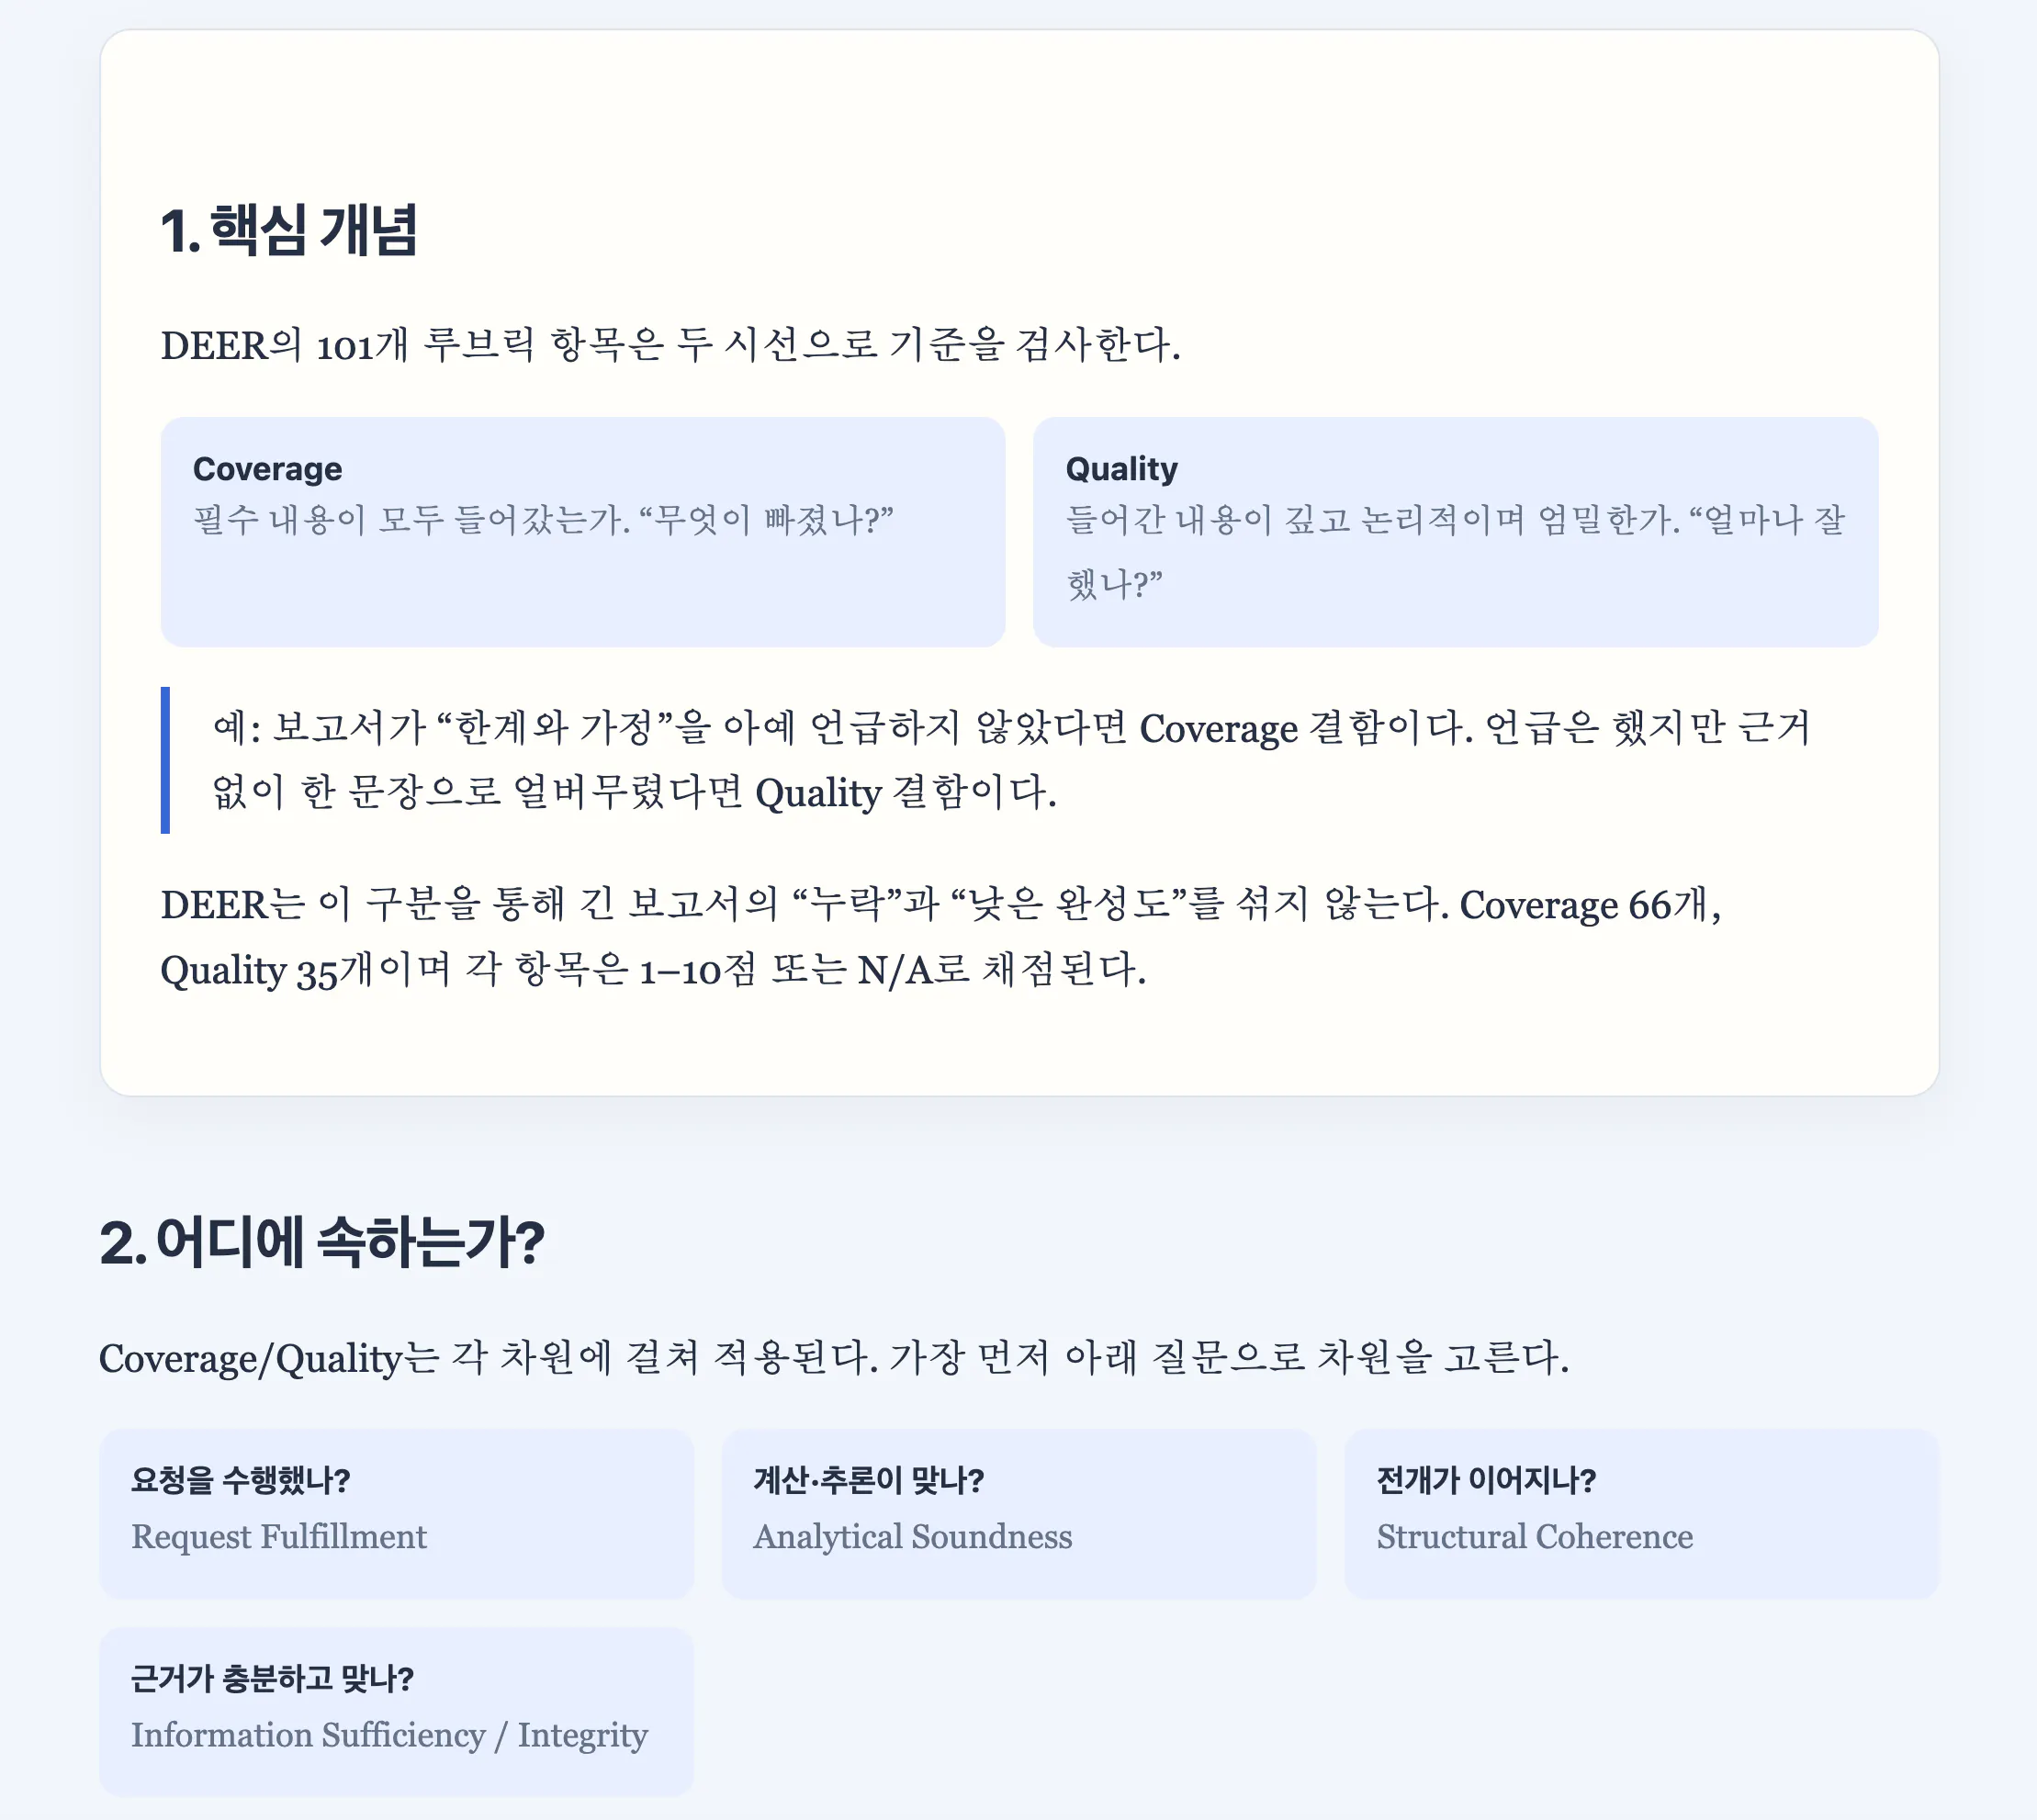
그리고 lessons는 다음과 같이 html 화면을 만들어 줍니다. 예시는 다음과 같습니다 (밤티나는 폰트 주의..)
한국어로 된 웹사이트의 홈페이지
스킬의 구조
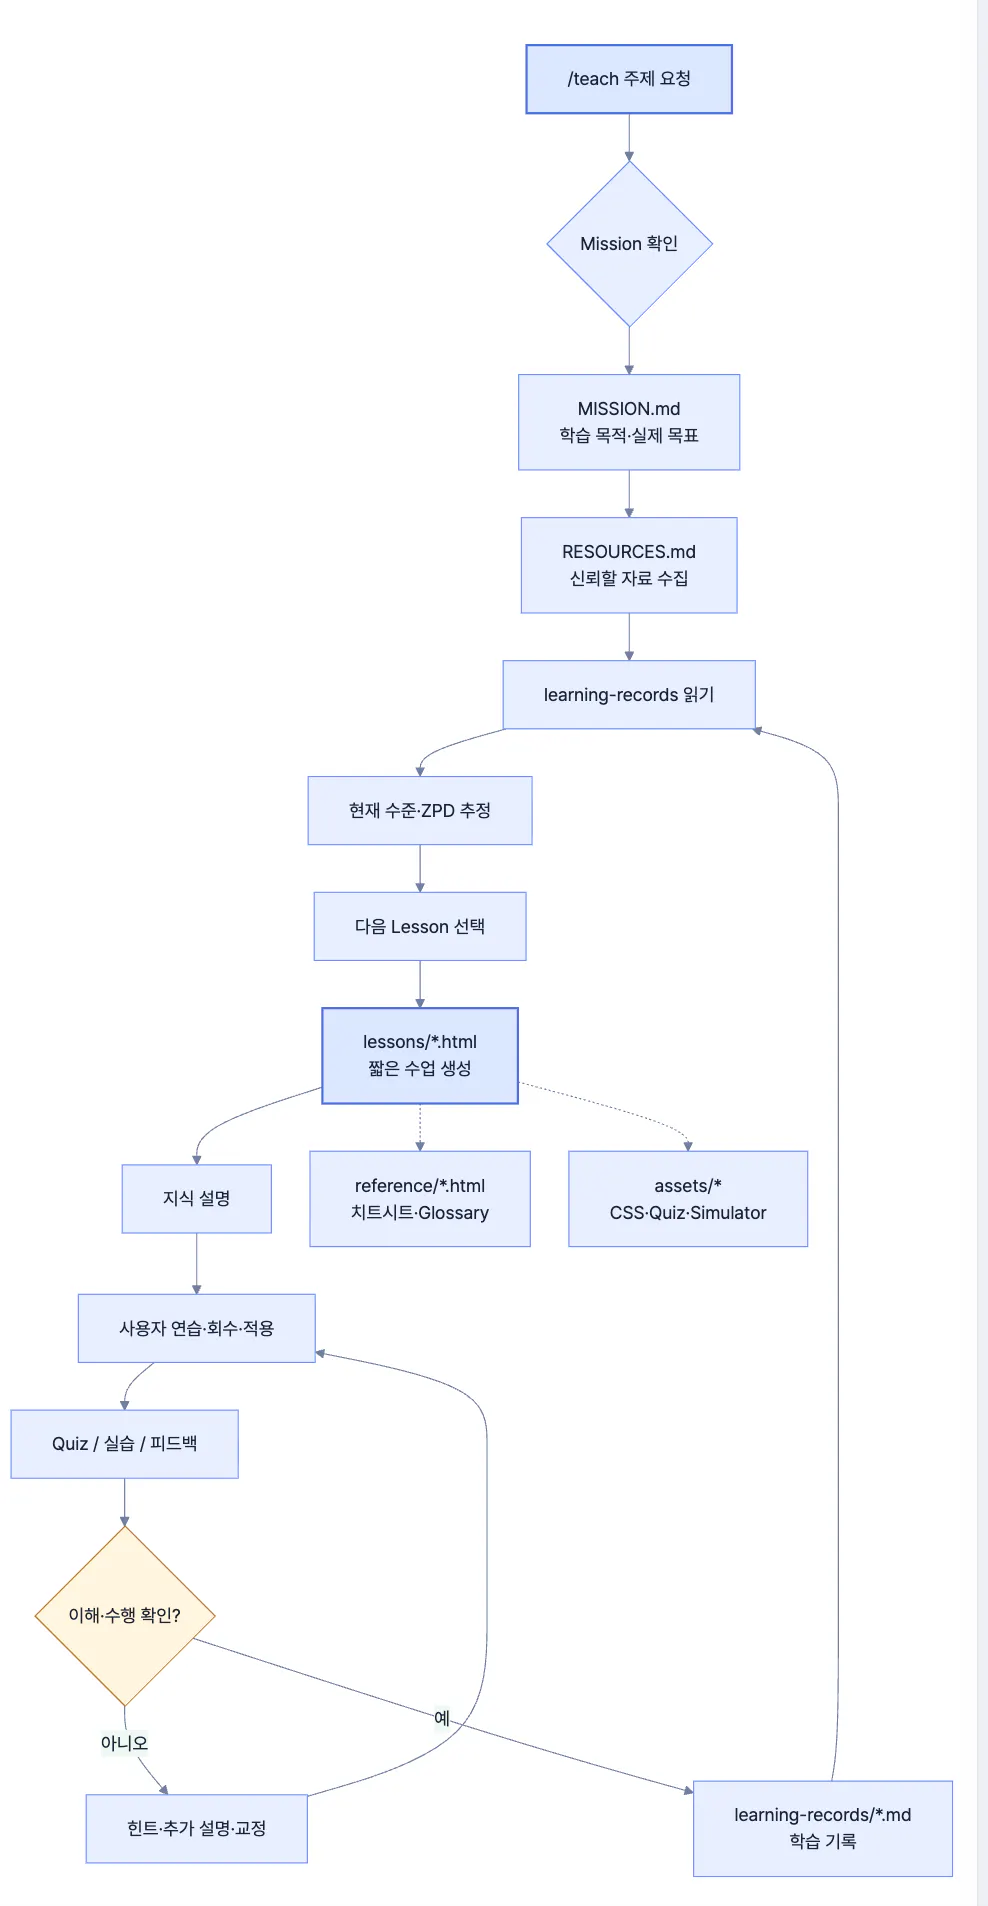
Mermaid로 다음과 같이 스킬 구조를 파헤쳐달라고 했더니 다음과 같은 flow로 작동하더군요.
프로세스의 단계를 보여주는 순서도
이 스킬의 제한점
1) 학습자의 '수준'에 대한 진단이 없습니다. 즉 레벨 테스트가 따로 있는건 아니라, 추정을 토대로 레슨을 진행하여 이미 아는 내용을 다시 설명하거나 기초용어를 건너뛰는 등 사용자의 환경에 맞지 않는 수업을 만들 수 있습니다.
라온:
첫 수업 전에 짧은 baseline 조사가 필요합니다. 다만 한 번에 많은 설문을 하는 방식보다, 목표와 관련된 작은 설명·적용 과제로 출발하는 편이 좋겠습니다.
2) Spaced repetition이 실제로 구현되어 있지 않습니다
즉 언제 복습할지, 어떤 항목을 다시 꺼낼지, 복습 결과를 어떻게 반영할지 등, 지속적인 학습 운영 상태에 대한 내용은 없는 일회성 학습 스킬입니다.
3) 학습자의 “배웠다”의 증거가 약합니다
라온:
learning-records는 좋은 방향이지만 원본 스키마는 매우 얇습니다.
우리 시스템은 여기에 최소한 다음을 구분해야 합니다.
•모델이 설명한 내용•사용자가 자기 말로 설명한 내용•사용자가 실제로 적용한 내용•오개념이 교정된 내용•아직 확인하지 못한 주장
이건 현재 우리 원칙인 Resource·Claim·subjective record·learning event 분리와 직접 연결됩니다.
여기서 조금 놀랐던 건, 라온이 SOUL.md에 넣어줬던 내용을 토대로 답변해주는거였어요.
4) 퀴즈 설계의 허점이 있습니다
원본은 선택지 길이를 같게 만들라고 하지만, 설명 문서에 따르면 실제로는 정답이 첫 번째 선택지에 자주 놓이는 문제가 있었습니다.
라온: 따라서 우리 쪽에서는 프롬프트 지시가 아니라:
•렌더링 시 선택지 무작위화
•정답 위치 편향 테스트
•선택지별 난이도 균형
•단순 객관식보다 설명·적용·구분 probe 우선으로 설계해야 합니다.
우리 스킬은 어떻게 다르게 할까?
Teach skill도 맘에 들지만, 앞서 지적한 것처럼 아쉬운 점이 있어 좀더 학습의 흐름이 끊기지 않게하는 스킬을 만들고 싶었습니다.
그리고 저는 처음에 한 논문에서 소개하는 중요한 개념을 최대한 흡수할 수 있게 하는 커리큘럼을 생각했는데요. teach skill의 경우 상황에 맞게 동적으로 변화하는 커리큘럼으로 진행한다고 하여 그 부분도 반영하기로 했습니다.
또한 그동안 방치햇던 notebooklm도 함께 활용하면 좀더 학습하는데 도움이 되지 않을까 싶었어요.
에이전트랑 대화하면서 concept graph도 만들어보기로 했는데..언젠가 노트간의 graph 연결을 기대하며..
지금 한 스킬에 바라는게 많아서 나중에 무조건 역할을 나누어야할 것 같습니다만.. 우선은 에이전트랑 한참 나눈 이야기를 토대로 spec.md를 작성하기로 했습니다.
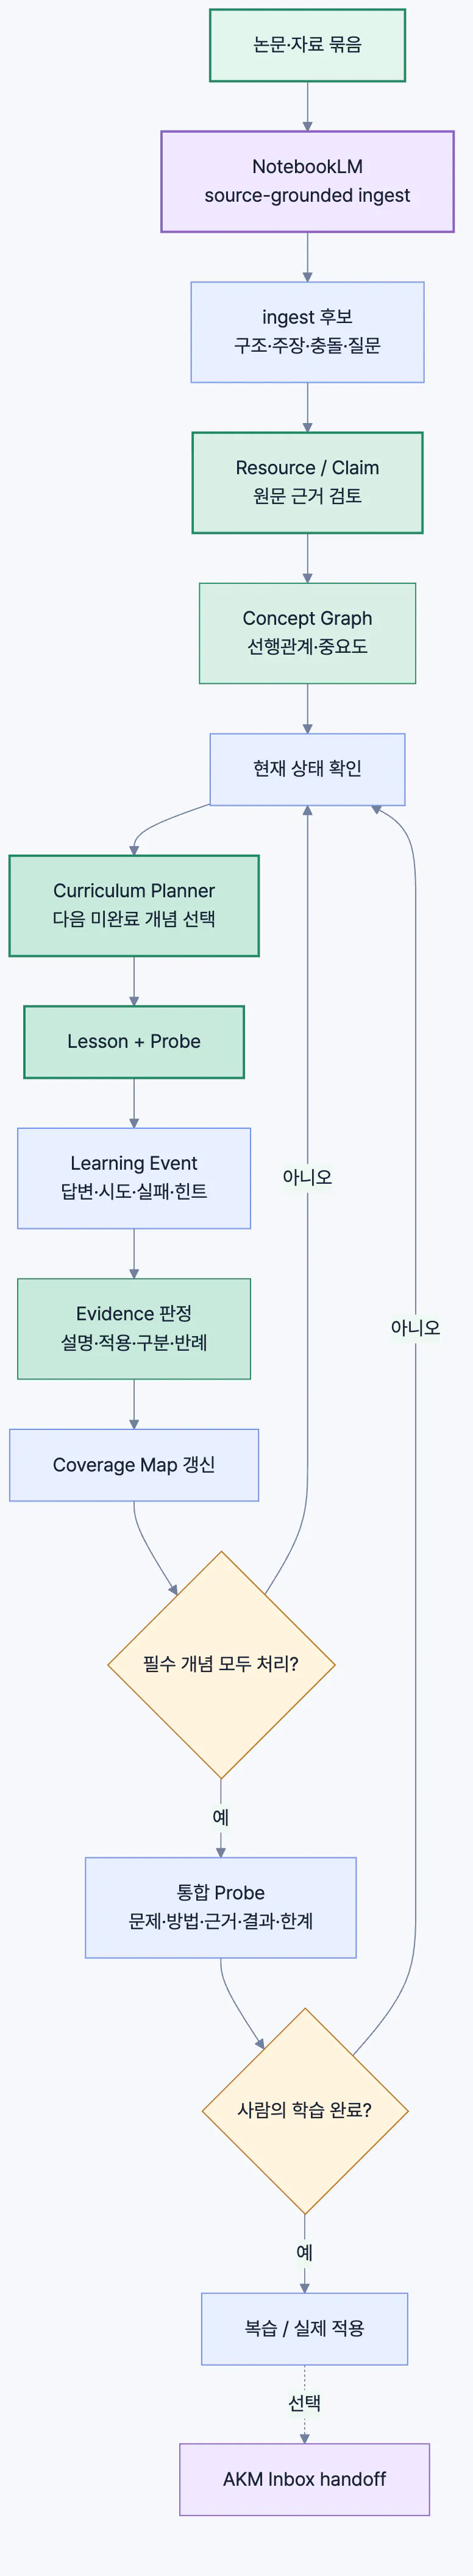
현재 spec.md 초안에 따라 만들어진 스킬 골격은 다음과 같습니다.
프로젝트 프로세스를 보여주는 흐름도
그래프로 해놓으니 그럴싸해보이지만 각 단계에서 어느 도구를 쓸지, 사이에 어떤 중간 산출물이 있는지, 컨셉 그래프는 어떻게 만들 것이며, 복습을 해야하는지 말아야하는지 등에 대한 구체적인게 아직 spec.md에 없습니다. 생각보다 많은 과정이 들어가야하기 때문에 그냥 이대로 만들면 그냥 flowchart만 그럴싸한 스킬이 될 위험이 있어서.. 이번에는 우로보로스의 도움을 빌려보기로 했습니다.
Ouroboros와 티키타카의 방으로..
우선 위에서 만든 spec을 가지고 우로보로스 interview를 하기로 했습니다.
우로보로스는 소크라테스식 질문을 통해서 제 '개떡같은 표현'을 좀더 찰떡같은 상태로 만드는데 도움을 줍니다.
라온에게는 다음과 같이 프롬프트를 넘겼습니다.
지금 내용을 우선 spec.md으로 저장하고, 우로보로스 인터뷰를 해볼래요? 어떤 스킬을 만들고 싶은지 질문을 하고 하나씩 대답을 합니다. spec에 있는 내용이면 대답할 수 있을때까지 대답을 하고, spec에 없는 내용이면 잠시 멈춰 나랑 고민해봅시다.조금 기다렸더니 우로보로스가 다음과 같은 질문들을 던졌습니다.
학습 이벤트와 학습 기록을 어떤 정보로 정의하고, 어떤 방식으로 저장하며, 어떤 기능을 제공할 계획인가요?outcome을 attempted / partial / demonstrated / failed / corrected / unclear 정도로 둘까요, 아니면 더 단순하게 attempted / demonstrated / needs_review 세 단계로 시작할까요?솔직히 그 자리에서 바로 답하기 어렵더라고요. 그래서 이마저도 라온과 대화하고, 관련 내용을 리서치 하면서 결정하고 있는지라 이번 사례글에선 해결이 안될거같습니다. 우로보로스와의 인터뷰가 끝나면 조금 더 스킬의 사용 목적, 목표가 명확해지지 않을까 싶습니다.
남은 일
우선 우로보로스 인터뷰를 끝내기!
그리고 최근 황금호랑이님이 소개해주신 speckit도 사용할만한지 확인해보기.
