여러 봇이 같이 보는 위키를 만들었더니, 매번 똑같은 설명을 안 해도 됐다
2026.06.01
한 줄 요약
여러 AI 에이전트가 업무 맥락을 잃지 않게 Markdown 기반 공유 지식 자료실(LLMWiki) 을 만들었고, 처음부터 완벽히 분류하는 대신 v0.1 → v0.2로 운영 규칙을 진화시키는 방식으로 시작했다.
1. 왜 만들었나 (시작점)
업무용 에이전트를 여러 개 굴리다 보면, 봇마다 아는 게 달라지는 순간이 온다. 한 봇은 "그 보고서 톤은 이렇게 잡기로 했다"를 기억하는데, 다른 봇은 그걸 모르고 처음 방식대로 답한다. 세션이 바뀌면 같은 맥락을 또 처음부터 설명해야 하고, 메모는 흩어져 있어 어떤 게 최신인지도 모른다. 결국 누구는 알고 누구는 모르는 상태가 쌓인다.
그래서 사람이 읽는 문서가 아니라, 모든 봇이 똑같이 참조하는 자료실을 하나 만들기로 했다. 핵심은 "한 군데만 보면 다 같은 답이 나오게" 하는 것이었다.
2. 주제 / 사용 목적
주제: 여러 봇이 공유하는 업무 운영 지식 자료실. 목적: 어떤 봇에게 물어도 같은 답이 나오게, "그 기준 뭐였지"를 사람에게 다시 묻지 않고 위키에서 스스로 찾게 하는 것. 사람 보고용이 아니라 봇 참조용이라는 게 핵심 포지셔닝이다.
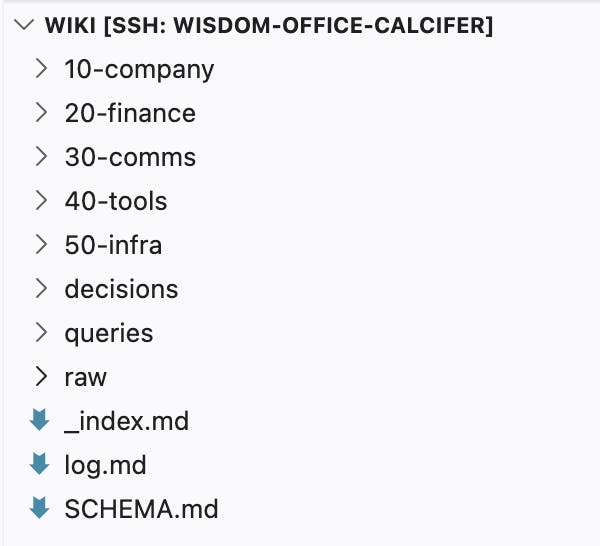
3. 초기 폴더 구조
도메인을 번호 prefix로 묶어 제목만 보고 찾게 했다. 도메인 폴더(10~50)와, 성격이 다른 보조 폴더(raw/queries/decisions)를 나눠 뒀다.
wiki/
  SCHEMA.md          # 운영 규칙 (v0.2)
  _index.md          # 전체 목차 (✅/⬜)
  log.md             # 변경 이력
  10-company/        # 회사 도메인 지식 — org-overview, product-glossary …
  20-finance/        # 재무·보고 규칙 — quarterly-report-rules …
  30-comms/          # 커뮤니케이션 규칙 — external-mail-tone, channel-routing …
  40-tools/          # 도구 사용법 — doc-export …
  50-infra/          # 운영 인프라 — bot-roster …
  ── 보조 ──
  raw/               # 원문 보관 (수정 안 함)
  queries/           # "그거 어딨지?"의 답
  decisions/         # 확정된 운영 결정만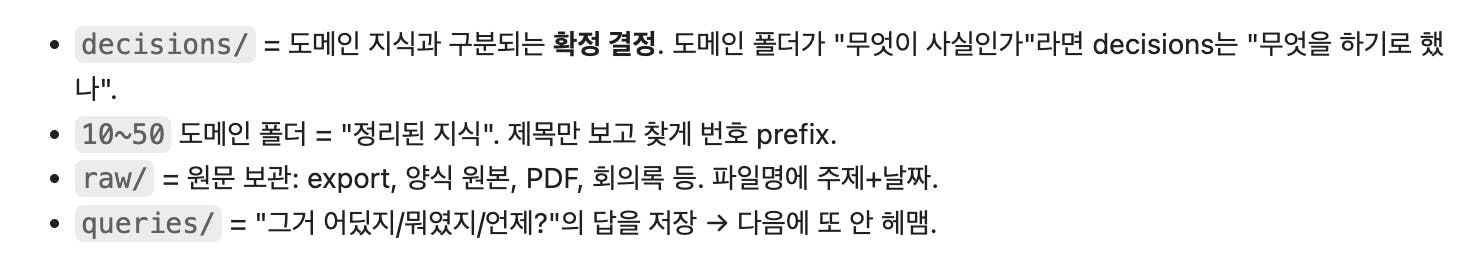
4. SCHEMA.md / index.md / log.md 를 어떻게 만들었나
한 번에 만들지 않고 세 파일에 각각 다른 역할을 줬다.
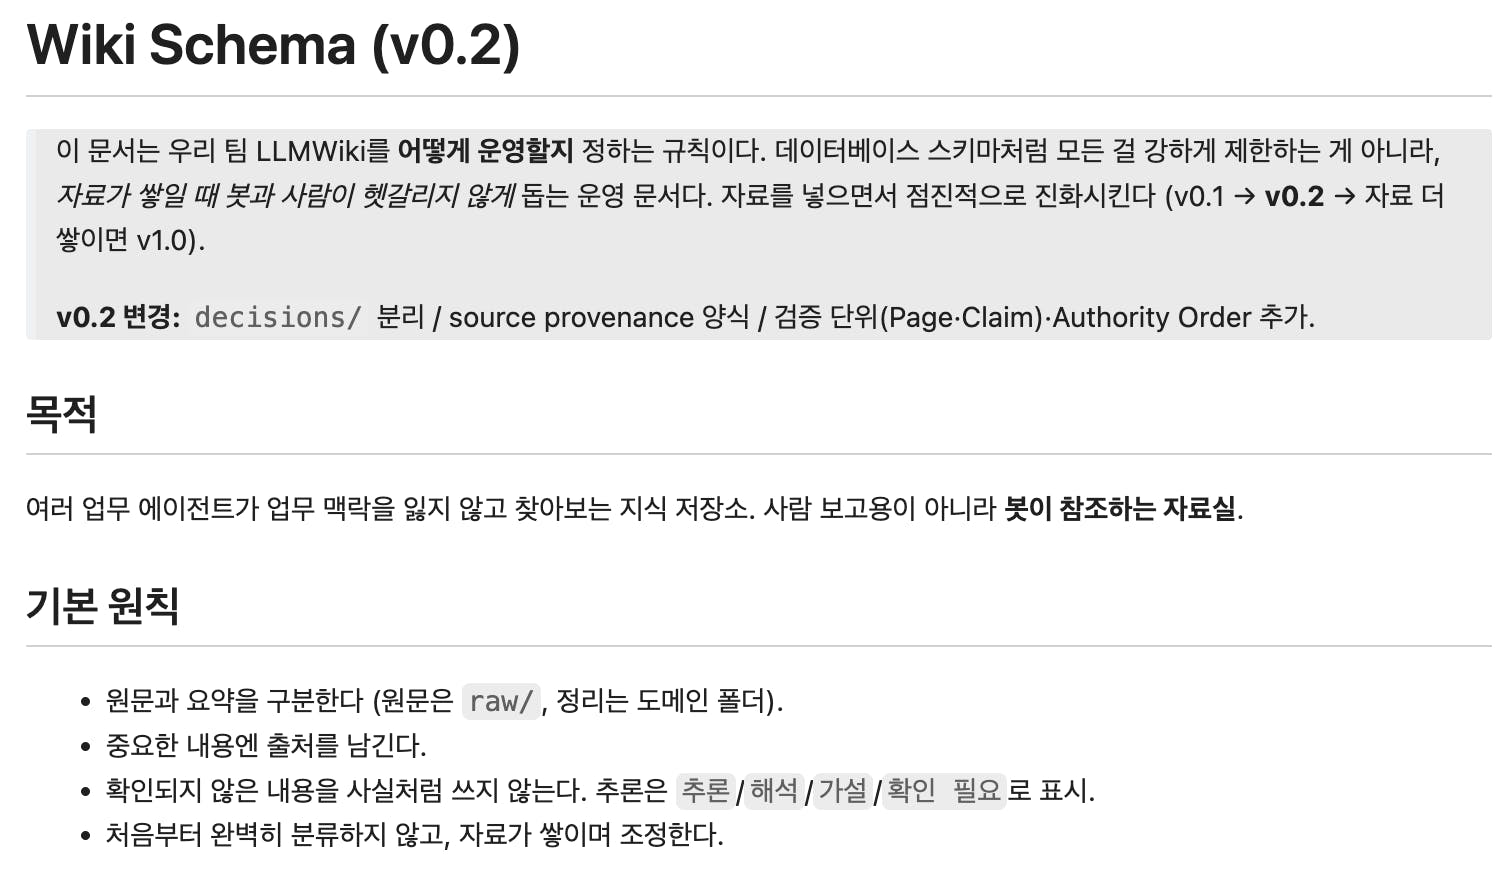
SCHEMA.md(운영 규칙) — 가장 먼저 만들었다. DB 스키마처럼 강제하는 게 아니라, 자료가 쌓일 때 헷갈리지 않게 돕는 운영 문서로 잡았다. ①형식 규칙(frontmatter), ②어디에 뭘 둘지(원본/요약 분리), ③민감정보 처리, ④충돌 처리 — 이 네 가지를 정해뒀다._index.md(목차) — 어떤 문서가 채워졌는지 ✅로 표시하는 한눈 목차. stub(빈 칸)과 완성본을 구분해서, 뭘 더 채워야 할지 보이게 했다.log.md(변경 이력) — 무엇을 언제 추가/수정했는지 날짜별 기록. 나중에 "이거 왜 이렇게 됐지"를 추적하는 용도.
만든 순서는 빈 골격(폴더+SCHEMA v0.1+빈 목차) 먼저 → 내용은 나중에 였다. 자료를 채워보며 헷갈렸던 지점만 규칙으로 흡수해 SCHEMA를 v0.2로 올렸다.
5. 에이전트에게 쓴 주요 프롬프트 (일부)
통째로 "위키 만들어줘"라고 맡기지 않고, 질문을 먼저 받게 한 게 핵심이었다.
나만의 LLMWiki를 시작하고 싶어.
- Markdown 기반, 작고 안전하게 시작
- 원본 자료와 AI 요약을 분리
- 나중에 Git과 연결 가능하게

먼저 나에게 질문해줘: 목적 / 다룰 주제 / 원본 자료 형태 / 정리 방식 / 복잡하지 않은 초기 폴더 구조.
그 답을 바탕으로 SCHEMA.md, index.md, log.md 초안을 만들어줘.
원본과 요약을 섞지 말고, 민감정보가 들어가지 않게 안내해줘.
6. 원본 자료와 AI 요약을 어떻게 분리했나
이 위키에서 가장 신경 쓴 규칙이다.
물리적 분리 — 원문은
raw/폴더에만 두기로 규칙을 정했다(가능하면 수정하지 않음). AI가 정리한 요약은 도메인 폴더(10~50)에 따로 둔다. 둘을 같은 파일에 섞지 않는다.출처 연결 — 정리 문서엔
sources필드로 어떤 원문에서 왔는지 연결한다. 출처 없는 내용을 사실처럼 단정하지 않는다.확신도 표시 — 추론이나 단일 출처는
확인 필요/가설로 표시하고, 여러 출처로 확인된 것만confidence: high로 올린다.
이 분리 덕분에 AI 요약을 원본처럼 믿어버리는 사고를 막을 수 있었다.
7. 앞으로 어떻게 활용할까
새 업무 기준이 생기면 원문은
raw/에, 증류한 지식은 도메인 폴더에 쌓는다.lint 루프 자동화 — 오래된 문서(stale)·아무 데서도 링크되지 않은 문서(orphan)·깨진 링크를 주기적으로 점검해 리포트받기.
자료가 더 쌓이면 SCHEMA를 v1.0으로 올린다. (규칙은 고정된 법이 아니라 계속 진화시키는 운영 문서)
배운 점
위키의 가치는 작성보다 유지보수 규칙에서 나온다. 규칙이 없으면 금방 "죽은 문서 저장소"가 된다.
처음부터 완벽히 분류하려 하면 시작을 못 한다. 작게 시작 → 헷갈리는 지점만 규칙화가 실제로 굴러갔다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


구체적인 사례를 들어주셔서 좋았습니다. 단순히 “이런 걸 해봤다”에서 끝나는 게 아니라, 어떤 상황에서 필요했고 어떻게 적용해봤는지가 보여서 다른 분들도 자기 업무나 상황에 대입해보기 쉬운 글이었어요.
특히 과정과 결과를 같이 남겨주신 점이 좋았습니다. 이런 사례가 하나씩 쌓이면, 나중에는 “나도 비슷한 방식으로 시도해볼 수 있겠다”는 참고 자료가 될 것 같아요.
좋은 공유 감사합니다. 다음 실험이나 적용 사례도 기대하겠습니다.